library(tidyverse)
library(FactoMineR)
library(factoextra)
library(aricode) # Pour l'indice AMI1 Introduction
Jusqu’à présent, nous avons cherché à expliquer une variable (la régression) ou à résumer l’information de plusieurs variables (les méthodes factorielles). Aujourd’hui, notre objectif est différent : nous voulons découvrir des groupes homogènes d’individus (des clusters) au sein de nos données, sans savoir à l’avance combien de groupes existent ni ce qu’ils représentent. C’est ce qu’on appelle la classification non supervisée ou clustering.
Nous allons voir ici deux méthodes de clustering : le k-means (k-moyennes en français) et la Classification Ascendante Hiérarchique (CAH).
Le clustering est extrêmement complémentaire avec les méthodes factorielles vues dans le cours précédent (ACP, MDS, AFC). En effet, l’ACP permet de réduire la dimensionnalité, d’éliminer le bruit et de créer une visualisation des individus, mais elle ne crée pas de “frontières” strictes entre les individus. À l’inverse, le clustering segmente les individus dans des classes discrètes, mais les résultats bruts sont difficiles à visualiser en haute dimension. La combinaison des deux donne souvent des résultats très parlants : on utilise l’ACP pour visualiser, puis le clustering pour catégoriser les individus.
Les deux méthodes de clustering que nous allons étudier sont directement disponibles dans R. Nous allons charger ici FactoMineR afin de coupler notre clustering avec de la visualisation en basse dimensionnalité. De plus, factoextra possède des fonctions qui sont très utiles à la classification :
Comme les résultats du k-means sont en partie aléatoires (initialisation au hasard), nous allons ici fixer la “graine aléatoire” pour garantir la reproductibilité de nos analyses :
set.seed(2026)2 Le k-means
2.1 Théorie
L’algorithme du k-means, ou des k-moyennes en français, est une méthode de partitionnement itérative. Son fonctionnement est assez intuitif à comprendre :
- Initialisation : L’utilisateur choisit le nombre de groupes k. L’algorithme place aléatoirement k points (les “centroïdes”) dans l’espace des données.
- Affectation : Chaque individu est assigné au centroïde le plus proche (via la distance euclidienne), formant ainsi k groupes initiaux.
- Mise à jour : L’algorithme recalcule la position exacte de chaque centroïde pour qu’il se place parfaitement au milieu (la moyenne) des individus de son groupe.
- Convergence : Puisque les centroïdes ont bougé, on recommence l’étape 2. On boucle ainsi jusqu’à ce que plus aucun individu ne change de groupe.

2.2 Le jeu de données
Nous allons utiliser le jeu de données USArrests, disponible nativement dans R, qui contient les taux d’arrestation pour divers crimes dans 50 États américains en 1973 :
arrests_df = as_tibble(USArrests, rownames="Name")
arrests_df
# A tibble: 50 × 5
Name Murder Assault UrbanPop Rape
<chr> <dbl> <int> <int> <dbl>
1 Alabama 13.2 236 58 21.2
2 Alaska 10 263 48 44.5
3 Arizona 8.1 294 80 31
4 Arkansas 8.8 190 50 19.5
5 California 9 276 91 40.6
6 Colorado 7.9 204 78 38.7
7 Connecticut 3.3 110 77 11.1
8 Delaware 5.9 238 72 15.8
9 Florida 15.4 335 80 31.9
10 Georgia 17.4 211 60 25.8
# ℹ 40 more rowsPour enrichir notre future analyse, nous allons ajouter un jeu de données externe, issu d’une étude sur les orientations politiques des États US à travers le temps (https://dataverse.harvard.edu/dataset.xhtml?persistentId=doi:10.7910/DVN/ZXZMJB). Le jeu de données original (validation_data.csv, disponible dans le dossier data) a déjà été pré-traité pour obtenir quelques colonnes pertinentes pour notre analyse :
states_meta_df = read_csv("data/states_meta_1973.csv")Rows: 50 Columns: 6
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
chr (2): Name, region
dbl (4): abortion, environment, gay_rights, families_payments
ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.On effectue maintenant la jointure des données, sur la colonne Name qui contient le nom des États :
states_df = arrests_df %>%
  left_join(states_meta_df, by="Name")
Les variables externes (non criminelles) vont nous servir de variables de comparaison pour interpréter les clusters que nous allons trouver. Cependant, ces clusters vont être calculés uniquement sur les variables de criminalité. La question sera : est-ce que les États qui ont des taux d’arrestation similaires ont aussi des orientations politiques ou géographiques similaires ?
Nous allons donc isoler les variables de criminalité pour faire le clustering. L’opération column_to_rownames() permet de conserver le nom des États comme identifiants de la matrice sans qu’ils soient considérés comme une variable numérique (et accessoirement, elle transforme le tibble en dataframe) :
clustering_df = states_df %>%
  select(Name, Murder, Assault, UrbanPop, Rape) %>%
  column_to_rownames("Name")
Dernier point (mais non des moindres) : il est absolument nécessaire de standardiser (centrer-réduire) les variables avant de faire des k-means ou une CAH. Sans cela, les variables avec les valeurs numériques les plus grandes (ici Assault qui monte à 337) prendront mathématiquement toute l’importance au détriment des autres variables (comme Murder qui est autour de 10) :
clustering_df = scale(clustering_df)
head(clustering_df)
Murder Assault UrbanPop Rape
Alabama 1.24256408 0.7828393 -0.5209066 -0.003416473
Alaska 0.50786248 1.1068225 -1.2117642 2.484202941
Arizona 0.07163341 1.4788032 0.9989801 1.042878388
Arkansas 0.23234938 0.2308680 -1.0735927 -0.184916602
California 0.27826823 1.2628144 1.7589234 2.067820292
Colorado 0.02571456 0.3988593 0.8608085 1.8649672072.3 Visualisation pré-clustering
Avant d’effectuer le clustering, nous allons observer notre jeu de données avec une ACP :
pca_res = PCA(clustering_df, graph=FALSE)Affichons le screeplot :
fviz_eig(pca_res, addlabels=TRUE)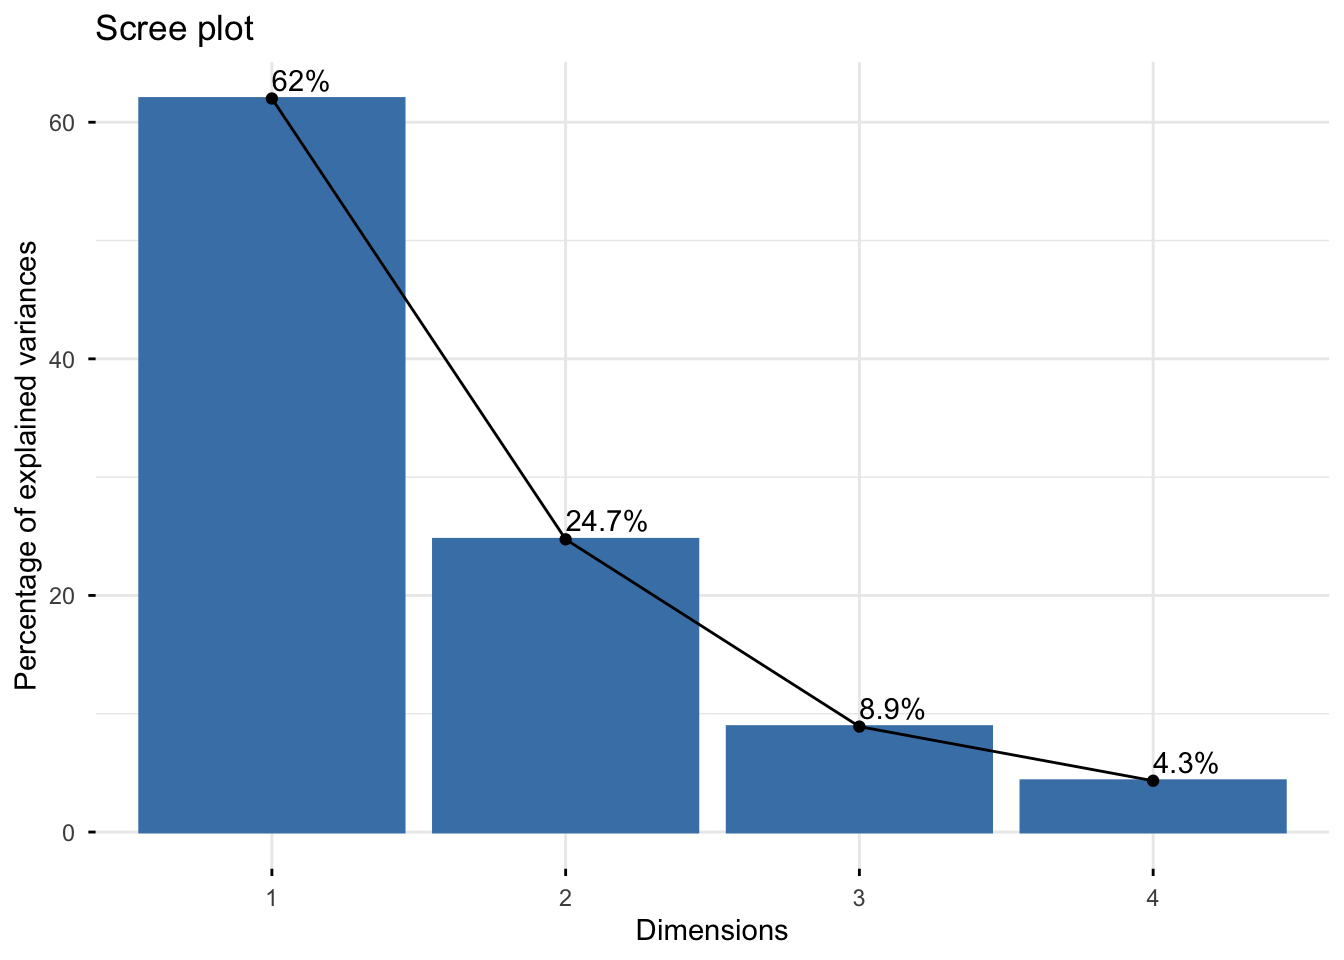
Ce graphique nous montre que presque toute l’inertie (86.7%) se trouve sur les deux premiers axes. Le clustering que nous allons réaliser devrait donc être très bien représenté sur un plan en 2D.
Passons au cercle des corrélations :
fviz_pca_var(pca_res, col.var="contrib",
             gradient.cols=c("#00AFBB", "#E7B800", "#FC4E07"),
             repel=TRUE)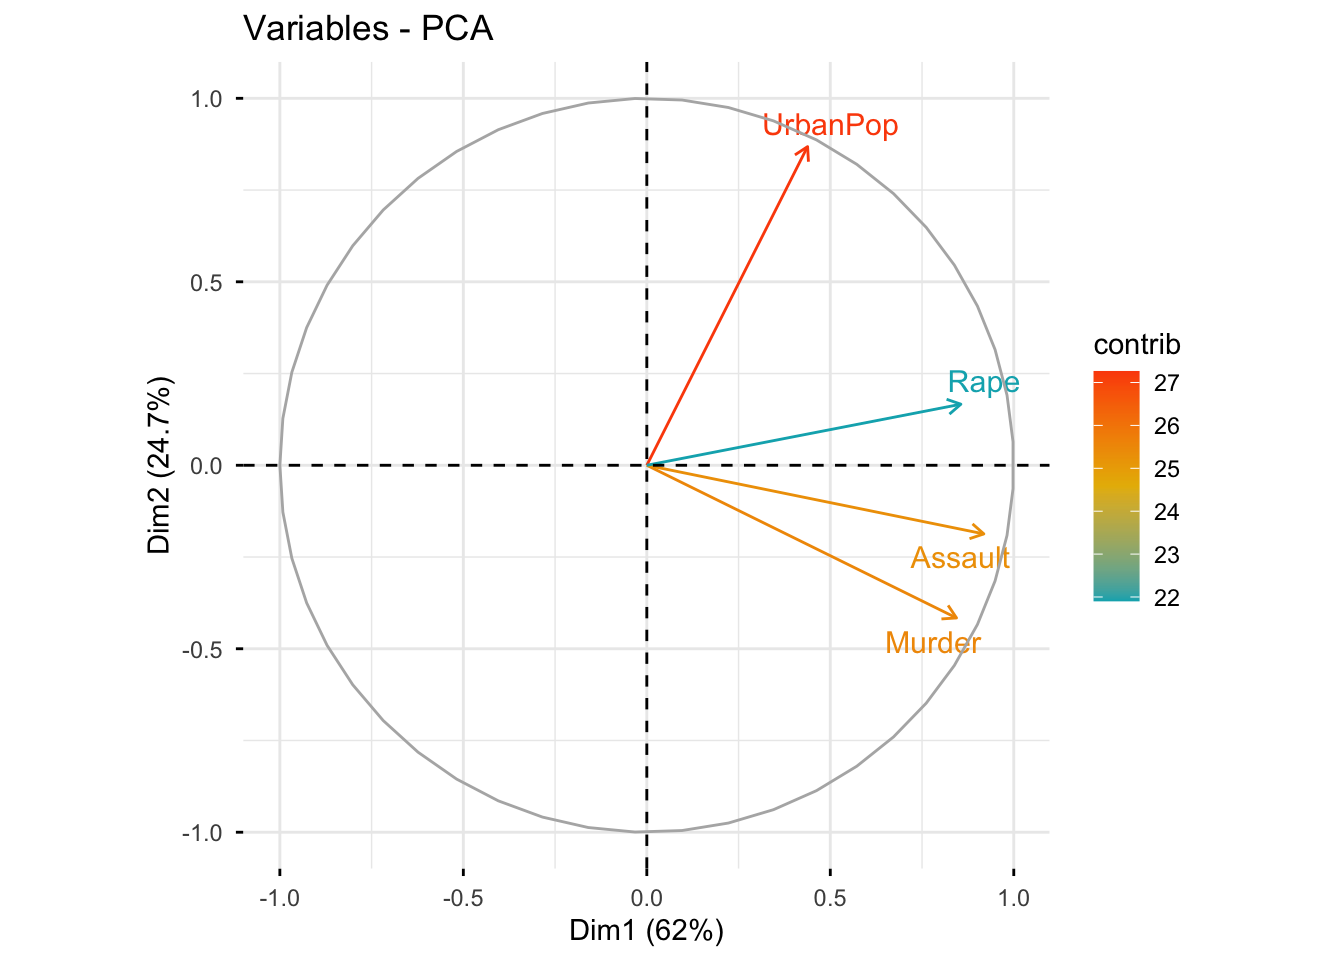
L’axe 1 (horizontal) est principalement défini par les crimes violents (Murder, Assault, Rape), tandis que l’axe 2 (vertical) est principalement défini par l’urbanisation (UrbanPop).
Affichons maintenant les individus sur les 4 premiers axes (dans notre cas, il s’agit de tous les axes disponibles) :
fviz_pca_ind(pca_res, repel=TRUE)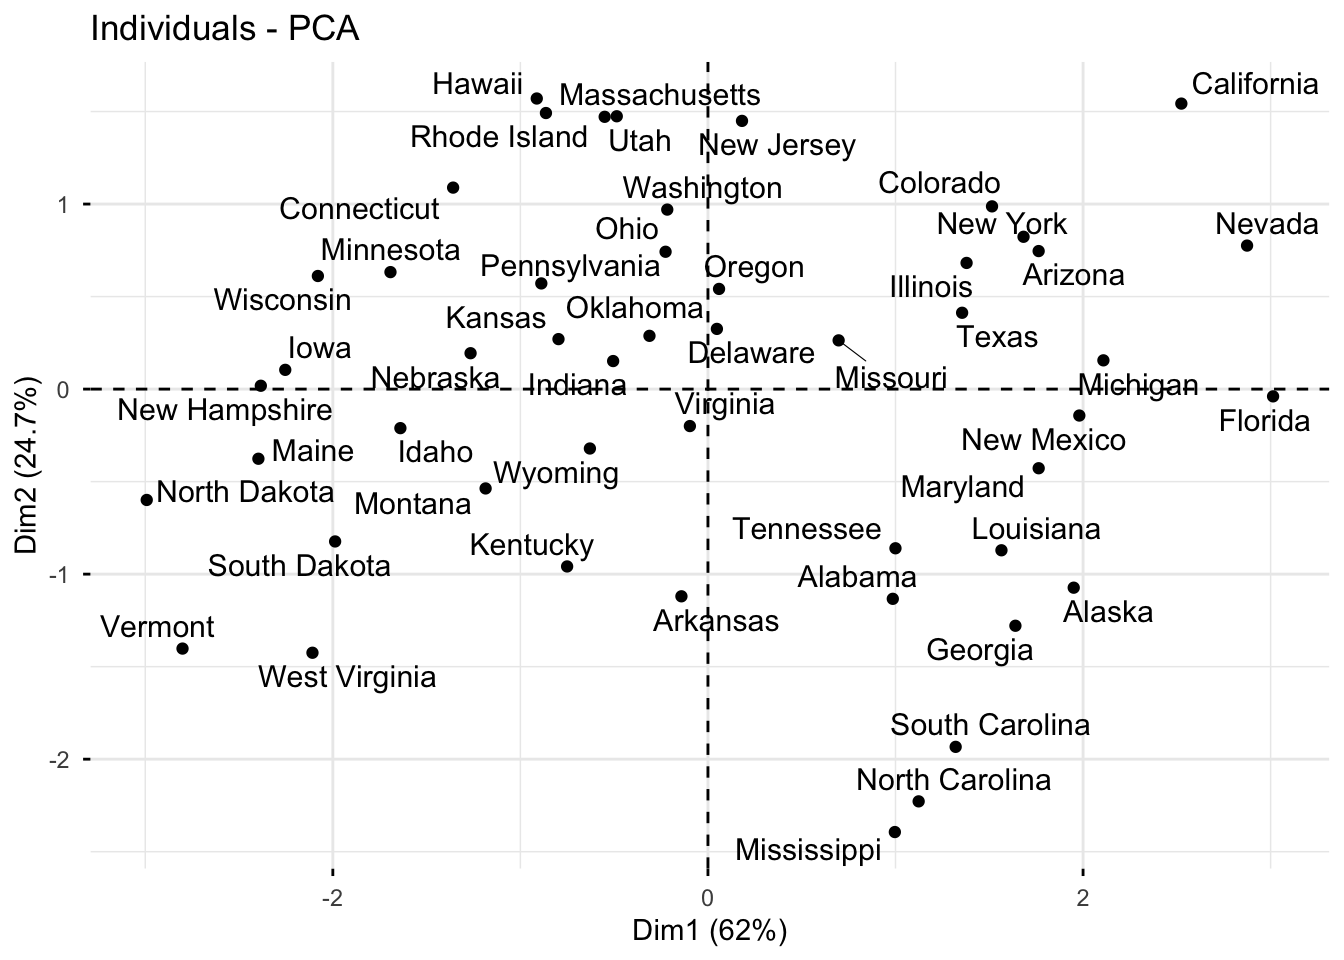
fviz_pca_ind(pca_res, axes=c(3, 4), repel=TRUE)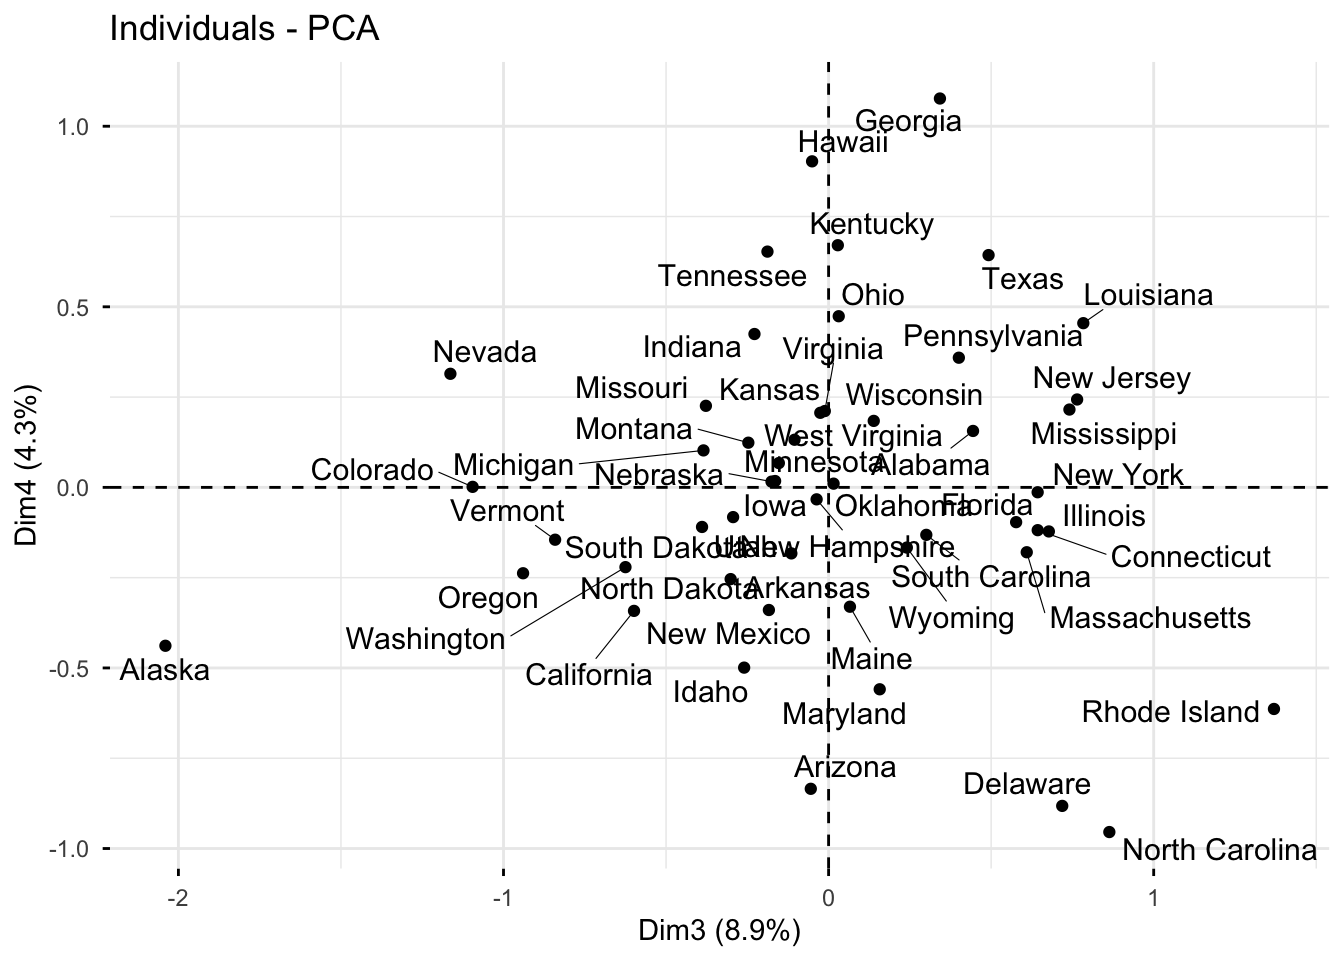
Nous pouvons déjà utiliser une variable externe pour colorer nos points, en l’occurrence la région (à mettre dans col.ind si elle n’est pas présente dans le jeu de données qui a servi à l’ACP) :
fviz_pca_ind(pca_res, repel=TRUE, col.ind=states_df$region)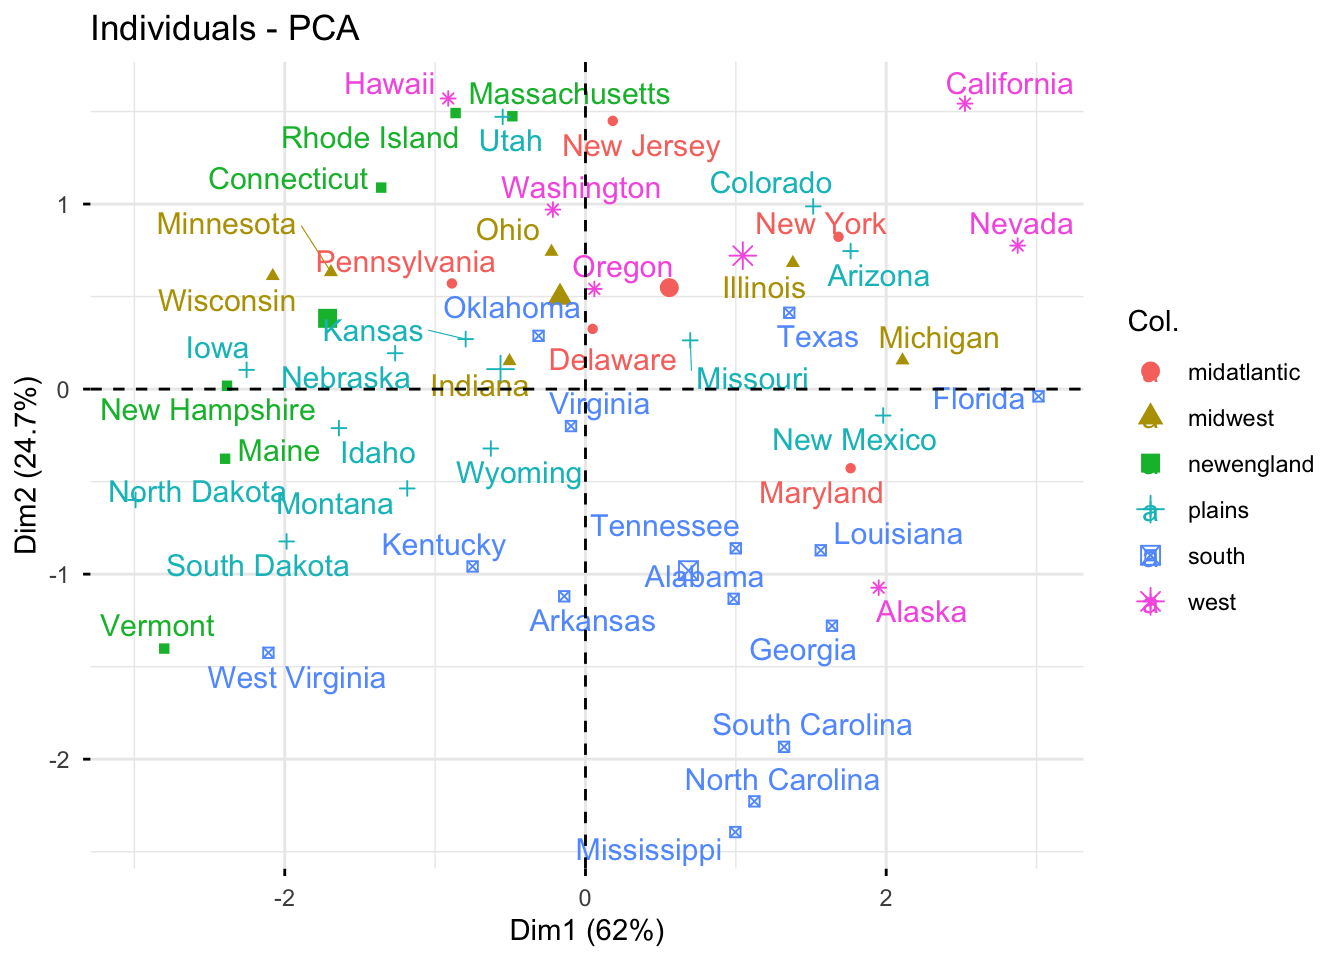
On voit que cette dernier semble expliquer en partie la variance. Nous verrons plus loin si notre clustering va trouver des groupes similaires.
2.4 Détermination du nombre de groupes
Une des grandes difficultés du k-means (et des méthodes de clustering en général) est de définir le nombre de groupes \(k\) à priori. On peut pour cela s’aider de plusieurs indices mathématiques qui évaluent la qualité du clustering résultant. La librairie factoextra en propose trois.
2.4.1 Le critère de la Silhouette
L’indice de la silhouette local est calculé pour chaque point \(i\), il s’agit de : \[ \text{sil}_i = \frac{b_i - a_i}{\max(a_i, b_i)}\] où \(a_i\) est la distance moyenne entre le point \(i\) et les autres points de son propre cluster, et \(b_i\) est la distance moyenne entre le point \(i\) et les points du cluster le plus proche (celui auquel il n’appartient pas). Une valeur proche de 1 indique un point très bien classé, 0 un point ambigu, et -1 un point mal classé.
L’indice de la silhoutte global est la moyenne de ces score de silouettes locaux : \[ \text{sil} = \frac{1}{n} \sum_{i=1}^n \text{sil}_i\]
Utilise le critère de la silhouette consiste à sélectionner le nombre de groupes \(k\) tel que cet indice soit maximal. On peut le faire aisémant avec la fonction fviz_nbclust() du package factoextra :
fviz_nbclust(clustering_df, kmeans) +
  labs(title="Silhouette pour déterminer k")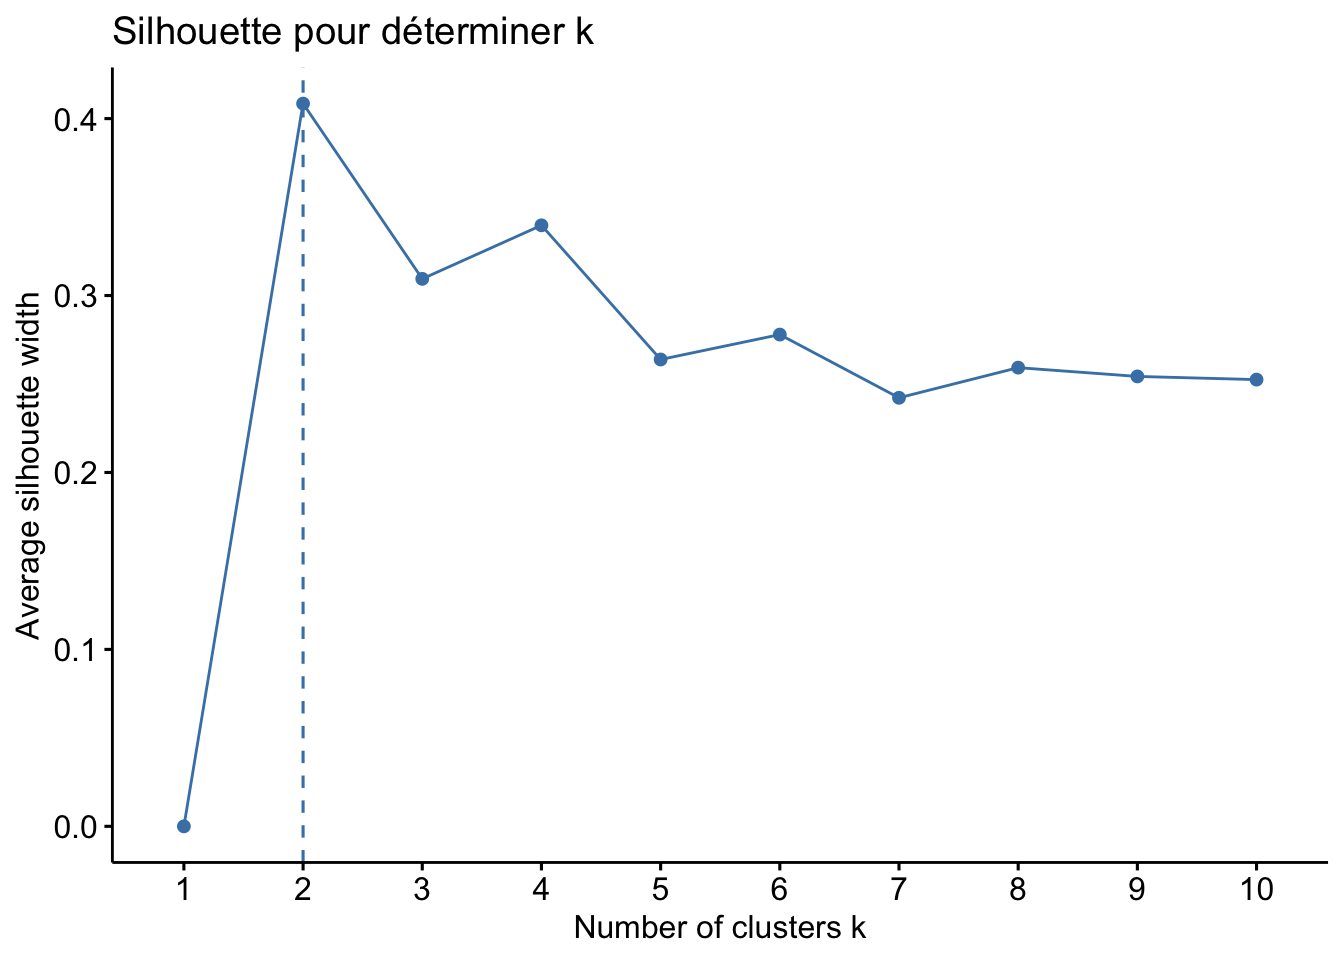
Ici, la méthode de la silhouette nous suggère \(k=2\).
2.4.2 La méthode du coude sur l’inertie intra-groupe
Le principe même du k-means est de minimiser l’inertie intra-groupe (WSS pour Within-cluster Sum of Squares), c’est-à-dire la somme des distances au carré entre les points et leur centroïde. En augmentant le nombre de groupes, on diminue forcément cette inertie, mais à un moment donné, l’amélioration devient marginale. La méthode du coude consiste à tracer l’inertie intra-groupe en fonction du nombre de groupes et à chercher le “coude” dans la courbe, c’est-à-dire le point où l’amélioration devient moins significative :
fviz_nbclust(clustering_df, kmeans, method="wss") +
  labs(title="Méthode du coude pour déterminer k")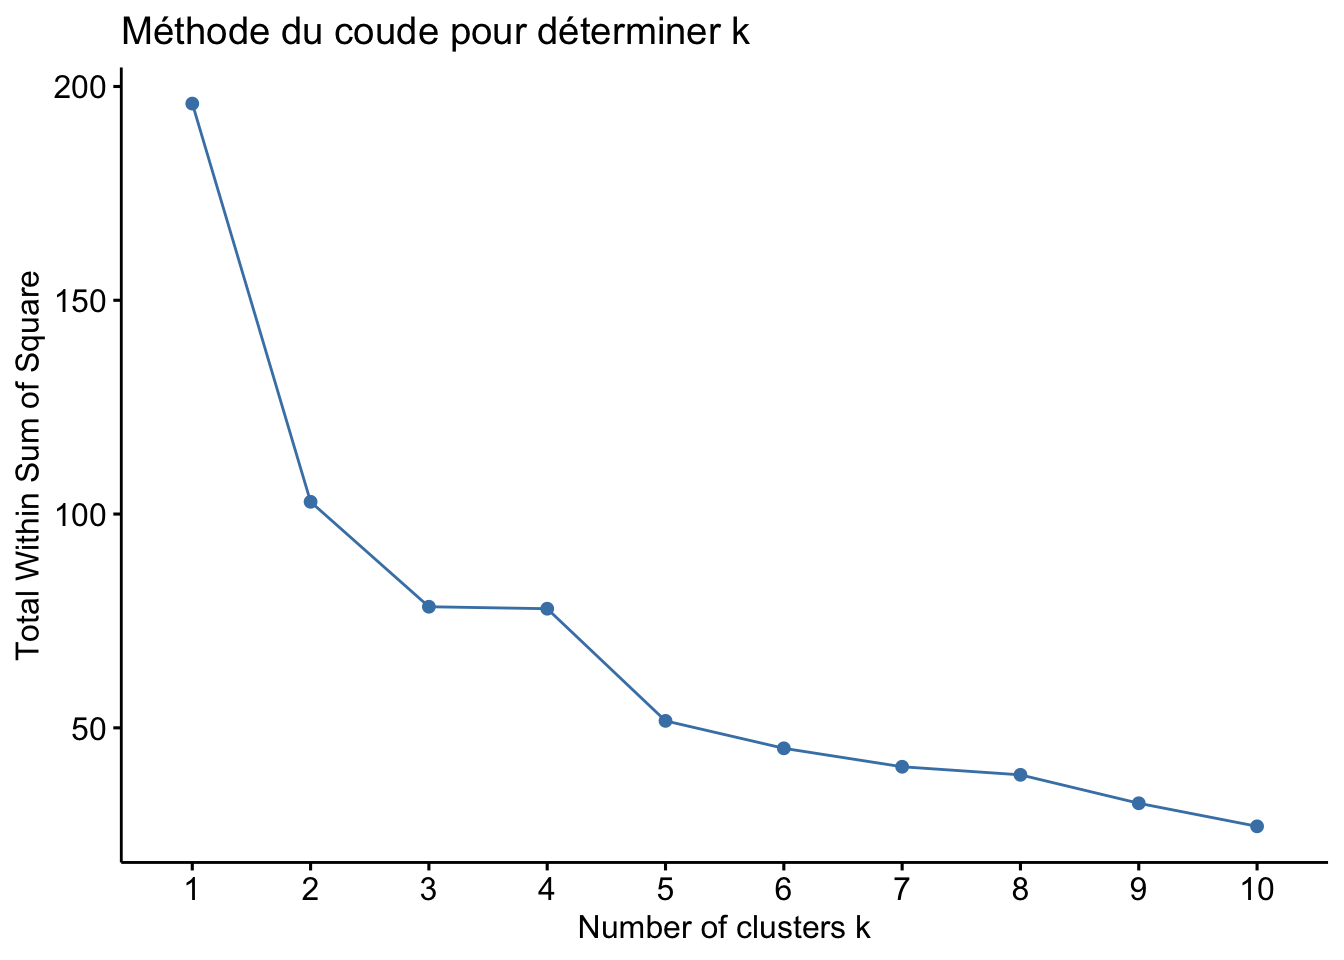
Ici, le résultat semble faire apparaître un coude à \(k=4\).
2.4.3 La Gap statistic
Cette méthode compare l’inertie intra-groupe de vos données réelles avec celle d’une distribution de référence aléatoire sans aucune structure de cluster. L’algorithme génère des données uniformément réparties, effectue un cluserting, et calcule la moyenne du logarithme de l’inertie intra-groupe. Le “Gap” est la différence entre ce log(WSS) espéré et le log(WSS) observé sur vos vraies données.
On choisit la valeur de k qui maximise la statistique Gap. Plus précisément, l’algorithme sélectionne souvent la plus petite valeur de k pour laquelle le Gap est supérieur ou égal au Gap de k+1 moins son écart-type. C’est la méthode la plus robuste statistiquement des trois :
fviz_nbclust(clustering_df, kmeans, method="gap_stat") +
  labs(title="Gap statistic pour déterminer k")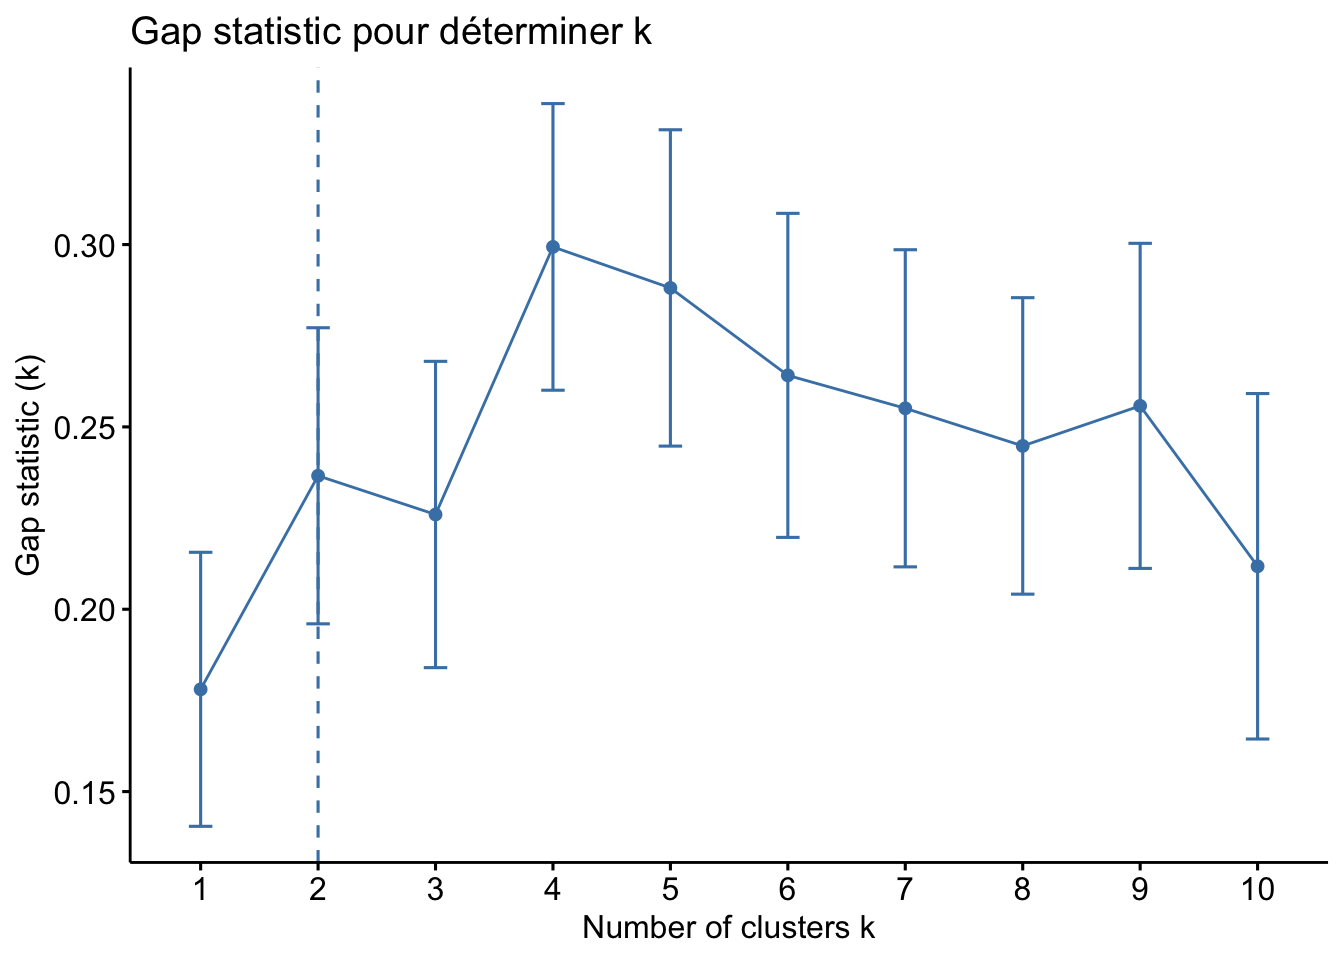
La méthode suggère ici de prendre \(k=2\), mais il y a aussi un pic significatif à \(k=4\).
Ces trois critères montrent que le nombre de groupes optimal se situe entre 2 et 4. Nous allons opter ici pour 4 groupes, pour avoir une granularité un peu plus intéressante qu’avec 2 groupes.
2.5 Résultats du k-means
Dans R, le k-means s’effectue avec la fonction kmeans() (nous l’avions déjà utilisée dans les arguements de fviz_nbclust()) :
kmeans_res = kmeans(clustering_df, centers=4, nstart=25)L’argument nstart=25 dit à R de faire 25 initialisations différentes du k-means et de garder le résultat avec la plus faible inertie intra-groupe. C’est une bonne pratique pour éviter de tomber sur un résultat sous-optimal.
Le résultat de kmeans() contient plusieurs éléments, dont l’appartenance des points aux clusters. Pour voir ce que nous pouvons en extraire (comme souvent, avec $), il suffit d’afficher le résultat :
kmeans_resK-means clustering with 4 clusters of sizes 13, 13, 16, 8
Cluster means:
Murder Assault UrbanPop Rape
1 -0.9615407 -1.1066010 -0.9301069 -0.96676331
2 0.6950701 1.0394414 0.7226370 1.27693964
3 -0.4894375 -0.3826001 0.5758298 -0.26165379
4 1.4118898 0.8743346 -0.8145211 0.01927104
Clustering vector:
Alabama Alaska Arizona Arkansas California
4 2 2 4 2
Colorado Connecticut Delaware Florida Georgia
2 3 3 2 4
Hawaii Idaho Illinois Indiana Iowa
3 1 2 3 1
Kansas Kentucky Louisiana Maine Maryland
3 1 4 1 2
Massachusetts Michigan Minnesota Mississippi Missouri
3 2 1 4 2
Montana Nebraska Nevada New Hampshire New Jersey
1 1 2 1 3
New Mexico New York North Carolina North Dakota Ohio
2 2 4 1 3
Oklahoma Oregon Pennsylvania Rhode Island South Carolina
3 3 3 3 4
South Dakota Tennessee Texas Utah Vermont
1 4 2 3 1
Virginia Washington West Virginia Wisconsin Wyoming
3 3 1 1 3
Within cluster sum of squares by cluster:
[1] 11.952463 19.922437 16.212213 8.316061
(between_SS / total_SS = 71.2 %)
Available components:
[1] "cluster" "centers" "totss" "withinss" "tot.withinss"
[6] "betweenss" "size" "iter" "ifault" Encore une fois, factoextra possède une fonction, nommée fviz_cluster(), qui permet de visualiser les résultats d’un clustering de manière pertinente. Cette fonction effectue automatiquement une ACP en arrière-plan pour projeter nos données dans le plan :
fviz_cluster(kmeans_res, data=clustering_df,
             repel=TRUE
)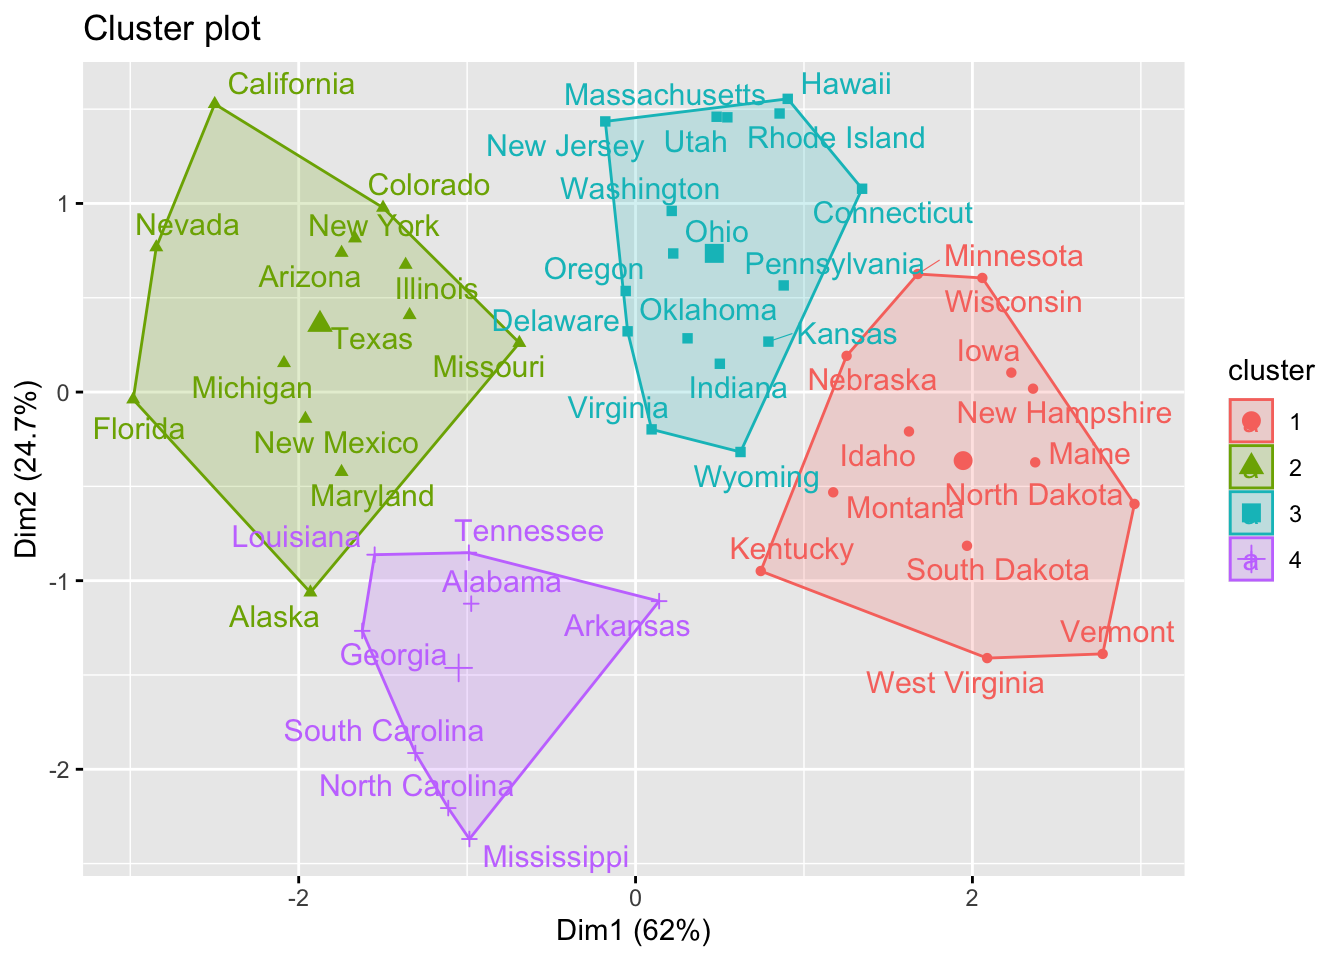
Cette fonction affiche les centroides et les frontières des groupes, tout ceci dans le plan factoriel. N’hésitez pas à consulter son aide pour voir toutes les possibilités qu’elle offre.
2.6 Liens entre les clusters et les variables
Une (autre) des difficultés du clustering et de pouvoir interpréter ce que signifient et ce que contiennent les clusters trouvés. Si notre jeu de données est suffisamment petit, l’observation visuelle des clusters ou l’études de quelques indivus qui les composent peut suffire. Cependant, il est souvent nécessaire de faire une étude statistique complémentaire pour voir si les clusters sont liés ou non à différentes variables, qu’elles aient servi au clustering ou non. Nous allons faire cette étude ici.
Pour commencer, nous allons mettre le résultat du clustering dans notre jeu de données initial (dans la variable clusters), afin d’avoir toutes les données au même endroit :
states_w_res_df = states_df %>%
  mutate(clusters = factor(kmeans_res$cluster))
2.6.1 Liens entre clusters et variables numériques
L’étude des liens entre clusters et variables numériques (utilisées pour le custering ou non) se fait en deux étapes :
On utilise un test du F-ratio (numérique x catégorielle) pour voir la force du lien ainsi que sa sifnificativité.
On étudie les moyennes par groupe des variables numériques pour voir les profils types de chaque groupe.
Concernant les variables qui ont été utilisés dans le clustering, il y a de fortes chances qu’elles soient fortement liées à nos clusters. Cependant, on peut se demander si certaines ont été plus discriminantes que d’autres. On commence donc par faire des tests du F-ratio pour toutes les variables de criminalité :
summary(aov(Murder ~ clusters, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters 3 722.4 240.8 53.47 4.93e-15 ***
Residuals 46 207.2 4.5
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1summary(aov(Assault ~ clusters, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters 3 266853 88951 55.7 2.38e-15 ***
Residuals 46 73460 1597
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1summary(aov(UrbanPop ~ clusters, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters 3 6002 2000.7 21.58 7.14e-09 ***
Residuals 46 4264 92.7
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1summary(aov(Rape ~ clusters, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters 3 3022 1007.3 36.29 3.48e-12 ***
Residuals 46 1277 27.8
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1On observe que toutes ces variables ont un lien très significatif (p valeur infime). Cependant, il apparait que les variables Assault (F=55.7) et Murder (F=53.47) ont un pouvoir discriminant plus grand que Rape (F=36.29) et UrbanPop (F=21.58).
Le même test effectué sur des variables supplémentaires nous donne :
summary(aov(abortion ~ clusters, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters 3 160.5 53.49 2.495 0.0716 .
Residuals 46 986.0 21.44
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1summary(aov(environment ~ clusters, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters 3 284.8 94.94 1.691 0.182
Residuals 46 2581.9 56.13 summary(aov(gay_rights ~ clusters, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters 3 0.899 0.2995 2.935 0.0432 *
Residuals 46 4.695 0.1021
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1summary(aov(families_payments ~ clusters, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters 3 835394 278465 6.424 0.001 **
Residuals 46 1993865 43345
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Cette fois-ci, on voit que seule families_payments (p=0.001) et, dans un moindre mesure, gay_rights (p=0.043) sont significatives. Les autres orientations politiques testées ne semblent pas liées à nos profils de criminalité.
Pour déterminer maintenant les profils concrets des États dans les différents clusters, ont va s’intéresser aux moyennes de ces variables au seins des différents groupes (on affiche également le nombre d’individus par cluster, pour avoir un profil plus complet) :
states_w_res_df %>%
  group_by(clusters) %>%
  summarise(n = n(),
            m_Murder = mean(Murder),
            m_Assault = mean(Assault),
            m_UrbanPop = mean(UrbanPop),
            m_Rape = mean(Rape),
            m_fpayments = mean(families_payments))
# A tibble: 4 × 7
clusters n m_Murder m_Assault m_UrbanPop m_Rape m_fpayments
<fct> <int> <dbl> <dbl> <dbl> <dbl> <dbl>
1 1 13 3.6 78.5 52.1 12.2 852.
2 2 13 10.8 257. 76 33.2 831.
3 3 16 5.66 139. 73.9 18.8 889.
4 4 8 13.9 244. 53.8 21.4 512.Pour résumer succintement :
| Cluster | Murder | Assault | UrbanPop | Rape | Payment |
|---|---|---|---|---|---|
| 1 | faible | moyen | élevé | moyen | élevé |
| 2 | élevé | élevé | élevé | élevé | élevé |
| 3 | élevé | élevé | faible | moyen | faible |
| 4 | faible | faible | faible | faible | élevé |
Ce qui illustre bien nos différents groupes.
2.6.2 Liens entre clusters et variables catégorielles
Pour voir les liens entre nos clusters et des variables catégorielles externes (liens entre variables catégorielles-catégorielles), il s’agira de construire une table de contingence et d’effectuer un test du chi2. Nous allons vérifier ici si nos clusters ont un lien avec la variable region.
On commence par construire la table de contingence :
region_clust = states_w_res_df %>%
  select(region, clusters) %>%
  table()
region_clust
clusters
region 1 2 3 4
midatlantic 0 2 3 0
midwest 2 2 2 0
newengland 3 0 3 0
plains 6 4 3 0
south 2 2 2 8
west 0 3 3 0Puis on fait un test du chi2 :
chisq.test(region_clust)Warning in chisq.test(region_clust): L’approximation du Chi-2 est peut-être
incorrecte
    Pearson's Chi-squared test

data:  region_clust
X-squared = 36.037, df = 15, p-value = 0.001746
Le test est significatif (p < 0.05), il existe bien un lien entre les clusters de criminalité et la région. On voit par exemple que le cluster 3 contient uniquement des États du sud, ce qui corrobore notre profilage (forte criminalité et faible population urbaine typique des États du Sud à cette époque).
Les liens entre variables catégorielles peuvent aussi être mesurés à l’aide d’indices issus de la théorie de l’information, généralement basés sur l’information mutuelle. Il en existe plusieurs, contenus pour la plupart dans la package aricode. Nous allons calculer ici le AMI (Adjusted Mutual Information) entre clusters et region. C’est un indice standardisé et corrigé (pour tenir compte du hasard), compris entre 0 (aucun lien) et 1 (partitions identiques) :
AMI(as.factor(states_w_res_df$region), states_w_res_df$clusters)[1] 0.1399376Le valeur de AMI=0.14 indique un lien mais faible, ce qui est cohérent avec le test du chi2 qui, bien que significatif, montre que les clusters ne sont pas complètement déterminés par la région.
3 La Classification ascendante hiérarchique (CAH)
Contrairement au k-means qui force à fixer \(k\) dès le départ, la Classification ascendante hiérarchique (CAH) propose une approche différente, qui se base sur une matrice de dissimilarité entre individus calculée en amont :
Au départ, chaque individu est considéré comme son propre groupe (ici, 50 groupes).
L’algorithme cherche les deux individus les plus proches (dissimilarité minimale) et les fusionne.
Les distances sont recalculées entre le nouveau groupe formé et les autres individus restants, en fonction d’un critère de liaison (p.ex. : saut minimal, saut maximal, méthode de Ward).
L’algorithme boucle sur l’étape 2 et 3 jusqu’à ce que tous les individus soient agglomérés dans un seul groupe.
Le résultat final illustre toutes les étapes de cet algorithme sous la forme d’un arbre de classification hiérarchique : le dendrogramme, que l’on peut a posteriori couper à la hauteur désirée pour obtenir nos groupes.
3.1 Application de la CAH
On commence par calculer la matrice des dissimilarités entre individus (ici, la distance euclidienne entre les variables standardisées) :
dist_mat = dist(clustering_df, method="euclidean")La CAH s’effectue ensuite avec la fonction hclust(), qui prend en argument la matrice de dissimilarité et le critère de liaison. Nous utilisons ici "ward.D2" : à chaque étape, la méthode de Ward fusionne les deux groupes qui feront augmenter le moins possible la variance intra-groupe. Elle a tendance à créer des clusters compacts :
cah_res = hclust(dist_mat, method="ward.D2")Si notre jeu de données et de taille raisonnable, on peut ensuite visualiser le dendrogramme avec fviz_dend() :
fviz_dend(cah_res, cex=0.5,
          main="Dendrogramme de la CAH (Méthode de Ward)")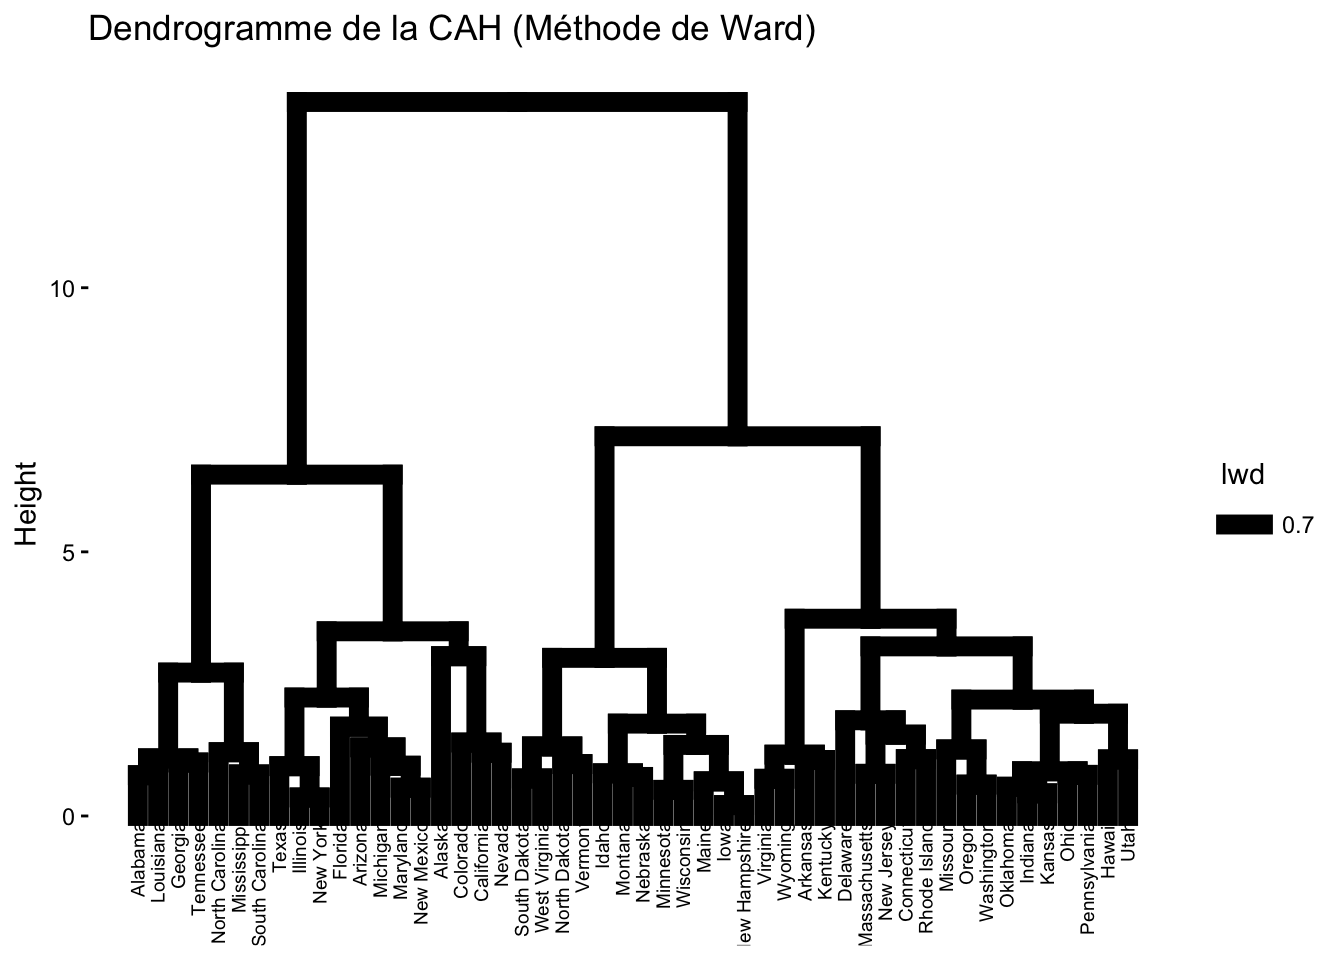
3.2 Détermination du nombre de groupes
La question est maintenant de savoir où couper cet arbre. La longueur verticale des branches représente la distance (l’hétérogénéité) entre les groupes fusionnés. On cherche généralement à couper l’arbre au niveau des branches les plus longues. Mais on peut aussi utiliser les critères vus précédemment.
Nous allons utiliser ici la méthode de la silhouette avec fviz_nbclust() (en lui passant l’argument FUN=hcut pour qu’il utilise une CAH au lieu du k-means) :
fviz_nbclust(clustering_df, FUN=hcut, method="silhouette") +
  labs(title="Silhouette pour déterminer le nombre optimal de clusters")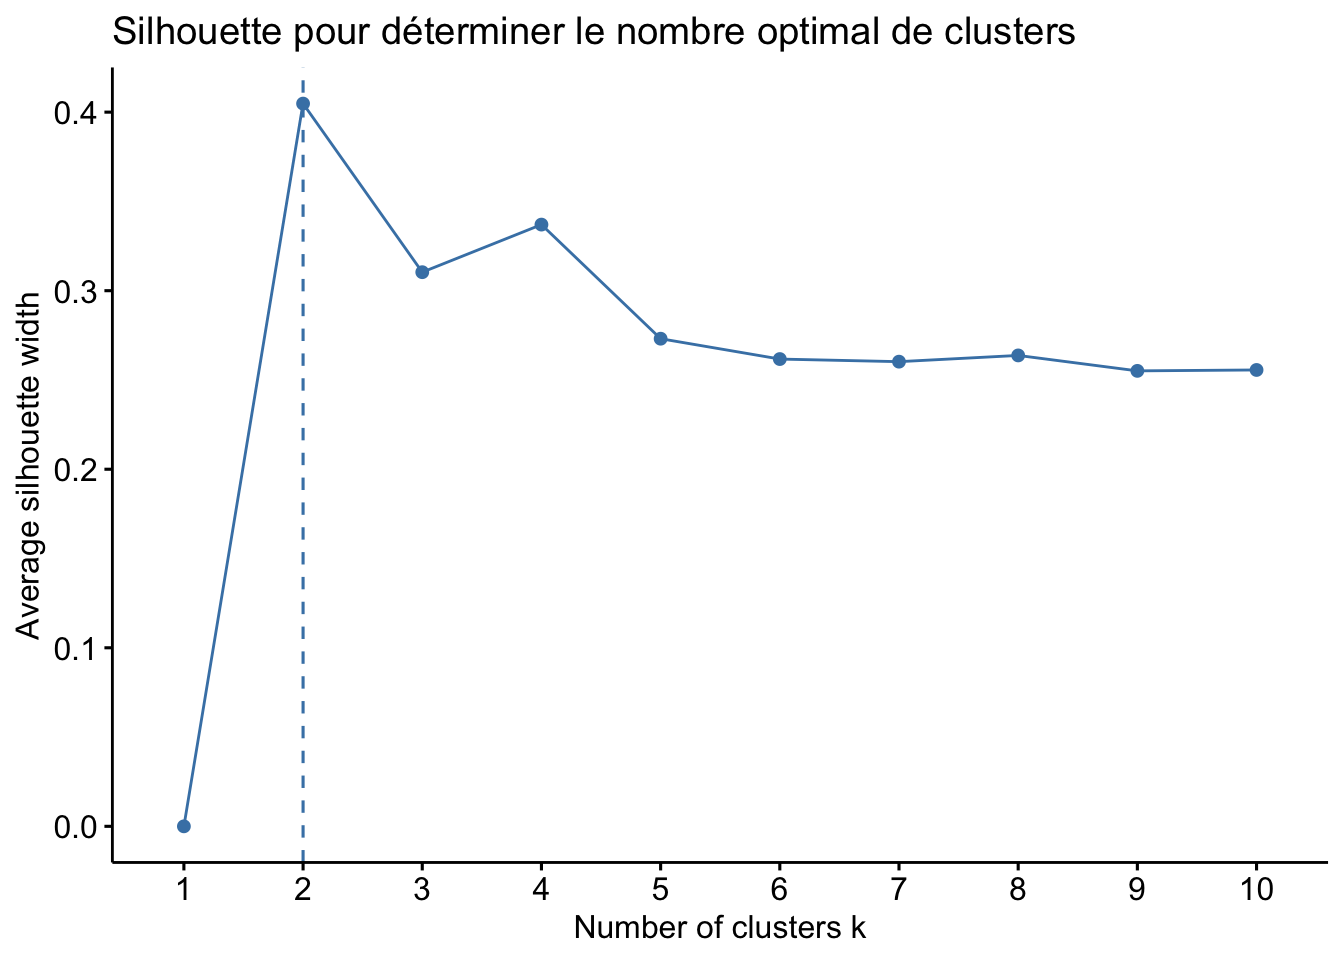
Avec ce critère, le nombre de groupes optimal est \(k=2\). On peut afficher le dendrogramme avec cette coupe dans fviz_dend():
fviz_dend(cah_res, k=2,
          cex=0.5,
          color_labels_by_k=TRUE,
          rect=TRUE,
          main="Dendrogramme coupé en 2 groupes")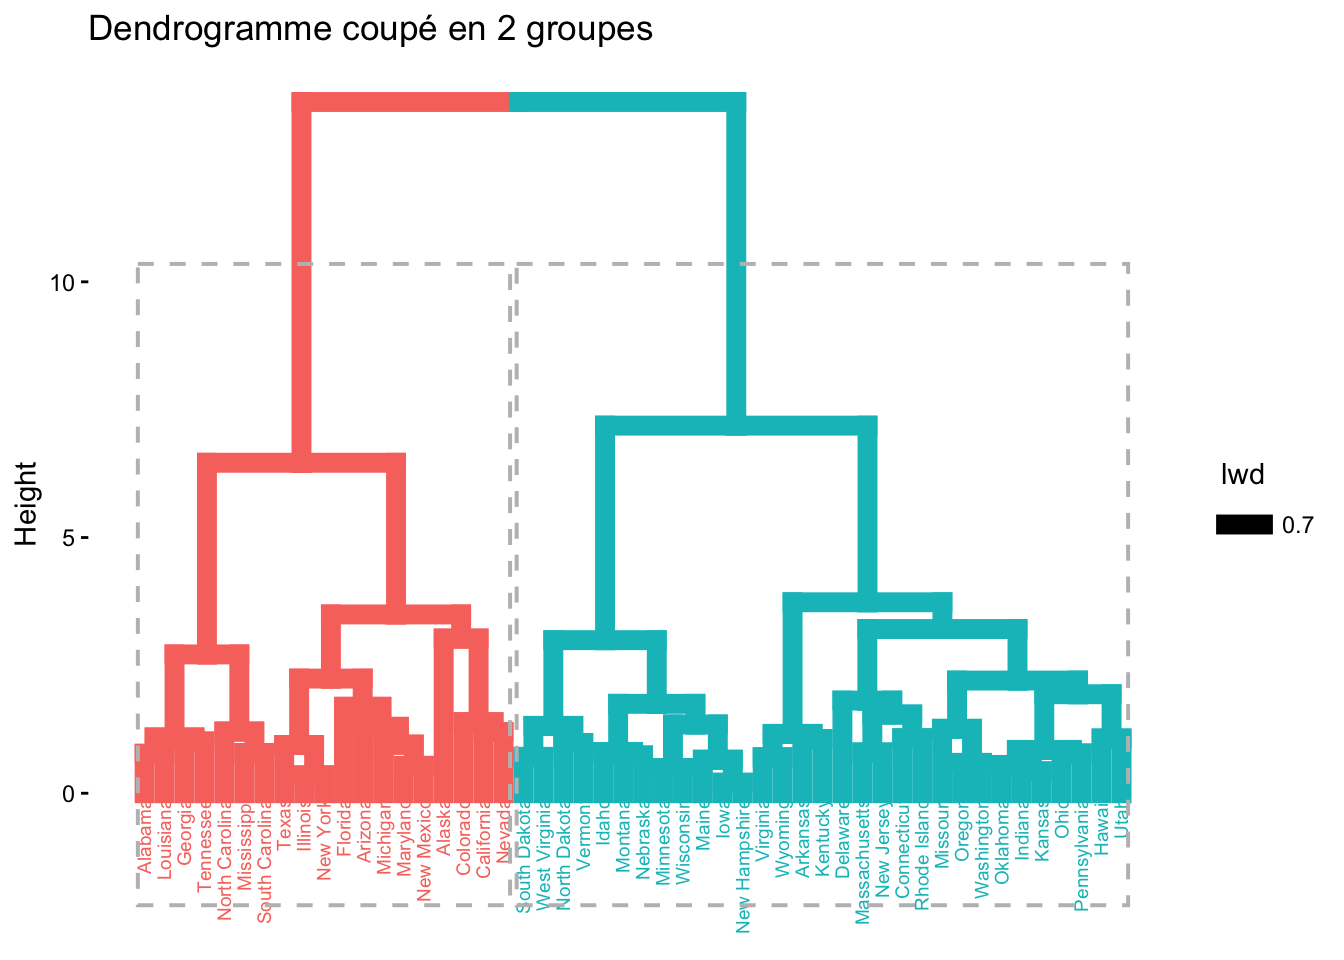
Pour extraire les groupes dans un vecteur, on utilise la fonction cutree() la hauteur correspondant à \(k=2\) :
grps_cah = cutree(cah_res, k=2)3.3 Liens entre les clusters et les variables
Comme pour le résultat du k-means, nous allons rapidement étudier les liens entre ces nouveaux clusters et nos variables. Il sera particulièrement intéressant de comparer le clustering obetnu avec la CAH (k=2) avec celui obtenu avec le k-means (k=4).
On commence par ajouter ces nouveaux clusters dans notre jeu de données étendu :
states_w_res_df = states_w_res_df %>%
  mutate(clusters2 = factor(grps_cah))
On calcule les F-ratios entre ces 2 clusters CAH et les variables numériques :
summary(aov(Murder ~ clusters2, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters2 1 632.6 632.6 102.3 1.75e-13 ***
Residuals 48 296.9 6.2
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1summary(aov(Assault ~ clusters2, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters2 1 240323 240323 115.4 2.32e-14 ***
Residuals 48 99990 2083
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1summary(aov(UrbanPop ~ clusters2, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters2 1 236 236.1 1.13 0.293
Residuals 48 10030 209.0 summary(aov(Rape ~ clusters2, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters2 1 1953 1953.3 39.98 8.04e-08 ***
Residuals 48 2345 48.9
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1summary(aov(abortion ~ clusters2, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters2 1 0.8 0.826 0.035 0.853
Residuals 48 1145.7 23.868 summary(aov(environment ~ clusters2, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters2 1 16.7 16.73 0.282 0.598
Residuals 48 2850.0 59.37 summary(aov(gay_rights ~ clusters2, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters2 1 0.138 0.1380 1.214 0.276
Residuals 48 5.456 0.1137 summary(aov(families_payments ~ clusters2, states_w_res_df)) Df Sum Sq Mean Sq F value Pr(>F)
clusters2 1 180759 180759 3.276 0.0766 .
Residuals 48 2648500 55177
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Curieusement, en séparant les données en seulement 2 grands groupes, la variable UrbanPop n’est plus du tout significative (p=0.29). Les deux groupes se sont formés purement sur l’axe de la criminalité. De plus, aucune des variables externes n’est significative à ce niveau de granularité.
Regardons les moyennes des variables criminelles pour ces deux clusters :
states_w_res_df %>%
  group_by(clusters2) %>%
  summarise(n = n(),
            m_Murder = mean(Murder),
            m_Assault = mean(Assault),
            m_Rape = mean(Rape))
# A tibble: 2 × 5
clusters2 n m_Murder m_Assault m_Rape
<fct> <int> <dbl> <dbl> <dbl>
1 1 19 12.3 259. 29.2
2 2 31 5.00 116. 16.3Ces deux grands clusters séparent de manière évidente et binaire les États avec une très forte criminalité globale (groupe 1) des États avec une faible criminalité (groupe 2).
Regardons s’il y a un lien entre la CAH et la variable région :
region_clust2 = states_w_res_df %>%
  select(region, clusters2) %>%
  table()
region_clust2
clusters2
region 1 2
midatlantic 2 3
midwest 2 4
newengland 0 6
plains 3 10
south 9 5
west 3 3chisq.test(region_clust2)Warning in chisq.test(region_clust2): L’approximation du Chi-2 est peut-être
incorrecte
    Pearson's Chi-squared test

data:  region_clust2
X-squared = 9.4427, df = 5, p-value = 0.09266AMI(as.factor(states_w_res_df$region), states_w_res_df$clusters2)[1] 0.0350692Le lien n’est pas significatif et l’information mutuelle ajustée est très faible. La région géographique est donc un mauvais prédicteur de cette séparation binaire.
Pour finir, comparons nos deux méthodologies de partitionnement :
clust_clust= states_w_res_df %>%
  select(clusters, clusters2) %>%
  table()
clust_clust
clusters2
clusters 1 2
1 0 13
2 12 1
3 0 16
4 7 1chisq.test(clust_clust)Warning in chisq.test(clust_clust): L’approximation du Chi-2 est peut-être
incorrecte
    Pearson's Chi-squared test

data:  clust_clust
X-squared = 42.368, df = 3, p-value = 3.352e-09AMI(as.factor(states_w_res_df$clusters), as.factor(states_w_res_df$clusters2))[1] 0.3778938Le lien est très fort (AMI = 0.38, p-value microscopique). En observant la table de contingence, on constate que la CAH a agi comme une “méta-classification” des k-means : les clusters 1 et 4 des k-means sont complètement inclus dans le macro-cluster 2 de la CAH, et à deux exceptions près, les clusters 2 et 3 du k-means forment le macro-cluster 1 de la CAH.
4 AFC et Clustering sur des données textuelles
Comme vu dans le cours précédant, Une matrice document-terme est généralement immense et l’AFC permet de résumer efficacement les profils des documents. Cependant, nous avons vu que les régions du biplot n’étaient pas si facile à interpréter au niveau des termes, car ceux-ci sont très nombreux et difficile à afficher simultanément.
Une des solutions à ce problème consiste à utiliser les coordonnées factorielles sur les termes pour faire un clustering sur les termes, afin d’associer les mots utilisés conjointement par plusieurs documents. Ce clustering nous permet ensuite de décrire certaines régions du biplot.
Cette approche a de forts liens avec le domaine du topic modeling en NLP, qui cherche à trouver des “thèmes” ou “topics” dans un corpus de textes. Nos clusters de termes trouvés par cette méthode peuvent être interprétés comme des thèmes récurrents dans les documents.
Nous allons utiliser ici la matrice document-terme manifesto_dtf.csv, déjà utilisée lors du cours précédant, qui contient les manifestes politiques de 9 partis politiques français écrits en 2017.
4.1 L’AFC
On charge la matrice document-terme :
dtf = read_csv("data/manifesto_dtf.csv") %>%
  column_to_rownames("doc_id")
Rows: 9 Columns: 7567
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
chr (1): doc_id
dbl (7566): emmanuel, macron, président, retrouver, esprit, conquête, bâtir,...
ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.as_tibble(dtf)# A tibble: 9 × 7,566
emmanuel macron président retrouver esprit conquête bâtir france nouvelle
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 1 1 3 2 4 2 2 21 5
2 0 0 0 1 0 0 0 38 2
3 0 2 6 2 5 0 1 64 18
4 0 0 0 2 1 0 1 36 2
5 0 0 4 2 1 0 4 36 10
6 0 1 1 0 0 0 0 0 1
7 0 0 6 0 0 2 0 21 6
8 0 0 0 0 0 0 0 7 0
9 2 2 2 1 2 0 0 35 6
# ℹ 7,557 more variables: contrat <dbl>, nation <dbl>, programme <dbl>,
# construit <dbl>, vivre <dbl>, travail <dbl>, inventer <dbl>,
# nouvelles <dbl>, protections <dbl>, sommes <dbl>, condamnés <dbl>,
# choisir <dbl>, chômage <dbl>, masse <dbl>, précarisation <dbl>,
# naïfs <dbl>, savons <dbl>, vie <dbl>, progrès <dbl>, personnel <dbl>,
# collectif <dbl>, dépend <dbl>, effort <dbl>, appelle <dbl>, lorsqu <dbl>,
# pratiqué <dbl>, bonnes <dbl>, conditions <dbl>, correctement <dbl>, …Puis on effectue l’AFC, avec, comme vu la dernière fois, le document parti_communiste_francais comme ligne supplémentaire :
ca_res = CA(dtf + 1e-50, graph=F, row.sup=6)On affiche ensuite le biplot avec les 30 mots les plus contributifs sur les 2 premiers axes :
fviz_ca_biplot(ca_res, repel=T, select.col=list(contrib=30))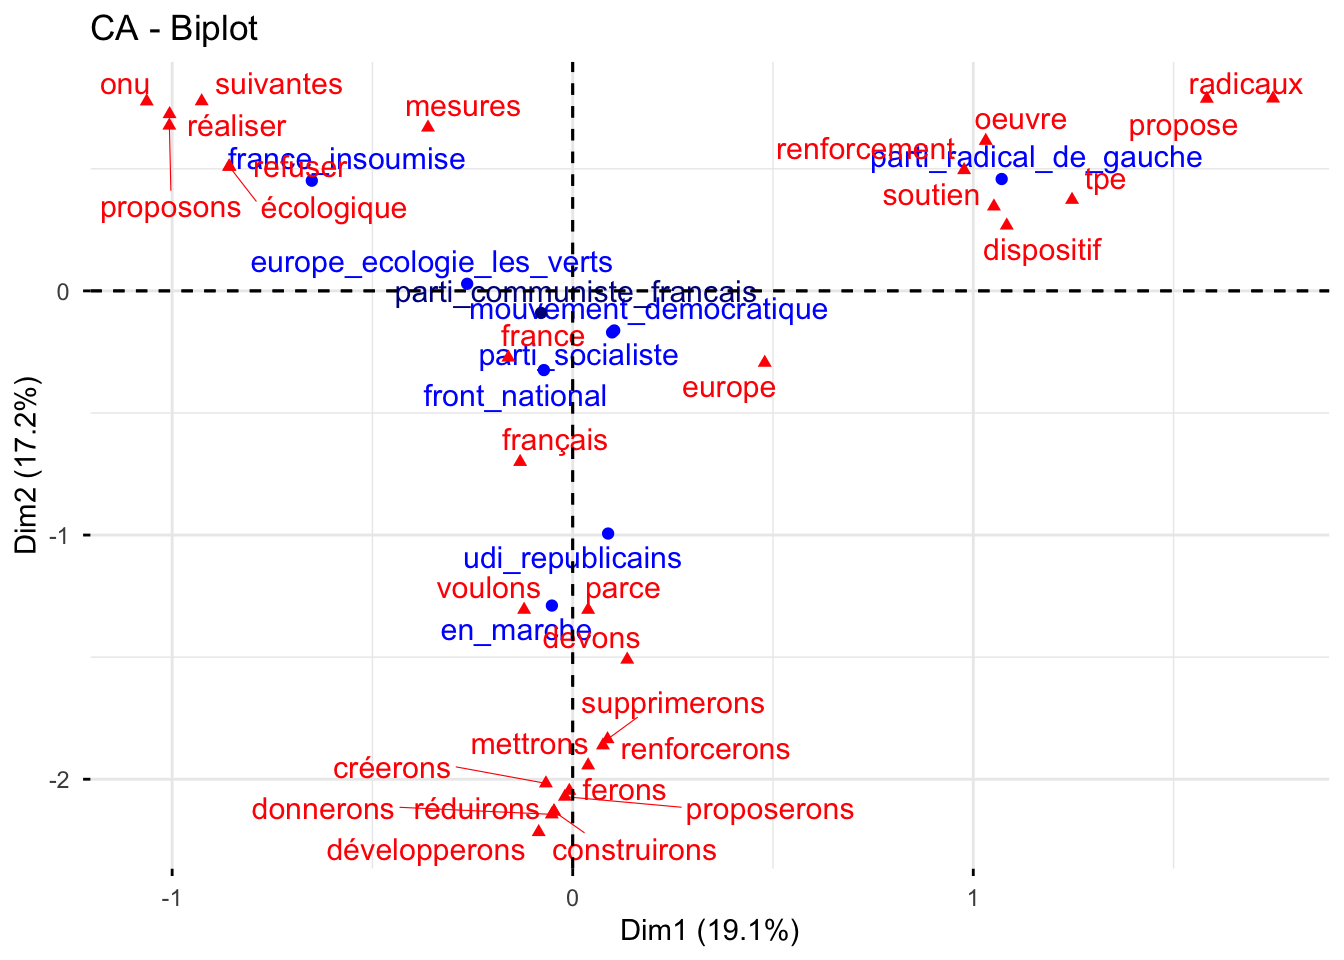
4.2 La CAH sur les termes
Pour faire le clustering sur les termes, on va utiliser les coordonnées factorielles des termes sur les 2 premiers axes de l’AFC. Ces coordonnées résument bien la position de chaque terme dans l’espace factoriel et le fait de ne pas toutes les prendre permet d’éliminer en grande partie le “bruit” présent dans les données :
word_coords = ca_res$col$coord[, 1:2]On effectue cette fois le clustering hiérachique avec la fonction HCPC() du package FactoMineR, qui est une fonction très pratique pour faire du clustering hiérarchique sur des données factorielles. L’argument nb.clust=-1 dit à la fonction de déterminer automatiquement le nombre optimal de clusters (selon un critère maison, voir l’aide) :
hcpc_res = HCPC(as.data.frame(word_coords), nb.clust = -1, graph = FALSE)
clust_grp = hcpc_res$data.clust$clust
On examine la taille des différents clusters :
table(clust_grp)clust_grp
1 2 3 4
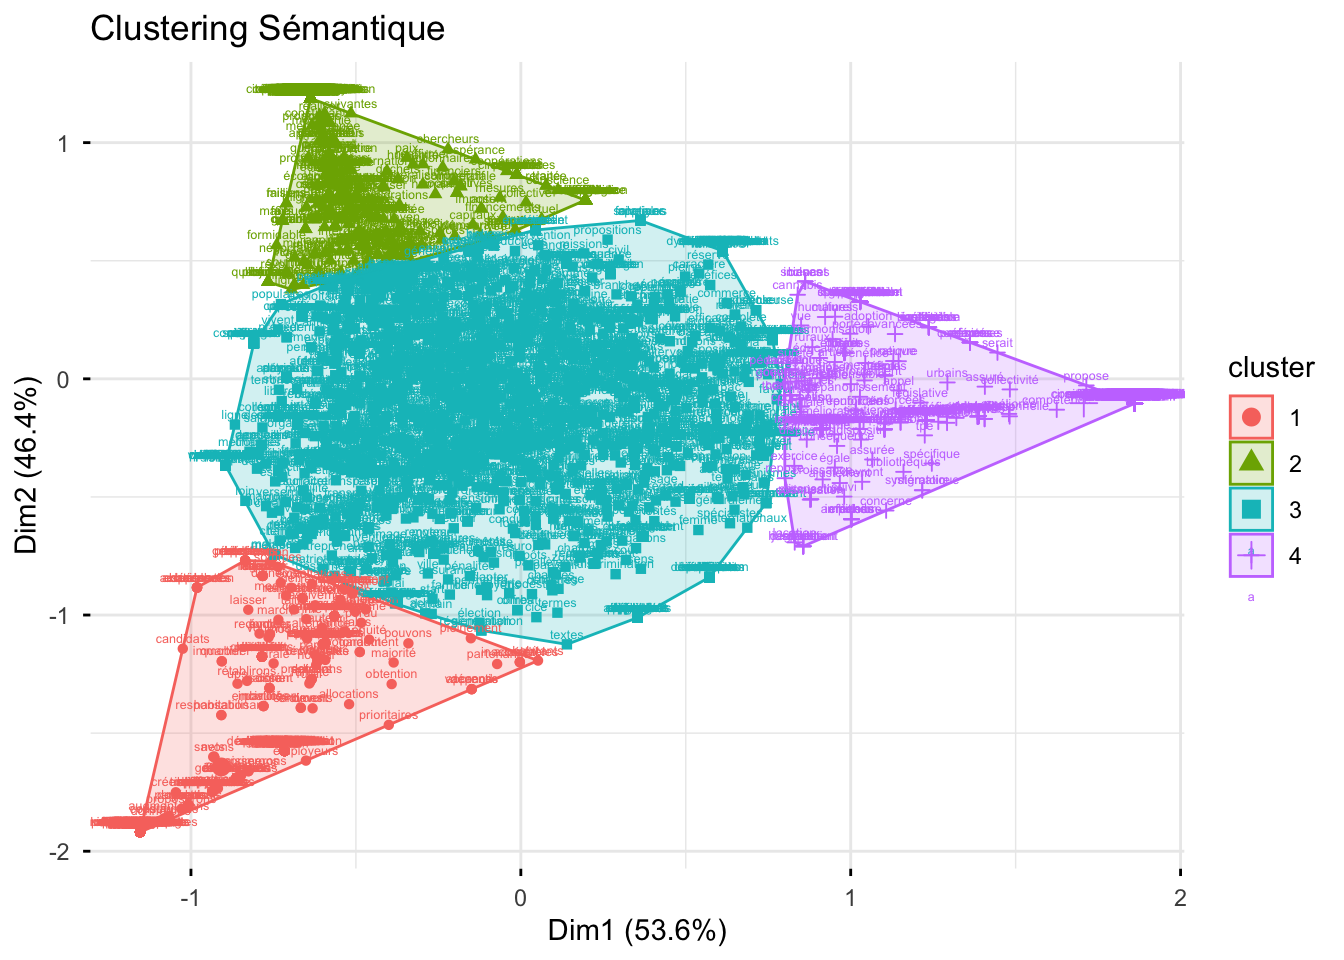
902 1883 3393 1388 Cependant, si l’on essaye de les visualiser, il y a trop de termes présents pour comprendre le résultat :
fviz_cluster(hcpc_res,
             show.clust.cent = TRUE,
             ggtheme = theme_minimal(),
             main = "Clustering Sémantique",
             labelsize=5
)
4.3 Caractérisation des clusters et affichage
Pour caractériser les clusters, on peut regarder les termes qui les composent, et en particulier les termes les plus proches des centres (les plus “typiques”).
On commence par calculer les coordonnées des centroïdes de chaque cluster (la fonction aggregate() permet de calculer une fonction par groupe) :
centroids = aggregate(word_coords, by=list(cluster=clust_grp), FUN=mean)On calcule maintenant, de manière optimisée pour éviter les boucles (les fonctions de type apply() sont fondamentales pour faire du R optimisé sans boucle, mais c’est un sujet avancé), la distance de chaque terme à son centroïde de cluster. On extrait ensuite les 10 termes les plus proches :
n_words = 10
closest_words = lapply(1:nrow(centroids), function(i) {
  cluster_center = as.numeric(centroids[i, -1])
  distances = apply(word_coords, 1, function(word) sqrt(sum((word - cluster_center)^2)))
  closest_indices = order(distances)[1:n_words]
  return(names(distances)[closest_indices])
})
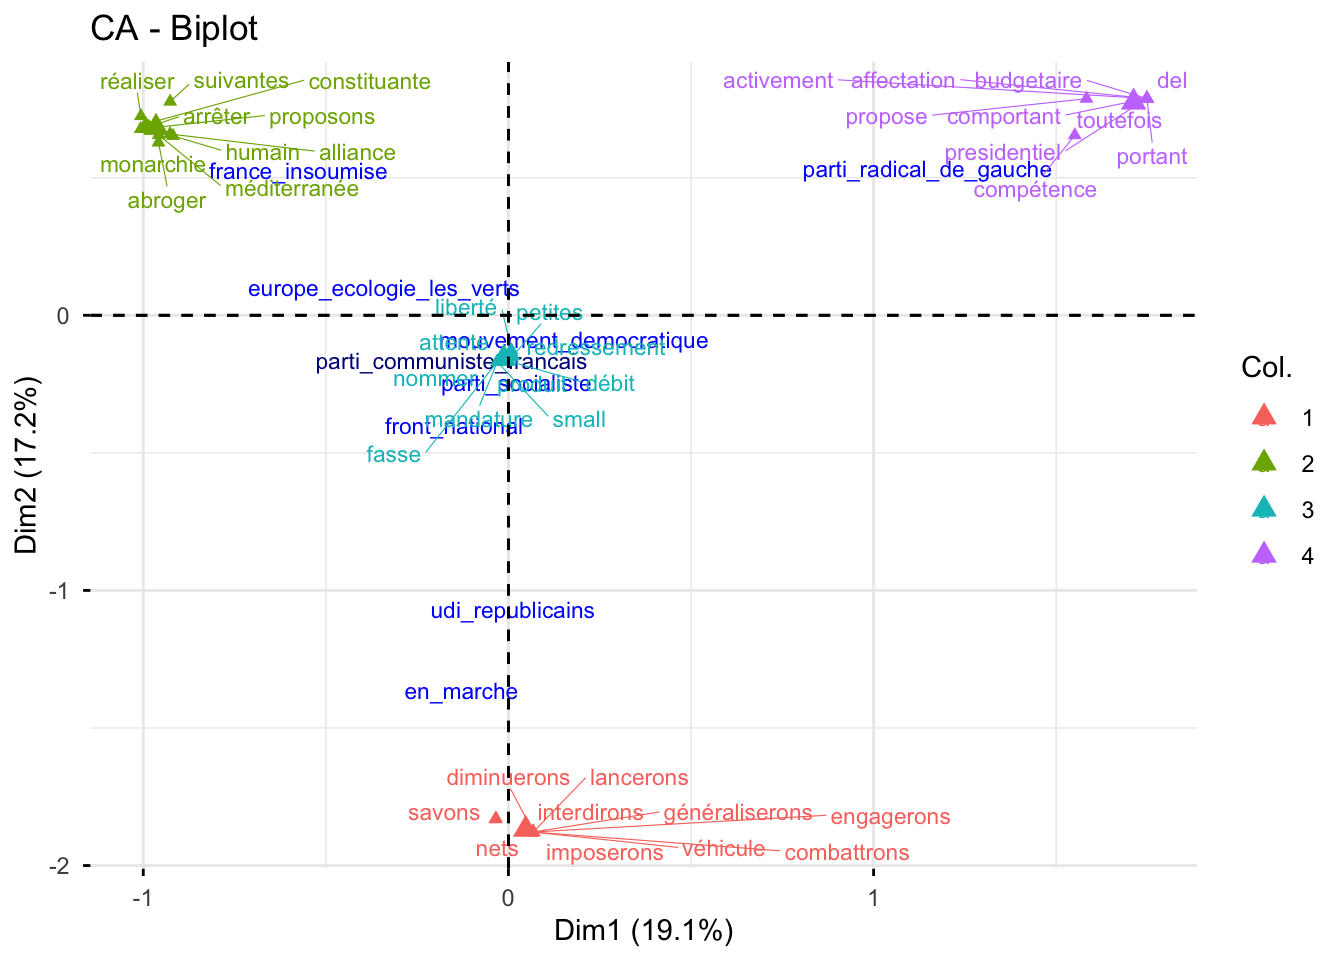
Cela nous permet d’avoir une liste des mots les plus typique par groupe :
closest_words[[1]]
[1] "nets" "savons" "engagerons" "combattrons"
[5] "véhicule" "imposerons" "interdirons" "généraliserons"
[9] "diminuerons" "lancerons"
[[2]]
[1] "constituante" "réaliser" "arrêter" "proposons" "monarchie"
[6] "méditerranée" "alliance" "suivantes" "abroger" "humain"
[[3]]
[1] "petites" "débit" "redressement" "attente" "liberté"
[6] "fasse" "produit" "mandature" "small" "nommer"
[[4]]
[1] "propose" "compétence" "activement" "comportant" "del"
[6] "toutefois" "presidentiel" "affectation" "portant" "budgetaire" On met tous ces mots dans un vecteur pour pouvoir les afficher sur le biplot :
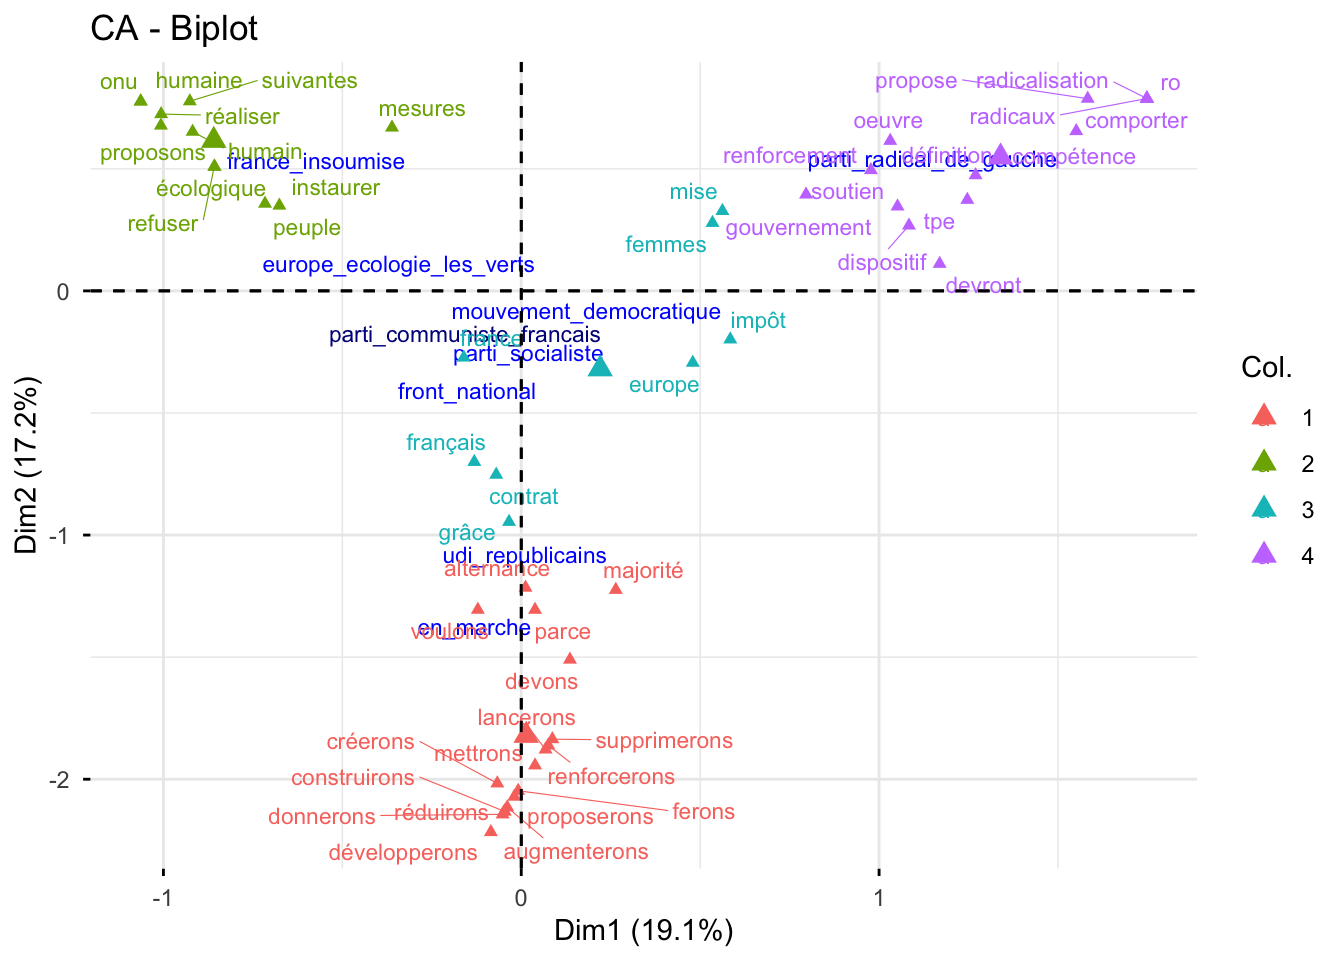
all_words = unique(unlist(closest_words))Toutes ces étapes permettent de visualiser notre biplot avec des “directions sémantiques” plus claires, grâce à l’affichage des mots les plus typiques de chaque cluster :
fviz_ca_biplot(ca_res,
               geom.row="text",
               col.col=clust_grp,
               repel=T,
               select.col=list(name=all_words),
               labelsize = 3
)
Une alternative aurait été d’afficher les 50 mots les plus contributifs et de les colorer par cluster, ce qui est moins couteux au niveau des calculs. Cependant, les mots choisis sont représentatifs du plan factoriel et non pas des clusters :
fviz_ca_biplot(ca_res,
               geom.row="text",
               col.col=clust_grp,
               repel=T,
               select.col=list(contrib=50),
               labelsize = 3
)