library(tidyverse)
library(readxl)
library(FactoMineR) # Le moteur de calcul principal
library(factoextra) # Le moteur graphique pour l'extraction et la visualisation
library(psych)      # Pour faire un test de sphéricité de Bartlett
library(ggrepel) # Permet d'améliorer la lisibilité des labels1 Introduction
Après avoir étudié des méthodes prédictives telles que la régression linéaire et logistique (expliquer \(Y\) en fonction de \(X\)), nous passons à des méthodes exploratoires : les méthodes factorielles. Nous allons en voir trois ici :
- L’Analyse en Composantes Principales (ACP)
- Le Positionnement Multidimensionnel (MDS)
- L’Analyse Factorielle des Correspondances (AFC)
Il n’y a donc plus de variable cible à prédire : l’objectif est de découvrir la structure cachée au sein d’un vaste ensemble de variables (ou même, dans le cas du MDS, de données non tabulaires).
1.1 Le tronc commun entre ces méthodes
Bien que ces trois méthodes s’appliquent à des types de données différents, les mathématiques sous-jacentes sont identiques. En effet, ces méthodes reposent sur la réduction de dimension par décomposition spectrale (calcul des valeurs propres et vecteurs propres d’une matrice, ou décomposition en valeurs singulières - SVD). Via ce mécanisme, elles essaient toutes de trouver la meilleure représentation en basse dimensionnalité de données en haute dimensionnalité.
Mais que signifie exactement cette idée de meilleure représentation ? Toutes ces méthodes recherchent en premier lieu un axe (une direction de l’espace) qui capture le maximum d’inertie (l’étalement des points) de la configuration. Ensuite, elles trouvent un deuxième axe, strictement orthogonal au premier, capturant le maximum d’inertie restante, et ainsi de suite. Au final, on obtient plusieurs axes de l’espace (les facteurs), tous orthogonaux entre eux, qui expriment l’information des données de manière décroissante et maximalement compressée sur les premiers éléments. Il suffit ensuite de ne garder que les premiers axes pour effectuer une compression avec un minimum de perte d’information.
1.2 Les différences entre les méthodes
Si la mécanique interne est la même, ce qui différencie ces méthodes est la nature des données d’entrée et la variété des sorties.
1.2.1 ACP
L’ACP s’applique à des individus possédant plusieurs variables numériques. Elle permet non seulement d’afficher les individus dans un espace compressé (la carte factorielle), mais également d’étudier les corrélations entre les axes factoriels et les variables originales (le cercle des corrélations).
1.2.2 MDS
Le MDS s’applique à des données non tabulaires, c’est-à-dire à des matrices de distances ou de dissimilarités entre les individus. Il permet de reconstruire une carte spatiale (des coordonnées) à partir de simples distances, et peut être utilisé pour n’importe quelle métrique de distance. Des objets mathématiques particuliers, comme des graphes, des séries temporelles ou des séquences ADN, peuvent ainsi être représentés dans l’espace à travers une matrice de distances.
1.2.3 AFC
L’AFC s’applique à des tableaux de contingence, c’est-à-dire à un tableau croisé entre des modalités de deux variables catégorielles. Elle utilise la distance du \(\chi^2\) pour étudier l’attraction ou la répulsion entre les différentes modalités. L’AFC est utilisée pour analyser les relations entre les profils de ces variables qualitatives, en particulier en les visualisant via une représentation superposée appelée le biplot.
1.3 Les packages de l’écosystème factoriel
Bien que R possède des fonctions natives pour faire des analyses factorielles (comme prcomp() ou cmdscale()), elles sont quelque peu limitées. L’analyse factorielle des données étant une spécialité historique de l’école statistique française, nous allons utiliser ici la suite de packages FactoMineR (http://factominer.free.fr/index_fr.html), développée par les chercheurs d’Agrocampus Ouest et qui est aujourd’hui le standard international en R :
2 L’Analyse en Composantes Principales (ACP)
Afin d’illustrer l’ACP, nous allons travailler sur les données realestate_data.xlsx (https://archive.ics.uci.edu/dataset/477/real+estate+valuation+data+set), qui contiennent des informations sur les prix de l’immobilier à Taïwan. Ce jeu de données est généralement utilisé pour prédire le prix de l’immobilier en fonction de différentes variables explicatives, mais nous allons faire plutôt une analyse exploratoire ici.
2.1 Chargement et pré-traitement des données
On commence par charger les données et jeter un coup d’oeil à leur structure :
real_estate = read_excel("data/realestate_data.xlsx")
real_estate
# A tibble: 414 × 8
No transaction_date house_age distance_to_station n_stores latitude
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 1 2013. 32 84.9 10 25.0
2 2 2013. 19.5 307. 9 25.0
3 3 2014. 13.3 562. 5 25.0
4 4 2014. 13.3 562. 5 25.0
5 5 2013. 5 391. 5 25.0
6 6 2013. 7.1 2175. 3 25.0
7 7 2013. 34.5 623. 7 25.0
8 8 2013. 20.3 288. 6 25.0
9 9 2014. 31.7 5512. 1 25.0
10 10 2013. 17.9 1783. 3 25.0
# ℹ 404 more rows
# ℹ 2 more variables: longitude <dbl>, house_price_unit <dbl>Il y a 414 observations. La variable “transaction_date” contient une date, qui n’a pas été lue correctement. On ne va garder que l’année qui se situe avant le point :
real_estate = real_estate %>%
  mutate(transaction_date = as.numeric(substr(transaction_date, 1, 4)))
Nous laissons ici la variable No, contenant le numéro de la maison. Nous le verrons plus loin, on pourra l’exclure de l’analyse et s’en servir lors de l’affichage.
2.2 Effectuer l’ACP
On effectue une ACP sur les données en utilisant la fonction PCA du package FactoMineR (mettre l’option graph=FALSE permet de ne pas afficher les graphiques par défaut) :
pca_res = PCA(real_estate, quanti.sup=1, graph=FALSE)L’argument quanti.sup=1 indique que la première variable (le numéro de la maison) est une variable quantitative supplémentaire, qui ne sera pas utilisée pour construire les axes factoriels, mais qui pourra être projetée a posteriori sur la carte factorielle. On peut également déclarer des variables catégorielles supplémentaires avec quali.sup.
La variable dans laquelle nous avons sauvegardé les résultats de l’ACP, pca_res, est un objet de classe PCA qui contient toutes les informations sur les résultats de l’ACP :
pca_res**Results for the Principal Component Analysis (PCA)**
The analysis was performed on 414 individuals, described by 8 variables
*The results are available in the following objects:
name
1 "$eig"
2 "$var"
3 "$var$coord"
4 "$var$cor"
5 "$var$cos2"
6 "$var$contrib"
7 "$ind"
8 "$ind$coord"
9 "$ind$cos2"
10 "$ind$contrib"
11 "$quanti.sup"
12 "$quanti.sup$coord"
13 "$quanti.sup$cor"
14 "$call"
15 "$call$centre"
16 "$call$ecart.type"
17 "$call$row.w"
18 "$call$col.w"
description
1 "eigenvalues"
2 "results for the variables"
3 "coord. for the variables"
4 "correlations variables - dimensions"
5 "cos2 for the variables"
6 "contributions of the variables"
7 "results for the individuals"
8 "coord. for the individuals"
9 "cos2 for the individuals"
10 "contributions of the individuals"
11 "results for the supplementary quantitative variables"
12 "coord. for the supplementary quantitative variables"
13 "correlations suppl. quantitative variables - dimensions"
14 "summary statistics"
15 "mean of the variables"
16 "standard error of the variables"
17 "weights for the individuals"
18 "weights for the variables" On peut y accéder via l’opérateur $, mais il existe des manières moins “austères” pour afficher les résultats importants. C’est ce que nous allons voir ci-dessous.
2.3 L’inertie expliquée sur chaque axe
Commençons par observer les valeurs propres qui expriment la variance expliquée sur chaque facteur (avec la fonction get_eigenvalue() de factoextra) :
eig_vals = get_eigenvalue(pca_res)
eig_vals
eigenvalue variance.percent cumulative.variance.percent
Dim.1 3.2715008 46.735726 46.73573
Dim.2 1.0771175 15.387393 62.12312
Dim.3 0.9983295 14.261850 76.38497
Dim.4 0.6361083 9.087262 85.47223
Dim.5 0.5533467 7.904953 93.37718
Dim.6 0.3185875 4.551251 97.92843
Dim.7 0.1450097 2.071567 100.00000On peut visualiser cette variance expliquée par chaque facteur avec le screegraph, via la fonction fviz_screeplot() de factoextra) :
# addlabels=T ajoute les valeurs d'inertie sur le graphique et ylim=c(0, 50) fixe les limites de l'axe des ordonnées
fviz_screeplot(pca_res, addlabels=T, ylim=c(0, 50))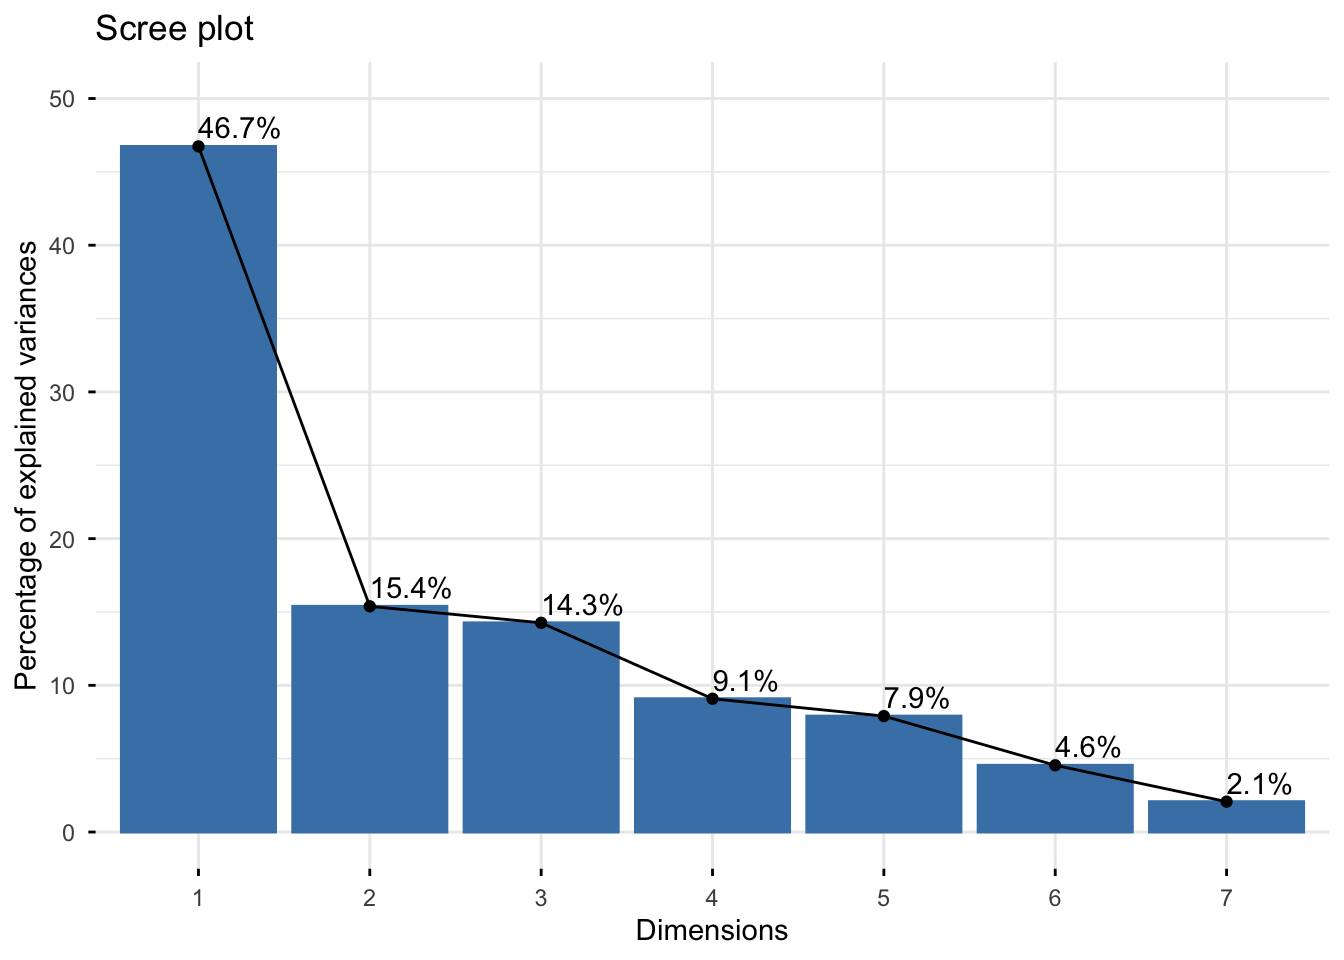
Grâce à ces éléments, on pourrait décider du nombre de facteurs selon différents critères :
- Selon le critère de Jolliffe (garder 90% de la variance), on garderait 5 facteurs.
- Selon le critère de Kaiser (valeurs propres > moyenne = 1), on garderait 2 facteurs.
- Selon le critère de Cattell ou du coude (chercher un coude dans le screegraph), on garderait 1 facteur.
Effectuons maintenant un test de Bartlett pour vérifier que l’ACP est pertinente :
cortest.bartlett(real_estate[, -1])R was not square, finding R from data$chisq
[1] 1172.576
$p.value
[1] 4.247946e-235
$df
[1] 21L’hypothèse \(H_0\) : “toutes les valeurs propres sont égales” est largement rejetée, notre ACP est donc pertinente.
2.4 Le cercle des corrélations
On peut visualiser le cercle des corrélations pour observer les contributions des variables aux différents facteurs. Ce cercle des corrélations peut être affiché via la fonction fviz_pca_var() :
# On définit des couleurs pour la somme des contributions, on rend la variable supplémentaire invisible et on active le "repel", qui empêche les superpositions
fviz_pca_var(pca_res, col.var="contrib",
             gradient.cols=c("#00AFBB", "#E7B800", "#FC4E07"),
             invisible="quanti.sup",
             repel=TRUE)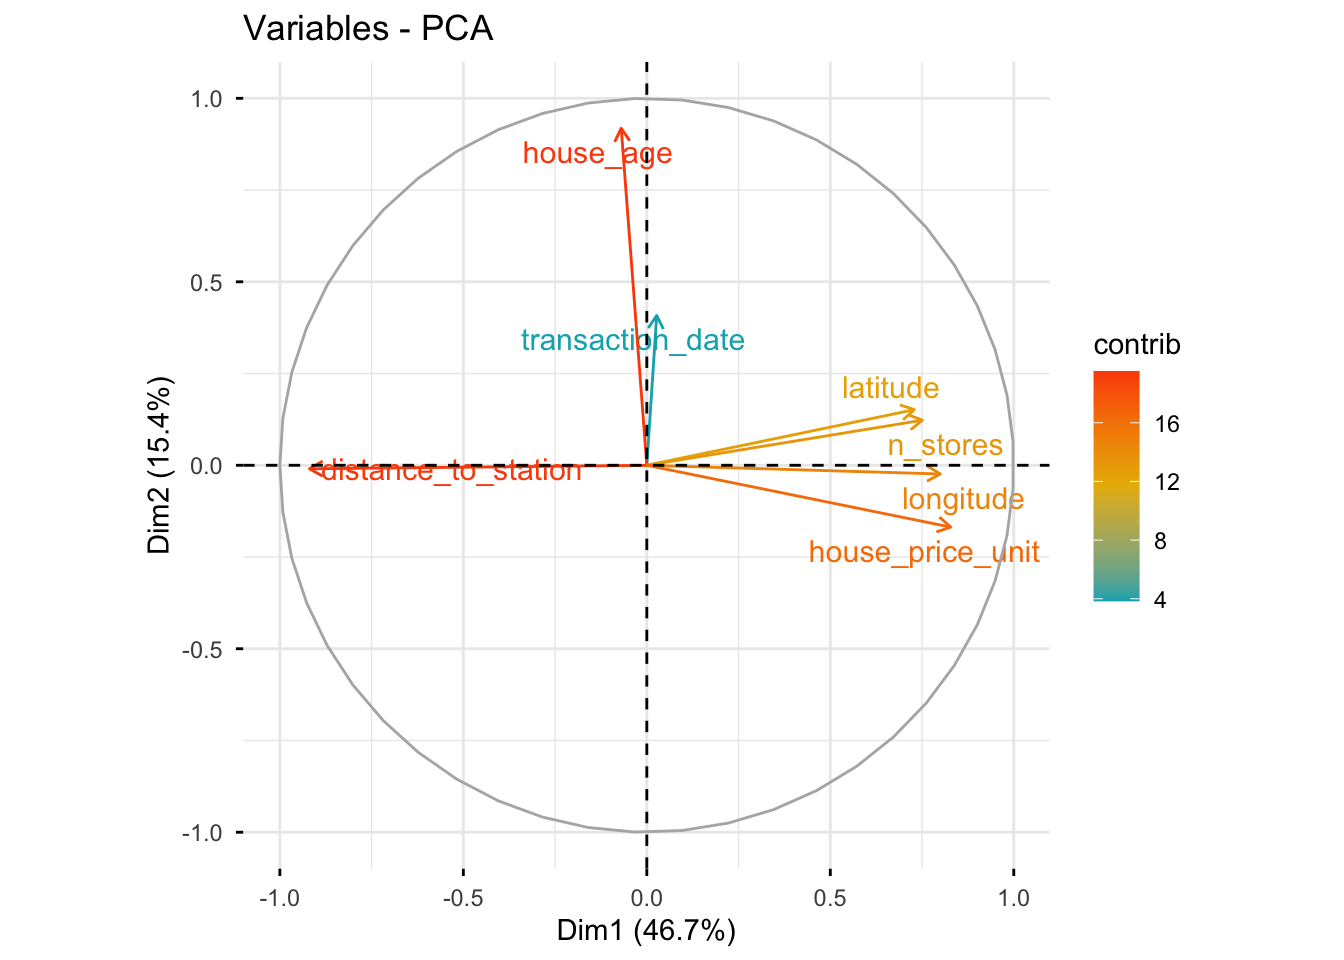
Les communalités (vues plus loin) des variables sur les deux premiers facteurs ont été utilisées pour la coloration. Ce graphique exprime 46.7% + 15.4% = 62.1% de la variance totale.
Ce graphique montre que le premier facteur comprend les variables :
- (positivement) le prix au m2
- (positivement) la latitude
- (positivement) la longitude
- (positivement) le nombre de commerces
- (négativement) la distance aux transports publics
On pourrait nommer cet axe “Attractivité du bâtiment”.
Le deuxième facteur lie :
- (positivement) âge de la maison
- (positivement) date de vente
En réalité cet axe est presque entièrement lié à l’âge de la maison, qui semble orthogonal à toutes les autres variables.
Ce graphique est basé sur les saturations (correlations entre variables et facteurs)
saturations = pca_res$var$coord[, 1:2]
saturations
Dim.1 Dim.2
transaction_date 0.02694038 0.408239197
house_age -0.06978933 0.918311455
distance_to_station -0.91903422 -0.009603627
n_stores 0.75106955 0.122938634
latitude 0.72901893 0.151597096
longitude 0.79972168 -0.023712815
house_price_unit 0.82834278 -0.168559219Les saturations carrées ou cos2 expriment le pourcentage de variance d’une variable expliquée par un facteur :
pca_res$var$cos2[, 1:2] Dim.1 Dim.2
transaction_date 0.0007257842 1.666592e-01
house_age 0.0048705500 8.432959e-01
distance_to_station 0.8446238942 9.222966e-05
n_stores 0.5641054635 1.511391e-02
latitude 0.5314686048 2.298168e-02
longitude 0.6395547589 5.622976e-04
house_price_unit 0.6861517567 2.841221e-02Et les communalités, qui sont la somme de ces dernières sur les deux premiers facteurs, expriment alors le pourcentage de variance des variables sur ces deux axes :
rowSums(pca_res$var$cos2[, 1:2]) transaction_date house_age distance_to_station n_stores
0.1673850 0.8481665 0.8447161 0.5792194
latitude longitude house_price_unit
0.5544503 0.6401171 0.7145640 On voit que les variables house_age (84.81%), distance_to_station (84.47%) et house_price_unit (71.45%) sont les mieux exprimées sur ces axes.
2.5 Coordonnées factorielles
On peut observer les coordonnées factorielles des observations sur les deux premiers facteurs avec fviz_pca_ind() :
fviz_pca_ind(pca_res)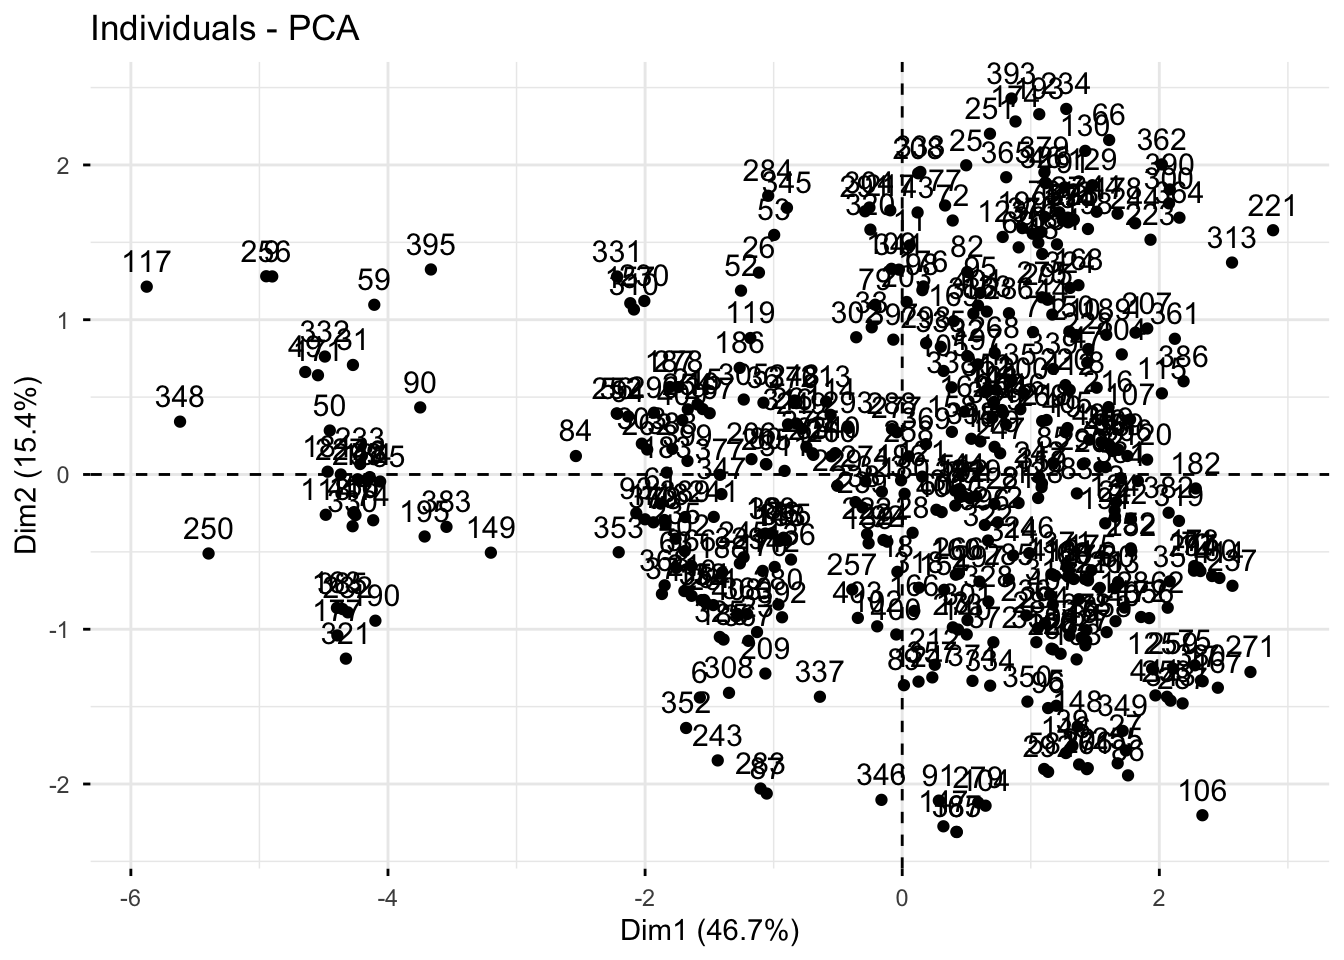
Les individus étant anonymes dans ce jeu de données, ce graphique n’est pas très informatif. On pourrait les colorer selon une variable catégorielle (en utilisant l’argument habillage="<nom_de_variable>", même si celle-ci est une variable supplémentaire), mais il n’y en a pas dans ce jeu de données.
Nous allons donc les colorer ici selon un gradient d’une des variables numériques. Commençons par house_age, qui est la variable la mieux représentée sur ces deux axes :
fviz_pca_ind(pca_res,
             geom="point",
             col.ind = real_estate$house_age,
             gradient.cols = c("#00AFBB", "#E7B800", "#FC4E07"))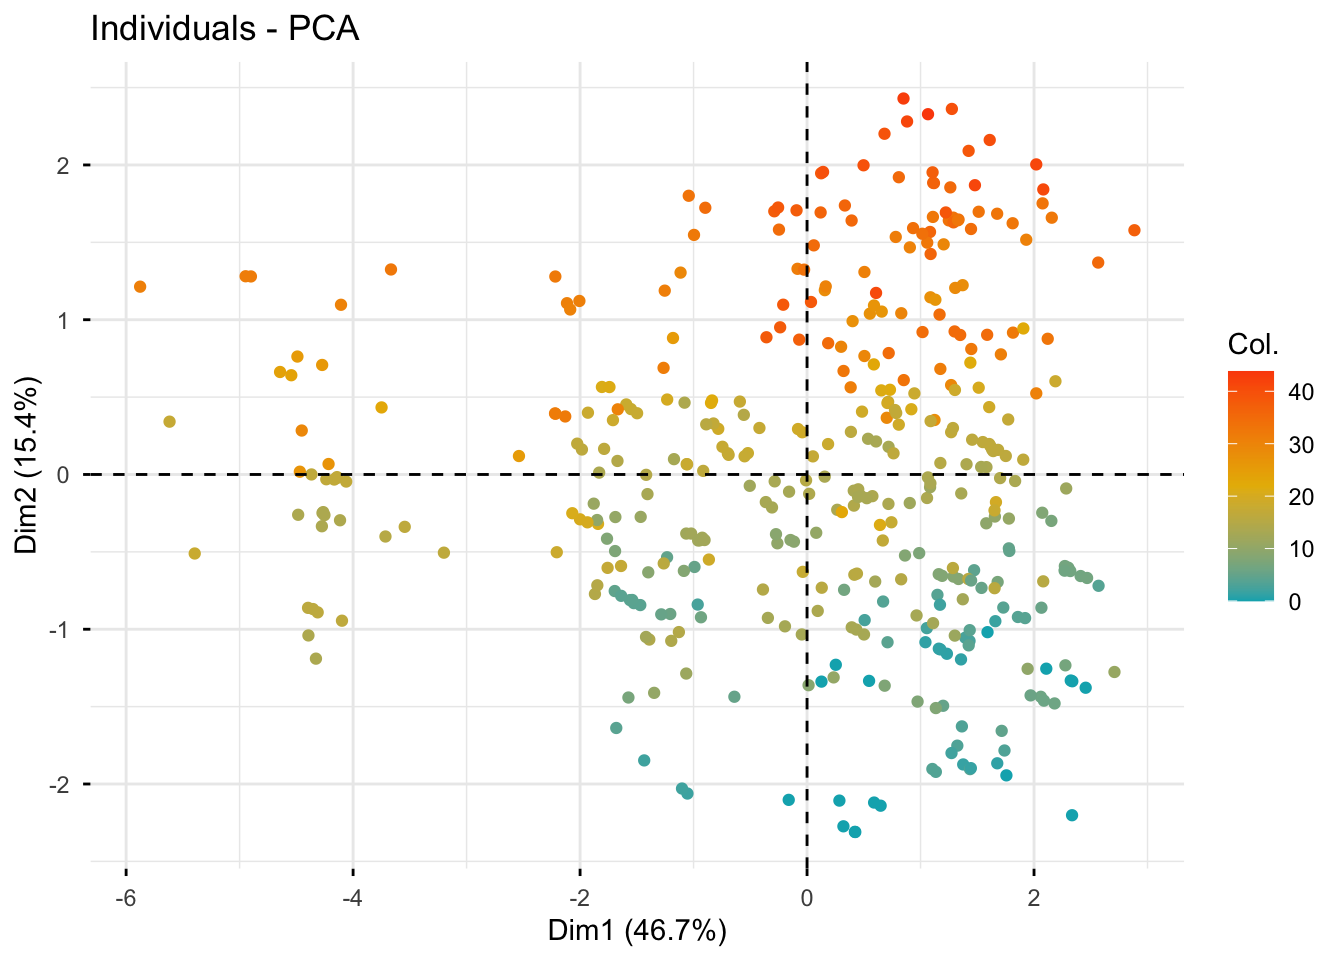
Comme attendu, les maisons plus récentes (en bleu) se situent en bas du graphique (âge faible sur le deuxième facteur).
Faisons de même avec distance_to_station.
fviz_pca_ind(pca_res,
             geom="point",
             col.ind = real_estate$distance_to_station,
             gradient.cols = c("#00AFBB", "#E7B800", "#FC4E07"))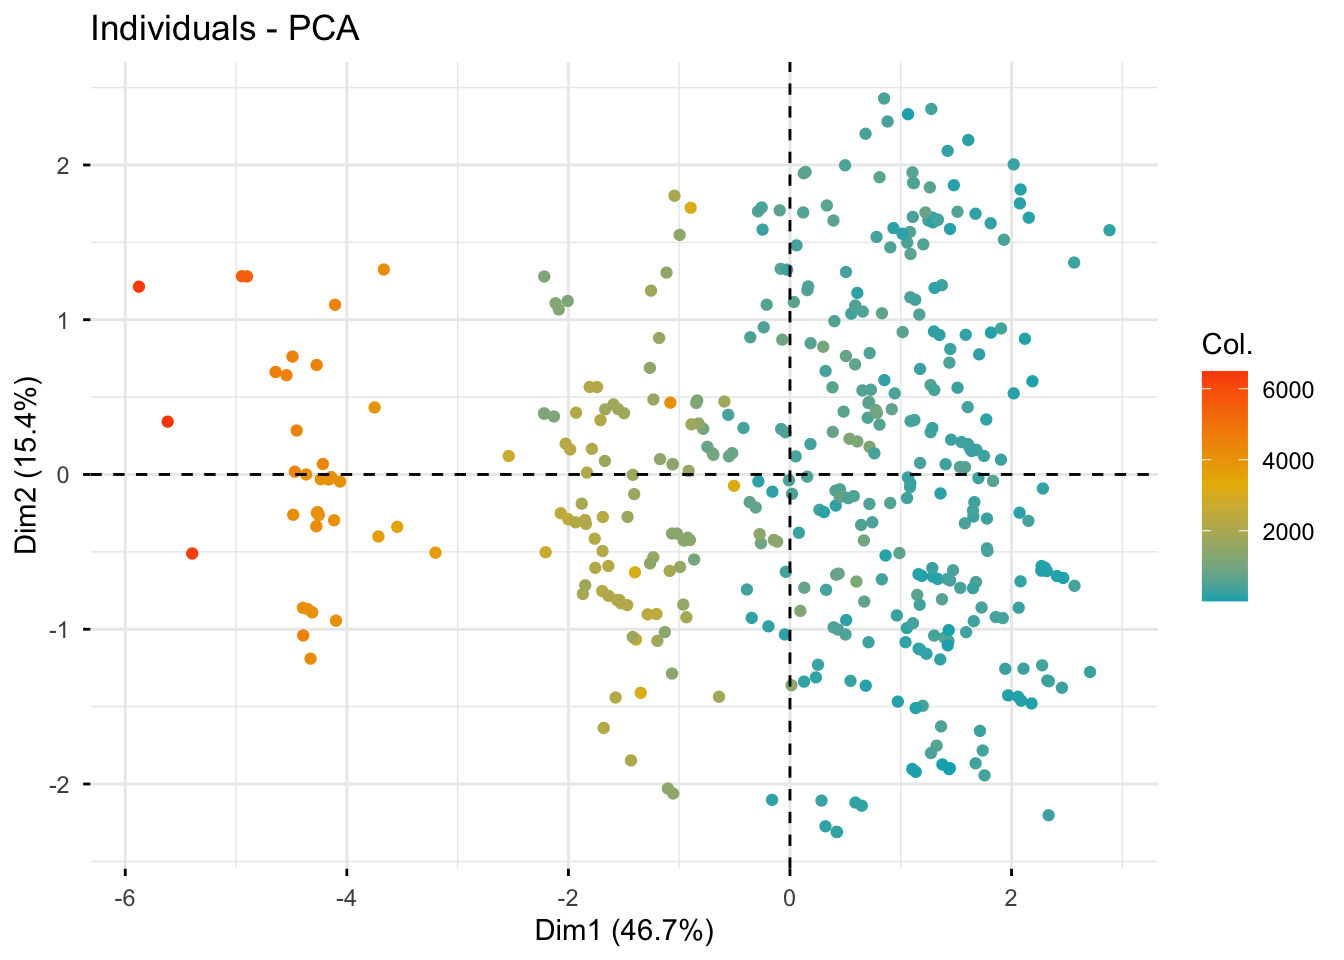
On observe que les maisons plus proches des transports publics (en bleu) se situent à droite du graphique (corrélation négative avec le premier facteur).
3 Le Positionnement Multidimensionnel (MDS)
Tout l’intérêt du MDS est de pouvoir construire des points dans l’espace à partir d’une matrice de dissimilarité euclidienne carrée. Il n’est donc pas nécessaire d’avoir des données tabulaires, mais uniquement des objets dont il est possible de construire des indices de similarités ou dissimilarités pour pouvoir ensuite les représenter.
3.1 Chargement des données
Pour illustrer la puissance du MDS, nous allons utiliser le jeu de données eurodist intégré à R. Il contient uniquement les distances routières (en km) entre 21 villes européennes dans les années 1960.
Voici la matrice de distances entre les 5 premières villes (les autres sont similaires) :
dist_mat = as.matrix(eurodist)
dist_mat[1:5, 1:5]
Athens Barcelona Brussels Calais Cherbourg
Athens 0 3313 2963 3175 3339
Barcelona 3313 0 1318 1326 1294
Brussels 2963 1318 0 204 583
Calais 3175 1326 204 0 460
Cherbourg 3339 1294 583 460 03.2 Effectuer le MDS (pondéré)
Il existe bien une fonction pour faire du MDS dans R, qui s’appelle cmdscale(). Elle prend en entrée une matrice de distances et retourne les coordonnées des points dans l’espace. Cependant, on va construire ici une fonction spécialisée qui permet de faire un MDS pondéré :
weighted_mds = function(dist, weights=NULL, k_max=NULL) {

  # La taille de la matrice
  n = nrow(dist)

  # Si il n'y a pas de poids ou si incompatibles, on pose de poids uniformes
  if (is.null(weights) || length(weights) != n) {
    weights = rep(1, n)
  }

  # On normalise les poids
  weights = weights / sum(weights)

  # Si k_max n'est pas spécifié ou est supérieur à n-1, on le fixe à n-1
  if (is.null(k_max) || k_max > (n-1)) {
    k_max = n-1
  }

  # Calcul des produits scalaires
  H = diag(n) - matrix(1/n, n, n)
  B = -0.5 * H %*% (dist^2) %*% H

  # Décomposition spectrale
  eigen_B = eigen(B)
  eigen_val = eigen_B$values
  eigen_vec = eigen_B$vectors

  # Suppression des valeurs propres négatives (si non-euclidien)
  eigen_val[eigen_val < 0] = 0

  # Reconstruction des coordonnées (1 à k_max seulement)
  coord = eigen_vec[, 1:k_max] %*% diag(sqrt(eigen_val[1:k_max]))

  # On retourne les valeurs propres et les coordonnées
  return(list(eigenvalues=eigen_val, coordinates=coord))
}
On peut maintenant appliquer cette fonction à notre matrice de distances pour effectuer notre MDS :
mds_res = weighted_mds(dist_mat)Comme défini dans la fonction, mds_res contient les valeurs propres et les coordonnées des points dans l’espace. Il existe moins de sorties possibles que pour l’ACP ou l’AFC, car nous n’avons normalement pas accès aux variables originales.
3.3 L’inertie expliquée sur chaque axe
La sortie eigenvalues contient les valeurs propres :
mds_res$eigenvalues [1] 19538377.09 11856555.33 1528844.47 1118741.95 789347.20 581655.21
[7] 262319.21 192597.56 145084.53 107967.31 51394.84 0.00
[13] 0.00 0.00 0.00 0.00 0.00 0.00
[19] 0.00 0.00 0.00On voit que de nombreuses valeurs ont été annulées (elles étaient négatives avant, mais notre fonction les a mises à 0), ce qui indique que notre dissimilarité d’entrée n’était pas euclidienne carrée.
On va tracer le screeplot illustrant la répartition de l’inertie sur chaque axe :
eigen_df = data.frame(id = 1:length(mds_res$eigenvalues),
                      inertia = mds_res$eigenvalues/sum(mds_res$eigenvalues) )

ggplot(eigen_df, aes(x=id, y=inertia)) +
  geom_point() +
  geom_line() +
  xlab("Dimension") +
  ylab("Proportion d'inertie")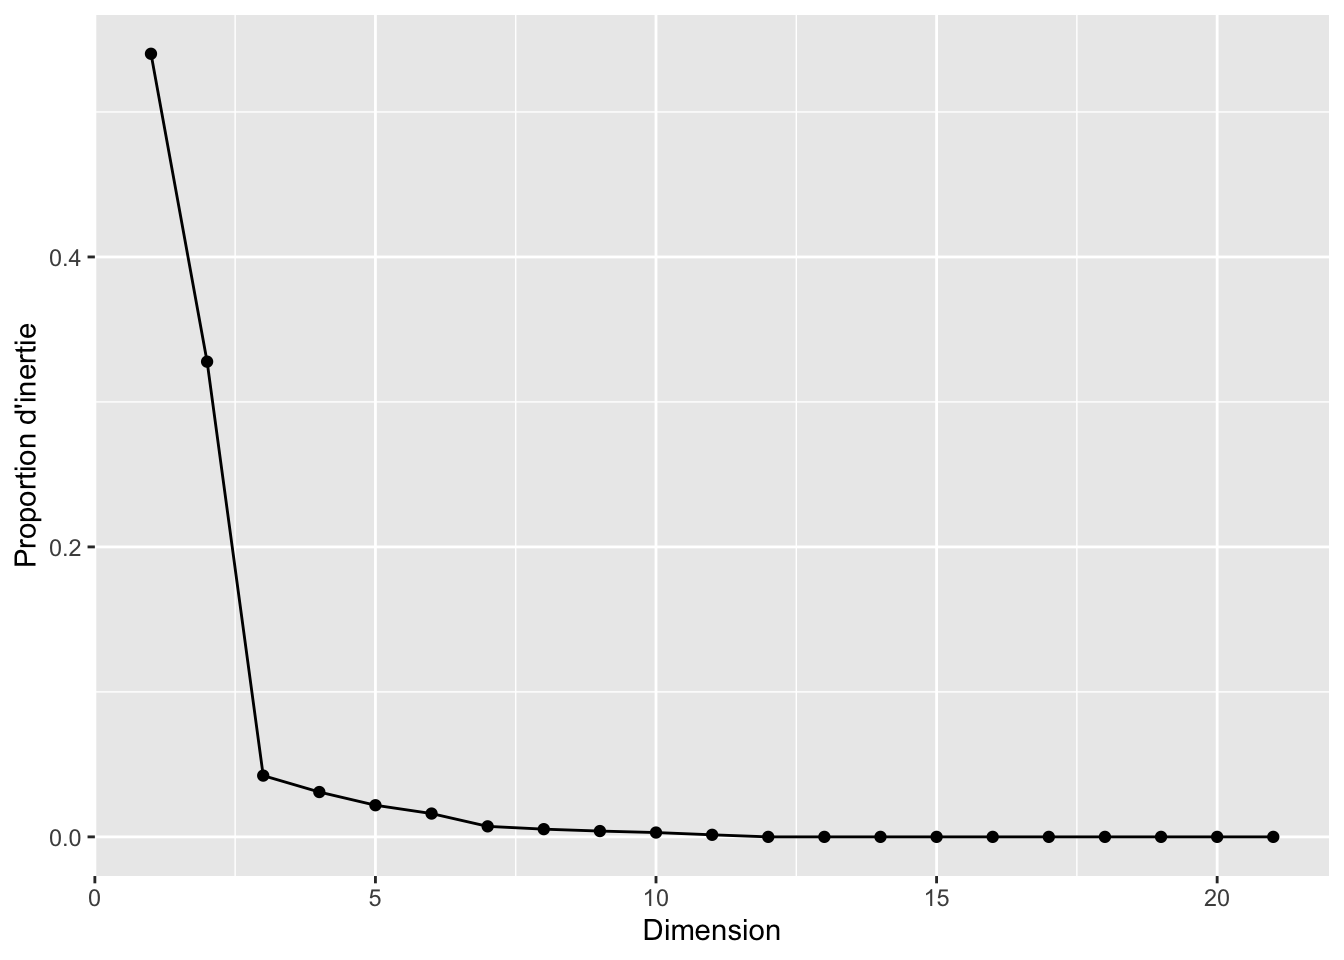
En utilisant le critère du coude, on voit que l’on ne garderait que les deux premières dimensions, ce qui n’est pas surprenant pour des données issues d’une carte bidimensionnelle.
3.4 Les coordonnées factorielles
On va maintenant utiliser les coordonnées factorielles pour reconstruire une carte des villes à partir de leurs distances routières. Nous allons utiliser les deux premières dimensions pour cela, ce qui correspond à une projection en 2D de la configuration originale :
ind_df = data.frame(ville = rownames(dist_mat),
                    x = mds_res$coordinates[, 1],
                    y = mds_res$coordinates[, 2])

ggplot(ind_df, aes(x = x, y = y, label = ville)) +
  geom_point(color = "darkred", size = 2) +
  geom_text_repel(size = 3.5, color = "darkblue") +
  theme_minimal() +
  labs(title = "Carte reconstruite par MDS (Distances routières)",
       x = "Dimension 1",
       y = "Dimension 2")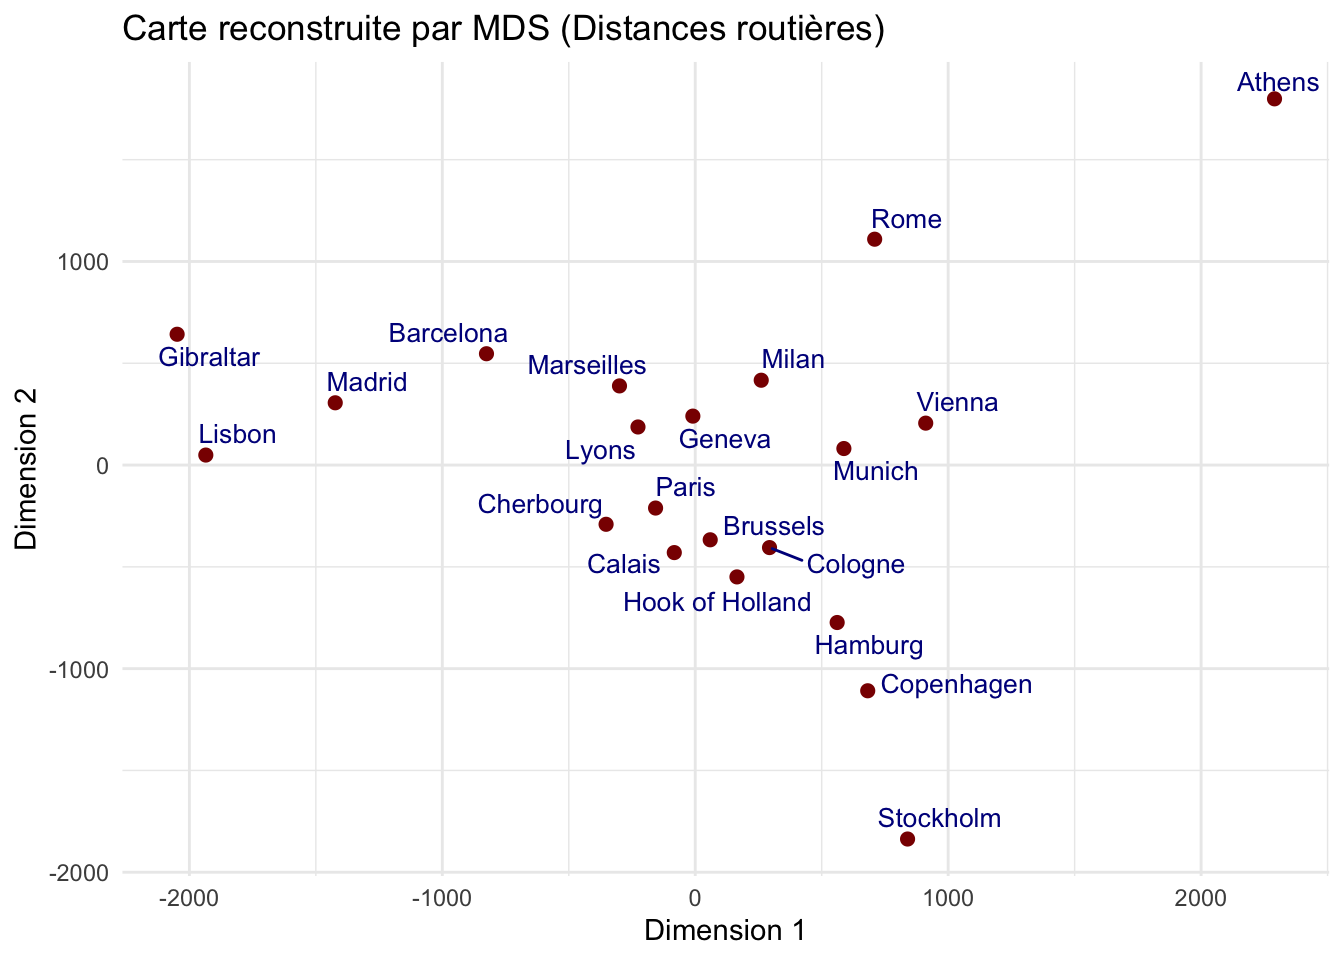
Sur ce graphique, la forme de l’Europe apparaît mais la carte n’est pas dans le bon sens. En réalité, l’orientation des axes n’a aucune signification absolue. L’algorithme préserve strictement les distances relatives entre les points, mais comme il ne connaît pas les concepts géographiques de “Nord” ou “Sud”, la projection finale est arbitraire dans son orientation (c’est invariant par rotation ou symétrie).
Dans ce cas précis, on peut remettre la carte dans le bon sens en inversant l’axe \(y\) :
ggplot(ind_df, aes(x = x, y = -y, label = ville)) +
  geom_point(color = "darkred", size = 2) +
  geom_text_repel(size = 3.5, color = "darkblue") +
  theme_minimal() +
  labs(title = "Carte reconstruite par MDS (Distances routières)",
       x = "Dimension 1",
       y = "Dimension 2")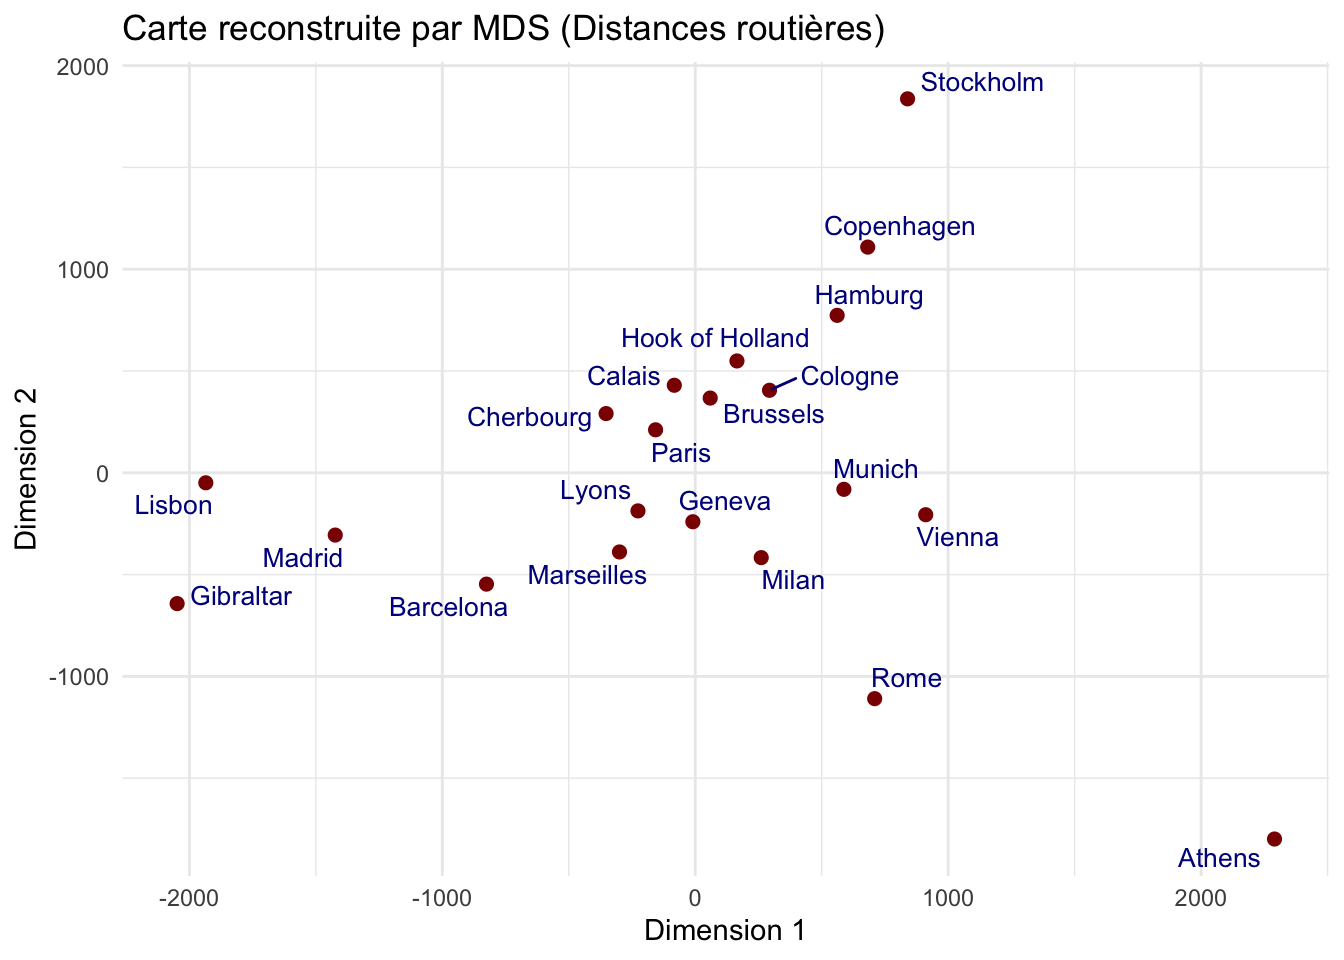
4 L’Analyse Factorielle des Correspondances (AFC)
L’AFC est une méthode d’analyse factorielle adaptée aux données qualitatives. Elle permet d’analyser les relations entre les modalités de deux variables catégorielles à partir d’une table de contingence (si vous avez des données tabulaires, utilisez la fonction table() pour l’obtenir). L’AFC utilise la distance du \(\chi^2\) pour mesurer les associations entre les modalités, et produit une représentation graphique appelée biplot, où les modalités des deux variables sont représentées dans le même espace.
Elle est particulièrement adaptée pour analyser des données textuelles mises sous forme de table document-terme (le paradigme Bag-of-Words), c’est-à-dire un tableau contenant sur les lignes des documents, sur les colonnes des termes, et dans les cases le nombre de fois que le terme est utilisé dans le document en question. C’est avec un exemple de telles données que nous allons effectuer l’AFC.
4.1 Le jeu de données
Nous allons utiliser ici le jeu de données manifesto_dtf.csv, qui contient les fréquences de plusieurs termes utilisés dans des manifestes politiques émis lors des élections présidentielles et législatives françaises en 2017. Cette table de contingence a été construite à partir de textes extraits du Manifesto Project https://manifesto-project.wzb.eu/.
On commence par charger la table de contingence :
dtf = read_csv("data/manifesto_dtf.csv") %>%
  column_to_rownames("doc_id") # on utilise la colonne "doc_id" comme nom des lignes
Rows: 9 Columns: 7567
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
chr (1): doc_id
dbl (7566): emmanuel, macron, président, retrouver, esprit, conquête, bâtir,...
ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.as_tibble(dtf)# A tibble: 9 × 7,566
emmanuel macron président retrouver esprit conquête bâtir france nouvelle
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 1 1 3 2 4 2 2 21 5
2 0 0 0 1 0 0 0 38 2
3 0 2 6 2 5 0 1 64 18
4 0 0 0 2 1 0 1 36 2
5 0 0 4 2 1 0 4 36 10
6 0 1 1 0 0 0 0 0 1
7 0 0 6 0 0 2 0 21 6
8 0 0 0 0 0 0 0 7 0
9 2 2 2 1 2 0 0 35 6
# ℹ 7,557 more variables: contrat <dbl>, nation <dbl>, programme <dbl>,
# construit <dbl>, vivre <dbl>, travail <dbl>, inventer <dbl>,
# nouvelles <dbl>, protections <dbl>, sommes <dbl>, condamnés <dbl>,
# choisir <dbl>, chômage <dbl>, masse <dbl>, précarisation <dbl>,
# naïfs <dbl>, savons <dbl>, vie <dbl>, progrès <dbl>, personnel <dbl>,
# collectif <dbl>, dépend <dbl>, effort <dbl>, appelle <dbl>, lorsqu <dbl>,
# pratiqué <dbl>, bonnes <dbl>, conditions <dbl>, correctement <dbl>, …4.2 Effectuer l’AFC
L’analyse factorielle des correspondances s’effectue avec la fonction CA() (“correspondence analysis”) de FactoMineR (toujours, sans graphique automatique avec graph=F) :
ca_res = CA(dtf, graph=F)De manière similaire au retour de PCA(), on peut accéder à de nombreuses valeurs via ce retour :
ca_res**Results of the Correspondence Analysis (CA)**
The row variable has 9 categories; the column variable has 7566 categories
The chi square of independence between the two variables is equal to 70978.31 (p-value = 8.514571e-179 ).
*The results are available in the following objects:
name description
1 "$eig" "eigenvalues"
2 "$col" "results for the columns"
3 "$col$coord" "coord. for the columns"
4 "$col$cos2" "cos2 for the columns"
5 "$col$contrib" "contributions of the columns"
6 "$row" "results for the rows"
7 "$row$coord" "coord. for the rows"
8 "$row$cos2" "cos2 for the rows"
9 "$row$contrib" "contributions of the rows"
10 "$call" "summary called parameters"
11 "$call$marge.col" "weights of the columns"
12 "$call$marge.row" "weights of the rows" Mais nous allons utiliser encore une fois les fonctions de factoextra pour extraire et visualiser les résultats importants de manière plus esthétique.
4.3 L’inertie expliquée sur chaque axe
Commençons par observer la valeurs propres qui expriment la variance expliquée sur chaque facteur (avec la fonction get_eigenvalue() de factoextra) :
get_eigenvalue(ca_res) eigenvalue variance.percent cumulative.variance.percent
Dim.1 0.3741426 16.698711 16.69871
Dim.2 0.3370321 15.042397 31.74111
Dim.3 0.2893282 12.913280 44.65439
Dim.4 0.2825024 12.608631 57.26302
Dim.5 0.2681149 11.966490 69.22951
Dim.6 0.2588573 11.553305 80.78282
Dim.7 0.2500510 11.160263 91.94308
Dim.8 0.1805192 8.056922 100.00000fviz_screeplot(ca_res, addlabels=T, ylim=c(0, 50))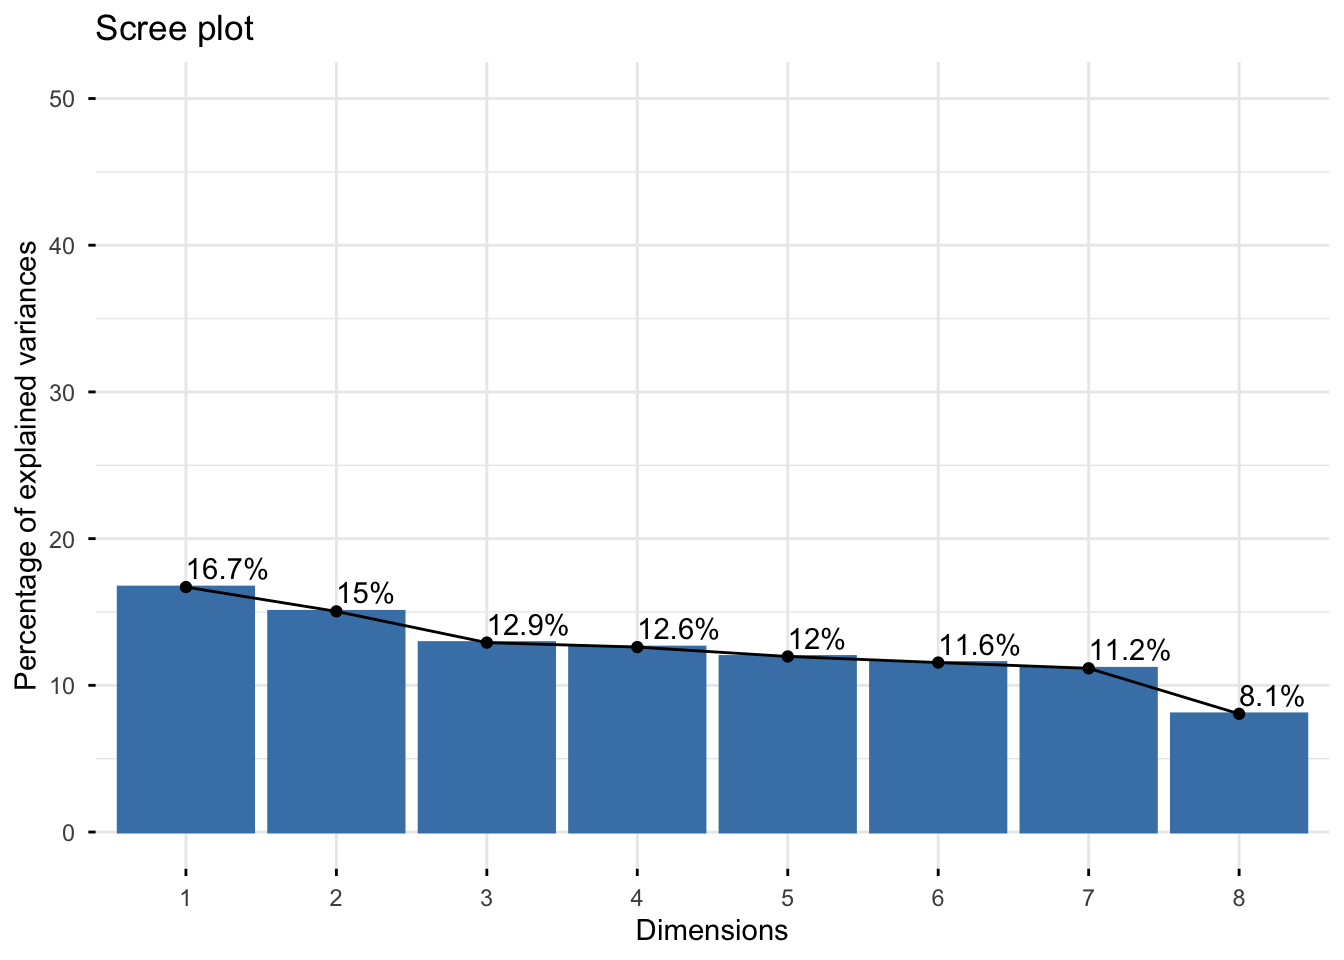
Contrairement aux autres résultats, on voit qu’ici la méthode ne compresse pas si bien l’inertie sur les deux premières dimensions : il existe donc de nombreux contrastes importants si l’on affiche que les deux premières dimensions.
4.4 Le biplot
Les fonctions fviz_ca_row() et fviz_ca_col() permettent d’afficher respectivement les modalités des lignes et des colonnes de la table de contingence. Cependant, lorsque l’on effectue une AFC, on peut afficher les deux résultats sur le même graphique. Cette représentation se nomme le biplot. On l’obtient avec la fonction fviz_ca_biplot() :
fviz_ca_biplot(ca_res, geom="text", labelsize=2)
Le problème est qu’il y a beaucoup trop de mots pour y voir quelque chose (même en diminuant la taille du texte avec labelsize). Une solution est d’utiliser certaines quantités de l’AFC pour sélectionner des colonnes (ou des lignes) à afficher.
Par exemple, on peut utiliser les contributions des modalités à la construction des axes pour n’afficher que les modalités les plus contributives. Ces dernières s’affichent avec :
fviz_contrib(ca_res, choice="col", axes=1:2, top=30)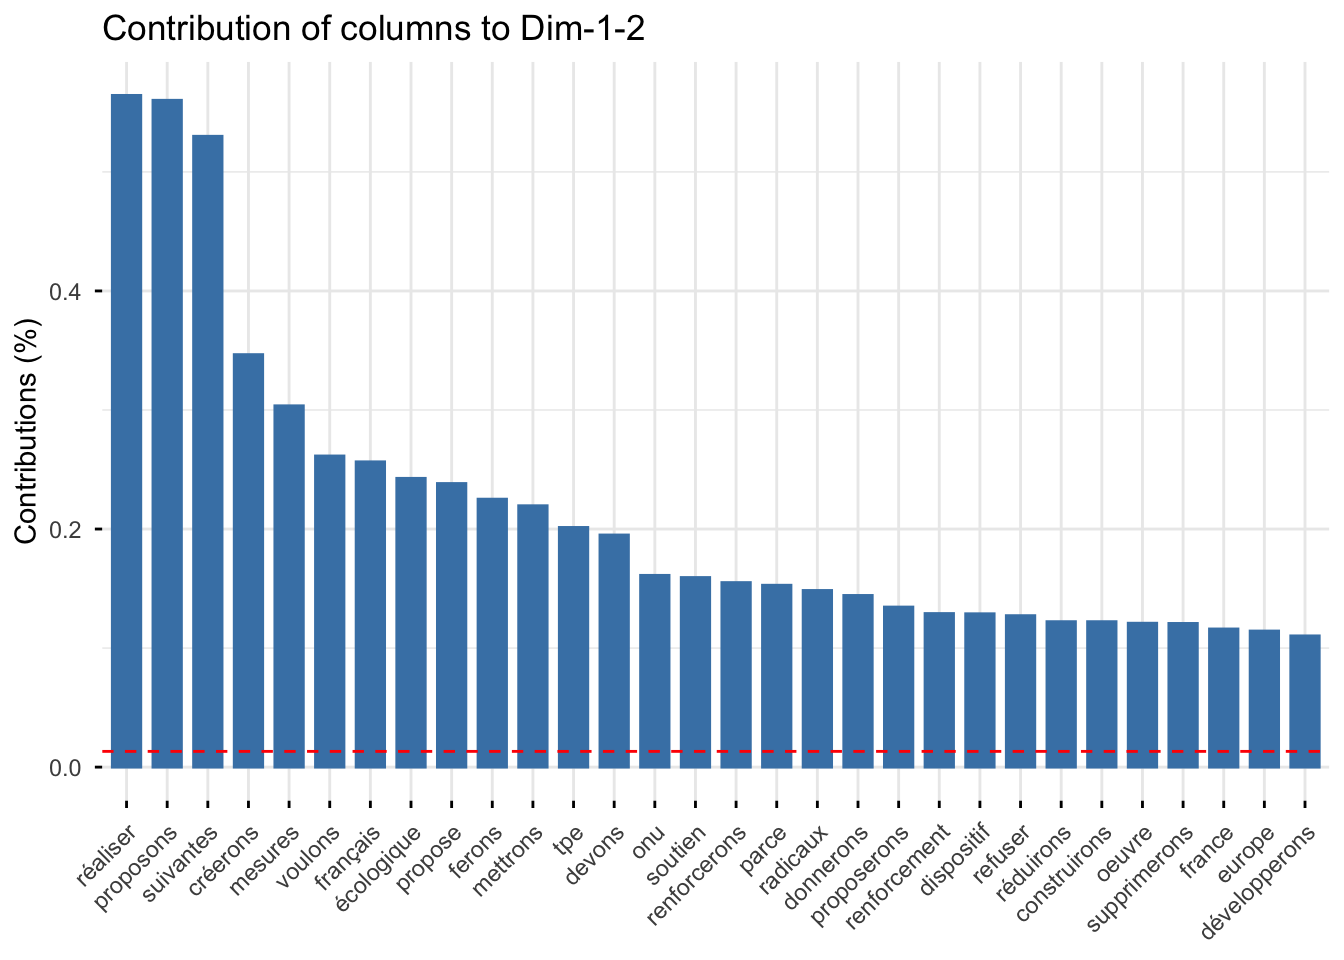
Ou alors, les cos2, c’est-à-dire la qualité de représentation des modalités sur les axes, représentables avec :
fviz_cos2(ca_res, choice="col", axes=1:2, top=30)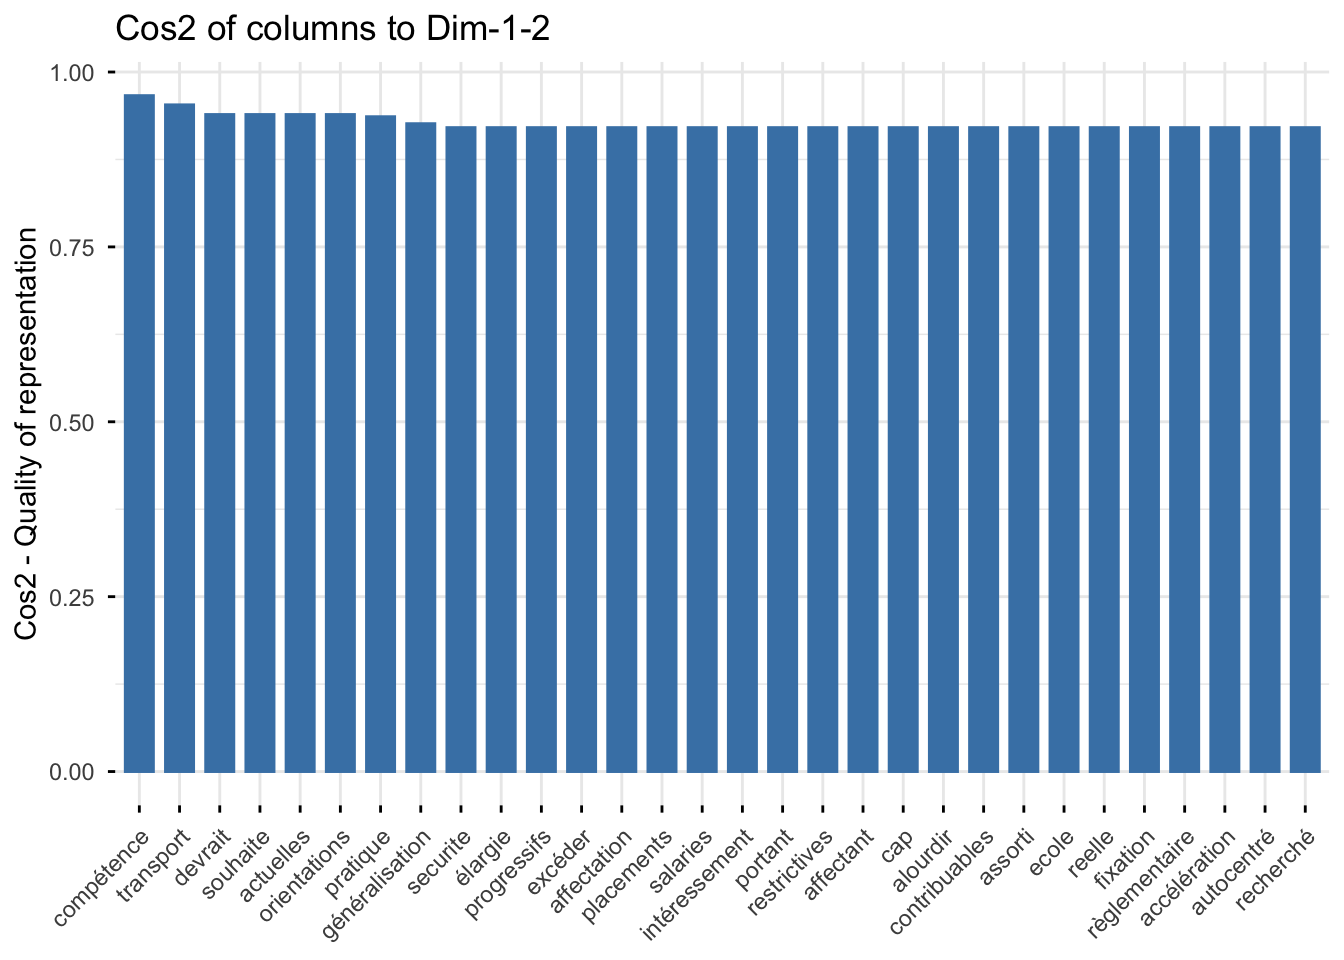
Heureusement, le package factoextra nous facilite la tâche en n’utilisant qu’une seule option dans la fonction fviz_ca_biplot() pour effectuer une sélection automatique :
fviz_ca_biplot(ca_res, repel=T, select.col=list(contrib=30))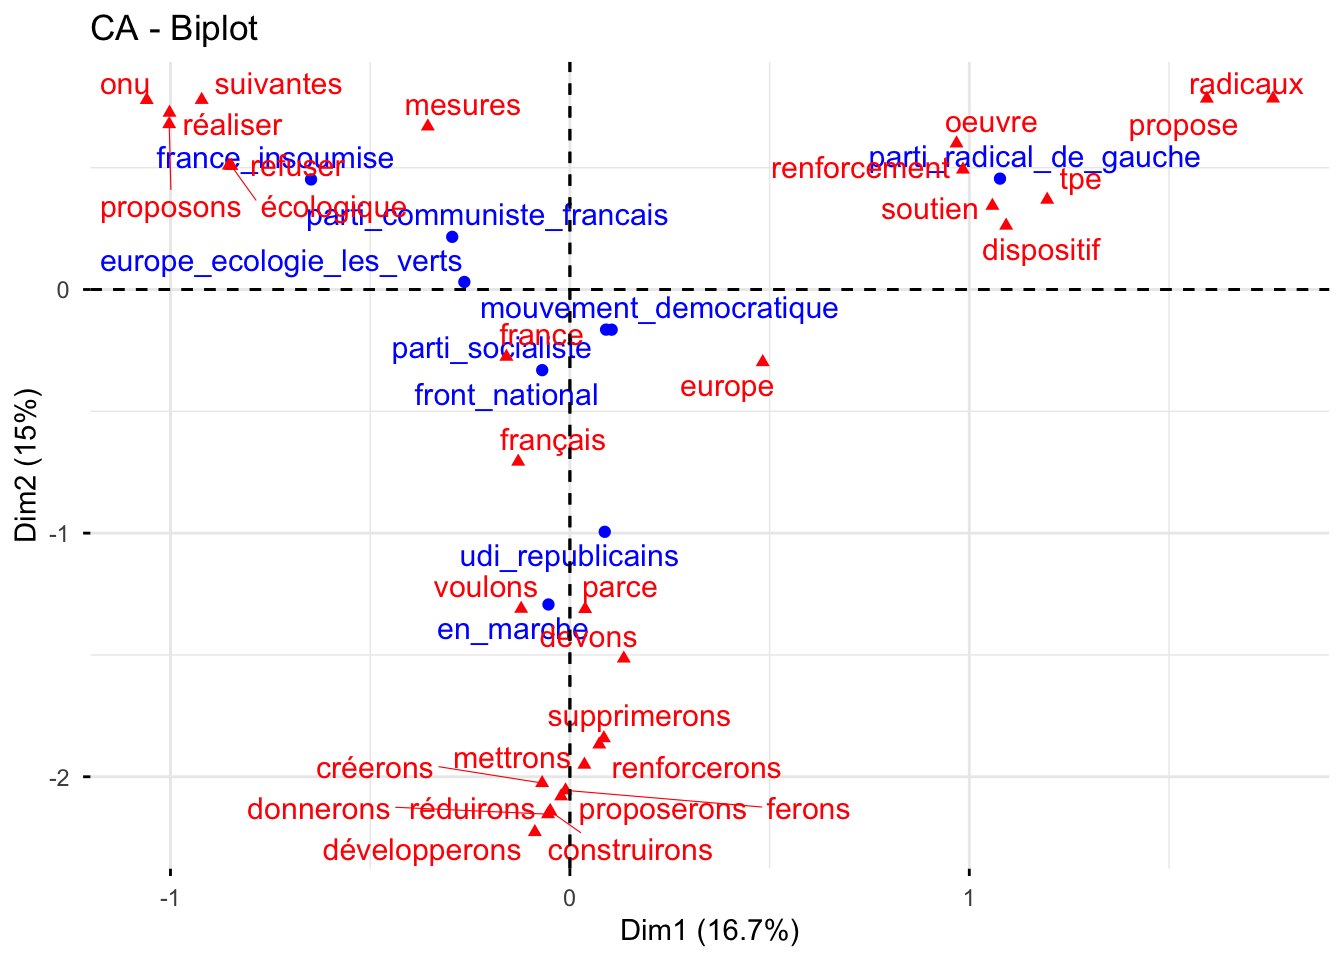
Vous pouvez voir que l’option select.col, ou select.row, peut prendre différentes métriques pour faire la sélection automatique.
D’autres dimensions peuvent également être affichées :
fviz_ca_biplot(ca_res, axes=c(3, 4), repel=T, select.col=list(contrib=30))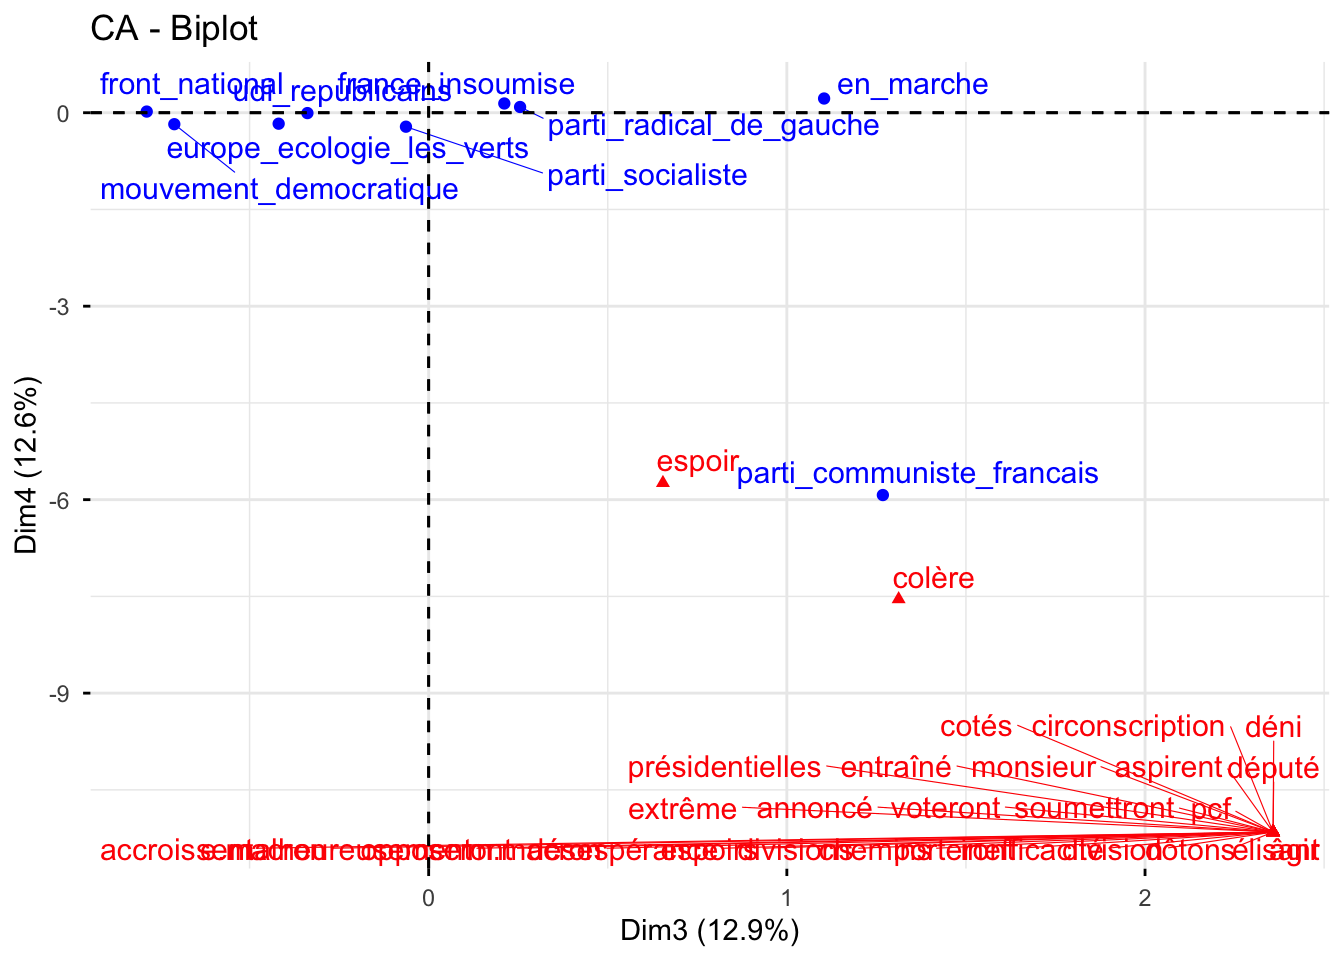
Mais ici, le document du parti communiste français, par son particularisme, semble absorber toute l’inertie.
4.5 Lignes ou colonnes supplémentaires
Comme le document du parti communiste français est si particulier, on peut éventuellement refaire une AFC en le mettant comme ligne supplémentaire. Attention, on doit ajouter une petite quantité à la matrice pour éviter des colonnes vides :
ca_noPCF_res = CA(dtf + 1e-50, graph=F, row.sup=6)On peut alors refaire nos graphiques. La ligne correspondant au parti communiste sera toujours affichée, mais n’a pas été utilisée pour définir les axes :
fviz_ca_biplot(ca_noPCF_res, repel=T, select.col=list(contrib=30))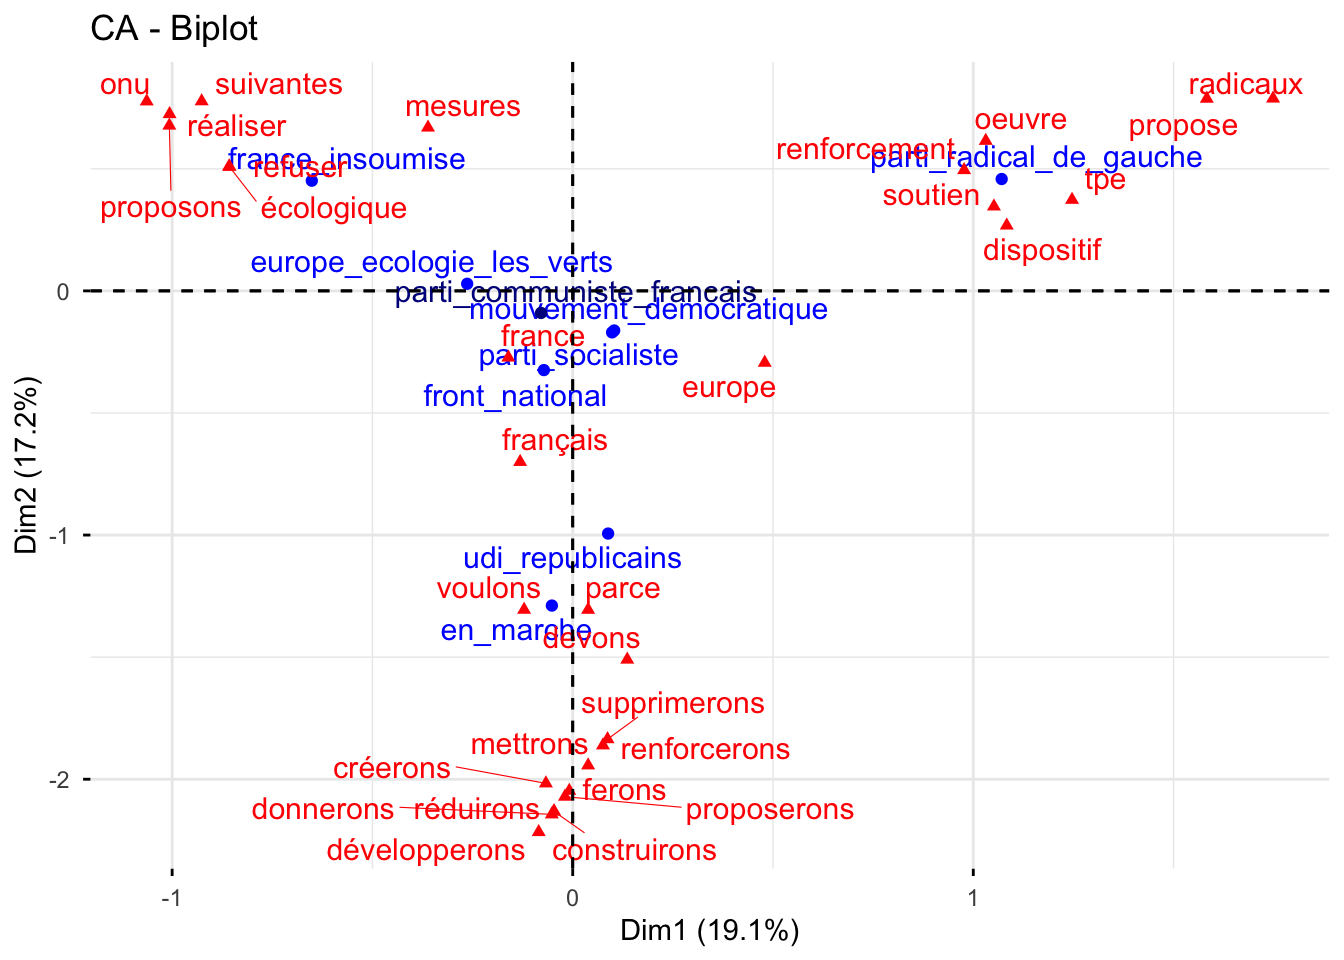
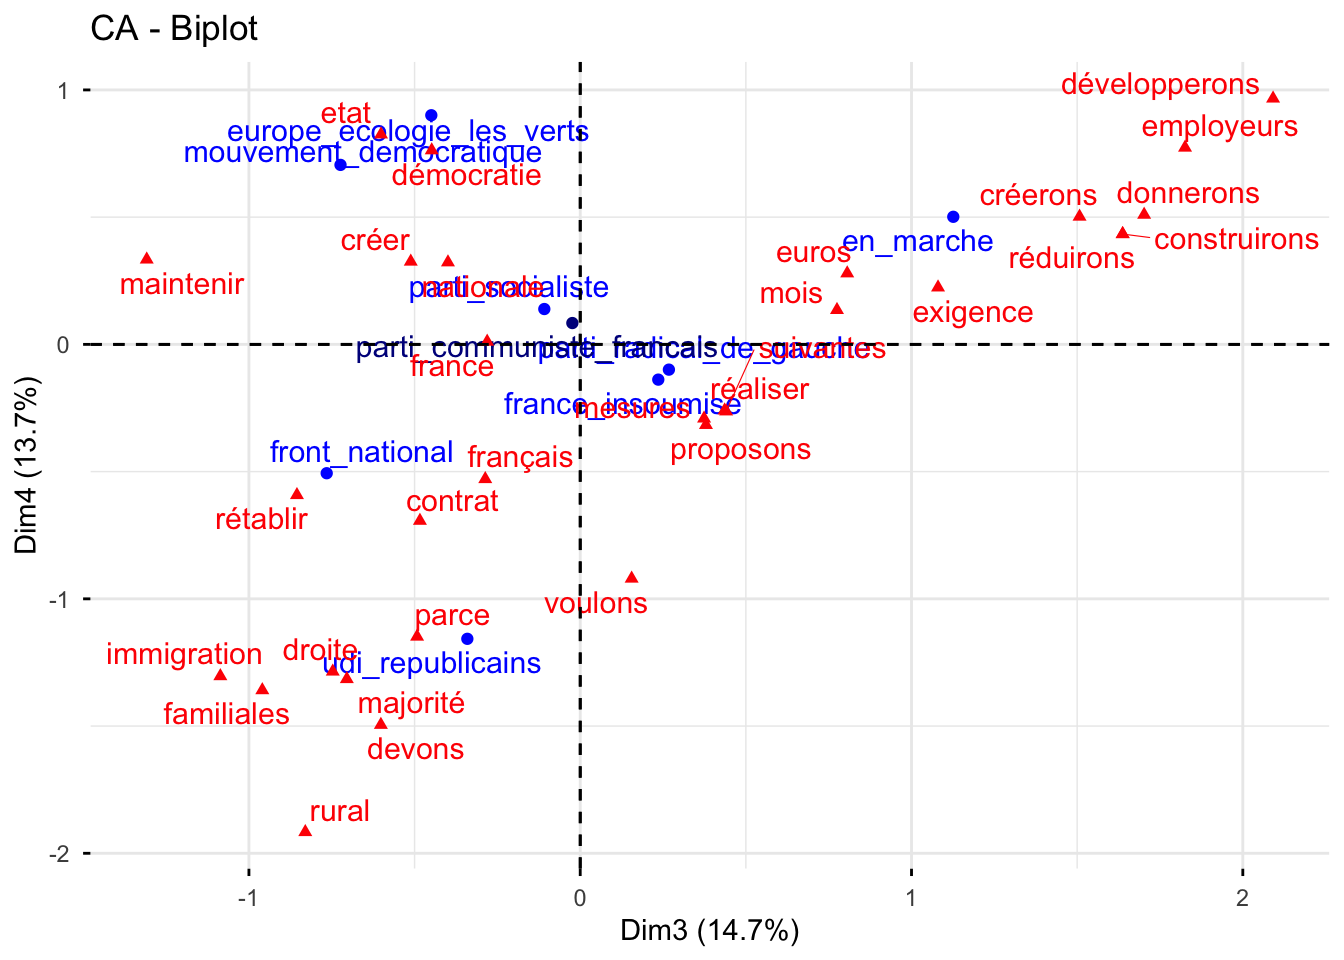
Et cette fois-ci, les dimensions 3 et 4 affichent des contrastes intéressants :
fviz_ca_biplot(ca_noPCF_res, axes=c(3, 4), repel=T, select.col=list(contrib=30))