library(tidyverse)
library(ISLR2) # Contient le jeu de données `Wage` sur lequel nous allons travailler
library(broom) # Pour extraire les résultats des modèles de manière "tidy"
library(car) # Pour un test global sur les variables catégorielles
library(MuMIn) # Pour la sélection de modèles exhaustive1 Introduction et Préparation des données
Dans ce cours, nous allons voir comment faire des modèles de régression linéaire multiple et de régression logistique avec R. Une troisième partie va également s’intéresser aux stratégies de sélection de modèles, applicables aussi bien à la régression linéaire qu’à la régression logistique.
Les fonctions fondamentales pour faire ces modèles, qui sont lm() et glm(), sont déjà présentes dans la base de R. Cependant de nombreuses extensions proposent des résultats, diagnostiques et procédures supplémentaires qui s’avèrent très utiles. Les packages nécessaires pour cette session sont donc les suivants :
Tout au long de ce cours, nous allons utiliser le jeu de données Wage du package ISLR. Il contient les informations salariales et démographiques de 3000 travailleurs masculins de la région “Mid-Atlantic” aux États-Unis.
Commençons par le charger, transformons-le en tibble, et examinons-le :
wage_df = as_tibble(Wage)
wage_df
# A tibble: 3,000 × 11
year age maritl race education region jobclass health health_ins logwage
<int> <int> <fct> <fct> <fct> <fct> <fct> <fct> <fct> <dbl>
1 2006 18 1. Nev… 1. W… 1. < HS … 2. Mi… 1. Indu… 1. <=… 2. No 4.32
2 2004 24 1. Nev… 1. W… 4. Colle… 2. Mi… 2. Info… 2. >=… 2. No 4.26
3 2003 45 2. Mar… 1. W… 3. Some … 2. Mi… 1. Indu… 1. <=… 1. Yes 4.88
4 2003 43 2. Mar… 3. A… 4. Colle… 2. Mi… 2. Info… 2. >=… 1. Yes 5.04
5 2005 50 4. Div… 1. W… 2. HS Gr… 2. Mi… 2. Info… 1. <=… 1. Yes 4.32
6 2008 54 2. Mar… 1. W… 4. Colle… 2. Mi… 2. Info… 2. >=… 1. Yes 4.85
7 2009 44 2. Mar… 4. O… 3. Some … 2. Mi… 1. Indu… 2. >=… 1. Yes 5.13
8 2008 30 1. Nev… 3. A… 3. Some … 2. Mi… 2. Info… 1. <=… 1. Yes 4.72
9 2006 41 1. Nev… 2. B… 3. Some … 2. Mi… 2. Info… 2. >=… 1. Yes 4.78
10 2004 52 2. Mar… 1. W… 2. HS Gr… 2. Mi… 2. Info… 2. >=… 1. Yes 4.86
# ℹ 2,990 more rows
# ℹ 1 more variable: wage <dbl>Ce jeu de données est déjà très propre, il n’y a donc pas beaucoup de pré-traitements à effectuer. Cependant, avec de nombreuses méthodes statistiques en R, dont les modèles de régression, définir le bon type des variables (numériques, catégorielles, ordinales) est très important, car les calculs effectués de manière sous-jacente ne seront pas les mêmes.
Ici, les variables catégorielles sont déjà correctement typées. Il nous reste à formater les variables ordinales, ce qui est facile à faire ici car, comme elles commencent par des numéros, l’ordre alphabétique correspond naturellement à l’ordre hiérarchique (sinon, on aurait dû définir l’ordre via le vecteur donné dans l’argument levels) :
wage_df = wage_df %>%
  mutate(
    education = factor(education, ordered=T),
    health = factor(health, ordered=T)
  )
head(wage_df$education)
[1] 1. < HS Grad 4. College Grad 3. Some College 4. College Grad
[5] 2. HS Grad 4. College Grad
5 Levels: 1. < HS Grad < 2. HS Grad < 3. Some College < ... < 5. Advanced Degreehead(wage_df$health)[1] 1. <=Good 2. >=Very Good 1. <=Good 2. >=Very Good 1. <=Good
[6] 2. >=Very Good
Levels: 1. <=Good < 2. >=Very GoodNous le verrons plus tard, mais dans le cadre de la régression, les variables ordinales sont traitées de manière très particulière, à mi-chemin entre des variables numériques et des variables catégorielles. Nous allons créer deux autres versions de ces dernières, une numérique et une catégorielle, qui nous permettront de les intégrer dans les modèles de régression d’une manière ciblée :
wage_df = wage_df %>%
  mutate(
    education_num = as.numeric(education),
    education_cat = factor(education, ordered=F),
    health_num = as.numeric(health),
    health_cat = factor(health, ordered=F)
  )
head(wage_df$education_num)
[1] 1 4 3 4 2 4head(wage_df$education_cat)[1] 1. < HS Grad 4. College Grad 3. Some College 4. College Grad
[5] 2. HS Grad 4. College Grad
5 Levels: 1. < HS Grad 2. HS Grad 3. Some College ... 5. Advanced Degree2 La régression linéaire
2.1 Théorie (rappel)
La régression linéaire (multiple) est un modèle qui postule qu’une variable numérique \(Y\), appelée variable dépendante ou critère, peut s’exprimer en fonction de \(p\) autres variables numériques \(X_1, \ldots X_p\), appelées variables indépendantes ou prédicteurs, selon la formule suivante : \[ Y = b_0 + b_1 X_1 + b_2 X_2 + \ldots + b_p X_p + \epsilon \] où les \(b_i\) sont les coefficients de régression, \(b_0\) est l’ordonnée à l’origine ou l’intercept, et \(\epsilon\) représente le terme d’erreur ou le résidu (c’est-à-dire la part de \(Y\) qui n’est pas expliquée par les variables indépendantes).
Cette relation est dite linéaire car elle suppose qu’il y a une structure sous-jacente de type “hyperplan”, autrement dit une droite dans la cas de la régression simple :
x = runif(50)
y = 2 + 3 * x + rnorm(50, sd=0.5)
df = tibble(x, y)
ggplot(df, aes(x=x, y=y)) +
  geom_point() +
  geom_abline(intercept=2, slope=3, color="red", linetype="dashed")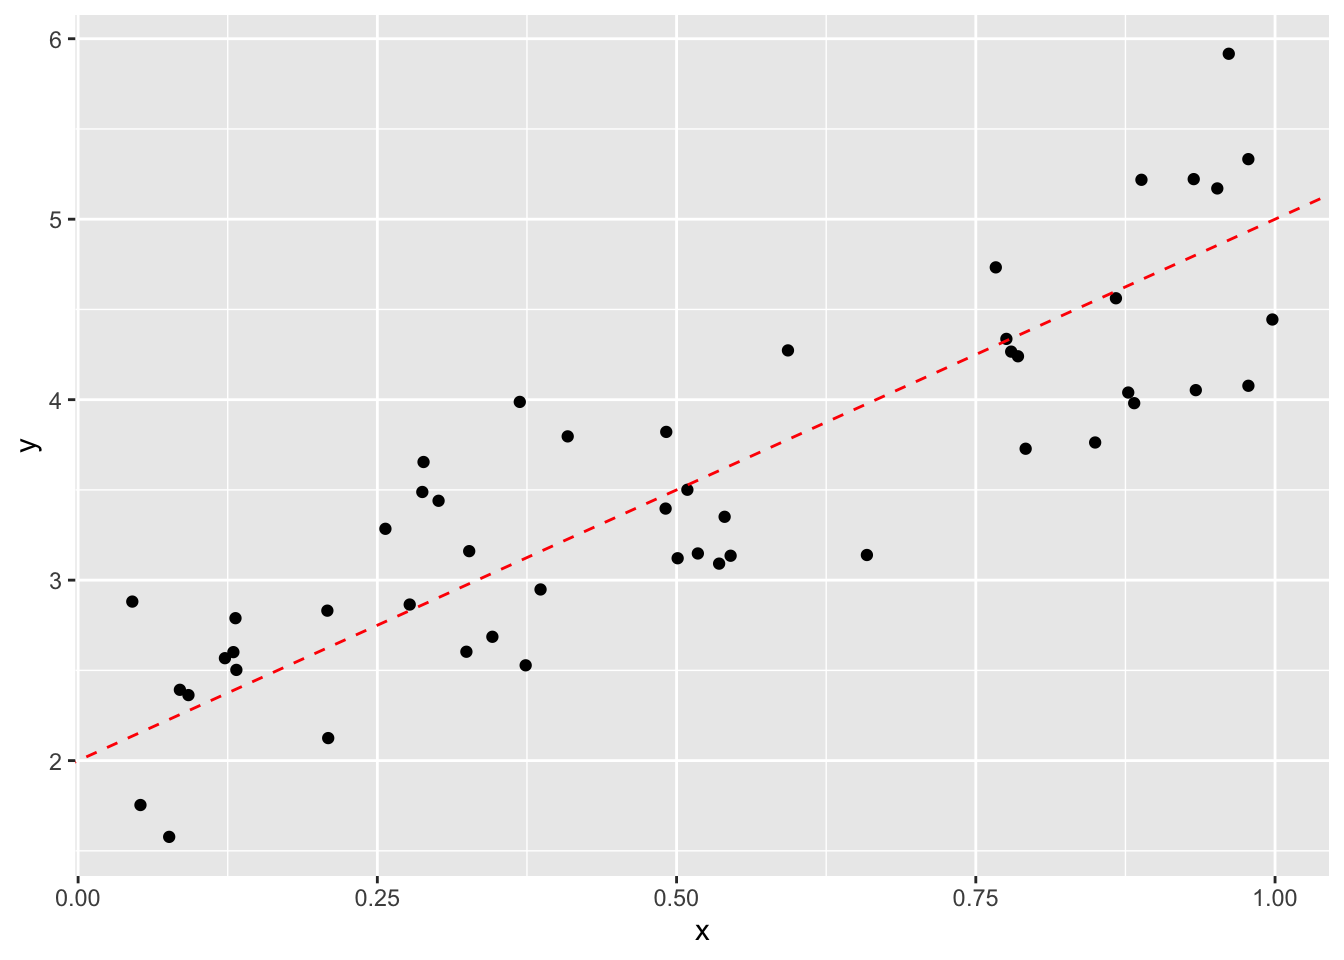
On trouve les coefficients de régression par la méthode des moindres carrés ordinaires (OLS). L’algorithme va chercher l’unique droite qui minimise l’erreur carrée moyenne (MSE), c’est-à-dire qui minimise la distance verticale entre chaque point réel \(y_i\) et la prédiction du modèle \(\hat{y}_i\) : \[ \text{MSE} = \tfrac{1}{n} \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 \] avec \(\hat{y}_i = b_0 + b_1 x_{i1} + \ldots + b_p x_{ip}\).
2.2 Construire un modèle linéaire avec lm()
Un modèle linéaire s’obtient avec la fonction lm() de R. Cette dernière demande comme premier argument une formule qui a une structure particulière et qui utilise l’opérateur tilde ~.
La structure usuelle d’une formule est la suivante :
<variable réponse> ~ <variable 1> + <variable 2> + ... + <variable p>Mais on peut également utiliser d’autres syntaxes :
- En utilisant
<variable réponse> ~ ., on indique que l’on prédit avec toutes les variables du jeu de données. - En ajoutant
-1à la formule, la droite de régression passera par l’origine (on omet l’intercept). <variable i>^npermet d’ajouter l’ordre \(n\) de la variable<variable i>*<variable j>permet d’ajouter les termes d’interaction.- Plusieurs fonctions peuvent être utilisées sur les variables, comme
exp()oulog().
Dans le jeu de données Wage, l’objectif sera de prédire la variable wage (le salaire annuel en milliers de $) en fonction d’autres variables du jeu de données. Pour commencer, nous allons faire un modèle linéaire en utilisant simplement deux autres variables numériques, age et education_num :
lm_res = lm(wage ~ age + education_num, data=wage_df)Nous avons sauvegardé le résultat dans la variable lm_res, car il s’agit d’une sortie qui est utilisable dans plusieurs contextes (une manière de travailler fréquente en R). En premier lieu, cette sortie s’utilise avec summary(), qui donne de nombreuses informations sur la régression effectuée :
summary(lm_res)
Call:
lm(formula = wage ~ age + education_num, data = wage_df)

Residuals:
     Min       1Q   Median       3Q      Max
-104.286  -19.796   -3.664   14.659  220.625

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)   38.77503    2.90509   13.35   <2e-16 ***
age            0.58847    0.05723   10.28   <2e-16 ***
education_num 15.93645    0.54341   29.33   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 36.08 on 2997 degrees of freedom
Multiple R-squared:  0.2527,    Adjusted R-squared:  0.2522
F-statistic: 506.8 on 2 and 2997 DF,  p-value: < 2.2e-16
Examinons cette sortie :
- Call: donne la formule utilisée.
- Residuals: donne un aperçu de la distribution des résidus, qui devraient suivre une distribution normale centrée autour de zéro pour que les hypothèses du modèle soient respectées.
- Coefficients: donne les estimations des coefficients de régression, leur erreur standard, la statistique \(t\) et la valeur \(p\) associée. Ces valeurs permettent de tester l’hypothèse nulle selon laquelle le coefficient est égal à zéro (c’est-à-dire que la variable n’a pas d’effet sur la variable dépendante).
- En bas: on trouve plusieurs statistiques globales du modèle, comme le \(R^2\) et le \(R^2\)-ajusté, qui permettent d’évaluer sa qualité globale.
On voit que ce modèle explique environ 25% de la variance totale des salaires, que l’intercept et nos deux coefficients sont significatifs, et que les deux variables associées ont un effet positif sur le salaire.
Notez que l’on peut extraire plusieurs informations de ce résultat via l’opérateur $ :
names(lm_res) [1] "coefficients" "residuals" "effects" "rank"
[5] "fitted.values" "assign" "qr" "df.residual"
[9] "xlevels" "call" "terms" "model" Comme par exemple, les coefficients de régression :
lm_res$coefficients (Intercept) age education_num
38.7750345 0.5884726 15.9364472 Si l’on cherche à faire des prédictions à l’aide de ce modèle, on peut utiliser la fonction predict(), qui prend en argument la variable contenant le modèle ainsi qu’un nouveau jeu de données (avec des variables ayant le même nom que celles utilisées pour construire le modèle) :
# Les nouvelles données avec 2 individus
new_df = tibble(age=c(30, 40), education_num=c(2, 4))
# La prédiction du salaire sur ces nouveaux individus
predict(lm_res, new_df)
1 2
88.30211 126.05973 2.3 Extraire les résultats avec broom
Bien que summary() soit un standard historique, sa sortie est du texte brut, difficilement manipulable dans un “pipeline” d’opérations. Au sain du tidyverse, c’est le package broom qui s’utilise pour transformer les sorties statistiques complexes de plusieurs modèles en tableaux de données propres (des tibbles).
Pour les coefficents de régression, on utilise la fonction `tidy() :
tidy(lm_res)# A tibble: 3 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 38.8 2.91 13.3 1.61e- 39
2 age 0.588 0.0572 10.3 2.14e- 24
3 education_num 15.9 0.543 29.3 1.98e-166Pour les métriques globales du modèle, on utilise la fonction glance(), qui donne un résumé de la qualité du modèle :
glance(lm_res)# A tibble: 1 × 12
r.squared adj.r.squared sigma statistic p.value df logLik AIC BIC
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 0.253 0.252 36.1 507. 2.57e-190 2 -15013. 30034. 30058.
# ℹ 3 more variables: deviance <dbl>, df.residual <int>, nobs <int>Nous nous pencherons plus en détails sur ces critères dans la Section 4, consacrée à la sélection des modèles.
Pour les résidus et les prédictions du modèle, on utilise la fonction augment(), qui ajoute des colonnes au jeu de données original (avec uniquement les variables retenues) avec les valeurs ajustées, les résidus, et d’autres diagnostics :
augment(lm_res)# A tibble: 3,000 × 9
wage age education_num .fitted .resid .hat .sigma .cooksd .std.resid
<dbl> <int> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 75.0 18 1 65.3 9.74 0.00258 36.1 6.30e-5 0.270
2 70.5 24 4 117. -46.2 0.00147 36.1 8.05e-4 -1.28
3 131. 45 3 113. 17.9 0.000350 36.1 2.88e-5 0.497
4 155. 43 4 128. 26.9 0.000555 36.1 1.03e-4 0.745
5 75.0 50 2 100. -25.0 0.000735 36.1 1.18e-4 -0.694
6 127. 54 4 134. -7.18 0.000854 36.1 1.13e-5 -0.199
7 170. 44 3 112. 57.1 0.000340 36.1 2.83e-4 1.58
8 112. 30 3 104. 7.48 0.000721 36.1 1.03e-5 0.207
9 119. 41 3 111. 8.17 0.000338 36.1 5.79e-6 0.227
10 129. 52 2 101. 27.4 0.000829 36.1 1.60e-4 0.761
# ℹ 2,990 more rowsOn peut ainsi facilement visualiser le diagramme des résidus, qui permet de vérifier visuellement les hypothèses de notre modèle (homoscédasticité, linéarité et normalité) :
ggplot(augment(lm_res)) +
  geom_point(aes(x=.fitted, y=.resid)) +
  geom_hline(yintercept=0, color="red", linetype="dashed") +
  labs(title = "Graphique des Résidus vs Valeurs Prédites",
       x = "Salaire Prédit",
       y = "Résidus")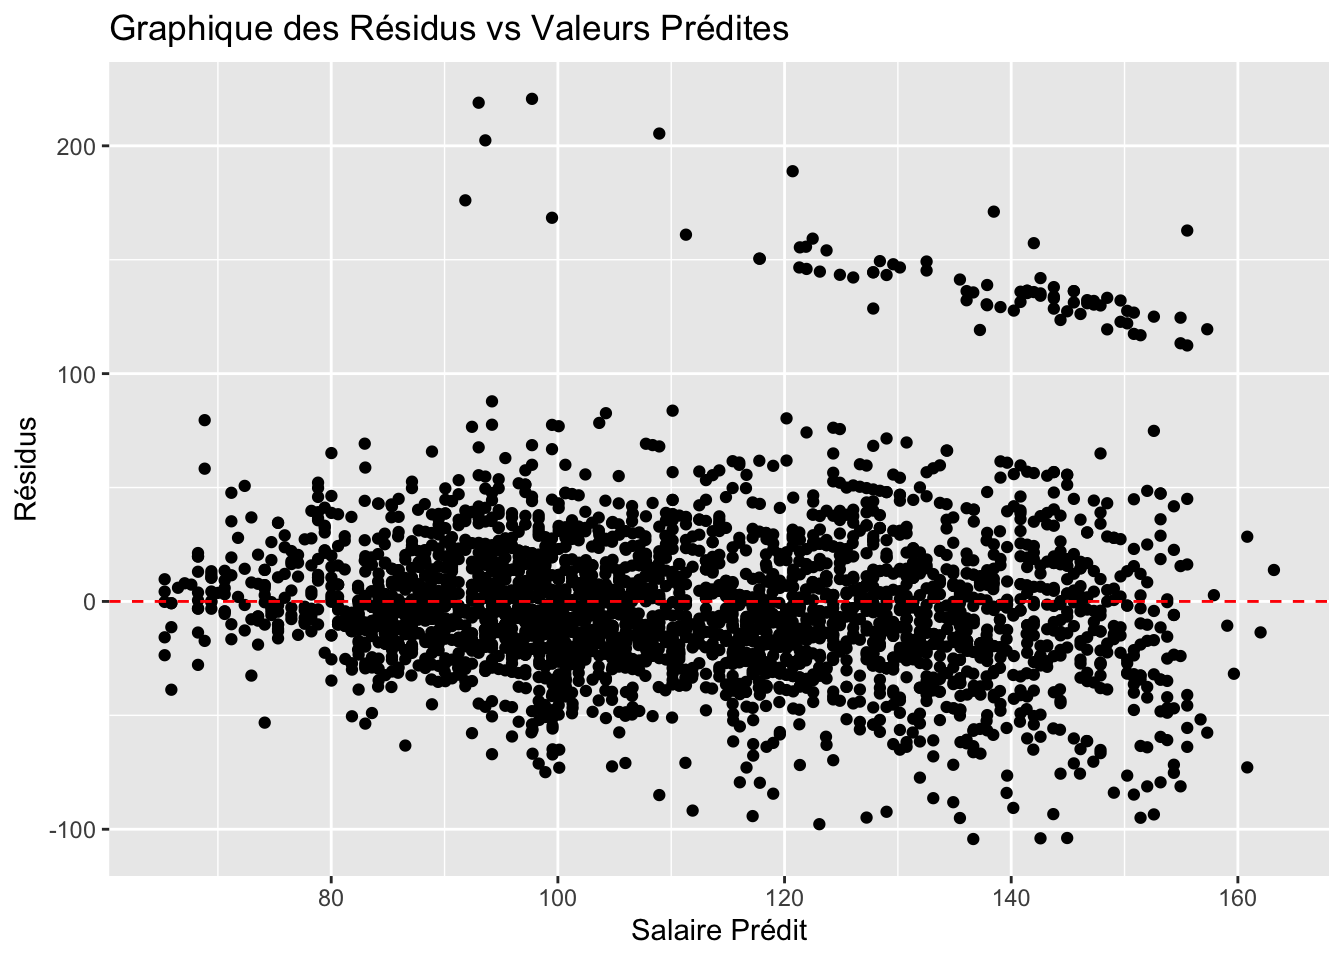
Ces hypothèses semblent vérifiées ici (les erreurs sont à peu près symétriques autour de la ligne rouge).
2.4 Les prédicteurs catégoriels ou ordinaux
Il est possible d’intégrer directement des variables catégorielles ou ordinales dans un modèle de régression linéaire, en tant que prédicteurs, et R va les traiter automatiquement de la manière la plus adéquate possible.
2.4.1 Les variables catégorielles dans le modèle linéaire
Que se passe-t-il lorsque nous incluons dans notre fonction lm() une variable catégorielle comme maritl, qui contient 5 modalités ?
levels(wage_df$maritl)[1] "1. Never Married" "2. Married" "3. Widowed" "4. Divorced"
[5] "5. Separated" R gère cela grâce à un processus appelé Dummy Encoding (ou création de variables indicatrices). Si une variable catégorielle possède \(m\) modalités, R va créer \(m-1\) nouvelles variables binaires (contenant uniquement des 0 et des 1).
La raison pour laquelle R crée \(m-1\) modalités au lieu de \(m\) est qu’il faut éviter la redondance parfaite d’information dans le jeu de données, et si l’on ajoute toutes les colonnes, l’une d’elle est déductible des \(m-1\) autres. Pour éviter cela, R enlève toujours une modalité qui devient la catégorie de référence (par défaut, la première dans l’ordre alphabétique, ou la première définie dans le factor). Cette catégorie de référence est comme “absorbée” par l’intercept et les coefficients des autres modalités représentent donc la différence par rapport à cette catégorie de référence.
Pour voir exactement le tableau de données que R construit avant d’ajuster le modèle linéaire, nous pouvons utiliser la fonction model.matrix() :
dummies_encoding = model.matrix(wage ~ maritl, wage_df)
head(dummies_encoding, 10)
(Intercept) maritl2. Married maritl3. Widowed maritl4. Divorced
1 1 0 0 0
2 1 0 0 0
3 1 1 0 0
4 1 1 0 0
5 1 0 0 1
6 1 1 0 0
7 1 1 0 0
8 1 0 0 0
9 1 0 0 0
10 1 1 0 0
maritl5. Separated
1 0
2 0
3 0
4 0
5 0
6 0
7 0
8 0
9 0
10 0Si l’on ajoute donc cette variable catégorielle maritl dans le modèle précédent, on obtient :
lm_res = lm(wage ~ age + education_num + maritl, wage_df)
summary(lm_res)
Call:
lm(formula = wage ~ age + education_num + maritl, data = wage_df)

Residuals:
     Min       1Q   Median       3Q      Max
-107.750  -19.353   -3.366   14.555  217.848

Coefficients:
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)        36.88259    2.85355  12.925  < 2e-16 ***
age                 0.33591    0.06277   5.351  9.4e-08 ***
education_num      15.61140    0.53445  29.210  < 2e-16 ***
maritl2. Married   18.79420    1.76767  10.632  < 2e-16 ***
maritl3. Widowed    1.22593    8.30134   0.148  0.88261
maritl4. Divorced   4.98086    2.98850   1.667  0.09568 .
maritl5. Separated 13.28207    5.02192   2.645  0.00822 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 35.33 on 2993 degrees of freedom
Multiple R-squared:  0.2848,    Adjusted R-squared:  0.2834
F-statistic: 198.6 on 6 and 2993 DF,  p-value: < 2.2e-16
Attention cependant à l’interprétation. Ici, seul les niveaux Married et Separated sont significatifs, mais en référence au niveau Never Married. Le salaire des personnes de ces deux catégories est donc significativement différent par rapport aux personnes n’ayant jamais été mariées. Pour les autres statuts maritaux, l’échantillon ne permet pas de prouver qu’ils gagnent significativement plus ou moins que les gens n’ayant jamais été mariés.
Pour tester si la variable maritl a un impact global sur le modèle (malgré le fait que certaines de ses modalités ne soient pas significatives), la bonne pratique consiste à faire une analyse de variance avec la fonction Anova() du package car :
Anova(lm_res)Anova Table (Type II tests)
Response: wage
Sum Sq Df F value Pr(>F)
age 35734 1 28.636 9.395e-08 ***
education_num 1064746 1 853.245 < 2.2e-16 ***
maritl 167436 4 33.544 < 2.2e-16 ***
Residuals 3734899 2993
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Ici, la valeur p très faible de maritl nous confirme que le statut marital, dans son ensemble, est une variable pertinente à conserver dans notre modèle.
Pour avoir d’autres contrastes, il est possible de changer le niveau de référence d’une variable avec relevel() :
rlv_wage_df = wage_df %>%
  mutate(maritl = relevel(maritl, ref="2. Married"))
lm_res = lm(wage ~ age + education_num + maritl, rlv_wage_df)
summary(lm_res)
Call:
lm(formula = wage ~ age + education_num + maritl, data = rlv_wage_df)

Residuals:
     Min       1Q   Median       3Q      Max
-107.750  -19.353   -3.366   14.555  217.848

Coefficients:
                        Estimate Std. Error t value Pr(>|t|)
(Intercept)             55.67679    3.28002  16.975  < 2e-16 ***
age                      0.33591    0.06277   5.351 9.40e-08 ***
education_num           15.61140    0.53445  29.210  < 2e-16 ***
maritl1. Never Married -18.79420    1.76767 -10.632  < 2e-16 ***
maritl3. Widowed       -17.56828    8.15103  -2.155   0.0312 *
maritl4. Divorced      -13.81334    2.59989  -5.313 1.16e-07 ***
maritl5. Separated      -5.51213    4.84299  -1.138   0.2551
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 35.33 on 2993 degrees of freedom
Multiple R-squared:  0.2848,    Adjusted R-squared:  0.2834
F-statistic: 198.6 on 6 and 2993 DF,  p-value: < 2.2e-16
2.4.2 Les variables ordinales dans le modèle linéaire
Pour ces variables, on sait qu’il y a un ordre, mais on ne sait pas si les écarts entre les modalités sont tous équivalents. R les traite de manière assez particulière.
Prenons directement un exemple avec la variable education (ordinale cette fois). Si l’on crée un modèle avec cette dernière, on obtient :
lm_res = lm(wage ~ age + education, wage_df)
summary(lm_res)
Call:
lm(formula = wage ~ age + education, data = wage_df)

Residuals:
     Min       1Q   Median       3Q      Max
-110.033  -19.635   -3.907   14.441  220.408

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 88.40777    2.53789  34.835  < 2e-16 ***
age          0.56869    0.05719   9.943  < 2e-16 ***
education.L 50.05925    1.86518  26.839  < 2e-16 ***
education.Q  8.13375    1.74709   4.656 3.37e-06 ***
education.C  2.63428    1.43992   1.829   0.0674 .
education^4  0.61756    1.36837   0.451   0.6518
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 35.94 on 2994 degrees of freedom
Multiple R-squared:  0.2593,    Adjusted R-squared:  0.2581
F-statistic: 209.6 on 5 and 2994 DF,  p-value: < 2.2e-16
On voit que cette variable été incluse avec différentes tendances, résumées par les indications L, Q, C et ^4 :
Tendance Linéaire
L: le modèle teste s’il y a une tendance linéaire globale. Autrement dit, on regarde si le fait de monter d’un niveau de diplôme augmente le salaire de manière régulière et constante.Tendance Quadratique
Q: le modèle teste s’il y a une courbure (une forme en “U”). Ici, la supposition est que les petits diplômes ne changent pas beaucoup le salaire, mais que l’effet augmente lorsque l’on arrive au Master ou au Doctorat.Tendance Cubique
C: le modèle teste s’il y a deux courbures (une forme en “S”). En gros, est-ce qu’on a un gros gain avec les premiers diplômes, puis un plateau (stagnation), puis de nouveau un gros gain avec les plus hauts diplômes.Tendance Quartique
^4: au-delà du cubique, les niveaux deviennent difficiles à interpréter et l’on a presque intérêt à traiter la variable comme une variable catégorielle sans ordre.
Il peut parfois être préférable d’utiliser les versions purement numériques ou catégorielles de cette variable, car l’interprétation s’en trouve allégée. D’une manière générale, si le L est le principal facteur significatif, alors la relation est presque linéaire et on peut utiliser sa version numérique. À l’inverse, si les tendances d’ordres supérieurs (cubique, quartique) sont les seules à être très significatives, la relation d’ordre devient difficile à interpréter et il est peut-être préférable de considérer la variable comme une variable catégorielle non-ordinale.
3 La régression logistique
3.1 Théorie
Jusqu’à présent, nous avons cherché à prédire le salaire (wage), qui est une variable numérique continue. Mais que se passe-t-il si nous voulons prédire une variable catégorielle binaire \(Y\) (0 ou 1, Oui ou Non, Succès ou Échec) ?
Imaginons que nous voulions prédire si un travailleur a un salaire considéré comme “élevé” (que nous définirons arbitrairement à plus de 120 000$ par an). Créons cette variable :
wage_df = wage_df %>%
  mutate(high_wage = ifelse(wage > 120, 1, 0))
# On regarde les proportions de chaque catégorie dans le jeu de données
table(wage_df$high_wage)
   0    1
2047  953
Si nous utilisons une régression linéaire classique (lm()) pour modéliser cette variable binaire, nous faisons face à un problème : une droite infinie finira inévitablement par prédire des valeurs absurdes, c’est-à-dire négatives ou supérieures à 1 (100%).
Pour résoudre ce problème, la régression logistique n’utilise pas une droite, mais une courbe en forme de “S” la fonction sigmoïde, notée \(\sigma()\), qui s’applique sur la formule de régression pour prédire une probabilité : \[ P(Y = 1) = \sigma(b_0 + b_1 X_1 + b_2 X_2 + \ldots + b_p X_p + \epsilon) \]
La fonction sigmoïde se définit comme : \[ \sigma(z) = \frac{1}{1 + e^{-z}} \] et transforme n’importe quelle valeur réelle \(z\) en une valeur comprise entre 0 et 1, interprétable comme une probabilité. On le voit avec sa courbe :
x = seq(-10, 10, length.out=100)
y = 1 / (1 + exp(-x))
df = tibble(x, y)
ggplot(df, aes(x=x, y=y)) +
  geom_line(color="blue") +
  labs(title="Fonction Sigmoïde",
       x="x",
       y="sigmoid(x)")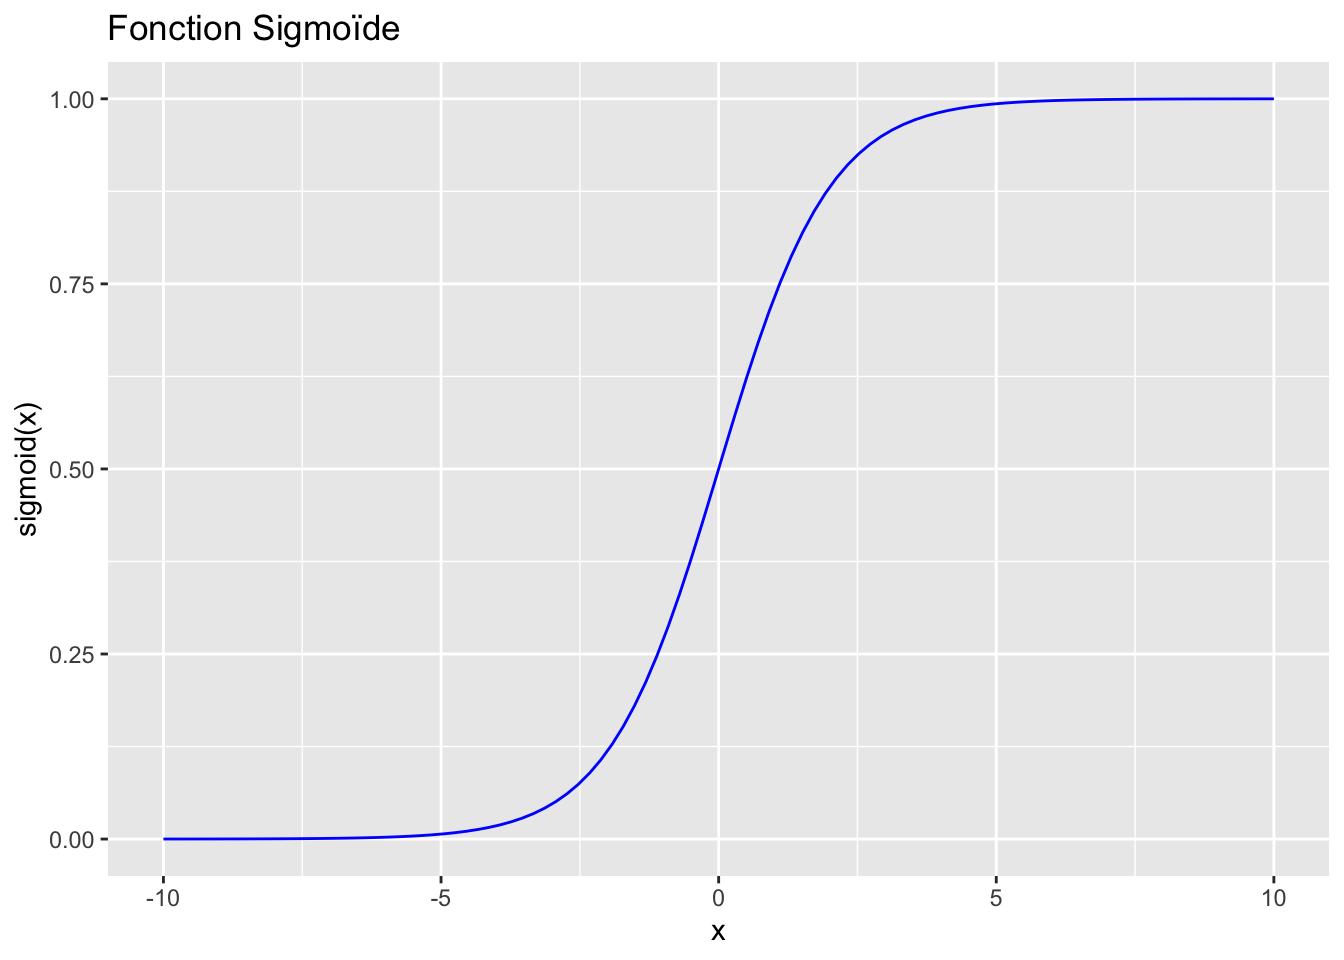
En réalité, on peut aussi voir la régression logistique comme une modélisation des log-odds (le logarithme du rapport des probabilités) de la variable dépendante avec une relation linéaire : \[ \ln\left(\frac{P(Y=1)}{1 - P(Y=1)}\right) = b_0 + b_1 X_1 + b_2 X_2 + \ldots + b_p X_p \] Nous le verrons plus tard, cette manière de poser le problème permet de mieux interpréter les coefficients de la régression logistique.
Notez que la régression logistique ne minimise pas les moindres carrées pour trouver les coefficients de régression, mais une entropie relative entre les probabilités prédites et les probabilités réelles (i.e. la variable binaire). À cause de cela, sa résolution algorithmique est plus lente.
3.2 Construire un modèle de régression logistique avec glm()
En R, nous n’utilisons plus lm(), mais glm() (pour Generalized Linear Model). La syntaxe de la formule est exactement la même, mais nous devons ajouter l’argument family="binomial" pour indiquer à R d’utiliser la transformation logistique.
Essayons de prédire la probabilité d’avoir un haut salaire en fonction de l’âge et du niveau d’éducation (version numérique) :
glm_res = glm(high_wage ~ age + education_num, wage_df, family="binomial")
summary(glm_res)
Call:
glm(formula = high_wage ~ age + education_num, family = "binomial",
    data = wage_df)

Coefficients:
               Estimate Std. Error z value Pr(>|z|)
(Intercept)   -4.950826   0.231505 -21.385  < 2e-16 ***
age            0.032059   0.003975   8.065 7.35e-16 ***
education_num  0.871085   0.040084  21.732  < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 3750.6  on 2999  degrees of freedom
Residual deviance: 3083.6  on 2997  degrees of freedom
AIC: 3089.6

Number of Fisher Scoring iterations: 4
Ce qui change fondamentalement ici, c’est l’interprétation des coefficients de régression. Si vous regardez la colonne Estimate, ces chiffres expriment une variation dans les log-odds par rapport à la référence définie par l’intercept (-4.95). Pour rendre ces coefficients interprétables, nous devons annuler le logarithme en appliquant une fonction exponentielle, qui nous donne alors des odds ratios, ou en français, des rapports de cotes.
Le package broom est ici très utile car la fonction tidy() possède un argument (exponentiate=T) qui les calcule automatiquement :
tidy(glm_res, exponentiate=T, conf.int=T)# A tibble: 3 × 7
term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 0.00708 0.232 -21.4 1.83e-101 0.00447 0.0111
2 age 1.03 0.00398 8.06 7.35e- 16 1.02 1.04
3 education_num 2.39 0.0401 21.7 1.03e-104 2.21 2.59 La colonne estimate contient désormais les odds ratios, autrement dit un rapport d’odds ou de cotes entre deux popultions (entre la population avec une différence de 1 dans cette variable). Les odds sont définis de la manière suivantes \[ \text{odds} = \frac{P(Y=1)}{P(Y=0)} \quad \text{ou à l'inverse} \quad P(Y=1) = \frac{\text{odds}}{1 + \text{odds}} \] On peut voir ces odds ratios comme des facteurs multiplicatifs sur les odds : la valeur neutre (l’absence d’effet) n’est plus 0, mais 1, et :
- Si l’odds ratio est > 1 : La variable augmente les chances de succès.
- Si l’odds ratio est < 1 : La variable diminue les chances de succès.
Par exemple, comme l’odds ratio pour education_num vaut 2.39, cela signifie que pour chaque niveau d’éducation supplémentaire acquis, en maintenant l’âge constant, les chances d’avoir un haut salaire sont multipliées par 2.39 par rapport aux chances d’avoir un bas salaire (on passe, p.ex, de 2 chances contre une à 4.78 chances contre une).
Contrairement à la fonction augment() classique (de broom), pour un glm, il faut explicitement préciser que l’on veut récupérer des probabilités (et non des log-odds) en utilisant l’argument type.predict="response" :
glm_augm = augment(glm_res, type.predict = "response")
glm_augm
# A tibble: 3,000 × 9
high_wage age education_num .fitted .resid .hat .sigma .cooksd
<dbl> <int> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 0 18 1 0.0292 -0.244 0.000647 1.00 0.00000650
2 0 24 4 0.332 -0.899 0.00187 1.000 0.000312
3 1 45 3 0.290 1.57 0.000455 1.000 0.000371
4 1 43 4 0.478 1.21 0.000642 1.000 0.000234
5 0 50 2 0.167 -0.605 0.000761 1.00 0.0000510
6 1 54 4 0.566 1.07 0.00108 1.000 0.000277
7 1 44 3 0.284 1.59 0.000445 1.000 0.000375
8 0 30 3 0.202 -0.671 0.000847 1.000 0.0000714
9 0 41 3 0.264 -0.784 0.000452 1.000 0.0000543
10 1 52 2 0.176 1.86 0.000853 0.999 0.00133
# ℹ 2,990 more rows
# ℹ 1 more variable: .std.resid <dbl>.fitted indique alors les probabilités prédites d’avoir un haut salaire pour chaque individu du jeu de données.
Pour évaluer la qualité du modèle, nous devons d’abord transformer ces probabilités continues en décisions d’affectation rigides (0 ou 1, en utilisant le seuil de 0.5), et calculer la matrice de confusion :
glm_augm = glm_augm %>%
  mutate(prediction = ifelse(.fitted > 0.5, 1, 0))
table(real=glm_augm$high_wage, prediction=glm_augm$prediction)
prediction
real 0 1
0 1782 265
1 510 443Dans un prochain cours, cette matrice va nous servir à calculer plusieurs métriques d’évaluation du modèle, comme l’exactitude (accuracy), la précision (precision) ou le rappel (recall).
4 La sélection de modèles
Dans cette dernière partie, nous abordons un problème central en statistiques appliquées : comment choisir le “meilleur” modèle parmi toutes les combinaisons possibles de variables ?
On pourrait être tenté d’inclure systématiquement toutes les variables disponibles dans notre jeu de données. Cependant, c’est une très mauvaise pratique à cause du surapprentissage (overfitting). Un modèle trop complexe, avec trop de variables, va apprendre “par coeur” l’échantillon (y compris le bruit aléatoire) et sera incapable de faire de bonnes prédictions sur de nouvelles données. Le principe de base est celui de la parcimonie (le rasoir d’Ockham) : on cherche le modèle qui explique le maximum de variance avec le minimum de complexité.
4.1 Les critères d’information : AIC et BIC
Pour comparer des modèles, nous ne pouvons pas utiliser le simple \(R^2\). En effet, mathématiquement, le \(R^2\) augmente toujours lorsqu’on ajoute une variable, même si celle-ci est totalement absurde.
À la place, nous utilisons les critères d’information, qui mesurent l’erreur du modèle tout en appliquant une pénalité pour chaque variable ajoutée. Ces métriques fonctionnent dans le même sens : on cherche le modèle qui les minimise.
L’AIC (Akaike Information Criterion) : \[AIC = 2k - 2\ln(\hat{L})\] (où \(k\) est le nombre de paramètres et \(\hat{L}\) la vraisemblance du modèle). L’AIC est très utilisé lorsque l’objectif du modèle est de faire de la prédiction.
Le BIC (Bayesian Information Criterion) : \[BIC = \ln(n)k - 2\ln(\hat{L})\] (où \(n\) est la taille de l’échantillon). La pénalité du BIC dépend de la taille de l’échantillon. En pratique, dès que l’on a plus de 8 observations, le BIC pénalise la complexité beaucoup plus sévèrement que l’AIC. Il favorise des modèles plus simples et est idéal lorsque l’objectif est d’expliquer le phénomène et d’identifier les vrais facteurs clés.
Comparons manuellement deux modèles avec la fonction glance() (du package broom) qui nous donne ces différentes métriques :
# Modèle simple
lm_simple = lm(wage ~ age, wage_df)

# Modèle plus complexe
lm_complex = lm(wage ~ age + education_num + jobclass, wage_df)

# Comparaison des métriques
glance(lm_simple)
# A tibble: 1 × 12
r.squared adj.r.squared sigma statistic p.value df logLik AIC BIC
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 0.0383 0.0380 40.9 119. 2.90e-27 1 -15391. 30789. 30807.
# ℹ 3 more variables: deviance <dbl>, df.residual <int>, nobs <int>glance(lm_complex)# A tibble: 1 × 12
r.squared adj.r.squared sigma statistic p.value df logLik AIC BIC
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 0.256 0.255 36.0 343. 1.96e-191 3 -15007. 30024. 30054.
# ℹ 3 more variables: deviance <dbl>, df.residual <int>, nobs <int>Le modèle complexe possède un AIC et un BIC légérement inférieurs à ceux du modèle simple. L’ajout des variables education_num et jobclass est donc statistiquement justifié : le gain d’information dépasse la pénalité de complexité.
Regradons maintenant deux méthodes automatiques de recherche de modèles, qui marchent aussi bien avec lm() qu’avec glm().
4.2 L’approche gloutonne
Lorsque nous avons de nombreuses variables potentielles, comparer les modèles à la main devient impossible. R propose une fonction native, step(), qui automatise ce processus.
C’est un algorithme dit glouton ou heuristique, qui part d’un modèle initial, et “avance” (comprendre: retire ou ajoute une variable) dans la direction qui améliore au mieux la métrique choisie. Par exemple, si l’on choisit la direction “backward”, l’algorithme part d’un modèle complet (toutes les variables), évalue quelle variable retirer pour améliorer au mieux le BIC, la retire, et recommence jusqu’à ce que plus aucun retrait n’améliore le score. Regardons justement comment cet exemple fonctionne ici.
On commence par sélectionner toutes le variables qui nous semblent pertinentes pour notre modèle :
wage_reduced_df = wage_df %>%
  select(age, maritl, race, education_num, jobclass, wage, health_cat)
On va maintenant définir le modèle complet, c’est-à-dire avec toutes les variables restantes :
lm_full = lm(wage ~ ., wage_reduced_df)Avec, step(), on lance la sélection automatique en choisissant la direction="backward" (on peut aussi faire “forward” ou “both”) et en précisant que l’on veut utiliser le BIC pour évaluer les modèles (pour cela on doit définir l’argument k comme \(\ln(n)\), avec \(n\) le nombre d’observations) :
n = nrow(wage_reduced_df)
lm_optimal_wstep = step(lm_full, direction="backward", k=log(n))
Start: AIC=21427.77
wage ~ age + maritl + race + education_num + jobclass + health_cat
Df Sum of Sq RSS AIC
- race 3 9757 3684278 21412
<none> 3674521 21428
- jobclass 1 17541 3692062 21434
- health_cat 1 33275 3707796 21447
- age 1 44403 3718924 21456
- maritl 4 146563 3821084 21513
- education_num 1 779121 4453642 21997
Step: AIC=21411.71
wage ~ age + maritl + education_num + jobclass + health_cat
Df Sum of Sq RSS AIC
<none> 3684278 21412
- jobclass 1 15169 3699447 21416
- health_cat 1 34151 3718429 21431
- age 1 43058 3727336 21439
- maritl 4 155662 3839940 21504
- education_num 1 812522 4496800 22002On peut ensuite examiner le meilleur modèle retenu :
summary(lm_optimal_wstep)
Call:
lm(formula = wage ~ age + maritl + education_num + jobclass +
    health_cat, data = wage_reduced_df)

Residuals:
     Min       1Q   Median       3Q      Max
-109.234  -19.580   -2.925   14.571  214.541

Coefficients:
                         Estimate Std. Error t value Pr(>|t|)
(Intercept)               31.1803     3.0402  10.256  < 2e-16 ***
age                        0.3748     0.0634   5.912 3.75e-09 ***
maritl2. Married          18.2215     1.7610  10.347  < 2e-16 ***
maritl3. Widowed           1.4883     8.2501   0.180 0.856851
maritl4. Divorced          4.9779     2.9692   1.677 0.093741 .
maritl5. Separated        12.1753     4.9928   2.439 0.014803 *
education_num             14.5034     0.5647  25.683  < 2e-16 ***
jobclass2. Information     4.7411     1.3510   3.509 0.000456 ***
health_cat2. >=Very Good   7.7031     1.4629   5.265 1.50e-07 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 35.1 on 2991 degrees of freedom
Multiple R-squared:  0.2945,    Adjusted R-squared:  0.2926
F-statistic: 156.1 on 8 and 2991 DF,  p-value: < 2.2e-16
La limite de cet algorithme est qu’il n’explore pas toutes les possibilités. Il risque donc de se retrouver bloqué dans un optimum local et de rater le meilleur modèle absolu.
4.3 L’approche exhaustive
Pour obtenir le meilleur modèle possible (selon un certain critère), on peut utiliser une approche exhaustive qui va calculer et comparer absolument toutes les combinaisons possibles des variables. Prenons ici un nouvel objectif de prédiction : prédire si les personnes ont une assurance maladie (health_ins), en fonction de plusieurs variables sélectionnées.
On commence par sélectionner nos variables :
wage_reduced2_df = wage_df %>%
  select(age, maritl, race, education_num, jobclass, health_ins, wage, health_cat)
On fait notre glm complet :
glm_full = glm(health_ins ~ ., wage_reduced2_df, family="binomial")Puis on lance la sélection exhaustive avec la fonction dredge() du package MuMIn, qui va calculer tous les modèles possibles à partir du modèle complet et les classer selon la métrique choisie (ici le BIC) :
# Changement de l'option pour la gestion des NA, requis par MuMIn
options(na.action = "na.fail")
# On lance la sélection exhaustive sur notre modèle complet précédent
all_model_eval = dredge(glm_full, rank="BIC")
Fixed term is "(Intercept)"On peut ensuite examiner tous les différents modèles, dans l’ordre croissant. Ici, on va afficher uniquement les 10 permiers :
head(all_model_eval, 10)Global model call: glm(formula = health_ins ~ ., family = "binomial", data = wage_reduced2_df)
---
Model selection table
(Int) age edc_num hlt_cat jbc wag df logLik BIC delta
74 2.333 -0.01279 + -0.02347 4 -1640.889 3313.8 0.00
76 2.434 -0.01324 -0.08353 + -0.02214 5 -1638.849 3317.7 3.92
73 1.910 + -0.02450 3 -1647.008 3318.0 4.23
78 2.455 -0.01405 + + -0.02304 5 -1639.283 3318.6 4.79
75 1.987 -0.07437 + -0.02334 4 -1645.371 3322.8 8.96
80 2.537 -0.01434 -0.07716 + + -0.02185 6 -1637.560 3323.2 9.35
77 1.959 + + -0.02430 4 -1646.397 3324.8 11.01
68 2.443 -0.01417 -0.11950 -0.02235 4 -1646.410 3324.8 11.04
66 2.292 -0.01361 -0.02443 3 -1650.843 3325.7 11.90
70 2.428 -0.01498 + -0.02393 4 -1648.864 3329.8 15.95
weight
74 0.723
76 0.102
73 0.087
78 0.066
75 0.008
80 0.007
77 0.003
68 0.003
66 0.002
70 0.000
Models ranked by BIC(x) Si le coefficient de régression apparaît ou une croix est présente, c’est que la variable a été retenue dans le modèle. On voit que le meilleur modèle selon le BIC est celui qui contient les variables age, jobclass et wage.
On peut ensuite obtenir ce modèle avec la fonction get.models(), cela nous permet d’examiner les valeurs de ses coefficients, de faire des prédictions, ou autre :
glm_best = get.models(all_model_eval, 1)[[1]]
tidy(glm_best, exponentiate=T)
# A tibble: 4 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 10.3 0.201 11.6 4.66e-31
2 age 0.987 0.00367 -3.48 4.99e- 4
3 jobclass2. Information 0.680 0.0866 -4.45 8.55e- 6
4 wage 0.977 0.00158 -14.9 4.14e-50Attention cependant, dredge() est soumis au problème d’explosion combinatoire. Au delà d’un certain nombre de variables, le nombre de modèles à tester devient trop grand pour un ordinateur standard. Dans ces situations, pour trouver un modèle adéquat, il faudra se tourner vers la sélection gloutonne ou vers des méthodes de régression pénalisée couplées avec des techniques de Machine Learning.