A = matrix(c(2, 1, 3, 2), 2, 2)
A
[,1] [,2]
[1,] 2 3
[2,] 1 2B = matrix(c( 1, 1,
-1, 0), 2, 2, byrow=T)
B [,1] [,2]
[1,] 1 1
[2,] -1 0Le calcul matriciel est un outil mathématique incontournable pour résoudre des systèmes d’équations, effectuer des transformations linéaires et manipuler de vastes jeux de données. La quasi-totalité des méthodes statistiques, d’analyses multivariées et d’algorithmes de Machine Learning s’appuient dessus “sous le capot”.
Le maîtriser vous confère donc un avantage technique majeur : vous aurez la capacité de programmer et de comprendre vos propres modèles de A à Z, d’optimiser vos temps de calcul, et de vous affranchir de nombreux packages externes.
Contrairement à d’autres langages qui nécessitent des librairies supplémentaires (comme numpy en Python), le calcul matriciel est totalement natif dans R.
Une matrice \(\mathbf{A}=(a_{ij})\) de type \(n\times m\) est un tableau de nombres disposés selon \(n\) lignes et \(m\) colonnes. La quantité \(a_{ij}\) désigne la composante \(ij\) de \(\mathbf{A}\), i.e. le nombre situé à la ligne \(i\) et la colonne \(j\).
En R, on utilise la commande matrix() pour en créer une (byrow=T permet de remplir en ligne) :
A = matrix(c(2, 1, 3, 2), 2, 2)
A [,1] [,2]
[1,] 2 3
[2,] 1 2B = matrix(c( 1, 1,
-1, 0), 2, 2, byrow=T)
B [,1] [,2]
[1,] 1 1
[2,] -1 0Une matrice de type \(n\times m\) est carrée si \(n=m\).
Lorsque \(m=1\), c’est un vecteur-colonne.
Lorsque \(n=1\), c’est un vecteur-ligne.
Lorsque \(n=m=1\), c’est un est un scalaire, i.e. un nombre ordinaire d’un point de vue mathématique. Toutefois, R distingue les deux :
matrix(-0.73, 1, 1) [,1]
[1,] -0.73as.numeric(matrix(-0.73, 1, 1)) # en scalaire.[1] -0.73Les vecteurs de R (c()) sont considérés comme vecteurs sans dimension. Ils peuvent être utilisés dans un calcul matriciel, mais s’interprètent comme vecteurs-lignes ou vecteurs-colonnes en fonction du calcul demandé. (nous le verrons plus tard)
L’addition de deux matrices \(\mathbf{A}=(a_{ij})\) et \(\mathbf{B}=(b_{ij})\) de même type \(n\times m\) est une matrice de même type, dont les composantes sont données par \(a_{ij}+b_{ij}\) :
A [,1] [,2]
[1,] 2 3
[2,] 1 2B [,1] [,2]
[1,] 1 1
[2,] -1 0A + B [,1] [,2]
[1,] 3 4
[2,] 0 2La multiplication (matricielle) de deux matrices \(\mathbf{A}=(a_{ik})\) (de type \(n\times l\)) et \(\mathbf{B}=(b_{kj})\) (de type \(l\times m\)) est une matrice \(\mathbf{C}=(c_{ij})\) de type \(n\times m\), dont les composantes sont données par \(c_{ij}=\sum_{k=1}^l a_{ik}b_{kj}\).
Si le nombre de colonnes de \(\mathbf{A}\) diffère du nombre de lignes de \(\mathbf{B}\), le produit (matriciel) n’est pas défini.
En R, le calcul matriciel s’effectue à l’aide de l’opérateur %*% :
A %*% B [,1] [,2]
[1,] -1 2
[2,] -1 1La multiplication matricielle n’est pas commutative : \(\mathbf{AB}\neq \mathbf{BA}\) en général :
B %*% A [,1] [,2]
[1,] 3 5
[2,] -2 -3La multiplication matricielle entre une matrice et un vecteur (défini avec c()) et aussi possible, le vecteur sera transformé en vecteur-colonne ou vecteur-ligne en fonction de sa position dans le calcul :
C = matrix(c(1, 10, 100, 1000), 2, 2)
C
[,1] [,2]
[1,] 1 100
[2,] 10 1000C %*% c(1, 2) # le vecteur est interprété comme un vecteur-colonne [,1]
[1,] 201
[2,] 2010c(1, 2) %*% C # le vecteur est interprété comme un vecteur-ligne [,1] [,2]
[1,] 21 2100La multiplication matricielle diffère de la multiplication composante par composante entre \(\mathbf{A}\) et \(\mathbf{B}\) (qui doivent être de même type), notée \(\mathbf{A}\odot \mathbf{B}\), appelée aussi multiplication de Hadamard :
A*B [,1] [,2]
[1,] 2 3
[2,] -1 0Les autres opérateurs de calcul standards (-, /, ^) s’effectuent également composante par composante.
Si on utilise un opérateur de calcul standard entre un vecteur et une matrice, le vecteur sera “dupliqué” en boucle (en suivant les colonnes) pour atteindre la taille de la matrice : c’est encore une fois le principe de recyclage qui s’applique :
C * c(1, 2) # le vecteur est répété pour correspondre au nombre de lignes de C [,1] [,2]
[1,] 1 100
[2,] 20 2000D = matrix(1:9, 3, 3)
D * c(1, 10) # Un avertissement que le vecteur n'est pas un multiple, mais le calcul s'effectueWarning in D * c(1, 10): la taille d'un objet plus long n'est pas multiple de
la taille d'un objet plus court [,1] [,2] [,3]
[1,] 1 40 7
[2,] 20 5 80
[3,] 3 60 9D^2 # toutes les composantes de D sont élevées au carré (par recyclage) [,1] [,2] [,3]
[1,] 1 16 49
[2,] 4 25 64
[3,] 9 36 81La transposée de la matrice \(\mathbf{A}=(a_{ij})\) est la matrice \(\mathbf{A}'\equiv \mathbf{A}^\top=(a_{ji})\) obtenue en échangeant les lignes et les colonnes. On utilise la fonction t() en R :
t(A) [,1] [,2]
[1,] 2 1
[2,] 3 2L’inverse d’une matrice carrée \(\mathbf{A}\) est la matrice carrée de même type, notée \(\mathbf{A}^{-1}\), telle que \(\mathbf{A}^{-1}\mathbf{A}=\mathbf{I}\) (et \(\mathbf{A}\mathbf{A}^{-1}=\mathbf{I}\)). Si l’inverse existe, elle s’obtient avec la fonction solve():
solve(A) # l'inverse de A [,1] [,2]
[1,] 2 -3
[2,] -1 2La partie diagonale d’une matrice carré \(\mathbf{A}=(a_{ij})\) de type \(n\times n\) est le vecteur \(\mbox{diag}(\mathbf{A})\) dont les \(n\) composantes sont \(a_{ii}\) pour \(i=1,\ldots,n\). On l’obtient avec la fonction diag() :
G = matrix(c(1, 2, 3,
             4, 5, 6,
             7, 8, 9), 3, 3, byrow=T)
G
[,1] [,2] [,3]
[1,] 1 2 3
[2,] 4 5 6
[3,] 7 8 9diag(G)[1] 1 5 9La fonction diag() appliquée à un vecteur \(\mathbf{x}\) donne une matrice dont la partie diagonale vaut \(\mathbf{x}\), et les composantes hors de la diagonale valent zéro. Une telle matrice est dite diagonale :
x = c(1, 2, 3)
diag(x)
[,1] [,2] [,3]
[1,] 1 0 0
[2,] 0 2 0
[3,] 0 0 3En particulier, diag(diag(A)) remplace toutes les composantes hors diagonale de la matrice carrée \(A\) par zéro:
diag(diag(G)) [,1] [,2] [,3]
[1,] 1 0 0
[2,] 0 5 0
[3,] 0 0 9Enfin, lorsque l’argument de diag() est un nombre entier \(n\), la matrice produite est une matrice diagonale \(n\times n\) contenant des 1 sur la partie diagonale. C’est la matrice identité \(n \times n\), notée \(\mathbf{I}_n\) ou simplement \(\mathbf{I}\) :
I3 = diag(3)
I3
[,1] [,2] [,3]
[1,] 1 0 0
[2,] 0 1 0
[3,] 0 0 1Le produit scalaire de deux vecteurs \(\mathbf{x}\) et \(\mathbf{y}\) à \(n\) composantes est le nombre, noté \((\mathbf{x},\mathbf{y})\), défini par \(\sum_{i=1}^n x_iy_i\) :
x = c(1, 2, 3, 4)
y = c(0, -1, 1, 10)
# Le produit scalaire (x, y)
t(x) %*% y
[,1]
[1,] 41# Le produit scalaire (y, x) = (x, y)
t(y) %*% x [,1]
[1,] 41Comme les vecteurs de R sont considérés comme des vecteurs sans dimension, le produit scalaire peut être calculé sans spécifier la transposition du premier élément (le vecteur de gauche et considéré comme un vecteur-colonne et celui de droite comme vecteur-ligne) :
x %*% y [,1]
[1,] 41On a que \(\mathbf{x}^\top \mathbf{y}=\mathbf{y}^\top \mathbf{x}\) (car le résultat est un scalaire). Par contre, \(\mathbf{x} \mathbf{y}^\top\) et \(\mathbf{y} \mathbf{x}^\top\) sont deux matrices \(n\times n\) distinctes, transposées l’une de l’autre :
x %*% t(y) [,1] [,2] [,3] [,4]
[1,] 0 -1 1 10
[2,] 0 -2 2 20
[3,] 0 -3 3 30
[4,] 0 -4 4 40y %*% t(x) [,1] [,2] [,3] [,4]
[1,] 0 0 0 0
[2,] -1 -2 -3 -4
[3,] 1 2 3 4
[4,] 10 20 30 40La norme euclidienne de \(\mathbf{x}\), notée \(\|\mathbf{x}\|\), est définie par \(\|\mathbf{x}\|=\sqrt{(\mathbf{x},\mathbf{x})}\) :
# Le carré scalaire (x,x), donnant
# le carré de la norme euclidienne de x
t(x) %*% x
[,1]
[1,] 30# Expression équivalente
sum(x^2) [1] 30# Norme euclidienne de x
sqrt(t(x) %*% x) [,1]
[1,] 5.477226Il découle de l’identité (cf. cours de géométrie) : \[ (\mathbf{x},\mathbf{y})=\|\mathbf{x}\|\|\mathbf{y}\|\cos\alpha \] où \(\alpha=\angle(\mathbf{x},\mathbf{y})\) est l’angle entre \(\mathbf{x}\) et \(\mathbf{y}\), que : \[ \cos\alpha=\frac{(\mathbf{x},\mathbf{y})}{\|\mathbf{x}\|\|\mathbf{y}\|} \]
# Cosinus de l'angle entre x et y
cosa = (t(x) %*% y) / sqrt(sum(x^2)*sum(y^2))
# Angle entre x et y, en radians
acos(cosa)
[,1]
[1,] 0.7359713# Angle entre x et y en degrés
acos(cosa) * (360 / (2*pi)) [,1]
[1,] 42.16805Une matrice carrée \(\mathbf{U}\) est orthogonale ssi \(\mathbf{U}\mathbf{U}^\top=\mathbf{U}^\top \mathbf{U}=I\), ou, de façon équivalente, ssi \(\mathbf{U}^{-1}=\mathbf{U}^\top\) :
# Angle en radians; correspond à 45 degrés
alpha = pi / 4
# Matrix de rotation de 45 degrés
U = matrix(c(cos(alpha), -sin(alpha),
             sin(alpha), cos(alpha)), 2, 2, byrow=T)
U
[,1] [,2]
[1,] 0.7071068 -0.7071068
[2,] 0.7071068 0.7071068# U est orthogonale : UU' = U'U = I
U %*% t(U) [,1] [,2]
[1,] 1.000000e+00 1.014654e-17
[2,] 1.014654e-17 1.000000e+00Toute matrice \(n\times n\) symétrique (i.e. telle que \(\mathbf{A}^\top=\mathbf{A}\)) se décompose de façon (presque) unique comme : \[ \mathbf{A}=\mathbf{U}\Lambda\mathbf{U}^\top, \] où \(\mathbf{U}\) est une matrice orthogonale \(n\times n\), et \(\Lambda=\mbox{diag}(\mathbf{\lambda})\) est une matrice orthogonale, dont les composantes \(\lambda_\alpha\) sont ordonnées de façon décroissante : \(\lambda_1\ge\lambda_2\ge\ldots\ge\lambda_\alpha\ge\ldots\ge\lambda_n\).
Les vecteurs colonne dans \(\mathbf{U}=(\mathbf{u}_1|\ldots |\mathbf{u}_\alpha|\ldots |\mathbf{u}_n)\) sont les vecteur propres de \(\mathbf{A}\), et les composantes \(\lambda_\alpha\) sont les valeurs propres correspondantes. On a \(\mathbf{A}\mathbf{u}_\alpha=\lambda_\alpha \mathbf{u}_\alpha\).
En R, la décomposition spectrale s’effectue avec la fonction eigen()
# On crée une matrice 4x4 avec 16 valeurs distribuées normalement
A = matrix(rnorm(16, mean=0, sd=1), 4, 4)
# On symétrise A, pour pourvoir y appliquer la décomposition spectrale
A = (A + t(A)) / 2
# Résultat de la décomposition spectrale
eigen(A)
eigen() decomposition
$values
[1] 1.94694210 0.04278969 -1.10585542 -2.44893220
$vectors
[,1] [,2] [,3] [,4]
[1,] -0.3881903 -0.5113983 0.7615779 -0.08819943
[2,] -0.5698741 -0.3736099 -0.4770749 0.55503029
[3,] 0.3253683 0.2143133 0.4055213 0.82689647
[4,] -0.6470604 0.7436110 0.1671857 -0.02011152Le résultat est une liste qui contient les éléments values (les valeurs propres) et vectors (les vecteurs propres) :
# Donne les vecteurs propres de A
U = eigen(A)$vectors
# Donne les valeurs propres de A, ordonnées par valeurs décroissantes
lambda = eigen(A)$values
# Vaut A en vertu du théorème de décomposition spectrale
U %*% diag(lambda) %*% t(U)
[,1] [,2] [,3] [,4]
[1,] -0.3558690 0.9605510 -0.4135209 0.3276189
[2,] 0.9605510 -0.3678530 -1.2744266 0.8215728
[3,] -0.4135209 -1.2744266 -1.6482542 -0.4373242
[4,] 0.3276189 0.8215728 -0.4373242 0.8069203# Vérification
U %*% diag(lambda) %*% t(U) - A [,1] [,2] [,3] [,4]
[1,] 9.992007e-16 -2.220446e-16 1.665335e-16 -5.551115e-17
[2,] -2.220446e-16 4.662937e-15 1.776357e-15 -4.218847e-15
[3,] 1.110223e-16 1.776357e-15 2.664535e-15 -1.165734e-15
[4,] 0.000000e+00 -4.218847e-15 -1.221245e-15 4.218847e-15\(\mbox{det}(\mathbf{A})\) désigne le déterminant de la matrice carrée \(\mathbf{A}\), défini comme le produit \(\prod_{\alpha=1}^n\lambda_\alpha\) de ses valeurs propres. La fonction det() calcule le déterminant d’une matrice carrée :
A = matrix(c(1, 2, 3,
             2, 4, 5,
             3, 5, 6), c(3, 3), byrow=T)
A
[,1] [,2] [,3]
[1,] 1 2 3
[2,] 2 4 5
[3,] 3 5 6eigen(A)$values[1] 11.3448143 0.1709152 -0.5157295det(A)[1] -1Une matrice \(\mathbf{A}\) possède un inverse ssi \(\mbox{det}(\mathbf{A})\neq0\). C’est bien le cas ici :
solve(A) [,1] [,2] [,3]
[1,] 1 -3 2
[2,] -3 3 -1
[3,] 2 -1 0Par contre le déterminant de \(\mathbf{B}\) ci-dessous est nul, et \(\mathbf{B}\) ne possède pas d’inverse:
B = matrix(c(1, 2, 3,
             2, 4, 5,
             2, 4, 5), 3, 3, byrow=T)
det(B)
[1] 0solve(B)Error in `solve.default()`:
! Routine Lapack dgesv : le système est exactement singulier : U[2,2] = 0Le rang \(\mbox{rang}(\mathbf{A})\) d’une matrice \(n\times m\) est le nombre de lignes (ou, de façon équivalente, de colonnes) linéairement indépendantes. Aucune ligne (ou colonne) ne peut s’exprimer comme combinaison linéaire des autres lignes (ou colonnes). On doit charger le package Matrix pour calculer le rang d’une matrice avec la fonction rankMatrix() :
# Chargement du package R "Matrix"
library(Matrix)
# La première composante de la fonction rankMatrix()
# donne le rang
rankMatrix(A)[1]
[1] 3rankMatrix(B)[1][1] 2En statistique, il est parfois nécessaire de générer ses propres données, par exemple pour voir comment se comporte une méthode si l’échantillon choisi vient d’une loi particulière de probabilité. Pour cela, R contient beaucoup d’outils permettant de générer des nombres ou des échantillons aléatoires. R possède également plusieurs fonctions qui se rapportent à certaines lois de probabilité, permettant d’obtenir des quantiles, la densité, etc.
La fonction permettant de tirer un échantillon aléatoire parmi un vecteur donné, est sample() :
# Création d'une séquence de 1 à 10
x = 1:10
# Permutation aléatoire
sample(x)
[1] 3 9 8 1 5 2 10 6 7 4# Tirage de 3 éléments sans remise
sample(x, 3)[1] 5 3 2# Tirage de 3 éléments avec remise
sample(x, 3, replace=T)[1] 1 6 9On peut également générer des nombres aléatoires issus de différentes lois de probabilité avec les fonctions suivantes :
rnorm() : loi normale.rpois() : loi de Poisson.rbinom() : loi binomiale.runif() : loi uniforme.rchisq() : loi du chi2.rt() : loi de Student.Par exemple :
# 10000 points N(2,2)
a = rnorm(10000, mean=2, sd=2)
 # 10000 points Chi2(4)
b = rchisq(10000, 4)La lettre “r” devant le nom abrégé de la loi dans ces fonctions veut dire random generation. Mais il nous est également possible, pour toutes les lois, d’utiliser :
“d” : donne la densité.
“p” : donne la distribution.
“q” : donne un quantile.
Par exemple pour une loi Normale \(N(0,1)\) :
# La densité en 0
dnorm(0)
[1] 0.3989423# La distribution en 2.58
pnorm(2.58)[1] 0.99506# Le quantile 0.975
qnorm(0.975)[1] 1.959964R contient de nombreuses fonctions pour effectuer des tests statistiques, comme les tests de Student, les tests du chi2, les tests de corrélation. Ici, on va s’intéresser aux tests suivants :
On va utiliser ici le jeu de données phonétique.xlsx pour illustrer ces tests, qui s’intéresse à la prononciation, en français, de différentes voyelles par des locuteurs faisant partie de différentes régions francophones (voir le fichier phonétique_info.docx) pour plus d’information. On va avoir besoin des deux packages suivants :
library(tidyverse)── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr 1.2.1 ✔ readr 2.2.0
✔ forcats 1.0.1 ✔ stringr 1.6.0
✔ ggplot2 4.0.3 ✔ tibble 3.3.1
✔ lubridate 1.9.5 ✔ tidyr 1.3.2
✔ purrr 1.2.2
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ tidyr::expand() masks Matrix::expand()
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag() masks stats::lag()
✖ tidyr::pack() masks Matrix::pack()
✖ tidyr::unpack() masks Matrix::unpack()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errorslibrary(readxl)Et on charge le jeu de données :
phonetique_df = read_excel("data/phonétique.xlsx")Les tests univariés concernent une seule variable, que l’on peut éventuellement mesurer sur deux échantillons (deux groupes) différents. Tous ces tests s’effectuent avec la même fonction t.test() (car on utilise à chaque fois la loi \(t\) de Student), mais en modifiant ses paramètres.
Commençons par le test le plus simple, le test de la moyenne pour un échantillon. On pose l’hypothèse que la moyenne de la durée de prononciation des voyelles en français est de 180ms, on a donc les hypothèses suivantes : \[ \begin{cases} H_0 : \mu_x = 180 \\ H_1 : \mu_x \neq 180 \end{cases} \] où \(\mu_x\) est la moyenne théorique de la durée de prononciation des voyelles en français.
On teste ces hypothèses avec :
t.test(phonetique_df$Dur_V, mu=180)
    One Sample t-test

data:  phonetique_df$Dur_V
t = 1.1318, df = 2737, p-value = 0.2578
alternative hypothesis: true mean is not equal to 180
95 percent confidence interval:
 178.5926 185.2504
sample estimates:
mean of x
 181.9215
Et avec un p-valeur = 0.2578, on voit que cette hypothèse semble tenir la route dans ce jeu de données. (si l’on avait voulu faire un test unilatéral, on aurait dû mettre l’argument de la fonction alternative sur "less" ou "greater").
Notons ici que la sortie d’un test est une sortie composite, qui contient plusieurs éléments, comme la moyenne de l’échantillon, la statistique du test, la p-valeur, etc. Il est possible d’extraire chacun de ces éléments de la sortie du test avec l’opérateur $ :
t_test_res = t.test(phonetique_df$Dur_V, mu=180)
names(t_test_res) # Liste de ce que l'on peut extraire
[1] "statistic" "parameter" "p.value" "conf.int" "estimate"
[6] "null.value" "stderr" "alternative" "method" "data.name" t_test_res$estimate # La moyenne de l'échantillonmean of x
181.9215 t_test_res$statistic # La statistique du test t
1.131812 t_test_res$p.value # La p-valeur[1] 0.2578128Ce test consiste à vérifier si la moyenne d’une variable numérique est significativement différente dans deux groupes constitués de personnes différentes.
Ici, nous allons tester si la durée de prononciation des mots est significativement différente entre les femmes et les hommes : \[ \begin{cases} H_0 : \mu_x = \mu_y \\ H_1 : \mu_x \neq \mu_y \end{cases} \] où \(\mu_x\) est la moyenne théorique chez les femmes et \(\mu_y\) la moyenne théorique chez les hommes.
Pour cela on peut extraire deux vecteurs de notre jeu de données. Le vecteurs de durée pour les femmes :
duree_f = phonetique_df %>%
  filter(Sexe=="F") %>%
  .$Dur_M # Le pipe envoie le résultat à la place du "."
head(duree_f, 100)
[1] 222 274 429 272 229 350 406 328 237 323 200 454 281 408 343 326 493 567
[19] 227 292 287 236 270 303 329 252 318 326 244 268 305 373 447 299 405 245
[37] 275 337 268 347 286 430 252 288 370 228 239 330 287 260 356 188 192 419
[55] 236 296 302 377 351 474 240 312 260 199 220 365 282 181 317 170 311 313
[73] 377 285 258 414 257 375 302 363 224 297 258 384 433 394 493 325 376 477
[91] 343 440 347 461 316 561 443 541 505 478Et pour les hommes :
duree_m = phonetique_df %>%
  filter(Sexe=="M") %>%
  .$Dur_M
head(duree_m, 100)
[1] 286 325 293 332 218 314 333 230 226 386 190 481 283 212 249 273 469 274
[19] 303 336 281 297 295 282 330 389 259 306 300 397 298 263 302 258 325 233
[37] 266 330 316 298 355 202 235 363 312 198 286 286 184 201 421 163 295 349
[55] 195 253 239 311 351 264 386 276 302 214 242 282 418 385 419 254 409 250
[73] 258 334 296 314 271 215 310 290 298 294 312 421 468 522 391 466 521 331
[91] 296 499 237 517 388 466 370 561 475 413Et on utilise encore une fois la fonction t.test() avec cette fois-ci deux vecteurs en entrée :
t.test(duree_f, duree_m)
    Welch Two Sample t-test

data:  duree_f and duree_m
t = 3.9425, df = 2735.9, p-value = 8.265e-05
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 10.92612 32.54837
sample estimates:
mean of x mean of y
 479.2391  457.5019
Le résultat est ici très significatif (p-valeur = 8.265e-05), et on peut voir que la durée moyenne des mots est plus élevée chez les femmes que chez les hommes.
Ce test consiste à vérifier si la moyenne d’une variable numérique est significativement différente dans deux groupes constitués de personnes identiques. Ce test consiste en fait à calculer la différence entre les valeurs de cette variable pour chaque personne, puis à vérifier si la moyenne de cette différence est significativement différente de 0.
Nous allons tester ici s’il existe une différence significative de durée entre la prononciation de [e] et [e:]. Pour obtenir la tableau des durées de ces deux voyelles par locuteur, on fait les opérations suivantes :
duree_e = phonetique_df %>%
  filter(Opposition=="e(:)") %>%
  group_by(Locuteur, Voyelle) %>%
  summarise(duree=mean(Dur_V)) %>%
  pivot_wider(names_from=Voyelle, values_from=duree)
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by Locuteur and Voyelle.
ℹ Output is grouped by Locuteur.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(Locuteur, Voyelle))` for per-operation grouping
(`?dplyr::dplyr_by`) instead.duree_e# A tibble: 84 × 3
# Groups: Locuteur [84]
Locuteur e `e:`
<chr> <dbl> <dbl>
1 74bac1 113 270
2 74bag1 140. 156
3 74bam1 208. 184.
4 74bbb1 116 134.
5 74bdc1 264. 212.
6 74bem1 143. 142
7 74bgs1 243. 241
8 74blm1 187. 154.
9 74bmc1 138. 222.
10 74bpf1 142. 167
# ℹ 74 more rowsOn va maintenant créer la différence de durée moyenne pour chaque locuteur·trice :
duree_e = duree_e %>%
  mutate(diff_duree=`e:` - e)
duree_e
# A tibble: 84 × 4
# Groups: Locuteur [84]
Locuteur e `e:` diff_duree
<chr> <dbl> <dbl> <dbl>
1 74bac1 113 270 157
2 74bag1 140. 156 16.5
3 74bam1 208. 184. -24
4 74bbb1 116 134. 17.5
5 74bdc1 264. 212. -51
6 74bem1 143. 142 -0.667
7 74bgs1 243. 241 -2.33
8 74blm1 187. 154. -33
9 74bmc1 138. 222. 85
10 74bpf1 142. 167 24.7
# ℹ 74 more rowsPar défaut, la fonction t.test() teste si la moyenne du vecteur est significativement différente de 0, c’est à dire : \[
\begin{cases}
H_0 : \mu_z = 0 \\
H_1 : \mu_z \neq 0
\end{cases}
\] où les \(z_i\) sont les différences de durée pour chaque locuteur·trice, i.e. \(z_i = x_i - y_i\) avec \(x_i\) la durée pour e: et \(y_i\) la durée pour e. On peut donc directement appliquer le test de Student à ce vecteur de différences :
t.test(duree_e$diff_duree)
    One Sample t-test

data:  duree_e$diff_duree
t = 11.612, df = 83, p-value < 2.2e-16
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
  99.35209 140.42172
sample estimates:
mean of x
 119.8869
Notez, qu’on aurait aussi pu tester directement avec les deux vecteurs, en précisant que les groupes sont appariés avec l’option paired=T :
t.test(duree_e$`e:`, duree_e$e, paired=T)
    Paired t-test

data:  duree_e$`e:` and duree_e$e
t = 11.612, df = 83, p-value < 2.2e-16
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
  99.35209 140.42172
sample estimates:
mean difference
119.8869 Pour tester les liens entre deux variables, on effectue des tests bivariés. Le test à utiliser dépend des types de variables que nous voulons tester :
Le lien entre deux variables numériques se mesure avec la corrélation. Un test de corrélation va déterminer si cette corrélation est significativement différente de 0 : \[ \begin{cases} H_0 : \rho_{xy} = 0 \\ H_1 : \rho_{xy} \neq 0 \end{cases} \]
Ici, nous allons tester s’il existe un lien entre la durée de la voyelle et sa valeur du premier formant F1. On effectue ce test avec cor.test(), en fournissant les deux vecteurs de variables numériques :
cor.test(phonetique_df$Dur_V, phonetique_df$F1)
    Pearson's product-moment correlation

data:  phonetique_df$Dur_V and phonetique_df$F1
t = -10.165, df = 2736, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.2266144 -0.1544177
sample estimates:
      cor
-0.190774
La corrélation est négative et fortement significative (p-valeur < 2.2e-16).
Le lien entre une variable numérique et catégorielle se mesure avec le F-ratio. Un test du F-ratio va définir si ce ratio est significativement différent de 0. Si le F-ratio = 0, il n’y a pas de lien entre les deux variables et les groupes définis par la variables catégorielles ont des moyennes (de la variable numérique) identiques : \[ \begin{cases} H_0 : \mu_1 = \mu_2 = \ldots = \mu_m \\ H_1 : H_0 \text{ est fausse} \end{cases} \] où \(\mu_j\) est la moyenne de la variable numérique dans le groupe \(j\) défini par la variable catégorielle. Nous testons ici si la variable région a une influence sur la durée de prononciation des mots.
Un F-test se fait de manière un peu particulière dans R. On doit d’abord faire appel à un modèle d’analyse de variance, grâce à la fonction aov() qui utilise une formule. Ici, pour tester si Dur_M dépend de Region, le modèle à créer est le suivant :
f_test_model = aov(Dur_M ~ Region, phonetique_df)On peut voir le résultat du test en passant notre modèle dans la fonction summary() :
summary(f_test_model) Df Sum Sq Mean Sq F value Pr(>F)
Region 4 3214708 803677 40.59 <2e-16 ***
Residuals 2733 54117756 19802
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Encore une fois, le test est très fortement significatif et il y a un lien fort entre les régions et la durée de prononciation des mots.
Notez que ce test nous dit uniquement s’il y a une différence significative de la durée parmi les régions, mais on ne peut pas savoir, uniquement avec ce résultat, quelles régions ont une tendance à la hausse ou à la baisse. On peut étudier ce lien plus en profondeur à l’aide d’un graphique :
ggplot(phonetique_df, aes(x=Region, y=Dur_M)) +
  geom_boxplot() +
  theme_minimal()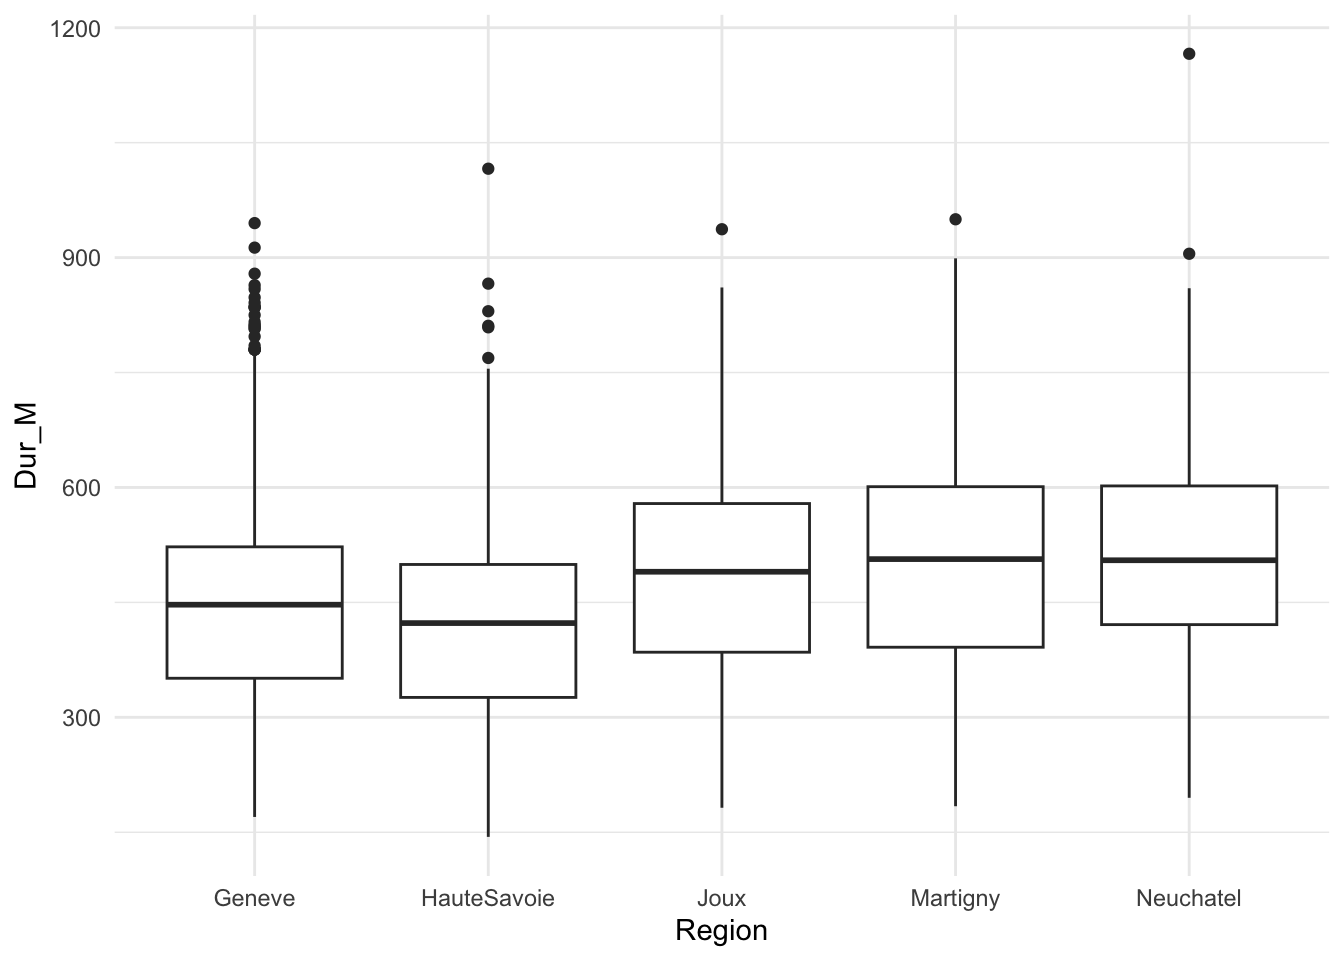
Finalement, pour tester le lien entre deux variables catégorielles, on utilise un test du chi2 sur une table de contingence. Ce test regarde si le chi2 (qui mesure l’écart entre notre table et la table que l’on devrait avoir en cas d’indépendance des variables catégorielles) est significativement différent de 0. Les hypothèses de ce test se formulent généralement de la façon suivante : \[ \begin{cases} H_0 : X \text{ et } Y \text{ sont indépendantes} \\ H_1 : H_0 \text{ est fausse} \end{cases} \] où \(X\) et \(Y\) sont les deux variables catégorielles que l’on veut tester.
Par exemple, on peut tester ici si il y a un lien entre la variable Region et la Sexe (l’existence d’un lien montrerait que notre échantillonnage est particulier).
Avant de faire un test du chi2, il nous faut créer une table de contingence. On peut utiliser pour cela la fonction table(), en ne gardant au préalable que les 2 colonnes des variables catégorielles :
cont_table = phonetique_df %>%
  select(Region, Sexe) %>%
  table()
cont_table
Sexe
Region F M
Geneve 363 324
HauteSavoie 353 354
Joux 159 230
Martigny 295 231
Neuchatel 231 198On peut alors directement utiliser chisq.test() sur cette table pour faire un test du chi2 entre les deux variables catégorielles :
chisq.test(cont_table)
    Pearson's Chi-squared test

data:  cont_table
X-squared = 24.017, df = 4, p-value = 7.925e-05
Un lien semble exister, nous pouvons représenter graphiquement les proportions femmes-hommes dans chaque région :
ggplot(phonetique_df) +
  geom_bar(aes(x=Region, fill=Sexe), position="fill") +
  theme_minimal()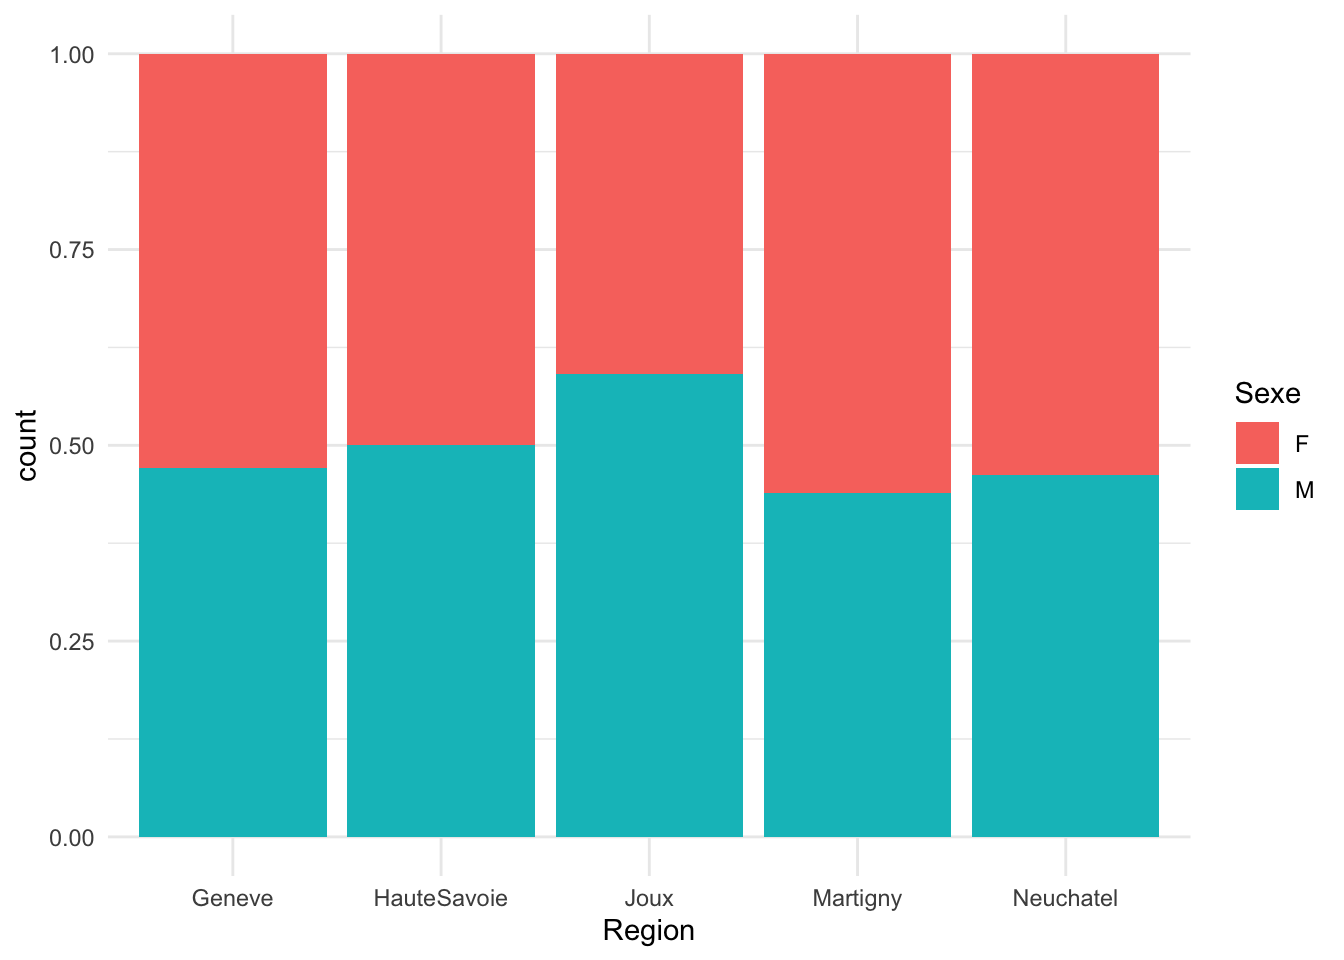
On voit que la vallée de Joux semble avoir une surreprésentation masculine dans notre échantillon.