R de base dispose de bonnes capacités graphiques. Cependant, il y a un certain consensus sur le fait qu’utiliser la librairie ggplot2, contenue dans le tidyverse, améliore nettement l’expérience et les rendus.
La librairie ggplot2 est l’une des premières a avoir été développées dans le tidyverse et permet la création d’une grande variété de graphiques. Plus précisément, elle fonctionne selon une logique appelée la “grammaire des graphiques” (Grammar of Graphics). L’idée centrale est qu’on construit un graphique en superposant des couches (layers) avec le symbole +.
On trouve de nombreux codes en ligne qui permettent de faire des graphiques particuliers. Une méthode de travail peut être d’aller chercher un exemple de graphique sur une base de données, par exemple https://www.r-graph-gallery.com/ggplot2-package.html, puis d’adapter le code trouvé à ses besoins.
Nous pouvons déjà charger ggplot2 en chargeant l’entièreté du tidyverse :
library(tidyverse)
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
2 Le jeu de données sociolinguistique
Dans ce TP, nous allons utiliser le jeu de sociolinguistique_v2.csv. Ce jeu de données vient du jeu de données “brut” sociolinguistique_raw.xlsx, dont nous avons effectués plusieurs pré-traitements d’un cours précédant. Ces pré-traitements sont contenus dans le script pretraitements.R donné dans le dossier de ce cours.
Chargeons le et transformons directement toutes les chaînes de caractères en variable catégorielles (en “facteurs”) :
Rows: 113 Columns: 61
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
chr  (12): acc_mode, acc_exclu, acc_accept, acc_enrich, acc_suppr, acc_menac...
dbl  (47): id, annee, duree, duree_num, Hashtag, Design, Selfie, Pull-over, ...
dttm  (2): h_deb, h_fin

ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.
Ce jeu de données ne contient pas beaucoup de variables numériques, nous allons donc en créer une nouvelle, qui sera le nombre d’anglicismes connus parmi la liste donnée (39 anglicismes) :
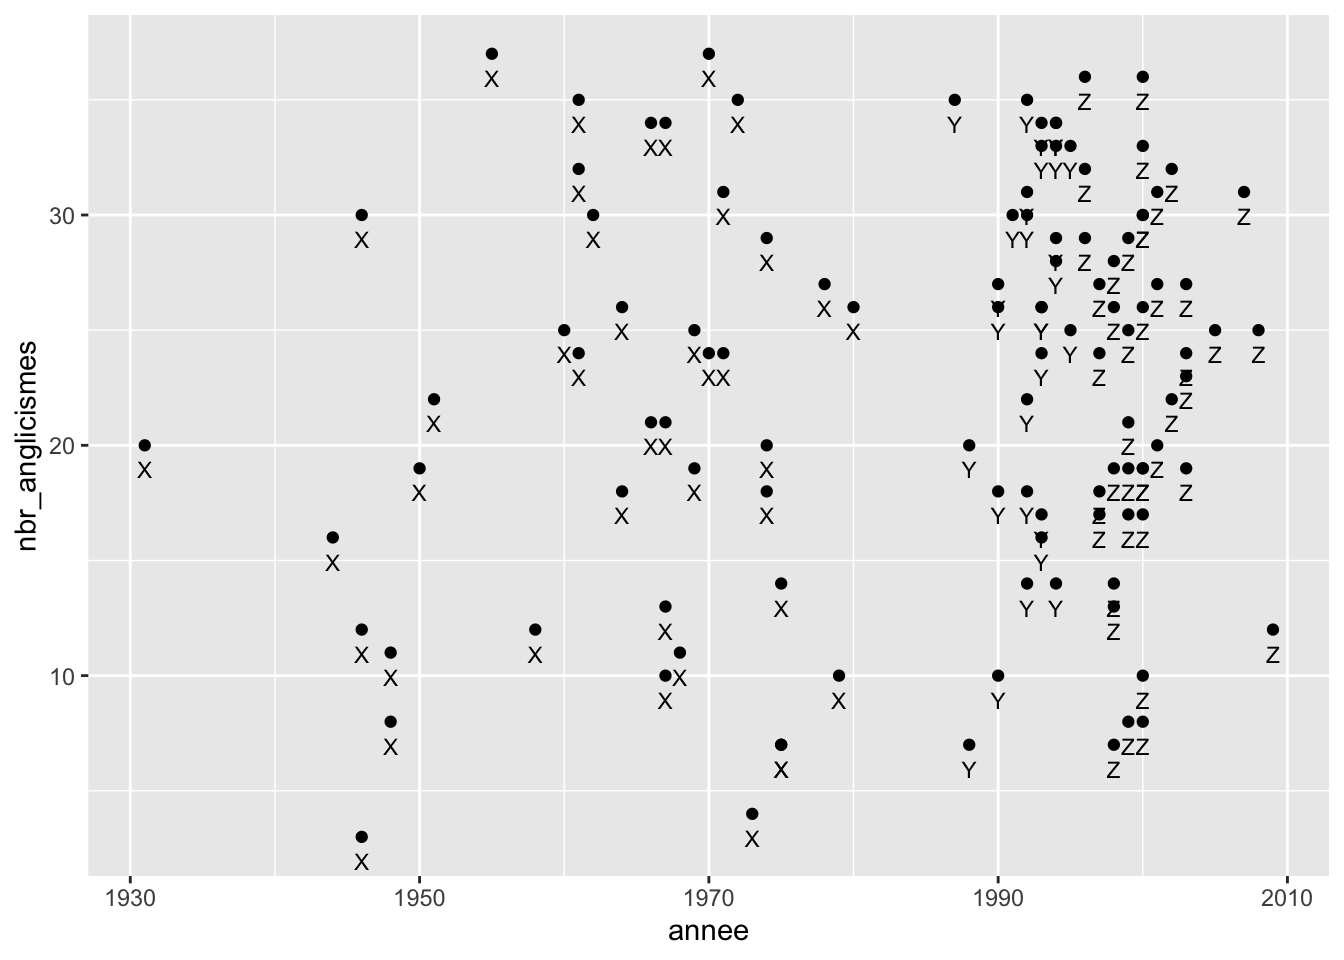
Nous allons créer une variable catégorielle generation à partir de annee qui contiendra les différentes générations (“X”, “Y” ou “Z”). Nous transformons cette variable en variable ordinale en appliquant la fonction factor() avec l’ordre des modalités spécifié :
On peut voir que cette dernière possède bien un ordre lorsque l’on l’affiche. Cet ordre définit comment les modalités vont s’afficher dans les graphiques :
socioling_df$generation
  [1] Z X X X X X X Y X X Y Z Y Y X Y X Z X Z Z Y Y Y X Y Z Y X Y Y Y Y X Y X X
 [38] X X Z Z X X X Z Y X Z X X X X Z Z Y Z X Y Y Z Z Z Z Z X Y X Z X X Y Z X Z
 [75] X Y Z Z Z X X X Z Z X X Z Z Z Z Z Z Y Z Z Z Z Z Z Z Z X Z Y Y Z X Y Y Y X
[112] X Y
Levels: X < Y < Z
Finalement, nous allons transformer également toutes les variables commençant par acc_ en variables ordinales. La commande est particulière car on utilise factor() comme une fonction “anonyme” (similaire aux fonctions lambda en Python), permettant de spécifier des arguments :
socioling_df = socioling_df %>%mutate(across(starts_with("acc_"), ~factor(.x, order=T, levels=c("En désaccord total","Plutôt en désaccord","Neutre", "Plutôt d'accord","Tout à fait d'accord"))))
La commande minimale pour faire un graphique avec ggplot2 nécessite la fonction ggplot(), suivie d’une fonction de géométrie (reliées avec l’opérateur +). La structure est la suivante :
Dans la fonction ggplot(), on fournit généralement le jeu de données avec lequel nous allons faire notre graphique. La <fonction_de_geometrie> va être choisie en fonction de quel graphique nous allons produire. Cette dernière prend comme argument obligatoire une autre fonction aes() (l’esthétique), dont les arguments vont définir comment tracer les points, traits, barres par rapport aux données.
3.2 Différence cruciale : Mapping vs Setting
Il est fondamental de comprendre la différence entre placer un paramètre dans la fonction aes() ou en dehors.
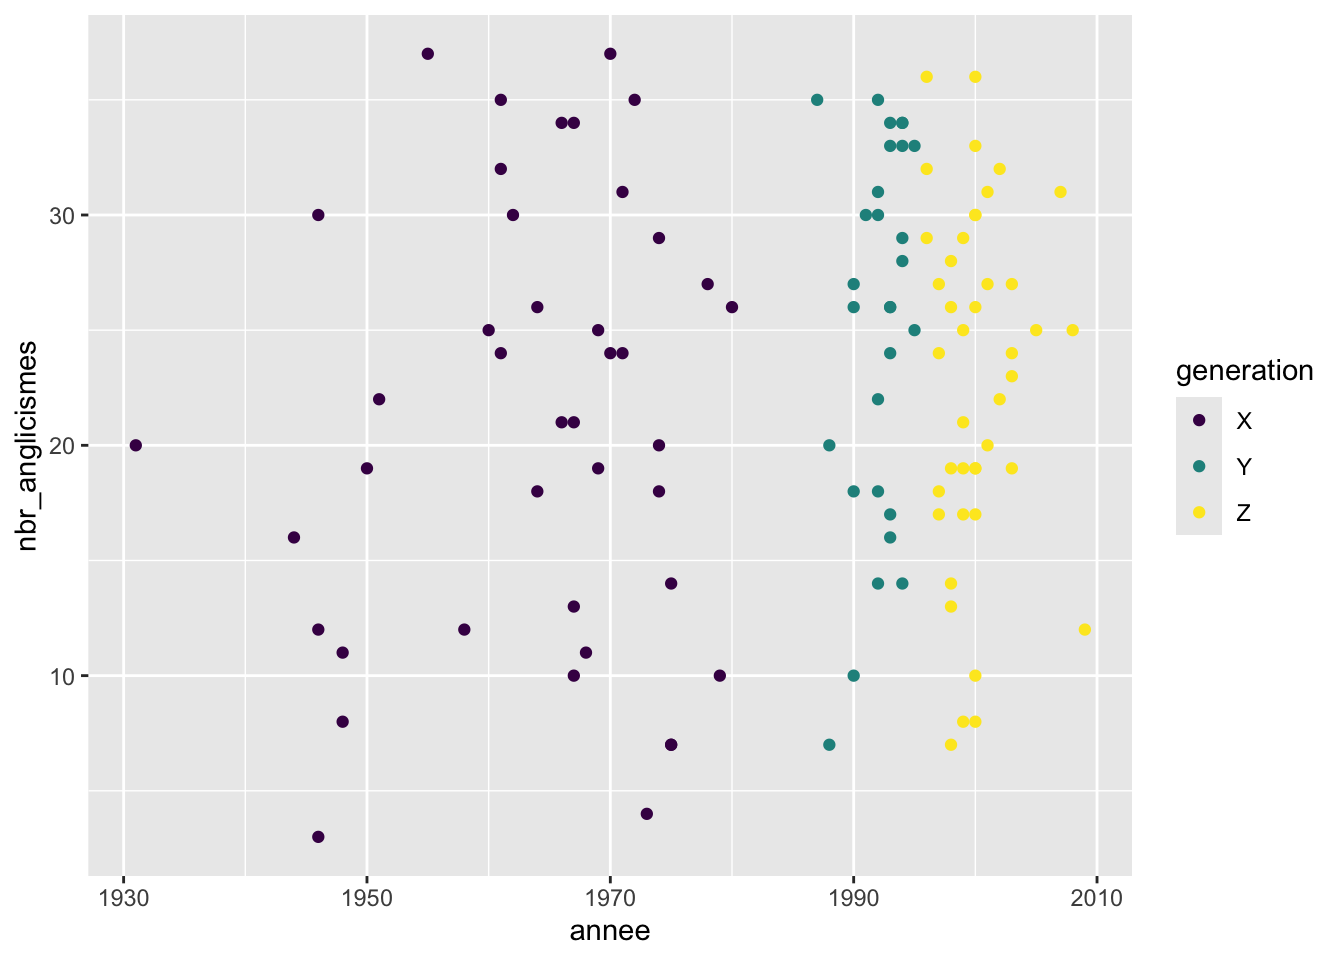
Dans aes() (Mapping) : On lie une propriété visuelle à une variable de notre jeu de données. La couleur, la taille ou la forme changera en fonction des données.
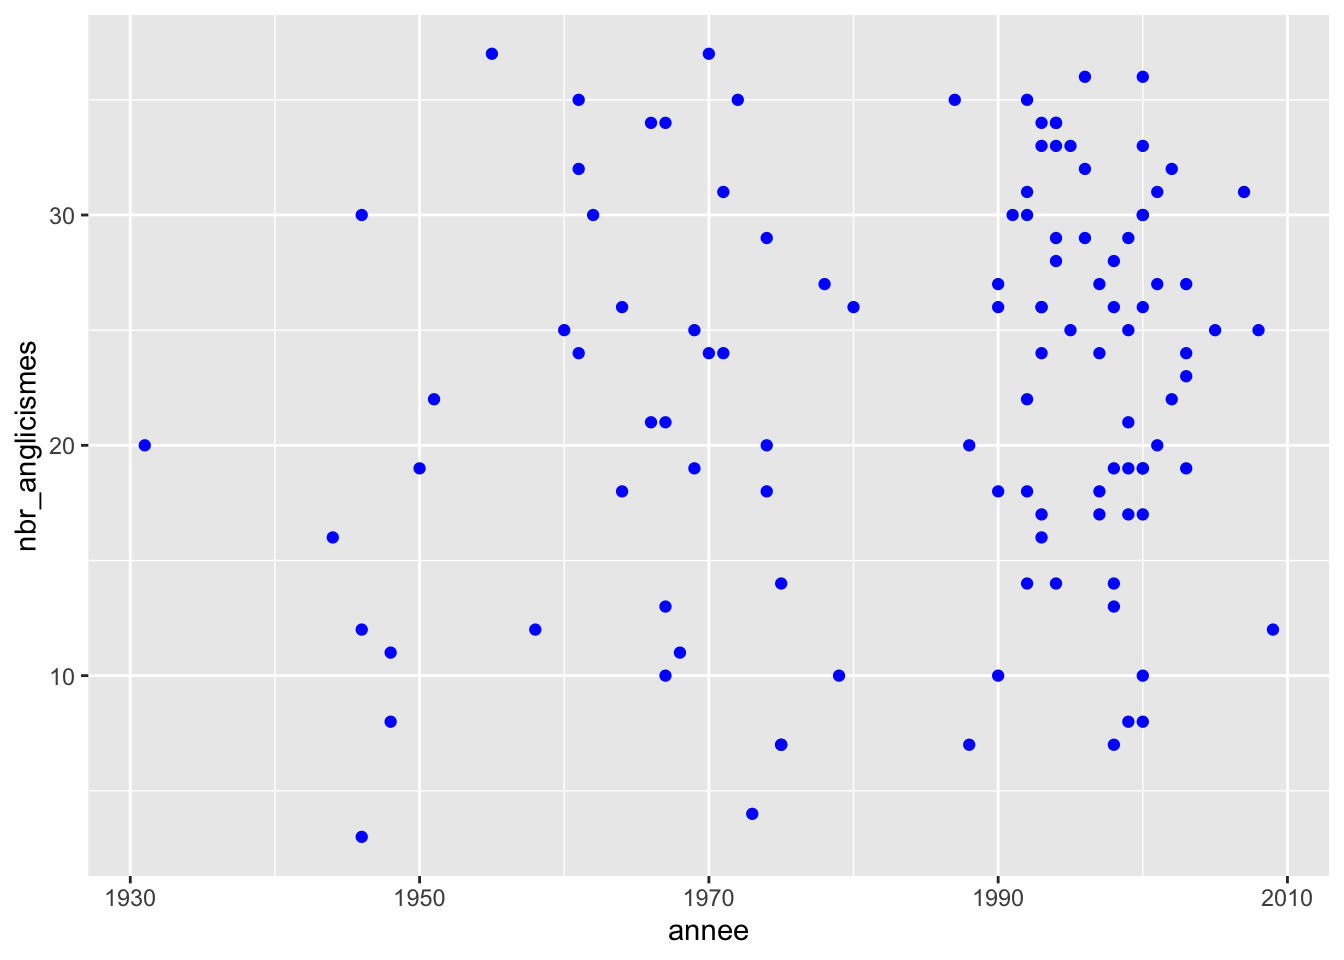
Hors de aes() (Setting) : On fixe une propriété visuelle pour toute la géométrie, de manière globale.
Pour illuster cette différence :
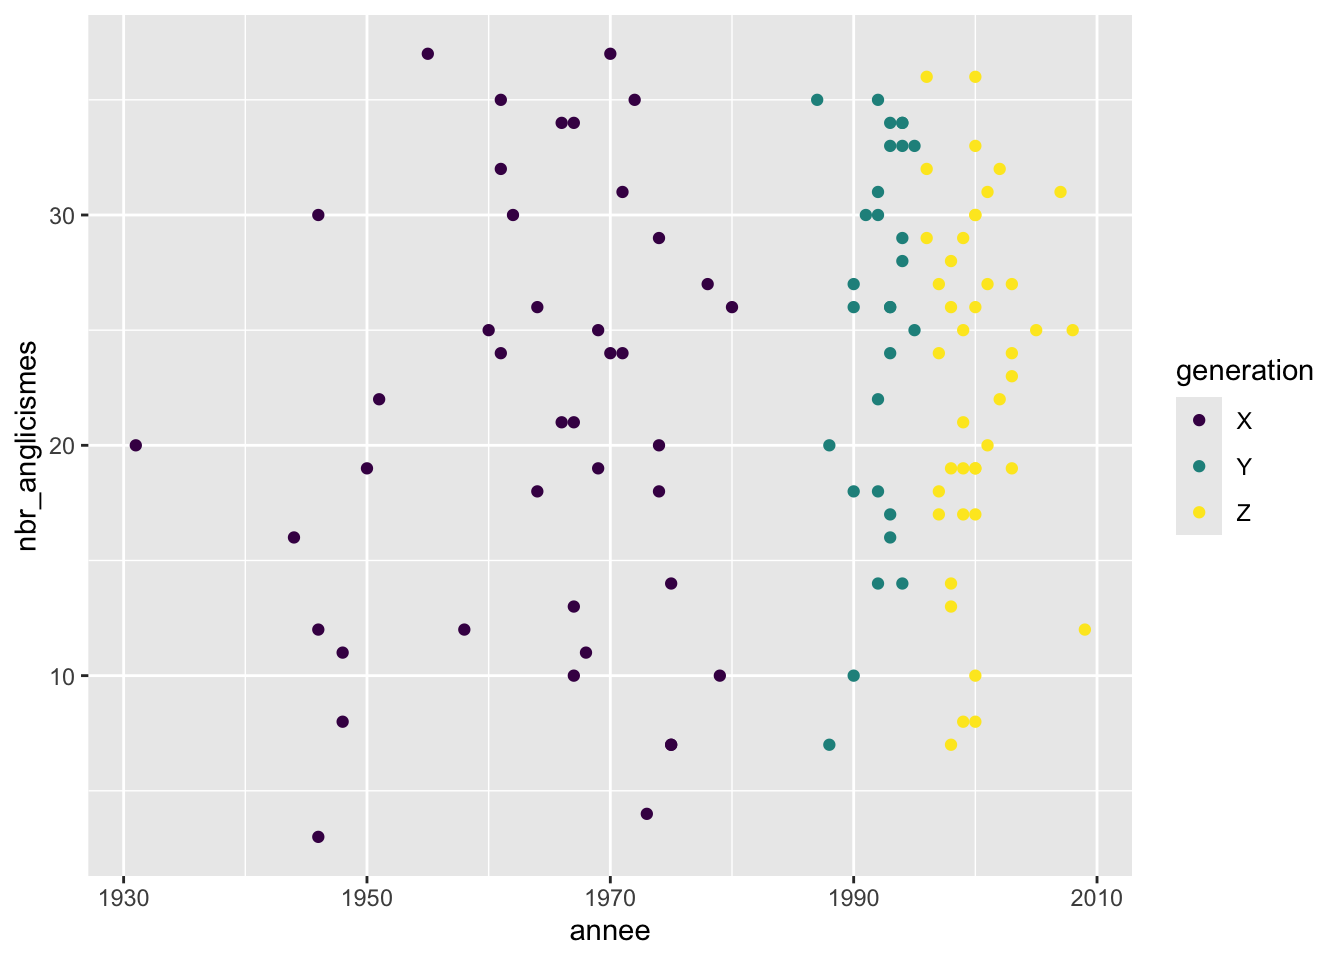
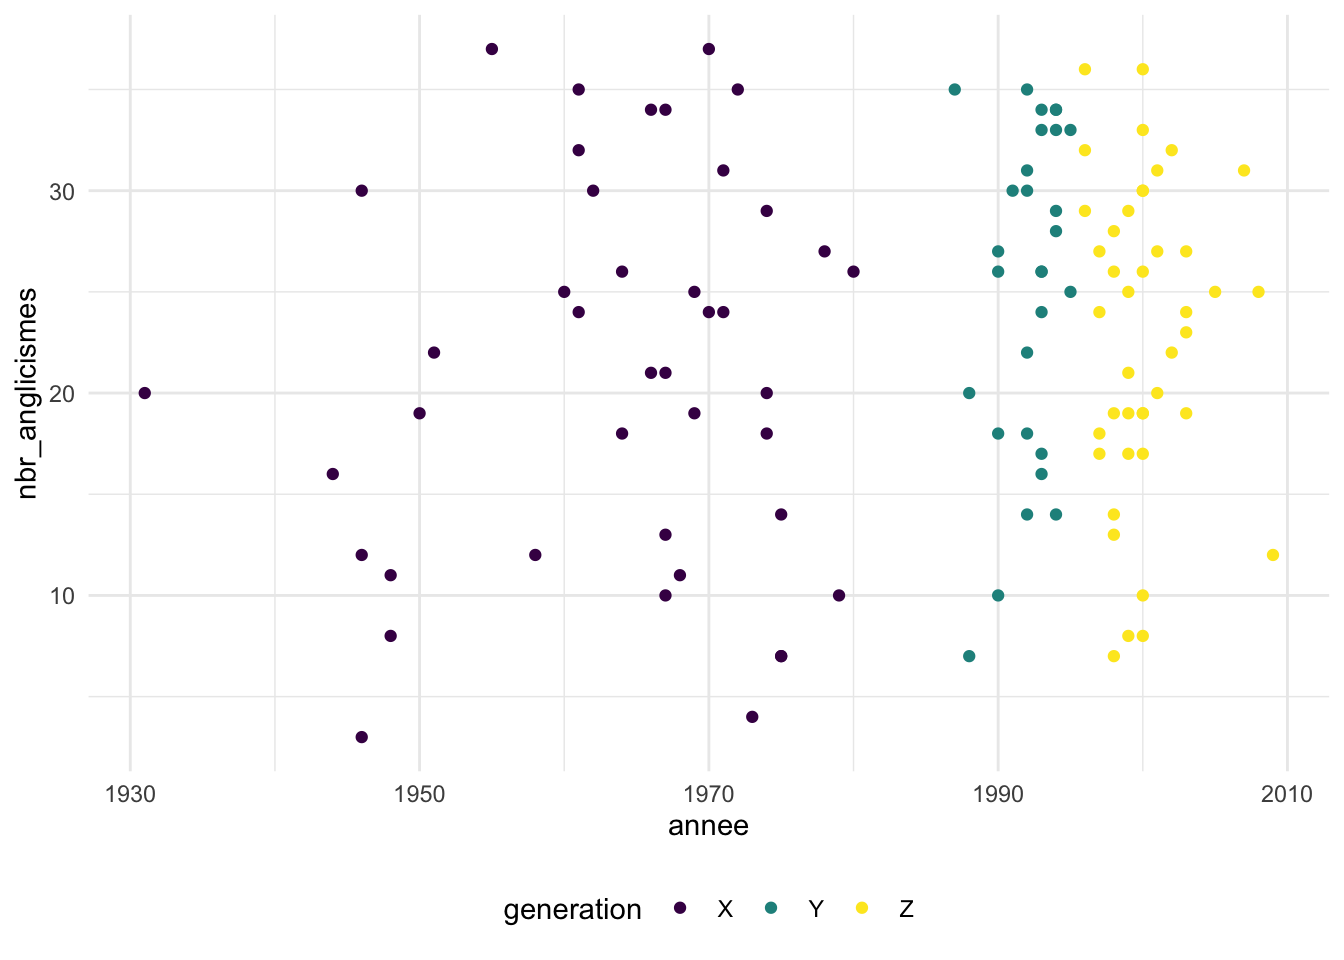
# MAPPING : La couleur dépend de la génération (dans aes)ggplot(socioling_df) +geom_point(aes(x=annee, y=nbr_anglicismes, color=generation))
# SETTING : Tous les points sont bleus (hors de aes)ggplot(socioling_df) +geom_point(aes(x=annee, y=nbr_anglicismes), color="blue")
Si vous écrivez aes(…, color=“blue”), R va créer une nouvelle variable temporaire qui s’appelle “blue” et attribuer une couleur par défaut à cette unique modalité.
3.3 Représentations uni-variées
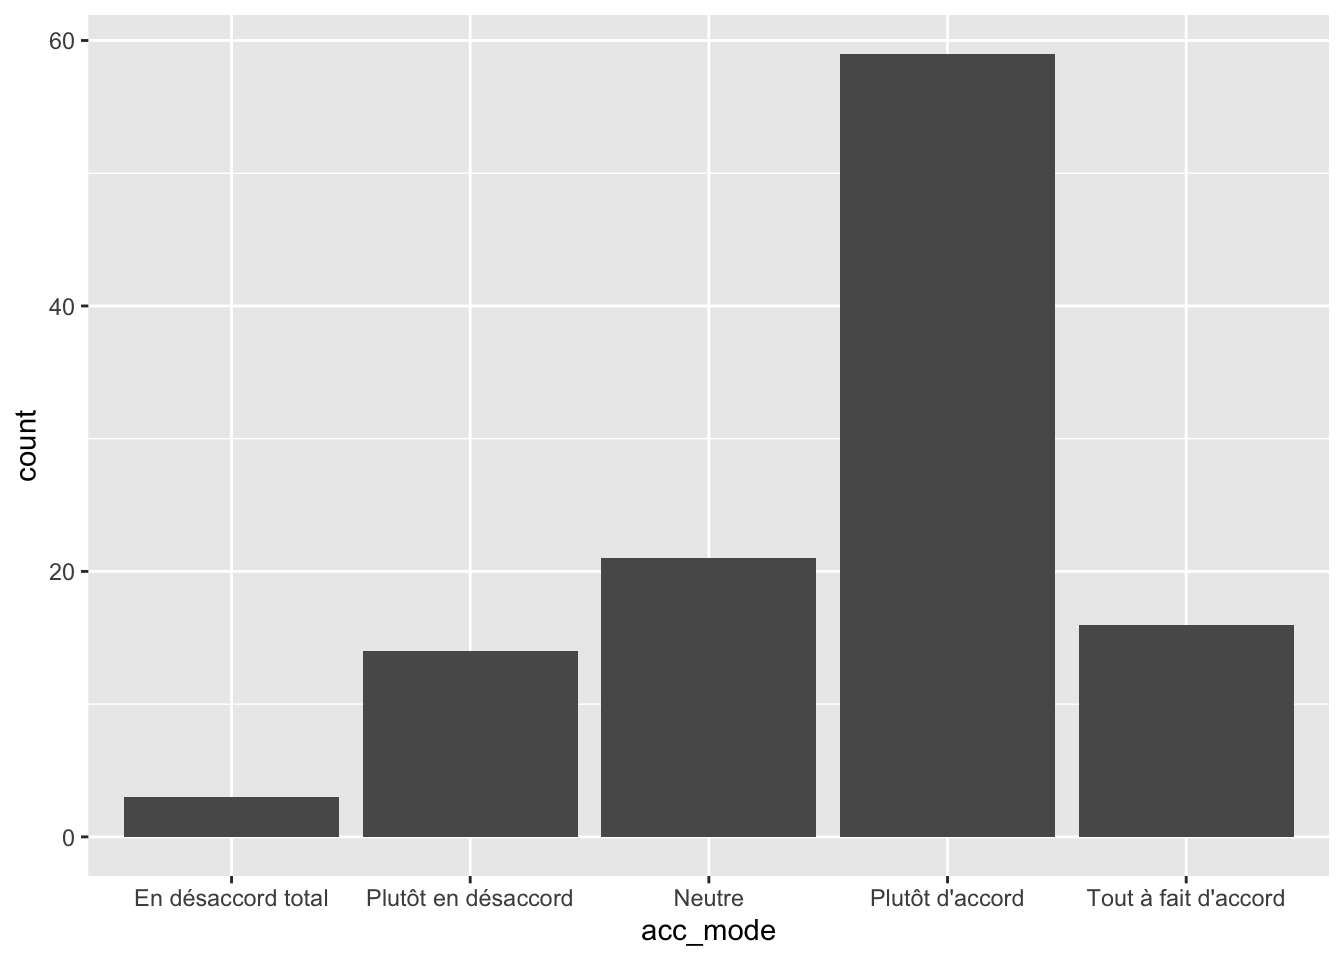
Commençons par un exemple simple. Lorsque que l’on veut illustrer une variable uni-variée catégorielle, le diagramme en barre est la représentation la plus courante. Celui-ci s’obtient avec la fonction de géométrie geom_bar() :
ggplot(socioling_df) +geom_bar(aes(x=acc_mode))
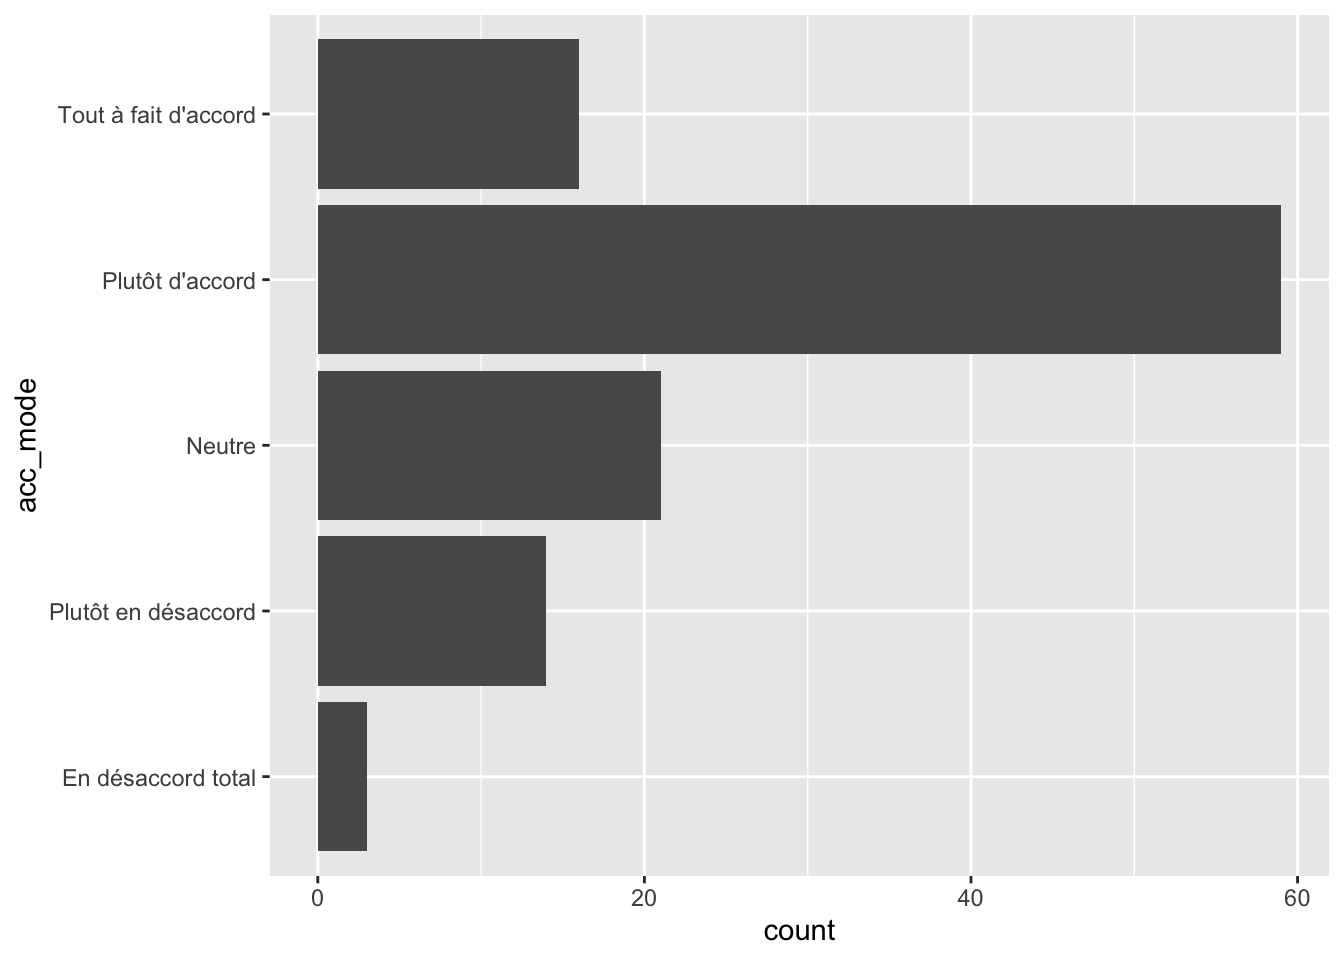
En changeant les paramètres de la fonction aes(), nous pourrions demander que l’esthétique de la géométrie soit différente :
ggplot(socioling_df) +geom_bar(aes(y=acc_mode))
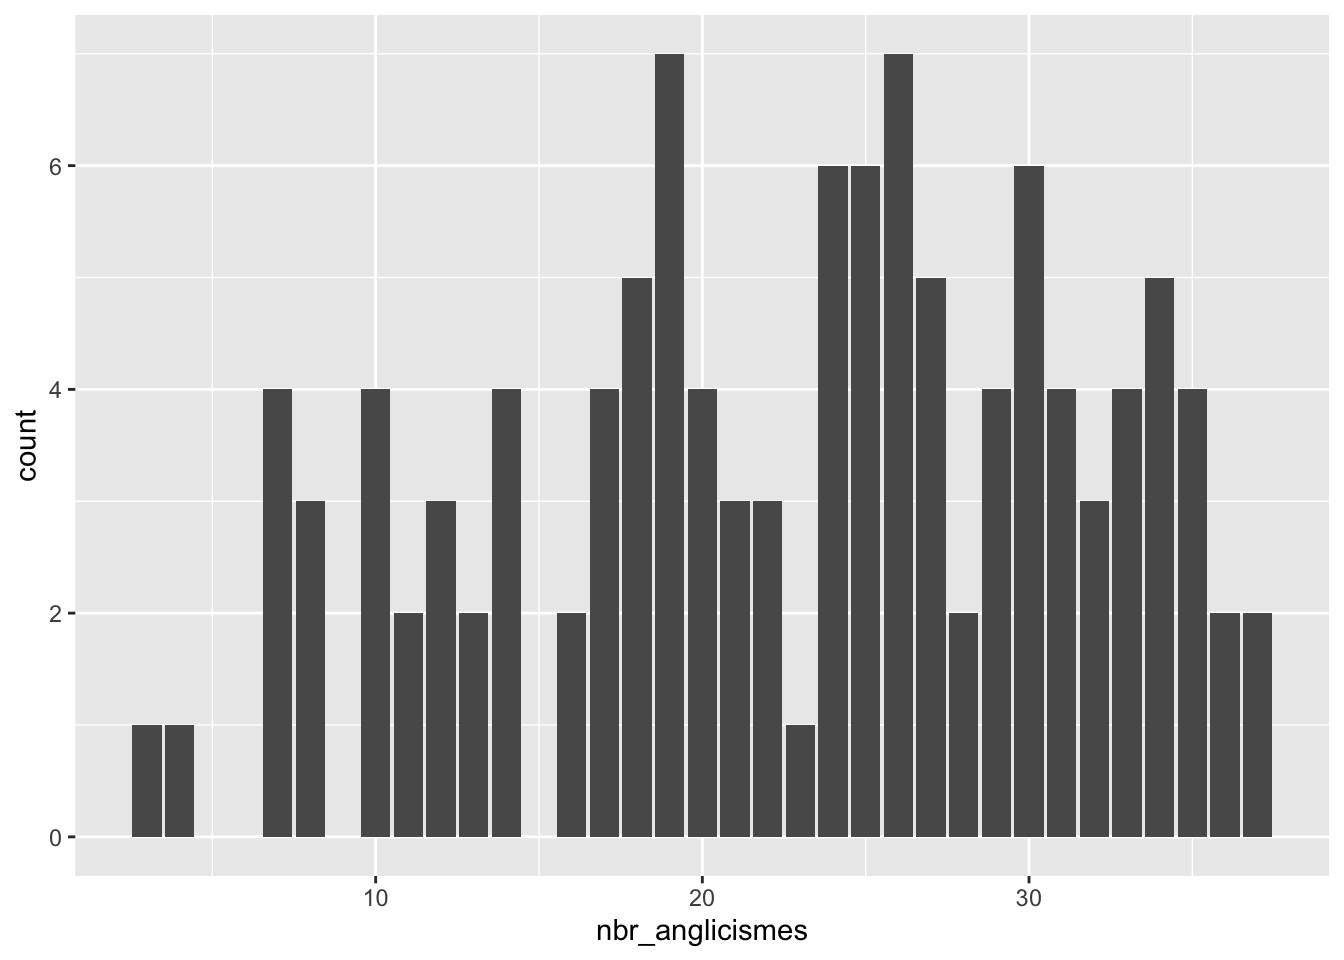
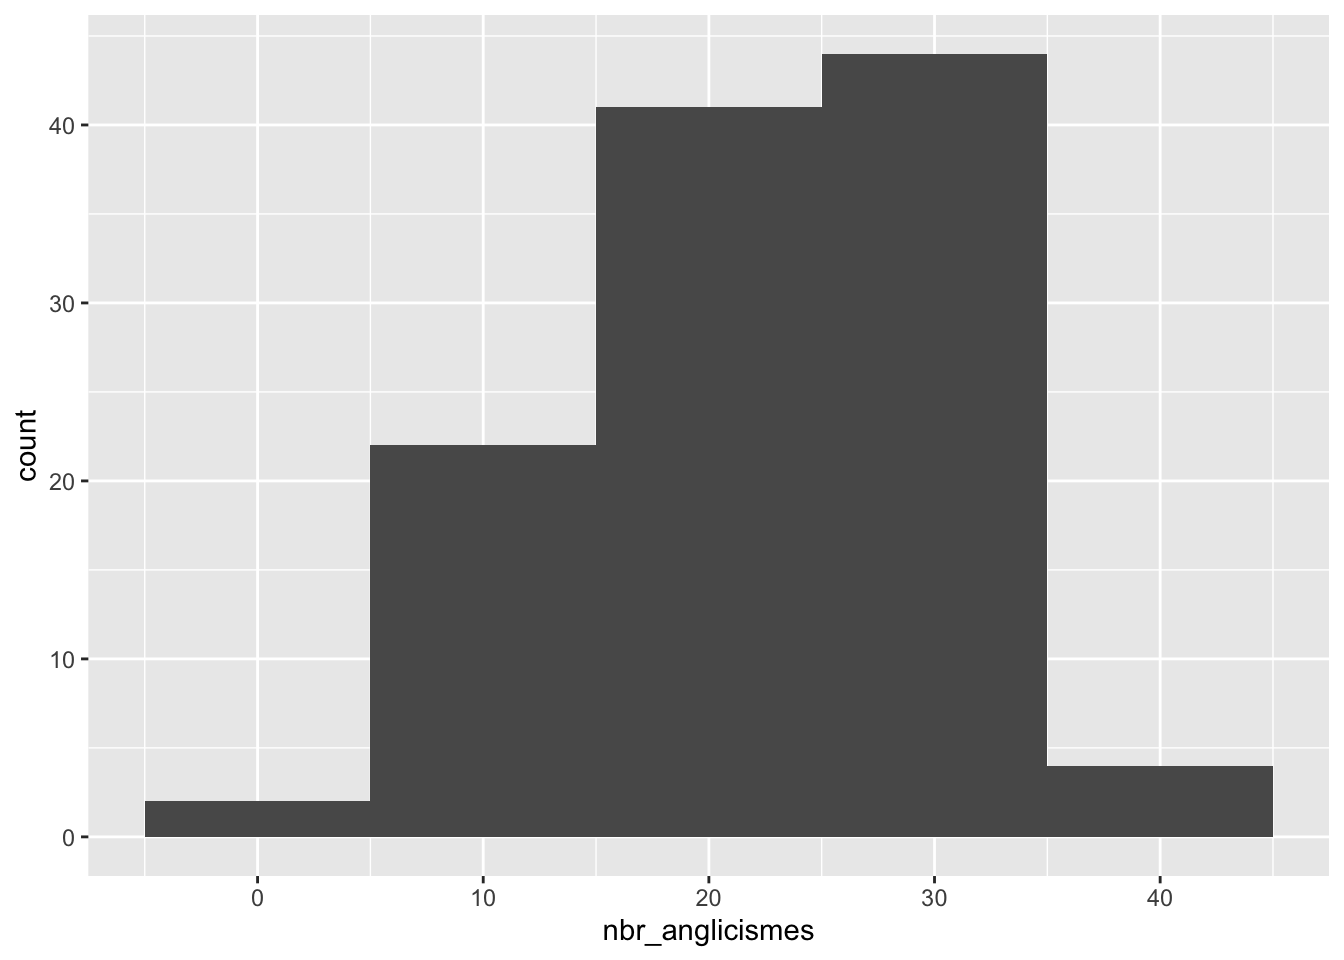
Pour une variable numérique, la géométrie geom_bar() est nettement moins pertinente :
Les représentations bi-variées se décomposent grossièrement en trois sortes, en fonction des types de variables : numérique-numérique, numérique-catégorielle, et catégorielle-catégorielle.
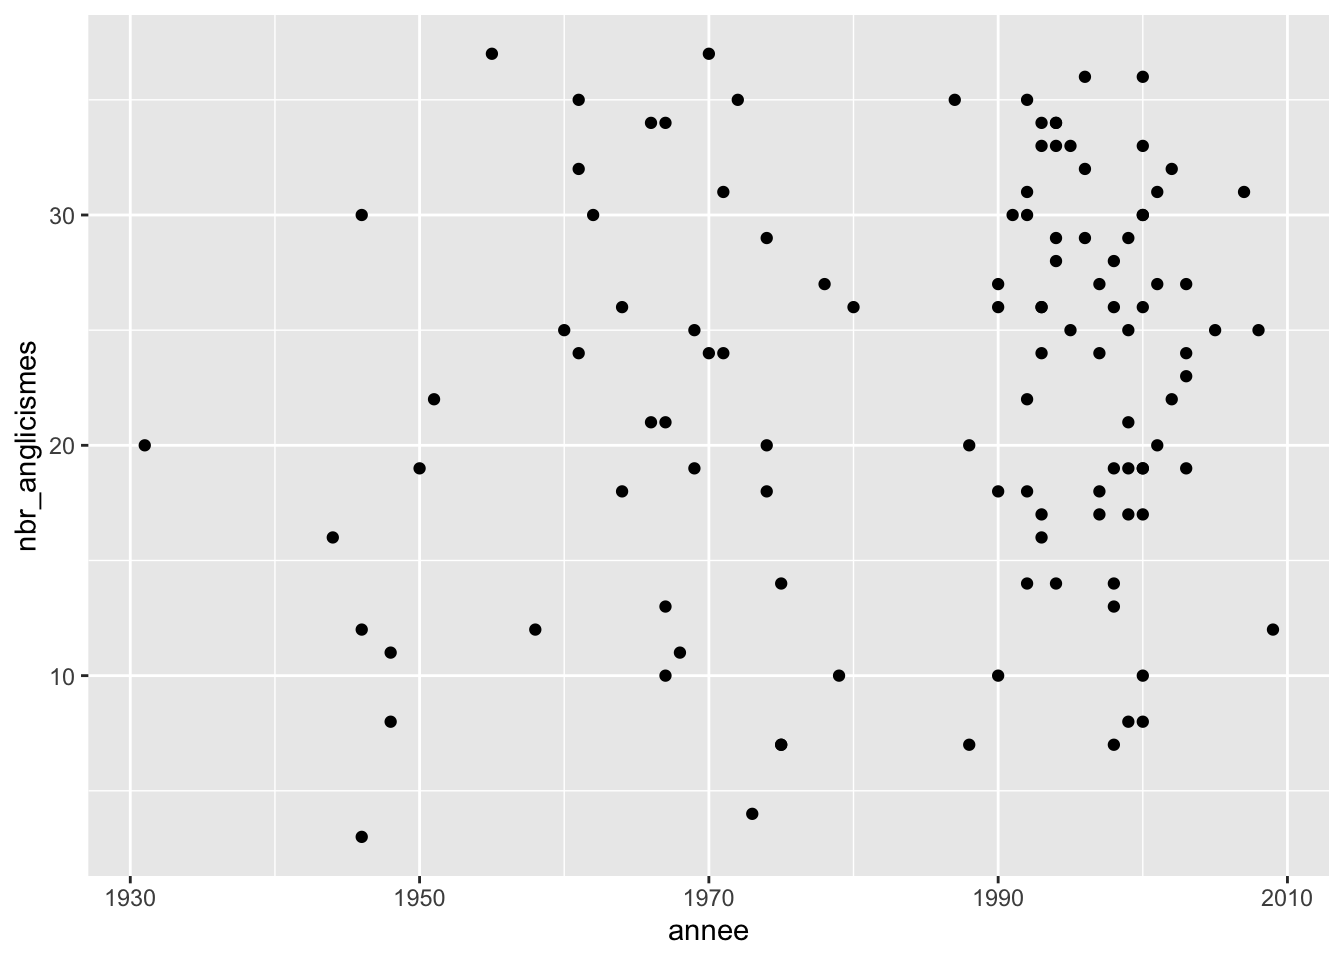
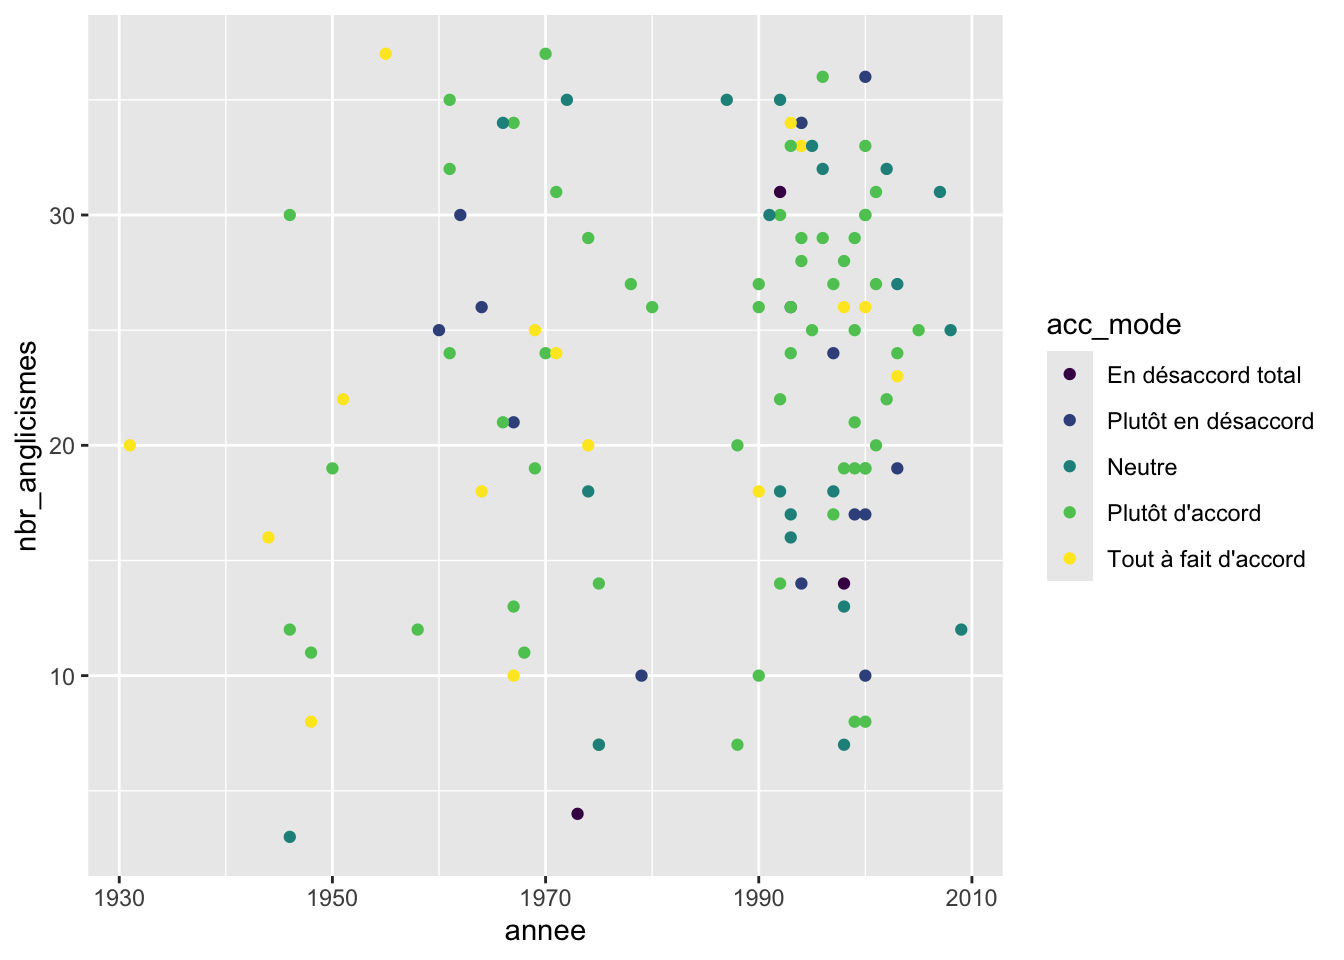
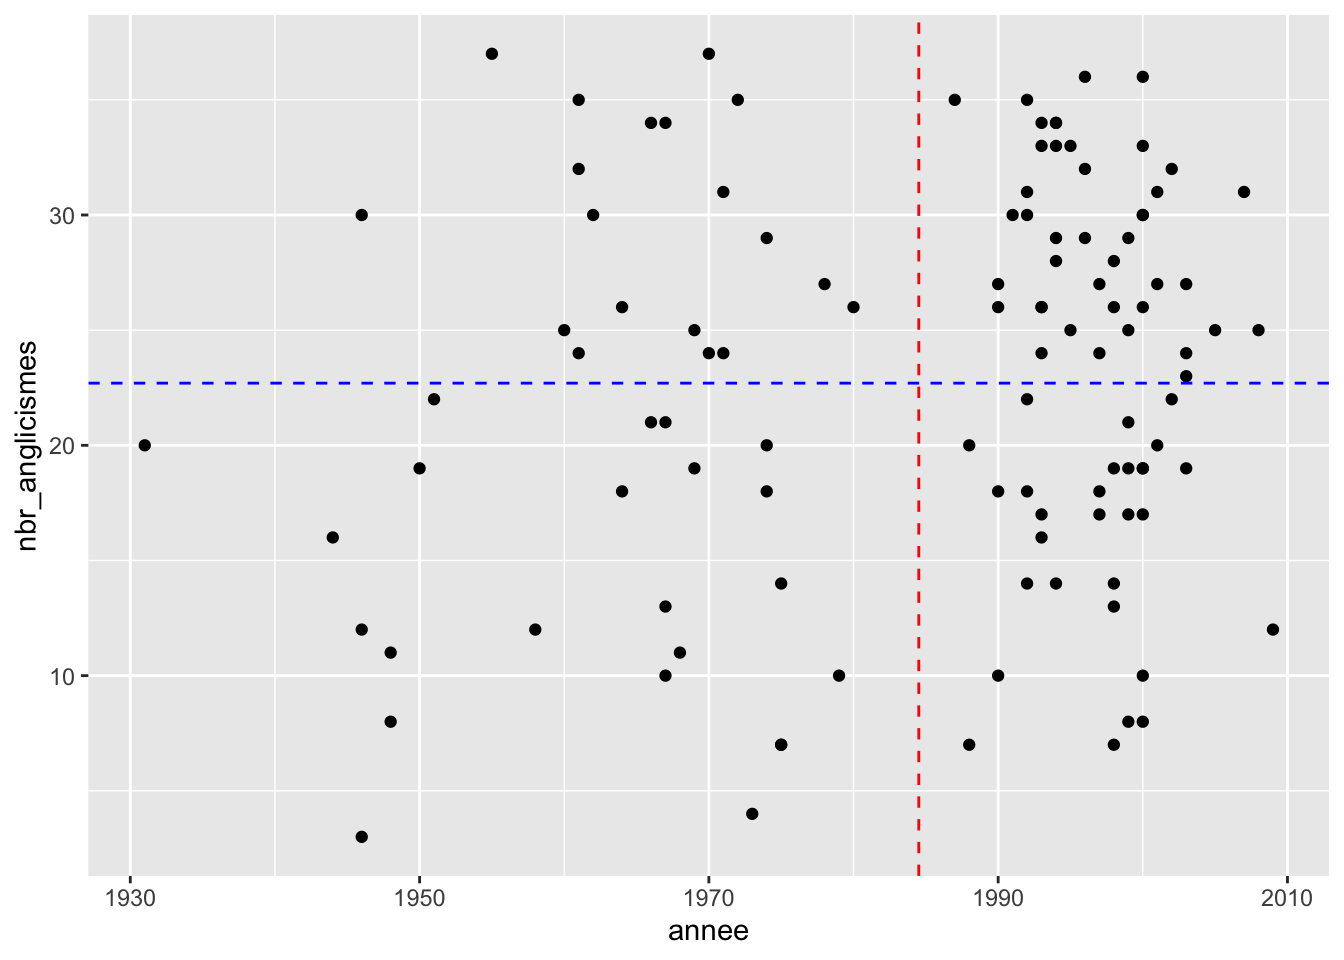
La représentation typique lorsque l’on veut représenter deux variables numériques est le nuage de points ou scatterplot. On l’obtient avec la géométrie geom_point() :
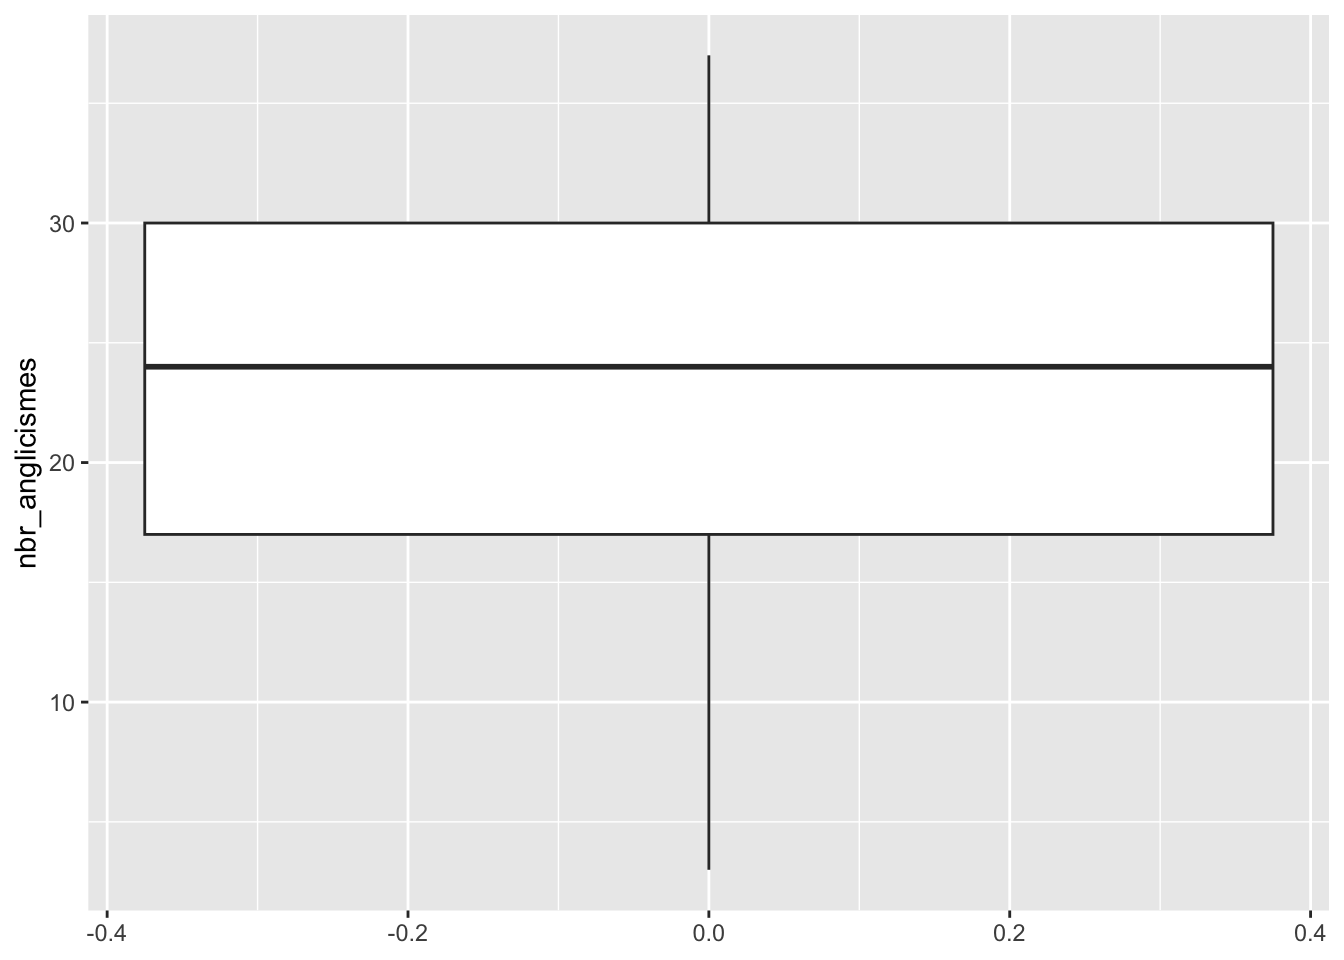
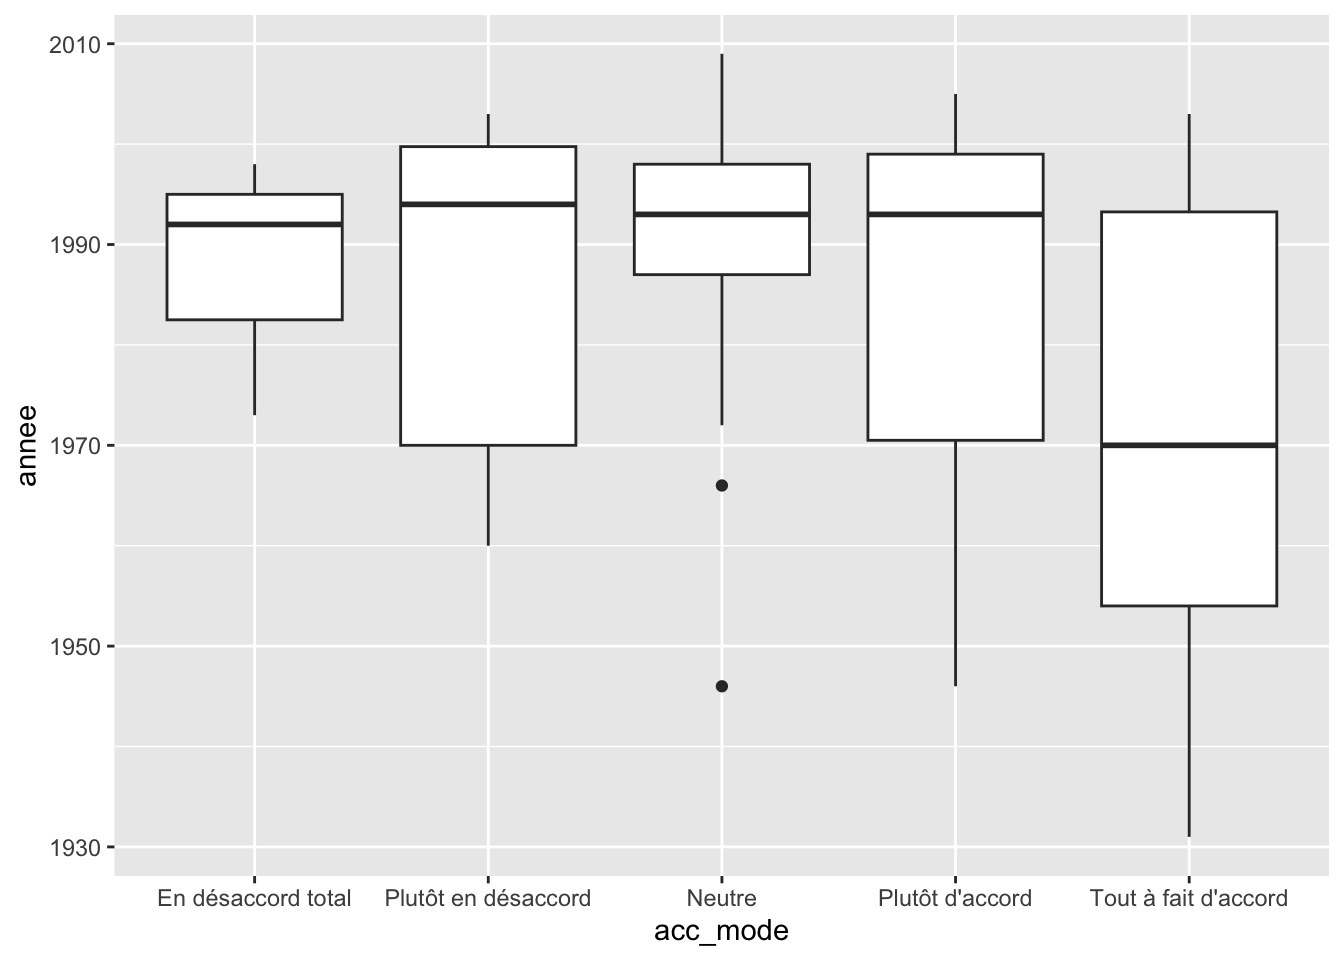
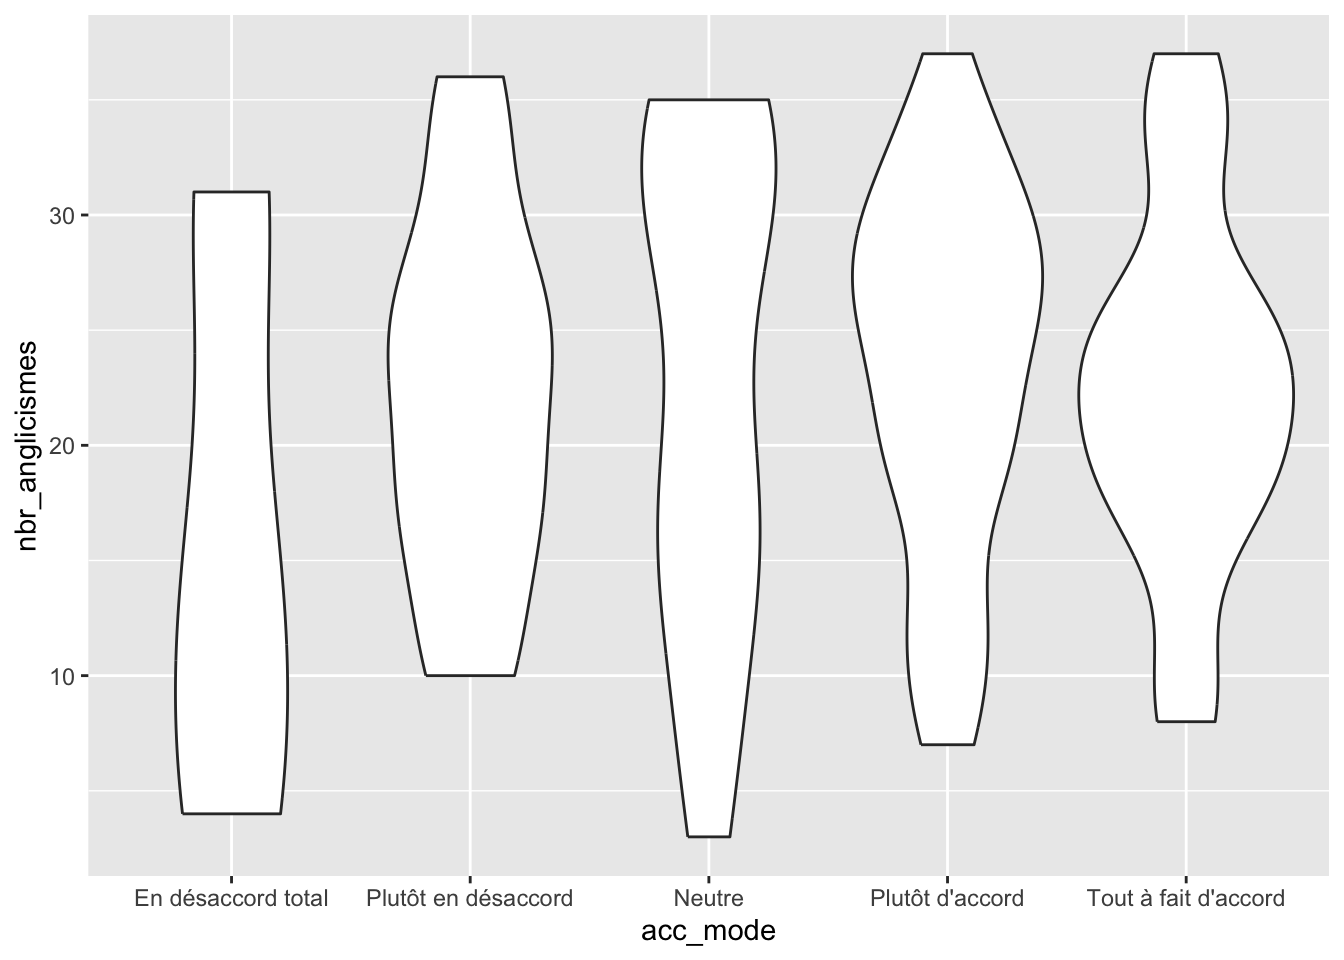
Le boxplot est très utile pour résumer une variable, mais il cache la vraie distribution sous-jacente des données. On lui préfère parfois le violin plot (diagramme en violon), qui montre la différence des distributions lorsque l’on a plusieurs catégories :
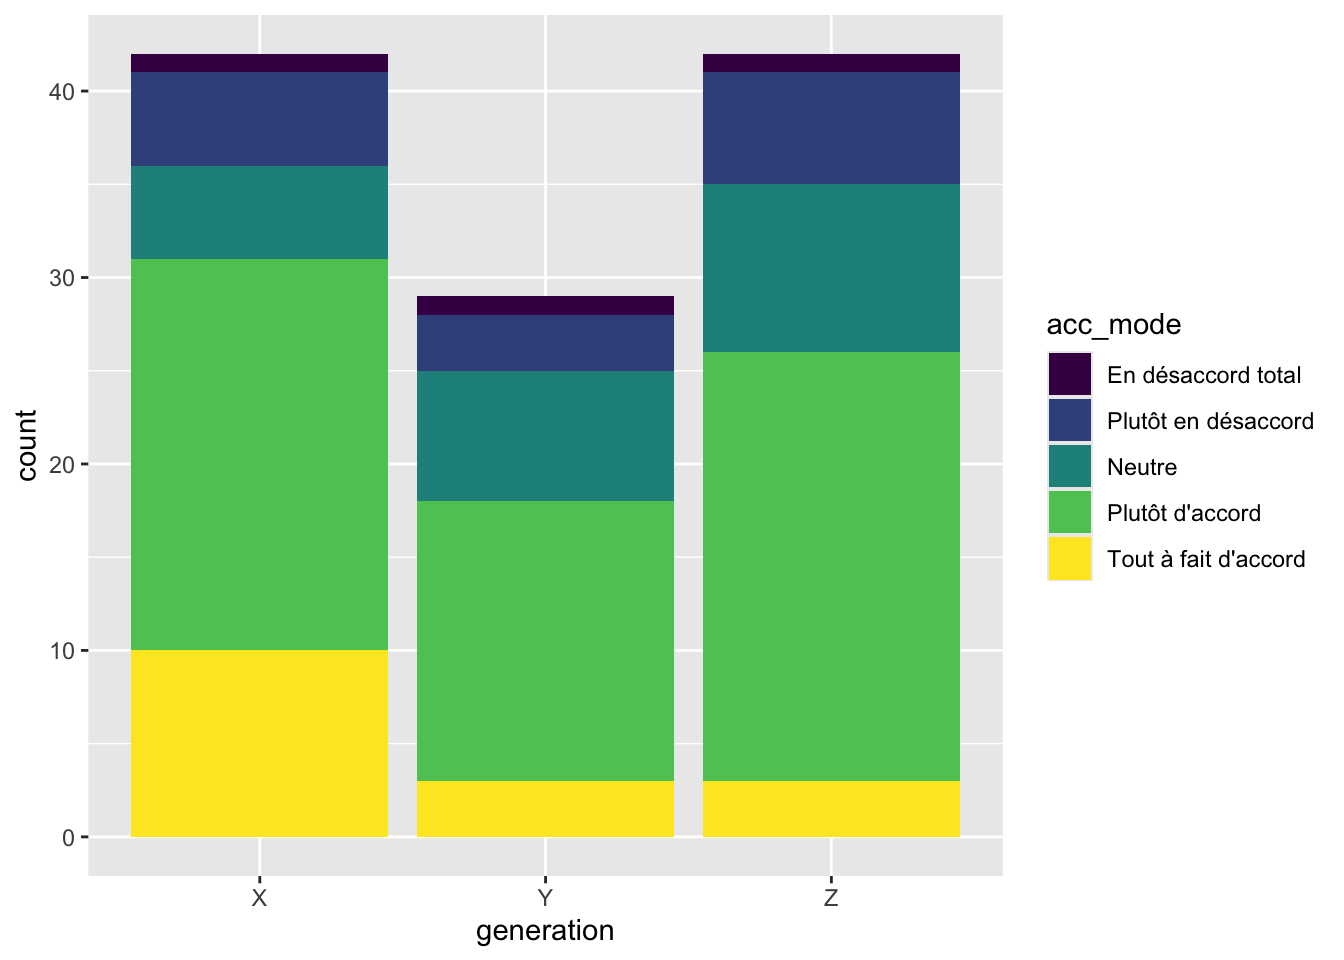
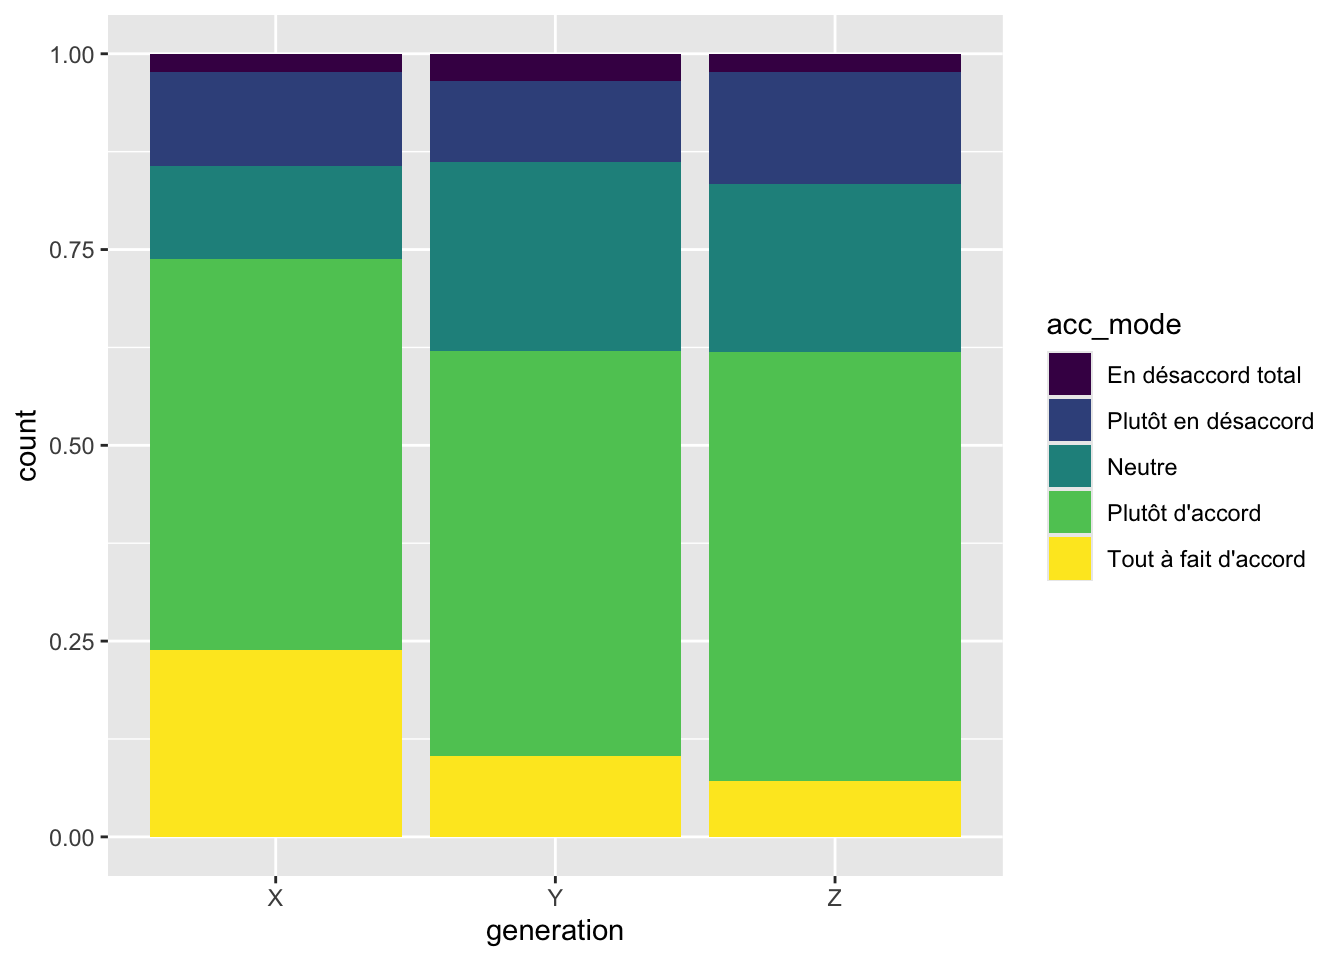
Mais ce n’est pas idéal vu les effectifs différents par génération. L’option position="fill" de geom_bar() permet de se rendre compte des proportions :
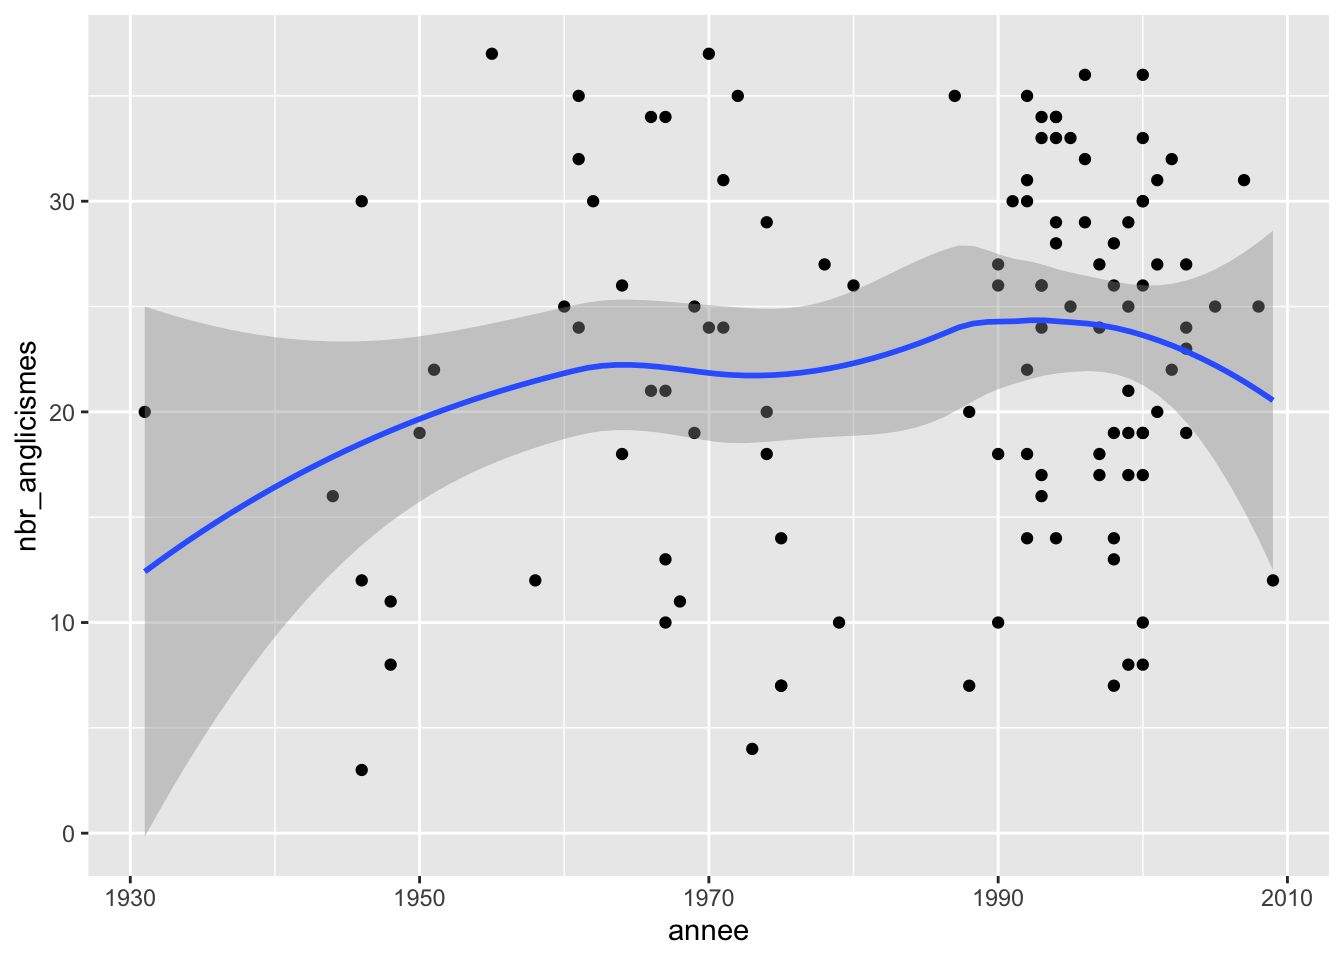
En réalité, on peut encore ajouter des lignes (toujours avec l’opérateur “+”) après notre graphique initial afin de modifier sa représentation ou ajouter des éléments. Par exemple, on peut superposer deux représentations (si elles sont dans le même système de coordonnées) :
`geom_smooth()` using method = 'loess' and formula = 'y ~ x'
Avertissement
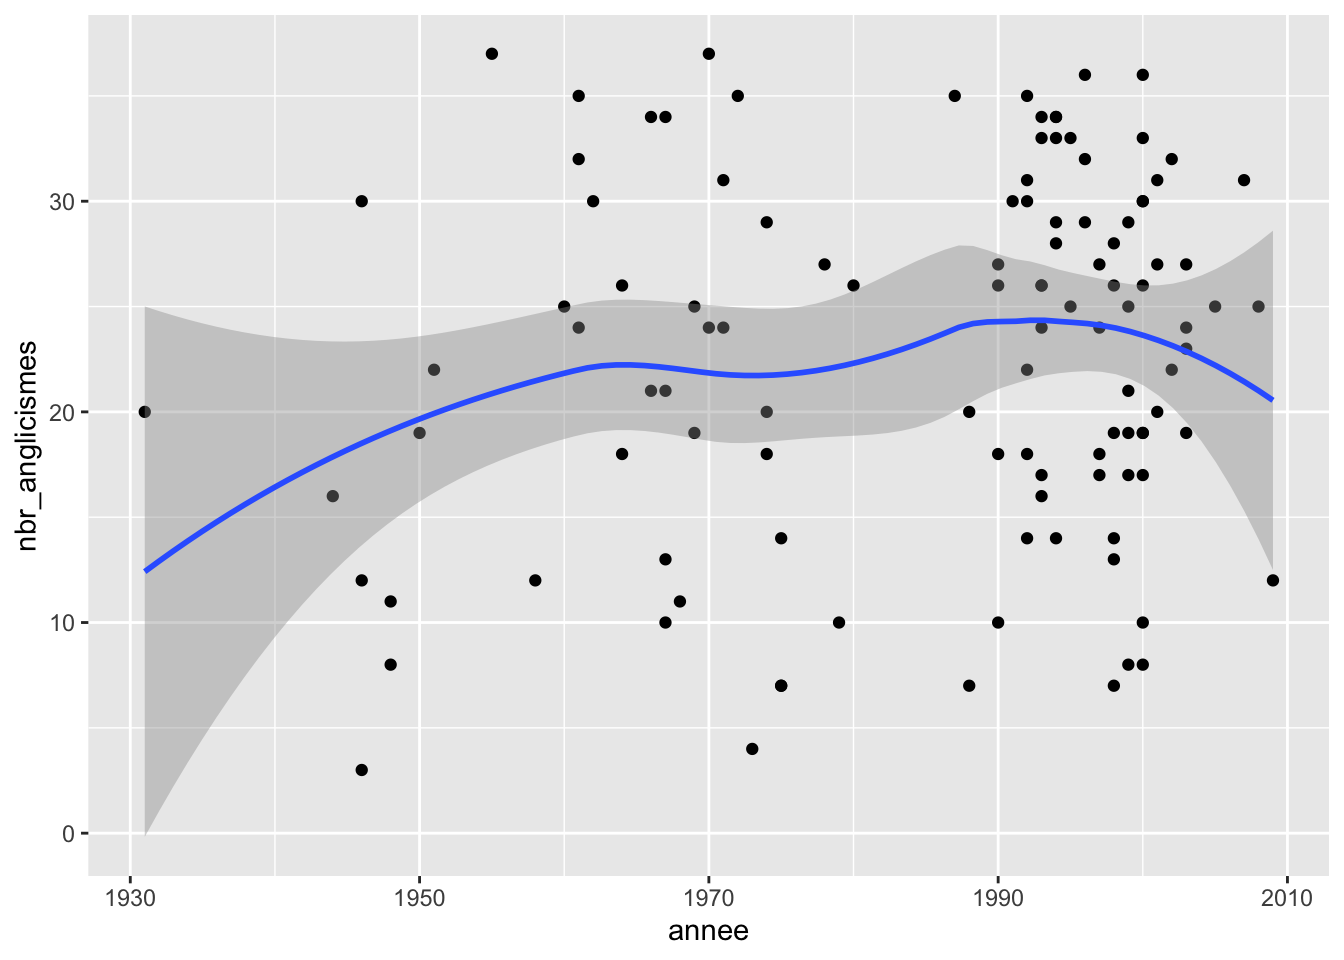
Dans notre exemple avec geom_smooth(), nous avons écrit deux fois aes(x=annee, y=nbr_anglicismes), ce qui est redondant. En fait, tout ce qui est défini dans le ggplot() initial est transmis (hérité) à toutes les couches suivantes. On peut donc simplifier le code de la manière suivante (ce qu’on appelle un “mapping global”) :
# Le mapping x et y est déclaré globalementggplot(socioling_df, aes(x=annee, y=nbr_anglicismes)) +geom_point() +geom_smooth()
`geom_smooth()` using method = 'loess' and formula = 'y ~ x'
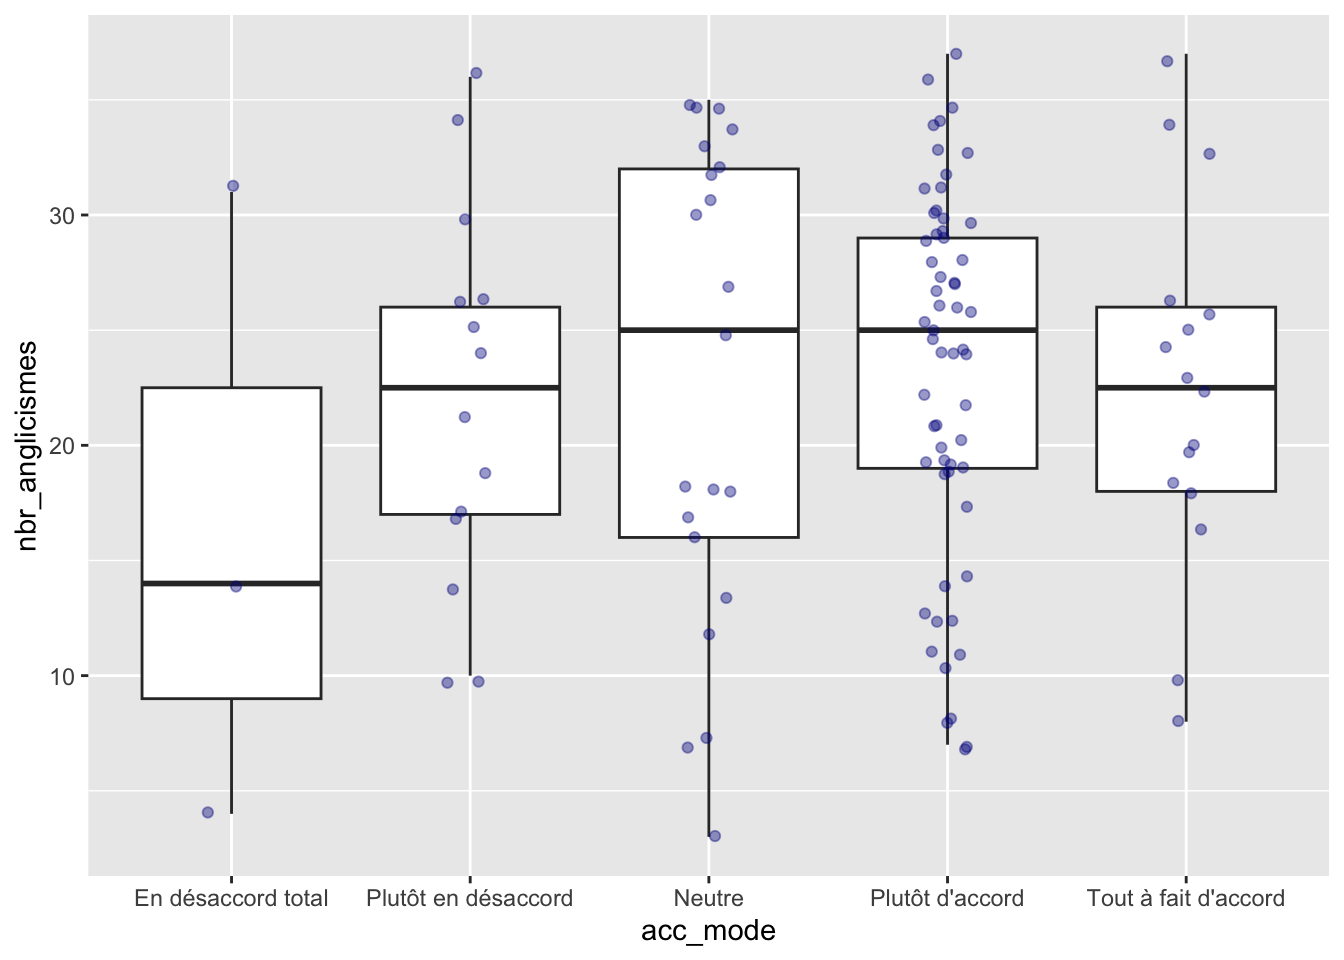
Cette superposition de graphiques nous permet d’être créatif. Par exemple, on peut superposer les vrais points de données par-dessus un boxplot. Comme les points risquent de se confondre, on utilise geom_jitter() qui ajoute un petit “bruit” aléatoire horizontal pour mieux voir la densité (outlier.shape=NA évite que le boxplot ne dessine les valeurs extrêmes une deuxième fois, puisqu’elles sont déjà dessinées par geom_jitter, et alpha gère la transparence) :
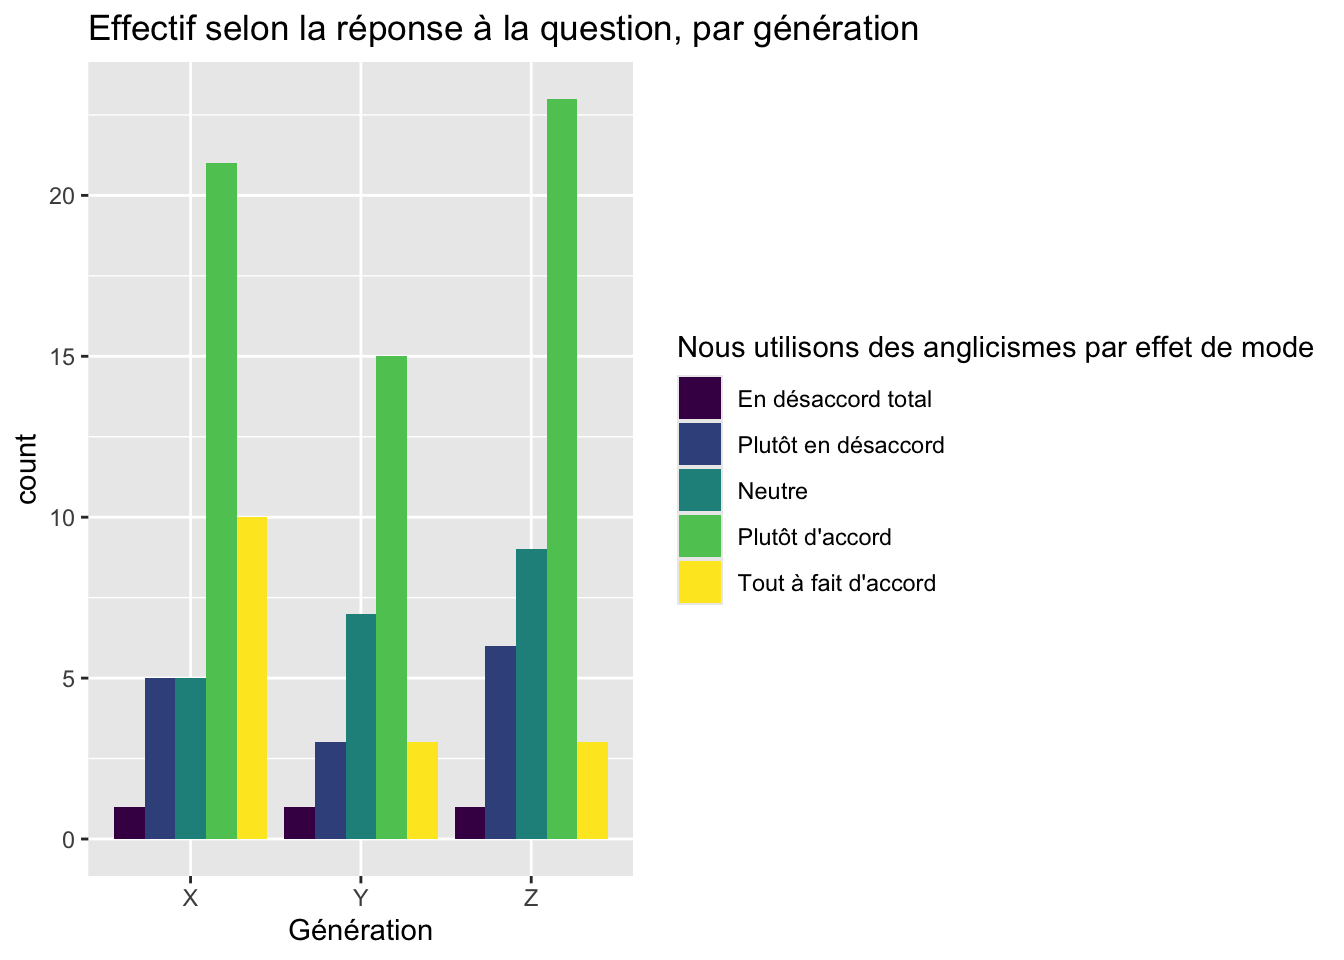
Pour changer les noms des axes, de la légende et du titre, on utilise la fonction labs() :
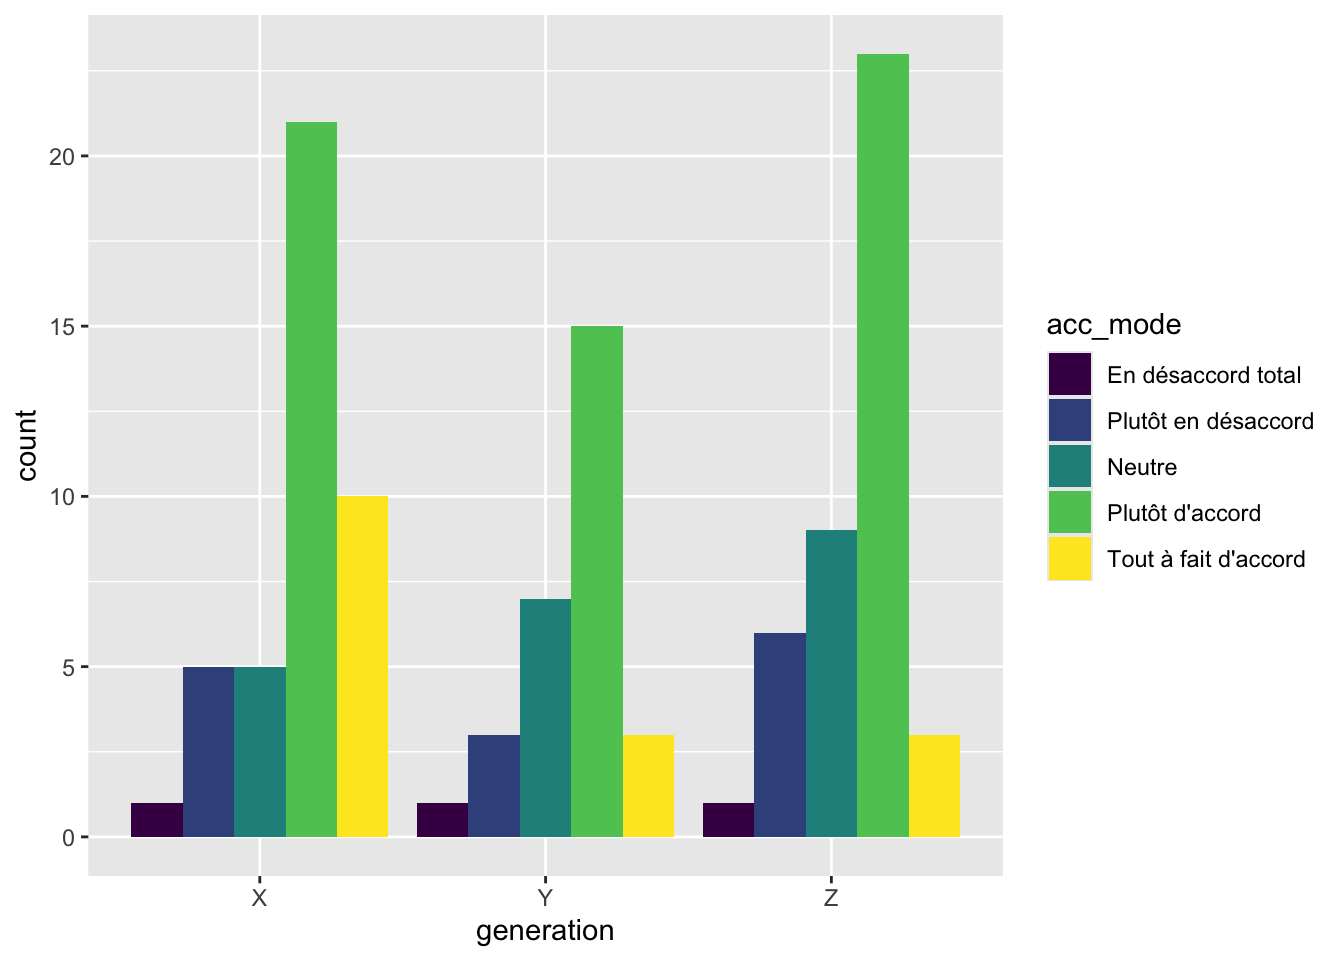
ggplot(socioling_df) +geom_bar(aes(x=generation, fill=acc_mode), position="dodge") +labs(title="Effectif selon la réponse à la question, par génération",x="Génération",fill="Nous utilisons des anglicismes par effet de mode")
5 Personnalisation avancée : facettes, thèmes, couleurs et coordonnées
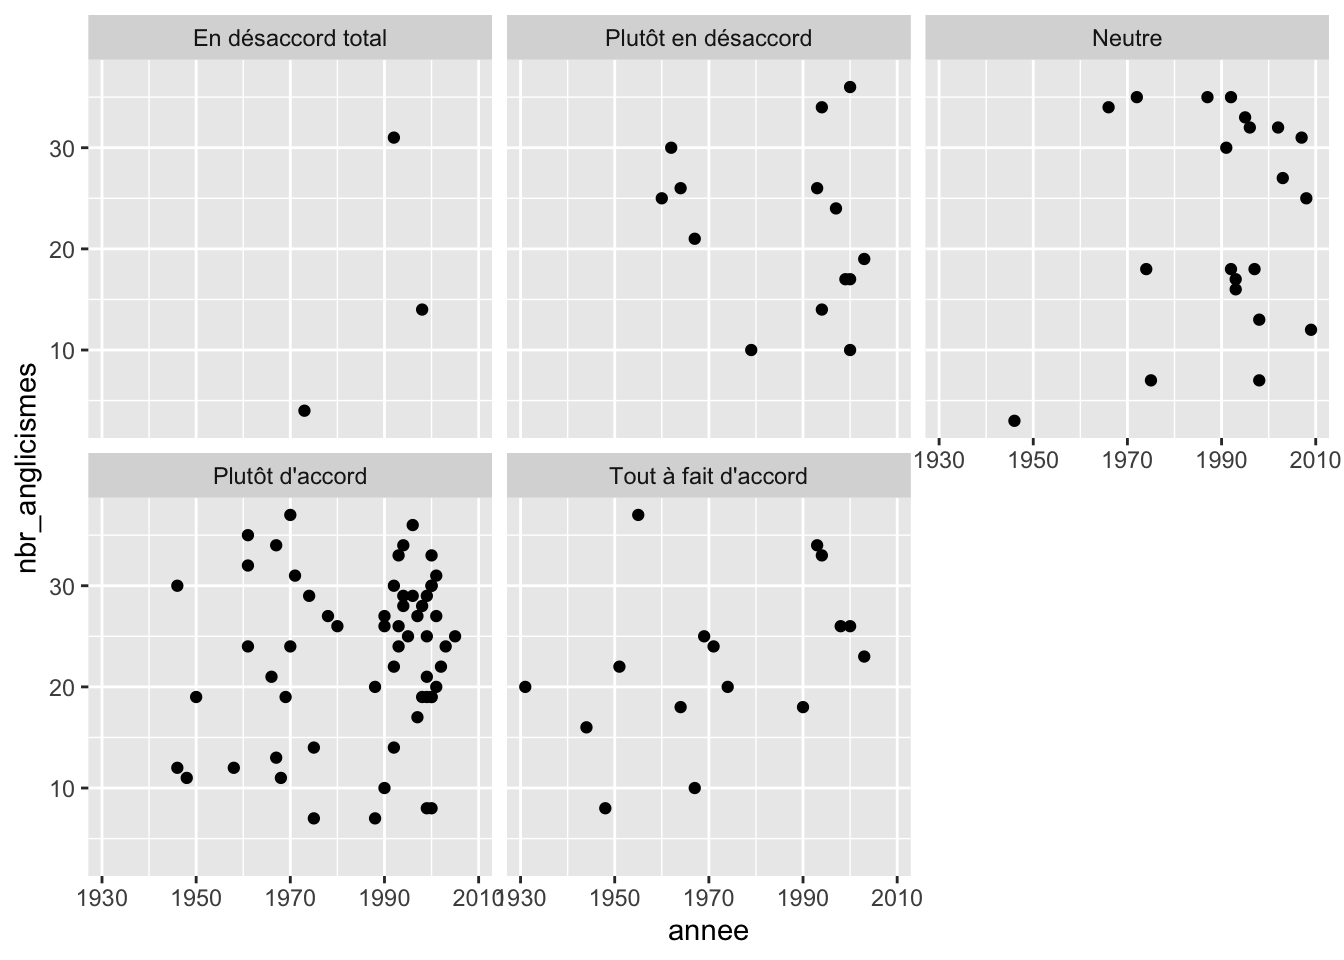
Les fonctions de facettes permettent de décomposer notre graphique en plusieurs représentation selon une ou plusieurs variables catégorielles. Par exemple :
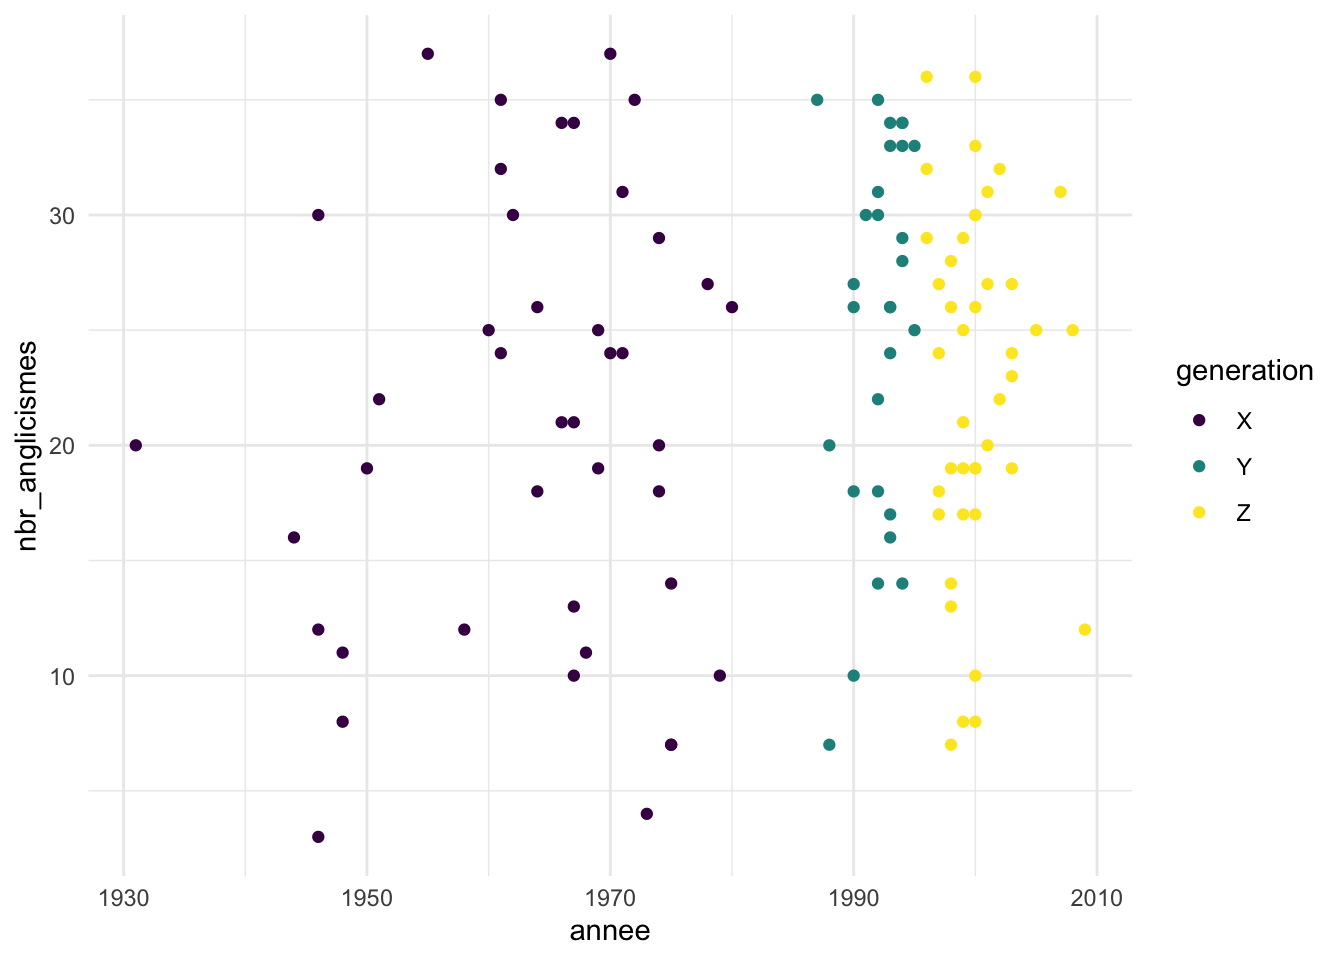
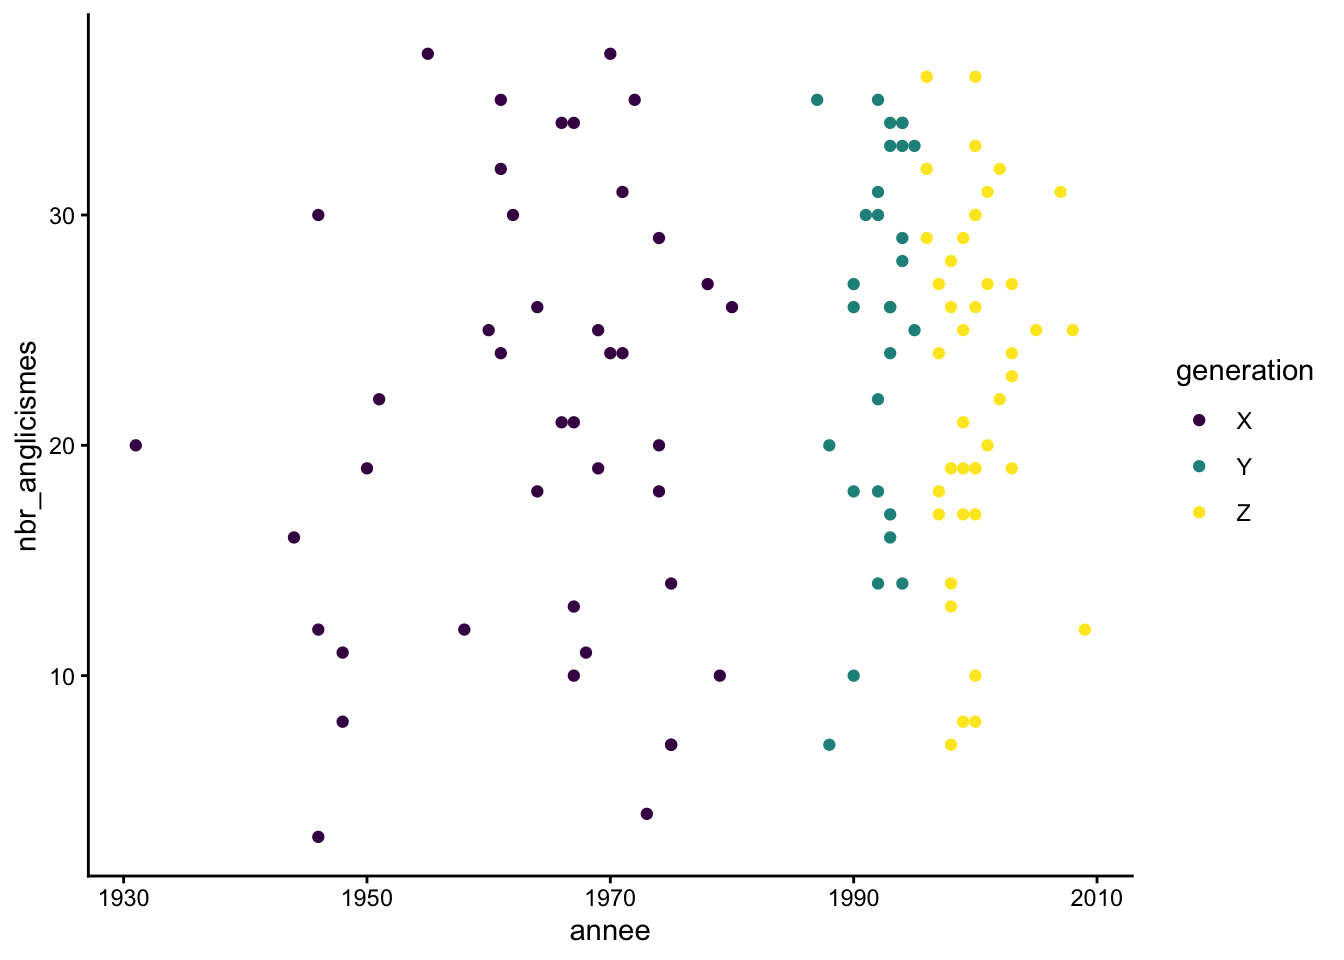
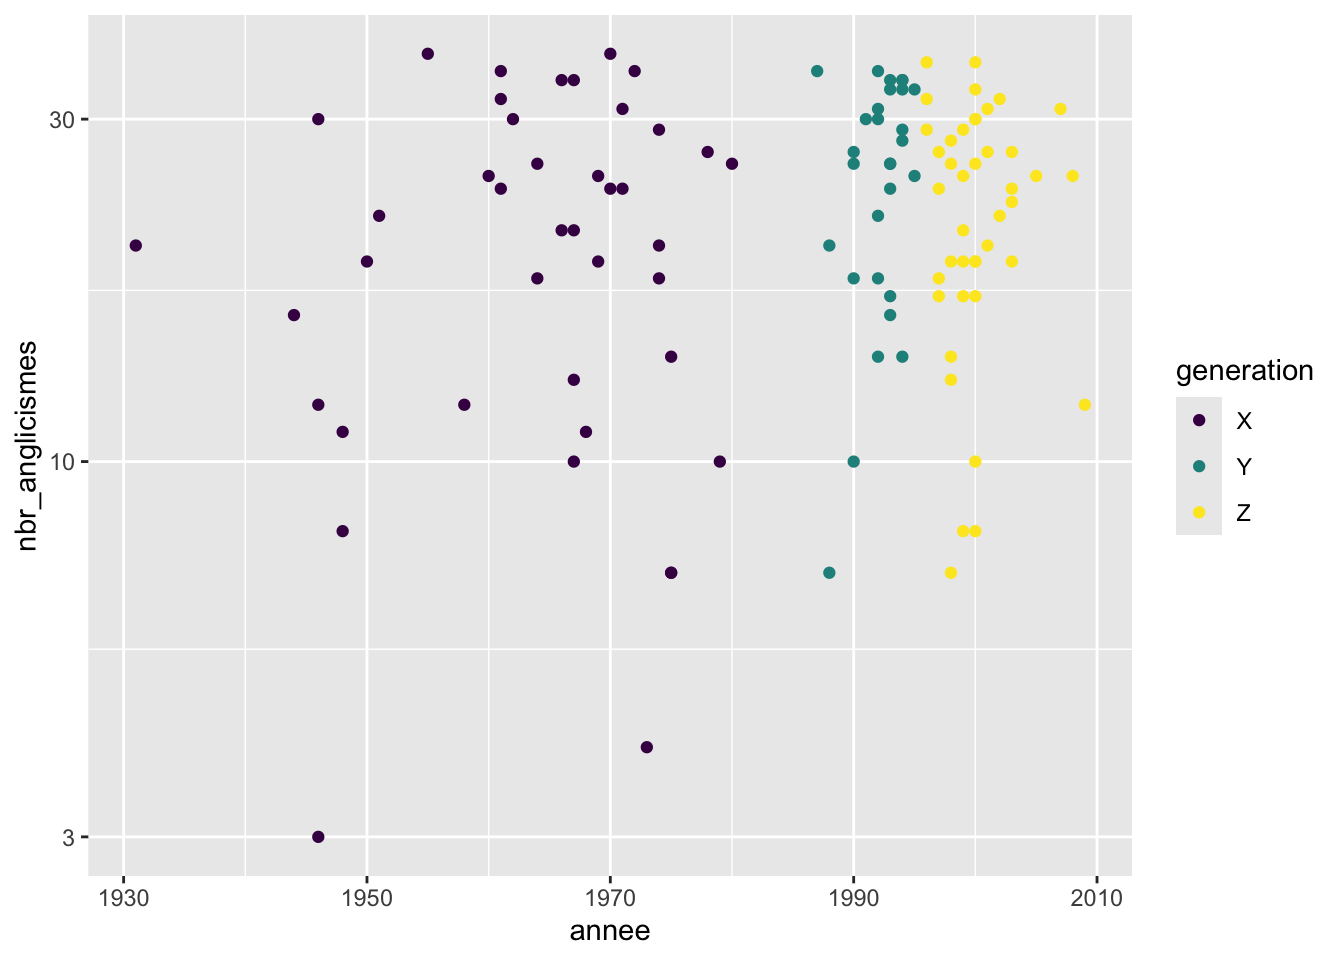
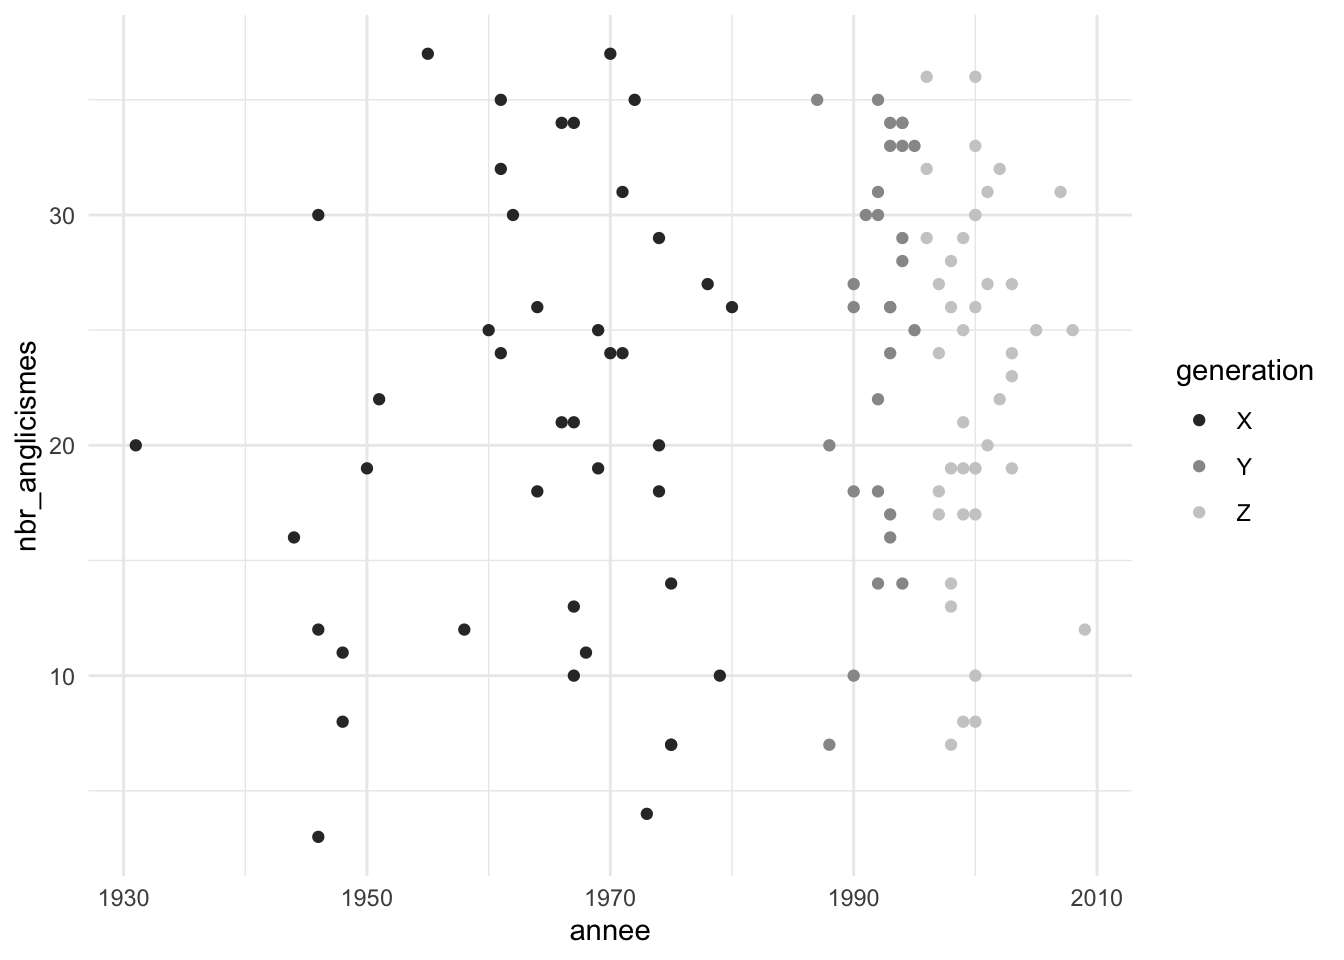
Il est également possible de changer l’apparence générale de notre graphique, c’est à dire les éléments graphiques qui ne sont pas liés aux données (couleurs, axes, fond, etc.) grâce aux thèmes. Par défaut, ggplot2 utilise un thème assez “chargé”, mais il en existe plusieurs autres. C’est aussi l’occasion de voir que les graphiques peuvent être sauvegardés dans des variables, pour être affichés ou affinés par la suite.
Prenons le graphique de base suivant, que nous sauvons dans my_plot :
La fonction theme() permet une personnalisation avancée avec de nombreux paramètres (attention, il faut toujours la placer après un thème prédéfini). On pourrait passer longtemps dessus, mais en guise d’exemple, on voit ici comment personnaliser notre légende avec cette dernière :
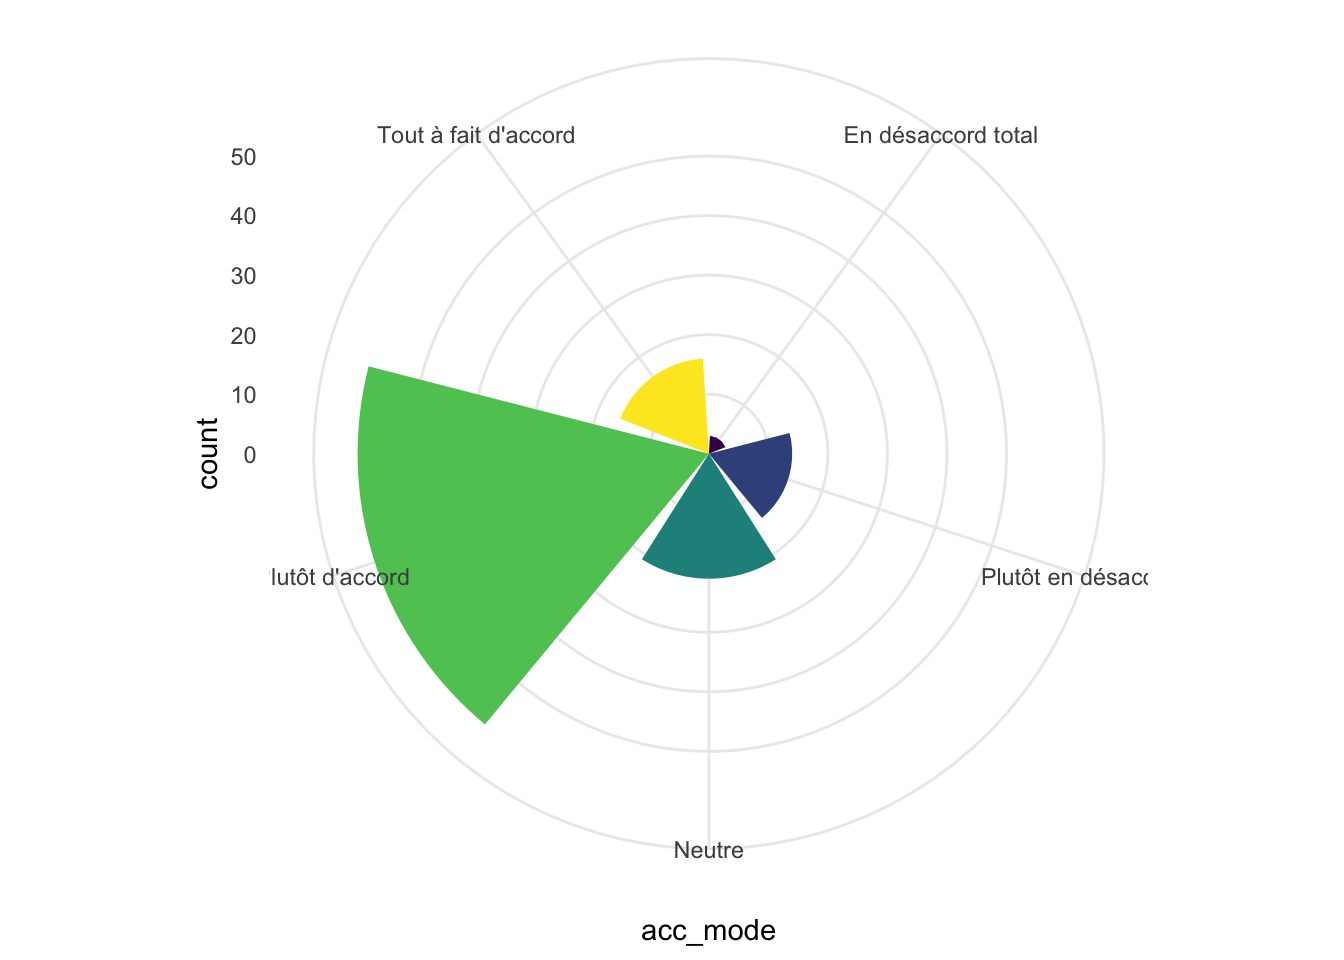
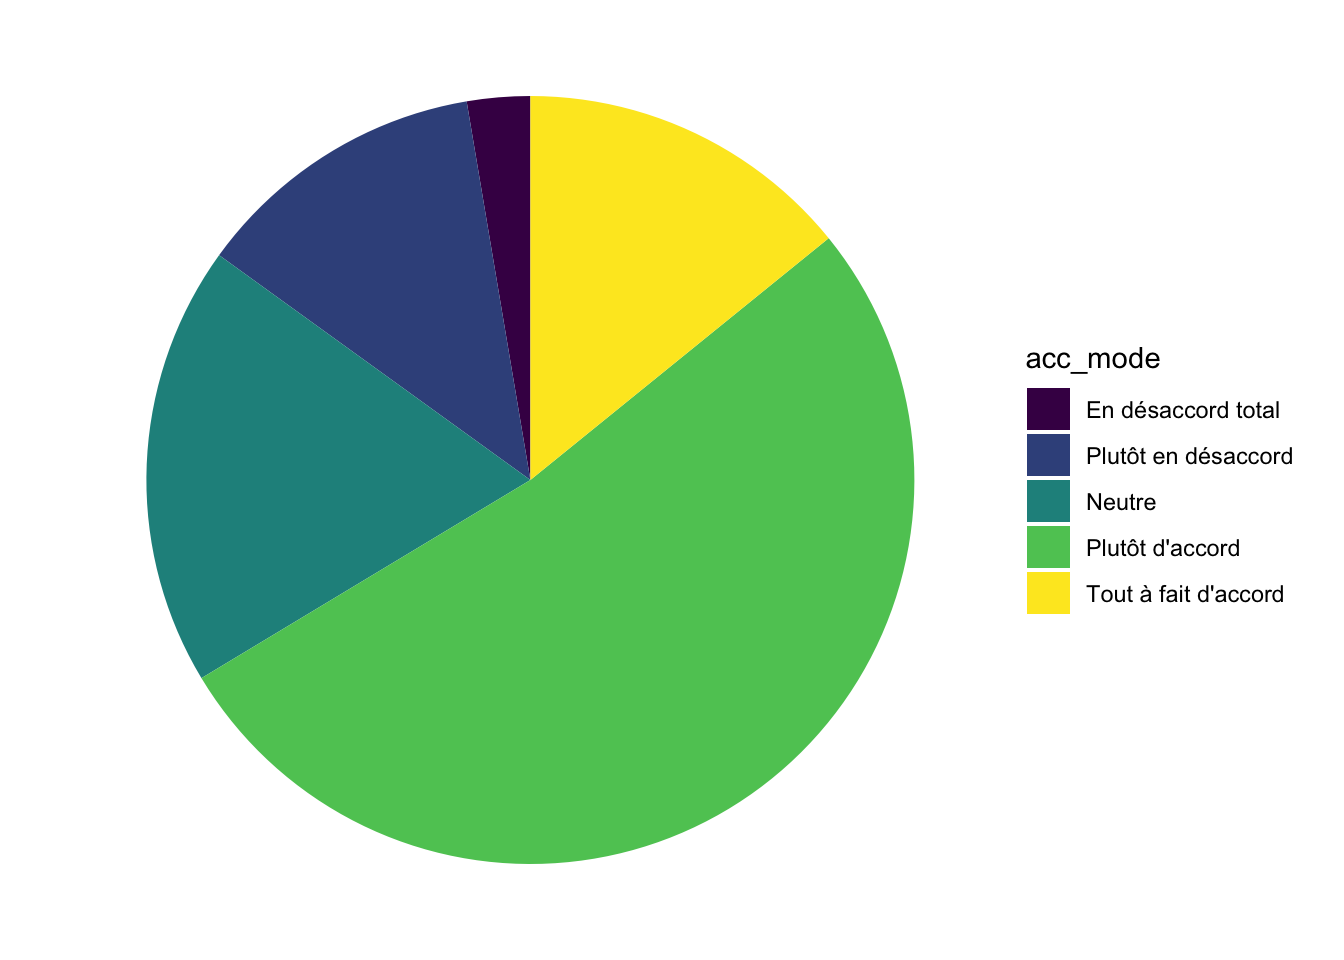
On peut d’ailleurs l’utiliser pour faire un diagramme en camembert (pie chart). Le paramètre theta spécifie l’angle de la coordonnée polaire (ici “y”, c’est-à-dire la hauteur du barplot, pour faire un camembert classique) :
Cette personnalisation avancée permet d’affiner l’esthétique de nos graphiques et de les rendre plus lisibles et adaptés à leur contexte d’utilisation (publication, présentation, etc.).
6 Que faire avec un graphique en R ?
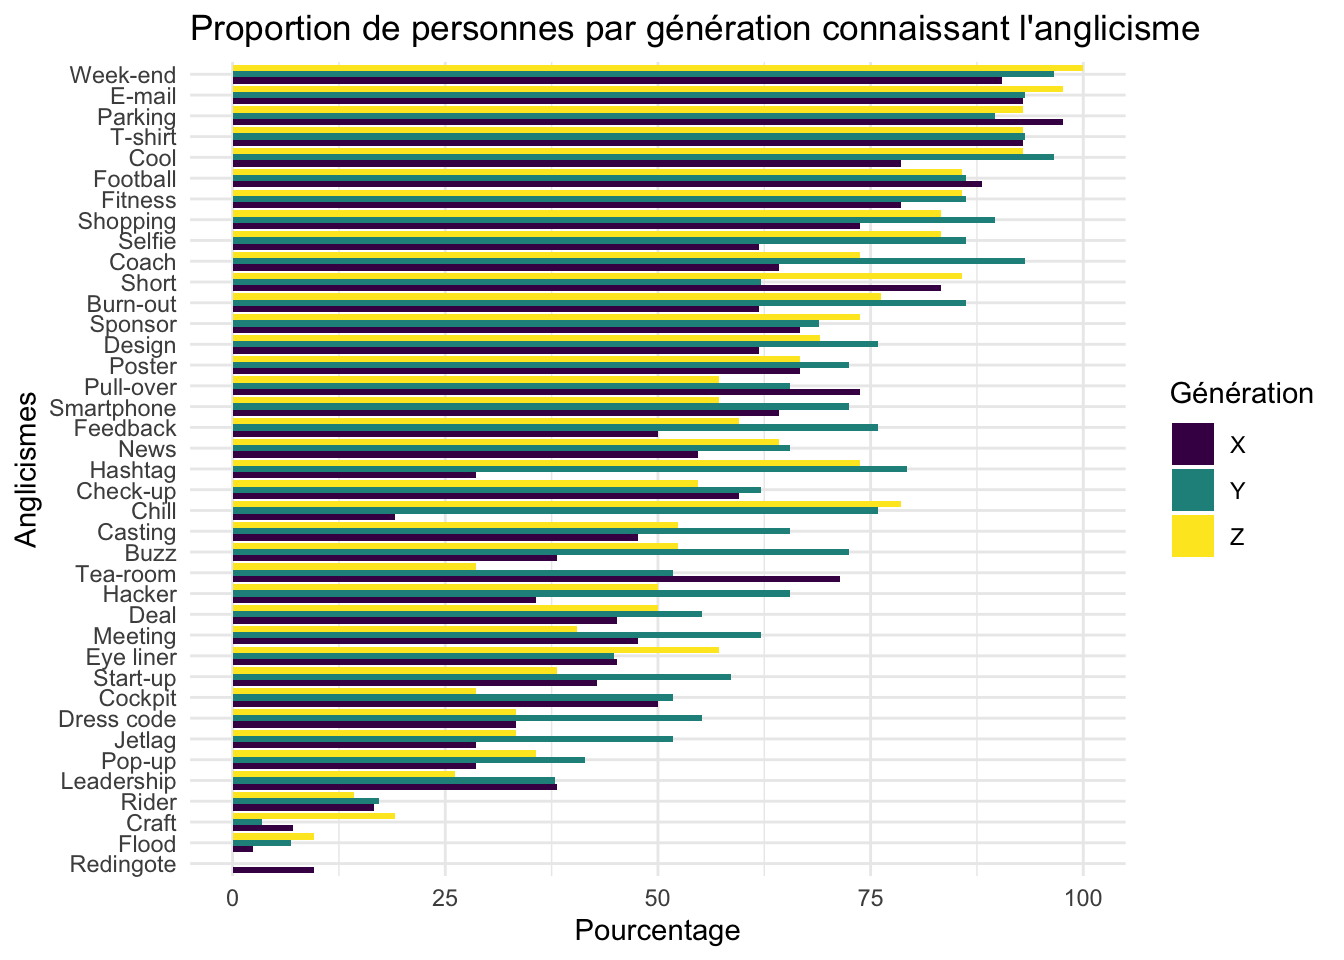
Avant de montrer ce qu’il possible de faire avec un graphique créé dans R, nous allons faire un dernier exemple pour illustrer comment, dans le tidyverse, la manipulation de données s’articule bien avec la création de graphiques. Voici une seule opération qui permet d’afficher un barplot de la proportion de personnes, par génération, connaissant chaque anglicisme :
socioling_df %>%pivot_longer(Hashtag:Craft, names_to="anglicisme", values_to="connu") %>%group_by(anglicisme, generation) %>%summarise(prop_connu=sum(connu)/n()*100) %>%mutate(gen_sum=sum(prop_connu)) %>%ggplot() +geom_bar(aes(x=prop_connu, y=reorder(anglicisme, gen_sum), fill=generation), stat="identity", position="dodge") +labs(title="Proportion de personnes par génération connaissant l'anglicisme",x="Pourcentage",y="Anglicismes",fill="Génération") +theme_minimal()
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by anglicisme and generation.
ℹ Output is grouped by anglicisme.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(anglicisme, generation))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
On peut ensuite sauvegarder directement les graphiques en png ou en pdf avec l’interface de RStudio. Mais il est aussi possible de sauvegarder le dernier graphique produit avec une commande (et personnaliser ainsi le document sortant) :
Il existe aussi la librairie plotly qui permet d’afficher des graphiques interactifs :
library(plotly)
Warning: le package 'plotly' a été compilé avec la version R 4.6.1
Attachement du package : 'plotly'
L'objet suivant est masqué depuis 'package:ggplot2':

    last_plot
L'objet suivant est masqué depuis 'package:stats':

    filter
L'objet suivant est masqué depuis 'package:graphics':

    layout
On doit d’abord sauvegarder notre graphique dans une variable, puis l’entrer dans la fonction ggplotly() :
g =ggplot(socioling_df) +geom_point(aes(x=annee, y=nbr_anglicismes, color=acc_mode))ggplotly(g)
Il existe également une librairie R très puissante nommée shiny (https://shiny.rstudio.com/) qui permet de transformer un script R en une application web. Elle est fréquemment utilisée pour créer des dashboards (en français : tableaux de bord) permettant de présenter des données sous différentes formes de manière interactive.