III. Le Tidyverse II et les statistiques uni- et bi-variées
Auteur·rice
Guillaume Guex
1 Préparation du jeu de données
Pour ce TP nous allons avoir besoin des librairies suivantes :
library(tidyverse)
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
library(readxl)library(janitor)
Attachement du package : 'janitor'

Les objets suivants sont masqués depuis 'package:stats':

    chisq.test, fisher.test
library(DescTools)
1.1 Chargement et aperçu des données
Dans ce TP, nous allons utiliser le jeu de données data/pragmatique.xlsx, qui porte sur une sélection de marqueurs de doute, prononcés dans différents contextes. Une description de ce jeu de données se trouve dans le fichier data/pragmatique_info.docx.
# A tibble: 321 × 20
   `ID marqueur` Evénement Année Genre         `Timing début` `Timing fin` Lemme
           <dbl> <chr>     <dbl> <chr>                  <dbl>        <dbl> <chr>
 1         20001 DPU_UDC    2007 Débat public          804366       804552 SEMB…
 2         20002 DPU_REC    2007 Débat public         1352035      1352284 PARA…
 3         20003 DPU_UDC    2007 Débat public         1888187      1888333 PARA…
 4         20004 DTV_SM1    2007 Débat télévi…         340280       341094 PARA…
 5         20005 DTV_SM2    2013 Débat télévi…         880398       880572 PARA…
 6         20006 REU_BL1    2017 Réunion prof…        2729947      2730002 PARA…
 7         20007 DPU_MED    2008 Débat public         2878433      2878820 AVOI…
 8         20008 DTV_DEM    2007 Débat télévi…        3199465      3199624 AVOI…
 9         20009 DTV_VEH    2007 Débat télévi…         463064       463380 AVOI…
10         20010 DPU_BIE    2009 Débat public         2384187      2385363 AVOI…
# ℹ 311 more rows
# ℹ 13 more variables: `POS-TAG` <chr>, `Type morpho-syntaxique` <chr>,
#   `Position du marqueur dans l'UCT` <chr>,
#   `Position de l'UCT dans le TDP` <chr>,
#   `Rôle de l'UCT dans la séquence` <chr>, `Regard avant le marqueur` <chr>,
#   `Regard pendant le marqueur` <chr>, `Regard après le marqueur` <chr>,
#   `Présence d'un geste?` <chr>, `Type de geste` <chr>, Direction <chr>, …
Le jeu semble relativement propre, on peut voir un résumé rapide de ses variables avec :
pragmatique_df %>%str()
tibble [321 × 20] (S3: tbl_df/tbl/data.frame)
 $ ID marqueur                    : num [1:321] 20001 20002 20003 20004 20005 ...
 $ Evénement                      : chr [1:321] "DPU_UDC" "DPU_REC" "DPU_UDC" "DTV_SM1" ...
 $ Année                          : num [1:321] 2007 2007 2007 2007 2013 ...
 $ Genre                          : chr [1:321] "Débat public" "Débat public" "Débat public" "Débat télévisé" ...
 $ Timing début                   : num [1:321] 804366 1352035 1888187 340280 880398 ...
 $ Timing fin                     : num [1:321] 804552 1352284 1888333 341094 880572 ...
 $ Lemme                          : chr [1:321] "SEMBLER" "PARAÎTRE" "PARAÎTRE" "PARAÎTRE" ...
 $ POS-TAG                        : chr [1:321] "verbe" "verbe" "verbe" "verbe" ...
 $ Type morpho-syntaxique         : chr [1:321] "construction attributive à verbe copule" "construction attributive à verbe copule" "construction attributive à verbe copule" "construction attributive à verbe copule" ...
 $ Position du marqueur dans l'UCT: chr [1:321] "milieu" "début*" "milieu" "début*" ...
 $ Position de l'UCT dans le TDP  : chr [1:321] "milieu" "milieu" "milieu" "milieu" ...
 $ Rôle de l'UCT dans la séquence : chr [1:321] "indéterminé" "indéterminé" "indéterminé" "indéterminé" ...
 $ Regard avant le marqueur       : chr [1:321] "allocutaire(s)" "allocutaire(s)" "allocutaire(s)" "autre" ...
 $ Regard pendant le marqueur     : chr [1:321] "allocutaire(s)" "autre" "allocutaire(s)" "indéterminable" ...
 $ Regard après le marqueur       : chr [1:321] "allocutaire(s)" "autre" "allocutaire(s)" "autre" ...
 $ Présence d'un geste?           : chr [1:321] "non" "oui" "oui" "impossible à déterminer" ...
 $ Type de geste                  : chr [1:321] NA "Meta.Aura" "Deictic.Addressee" NA ...
 $ Direction                      : chr [1:321] "à l'intérieur" "à l'intérieur" "à l'intérieur" "portée<marqueur" ...
 $ Source                         : chr [1:321] "ML" "ML" "ML" "ML" ...
 $ Polarité                       : chr [1:321] "positive" "positive" "positive" "positive" ...
Cependant ATTENTION, le nom de la plupart des variables ne respecte pas une syntaxe propre à R (en l’occurrence, il y a des espaces dans les noms) :
names(pragmatique_df)
 [1] "ID marqueur"                     "Evénement"
 [3] "Année"                           "Genre"
 [5] "Timing début"                    "Timing fin"
 [7] "Lemme"                           "POS-TAG"
 [9] "Type morpho-syntaxique"          "Position du marqueur dans l'UCT"
[11] "Position de l'UCT dans le TDP"   "Rôle de l'UCT dans la séquence"
[13] "Regard avant le marqueur"        "Regard pendant le marqueur"
[15] "Regard après le marqueur"        "Présence d'un geste?"
[17] "Type de geste"                   "Direction"
[19] "Source"                          "Polarité"
Ce qui veut dire que, pour les utiliser, on les entourera de `` (accents graves). Par exemple pour sortir le vecteur Timing début :
La dernière fois, nous avons vu comment utiliser le package janitor pour nettoyer les lignes et colonnes vides. Nous pouvons aussi l’utiliser pour renommer automatiquement les noms de variables de manière “adéquate” pour R.
Finalement, pour les graphiques est certaines fonctions statistiques, il est utile de transformer les variables de type “character” en type “factor” (véritables variables catégorielles dans R). On peut le faire avec as.factor() :
[1] SEMBLER  PARAÎTRE PARAÎTRE PARAÎTRE PARAÎTRE PARAÎTRE
9 Levels: APPAREMMENT AVOIR L'AIR AVOIR L'IMPRESSION ... VISIBLEMENT
On peut appliquer cette logique à l’ensemble des variables de type “character” du jeu de données avec l’aide de la fonction accross() (on s’assure au préalable que les modalités ne possède pas d’espaces en trop) :
Pour commencer, nous allons faire des statistiques uni-variées sur des vecteurs. Nous verrons comment utiliser ses fonctions dans le cadre du tidyverse dans Section 3.
2.1 Statistiques uni-variées sur une variable numérique
Les statistiques uni-variées classiques sur des variables numériques sont les suivantes :
La moyenne, indicateur de tendance centrale.
La médiane, indicateur de tendance centrale moins sensible aux valeurs extrêmes.
La variance et l’écart-type, indicateurs de dispersion.
Le minimum et maximum, autres indicateurs de dispersion.
Les quantiles, coupant la distribution en plusieurs groupes de proportions pré-définies.
Le skewneess et le kurtosis, indicateurs d’asymétrie et d’aplatissement.
Pour faire la moyenne, la fonction à utiliser est mean() :
mean(pragmatique_df$duree)
[1] 571.1184
La médiane s’obtient avec median() :
median(pragmatique_df$duree)
[1] 481
La variance avec var() :
var(pragmatique_df$duree)
[1] 142354.2
L’unité de la variance est l’unité de la variable au carré. Pour obtenir une valeur dans la même unité que notre variable, on calcule l’écart-type, qui correspond à la racine carrée de la variance :
sd(pragmatique_df$duree)
[1] 377.2985
sqrt(var(pragmatique_df$duree))
[1] 377.2985
Si notre variable se distribue selon une loi normale, on sait qu’à-peu-près 95% des valeurs sont comprises entre +/- deux fois l’écart-type (1.96 pour être plus précis) :
Les valeurs minimale et maximale s’obtiennent respectivement avec min() et max() :
min(pragmatique_df$duree)
[1] 0
max(pragmatique_df$duree)
[1] 2815
Il existe une infinité de quantiles différents. Ils sont définis par rapport à un pourcentage. Par exemple, on parle du quantile-0.25 la valeur telle que 25% des observations de la variable lui sont inférieures. On les obtient avec quantile(), avec le deuxième argument qui doit être un vecteur contenant les pourcentages désirés :
Notons que le quantile 50% correspond à la médiane.
Finalement, on peut également obtenir plusieurs statistiques d’un coup en utilisant la fonction summary() :
summary(pragmatique_df$duree)
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
    0.0   351.0   481.0   571.1   646.0  2815.0
Cette dernière peut même être appliquée à un tableau entier, auquel cas elle retournera un résumé pour chaque variable :
summary(pragmatique_df)
  id_marqueur      evenement       annee                          genre
 Min.   :20001   DPU_SAL: 40   Min.   :2007   Débat public           :155
 1st Qu.:20085   DPU_UDC: 26   1st Qu.:2007   Débat télévisé         : 70
 Median :40077   DPU_MED: 22   Median :2008   Réunion professionnelle: 96
 Mean   :34742   DPU_PRE: 21   Mean   :2011
 3rd Qu.:40158   DTV_DEM: 21   3rd Qu.:2017
 Max.   :40240   DPU_BIE: 20   Max.   :2018
                 (Other):171
  timing_debut       timing_fin                     lemme
 Min.   :  20296   Min.   :  20648   EVIDEMMENT        :111
 1st Qu.:1196517   1st Qu.:1196719   SEMBLER           : 95
 Median :2055657   Median :2056201   AVOIR L'IMPRESSION: 43
 Mean   :2188817   Mean   :2189388   PARAÎTRE          : 23
 3rd Qu.:2931688   3rd Qu.:2932249   APPAREMMENT       : 17
 Max.   :6846140   Max.   :6847425   AVOIR L'AIR       : 14
                                     (Other)           : 18
             pos_tag                                type_morpho_syntaxique
 adverbe         :141   construction attributive à verbe copule: 64
 locution verbale: 62   parenthétique                          : 29
 verbe           :118   prédicat verbal à complément           : 85
                        proposition complète                   :  2
                        syntagme adverbial                     :141


 position_du_marqueur_dans_l_uct position_de_l_uct_dans_le_tdp
 début   : 29                    début   : 29
 début*  : 56                    fin     : 47
 fin     : 16                    milieu  :182
 fin*    :  8                    totalité: 63
 milieu  :204
 totalité:  8

   role_de_l_uct_dans_la_sequence       regard_avant_le_marqueur
 indéterminé      :233            allocutaire(s)    :142
 initiatif        : 34            autre             : 53
 réactif/évaluatif: 54            indéterminable    : 75
                                  objet (symbolique): 47
                                  tiers             :  3
                                  yeux fermés       :  1

      regard_pendant_le_marqueur       regard_apres_le_marqueur
 allocutaire(s)    :147          allocutaire(s)    :158
 autre             : 47          autre             : 41
 indéterminable    : 75          indéterminable    : 70
 objet (symbolique): 47          objet (symbolique): 47
 tiers             :  4          tiers             :  5
 yeux fermés       :  1

               presence_dun_geste                type_de_geste
 impossible à déterminer: 56      Deictic.Object        : 16
 non                    :159      Deictic.Indeterminable: 13
 oui                    :106      Deictic.Addressee     : 11
                                  Meta.Cup              : 11
                                  Emblem.Doubt-Shrug    :  9
                                  (Other)               : 46
                                  NAs                   :215
           direction   source       polarite       duree        duree_cat
 à l'intérieur  :129   AL: 13   négative:  7   Min.   :   0.0   court:108
 à l’intérieur  :  4   ML:308   neutre  : 13   1st Qu.: 351.0   long :107
 marqueur>portée:133            positive:301   Median : 481.0   moyen:106
 portée<marqueur: 55                           Mean   : 571.1
                                               3rd Qu.: 646.0
                                               Max.   :2815.0
Grâce à la libraire DescTools, on peut également mesurer des indices avancés comme le skewness (asymétrie) et le kurtosis (aplatissement) avec respectivement Skew() et Kurt() :
Skew(pragmatique_df$duree)
[1] 2.540387
Kurt(pragmatique_df$duree)
[1] 9.251883
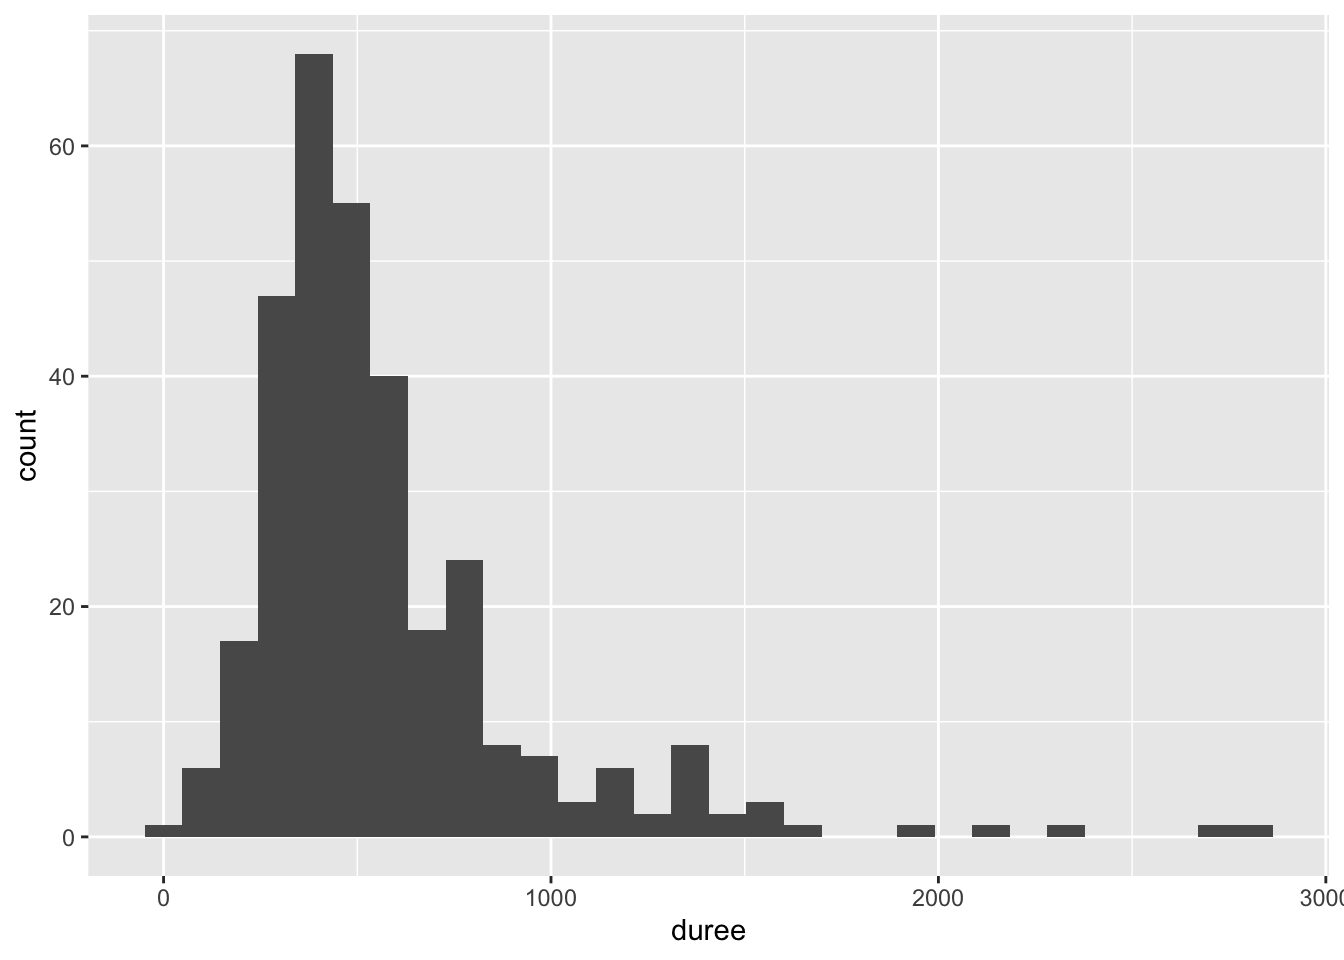
La valeur positive du skewness indique que la distribution est “penchée” à gauche, tandis que la valeur de kurtosis (calcul normalisé, valeur de 0 pour la loi normale) indique que la distribution est plus “aplatie” que la normale.
On anticipe un peu (les graphiques viendront par la suite), mais voici la distribution de la variable duree:
Le mode s’obtient avec la fonction Mode() (de DescTools) :
Mode(pragmatique_df$lemme)
[1] EVIDEMMENT
attr(,"freq")
[1] 111
9 Levels: APPAREMMENT AVOIR L'AIR AVOIR L'IMPRESSION ... VISIBLEMENT
Finalement l’entropie s’obtient avec Entropy() (de DescTools) appliqué à la table des fréquences :
Entropy(table(pragmatique_df$lemme))
[1] 2.451984
Notez que cette dernière est calculée en base 2 (par défaut). Elle a comme valeur maximale 2^(nombre de catégories) ssi toutes les catégories possèdent la même fréquence. Afin d’interpréter l’entropie, on peut élever sa base par la valeur obtenue, ce qui nous donne la variété effective :
2^Entropy(table(pragmatique_df$lemme))
[1] 5.471682
2.3 Statistiques bi-variées
Les statistiques bi-variées que nous allons voir sont peu nombreuses.
Entre deux variables numériques, on peut utiliser la covariance ou la corrélation, avec cov() et cor() :
Il est important de noter que les fonctions de statistiques uni- et bi-variées ne gèrent pas les valeurs manquantes. Par défaut, elles retournent NA. Pour les faire fonctionner, il faut ajouter l’argument na.rm=TRUE :
test =c(4, 5, NA, 8)mean(test)
[1] NA
mean(test, na.rm=TRUE)
[1] 5.666667
3 Utilisation dans le tidyverse
3.1 Calcule d’indices avec mutate()
Le calcul d’indice statistiques dans le tidyverse peut intervenir dans des contextes différents.
Si l’on utilise aucune agrégation ou groupes (voir Section 3.3) et que l’on utilise directement mutate(), les fonctions de statistiques vont calculer l’indice sur l’ensemble du jeu de données, et retourner la même valeur pour chaque observation :
AstuceUne application : la normalisation des variables
Calculer des indices constants sur une colonne peut parfois être utile : on peut s’en servir par exemple pour normaliser nos variables (en construisant deux colonnes auxiliaires pour la moyenne et l’écart-type) :
On peut s’assurer que les deux variables sont bien normalisées avec :
mean(pragmatique_df$duree_norm)
[1] 6.637128e-16
sd(pragmatique_df$duree_norm)
[1] 1
mean(pragmatique_df$duree_norm2)
[1] 3.908262e-17
sd(pragmatique_df$duree_norm2)
[1] 1
3.2 Utilisation de summarize() et reframe()
Si la fonction ne retourne qu’un résultat, il est souvent plus judicieux d’utiliser la fonction summarize() (ou summarise()), qui applique l’indice et combine toutes les observations en une seule :
pragmatique_df %>%summarize(m_duree=mean(duree))
# A tibble: 1 × 1
  m_duree
    <dbl>
1    571.
On peut également l’utiliser pour créer plusieurs indices (la fonction n() compte le nombre d’observations) :
3.3 Définir des groupes et la logique du “Split-Apply-Combine”
La puissance de summarize() devient plus évidente lorsque l’on souhaite faire des statistiques par groupe. La logique devient alors celle du “Split-Apply-Combine”, qui effectue les opérations suivantes :
Split : le jeu de données est divisé en groupes selon une ou plusieurs variables.
Apply : une fonction est appliquée à chaque groupe pour calculer des statistiques ou effectuer des transformations.
Combine : les résultats de chaque groupe sont combinés pour former un nouveau jeu de données
L’opération de split, c’est-à-dire celle de définir les groupes, se fait en amont des deux autres grâce à la fonction group_by() :
# A tibble: 321 × 4
# Groups:   lemme, genre [24]
   genre                   lemme              m_duree sd_duree
   <fct>                   <fct>                <dbl>    <dbl>
 1 Débat public            SEMBLER               573.    339.
 2 Débat public            PARAÎTRE              317.     98.4
 3 Débat public            PARAÎTRE              317.     98.4
 4 Débat télévisé          PARAÎTRE              385.    200.
 5 Débat télévisé          PARAÎTRE              385.    200.
 6 Réunion professionnelle PARAÎTRE              367     299.
 7 Débat public            AVOIR L'AIR           652     737.
 8 Débat télévisé          AVOIR L'AIR           238.    111.
 9 Débat télévisé          AVOIR L'AIR           238.    111.
10 Débat public            AVOIR L'IMPRESSION   1127.    531.
# ℹ 311 more rows
C’est avec summarize() (ou reframe()) que l’apply est suivi d’un combine : le calcul est effectué sur chaque groupe et le résultat est combiné par groupe (d’ailleurs, la dernière granularité du groupe disparait) :
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by lemme and genre.
ℹ Output is grouped by lemme.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(lemme, genre))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
# A tibble: 24 × 5
# Groups:   lemme [9]
   lemme               genre                   n_obs m_duree sd_duree
   <fct>               <fct>                   <int>   <dbl>    <dbl>
 1 APPAREMMENT         Débat public                5    521      138.
 2 APPAREMMENT         Débat télévisé              1    815       NA
 3 APPAREMMENT         Réunion professionnelle    11    514      182.
 4 AVOIR L'AIR         Débat public                6    652      737.
 5 AVOIR L'AIR         Débat télévisé              2    238.     111.
 6 AVOIR L'AIR         Réunion professionnelle     6    288.     138.
 7 AVOIR L'IMPRESSION  Débat public               15   1127.     531.
 8 AVOIR L'IMPRESSION  Débat télévisé              6    911.     607.
 9 AVOIR L'IMPRESSION  Réunion professionnelle    22    873.     440.
10 DONNER L'IMPRESSION Réunion professionnelle     5   1399.     556.
# ℹ 14 more rows
Si les groupes ont été définis avec plusieurs variables, un enchaînement de summarize() va donner des statistiques de plus en plus grossières :
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by lemme and genre.
ℹ Output is grouped by lemme.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(lemme, genre))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
Le besoin de compter les effectifs par groupe (group_by(...) %>% summarize(n = n())) est tellement fréquent en statistiques qu’il existe une fonction raccourci dédiée : count(). C’est l’équivalent Tidyverse de la fonction table() que nous avons vue plus tôt, mais elle retourne un tibble prêt à l’emploi (et permet de classer les observations) :
pragmatique_df %>%count(lemme, sort=TRUE) %>%mutate(freq_rel = n /sum(n))
Finalement, la fonction reframe() nous permet d’obtenir plusieurs valeurs par groupe, et duplique donc le nombre de lignes par le nombre de résultats :