1 Introduction
Jusqu’à présent, dans les jeux de données sur lesquels nous avons travaillé, nos individus (nos lignes) ont été caractérisés par leurs variables. Nous avons vu comment construire des distances entre ces individus et même les représenter en tant que points dans l’espace. Cependant, il nous manque un outil mathématique pour représenter des liens formels (ou leur absence) entre les individus.
L’analyse de réseaux propose de remédier à cela : ce qui nous intéresse dans ce cadre, ce sont les relations qui unissent (ou non) les individus. Ce paradigme permet de représenter de nombreux phénomènes : les réseaux sociaux, le trafic aérien, les relations entre les personnages d’un roman ou même les interactions entre les protéines de notre corps. L’analyse de réseaux se base sur une branche des mathématiques particulière : la théorie des graphes.
1.1 Définition d’un graphe
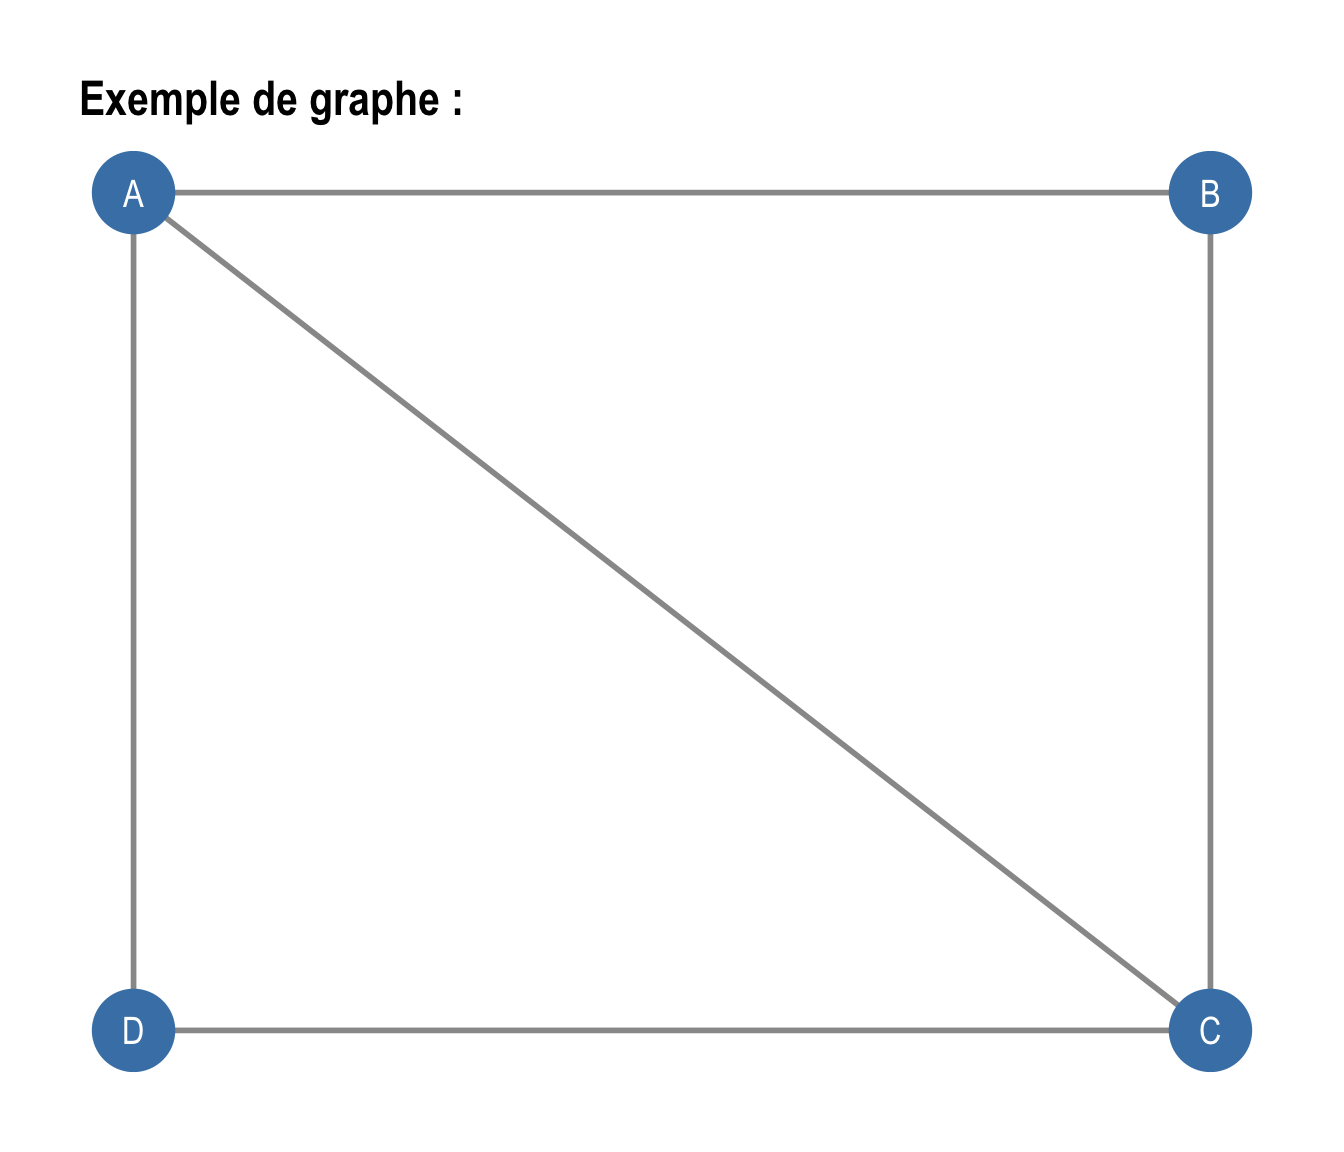
Un graphe, que l’on distingue d’un réseau par son côté abstrait (bien que cette distinction se perde), est une structure mathématique formelle composée de deux éléments fondamentaux :
- Les Nœuds (Nodes ou Vertices en anglais) : ce sont les entités de notre réseau (des personnes, des villes, des ordinateurs, des mots, etc.).
- Les Arêtes (Edges en anglais) : ce sont les connexions qui relient ces nœuds (une amitié, une route, un câble, une co-occurrence, etc.).
Il existe deux standards pour représenter un graphe de manière formelle :
- La matrice d’adjacence : c’est un tableau carré où les lignes et les colonnes représentent les nœuds. Si deux nœuds sont connectés, on place un 1 à leur intersection. S’ils ne le sont pas, on place un 0 :
\[\begin{array}{c|cccc} & A & B & C & D \\ \hline A & 0 & 1 & 1 & 1 \\ B & 1 & 0 & 1 & 0 \\ C & 1 & 1 & 0 & 1 \\ D & 1 & 0 & 1 & 0 \\ \end{array}\]
- La liste d’arêtes : c’est le format le plus courant en informatique (et celui préféré par le Tidyverse). Il s’agit d’un tableau à deux colonnes (source et cible) où chaque ligne représente un lien qui existe. Cette représentation prend moins de place en mémoire :
\[\begin{array}{cc} \textbf{Source (from)} & \textbf{Cible (to)} \\ \hline A & B \\ A & C \\ A & D \\ B & C \\ C & D \\ \end{array}\]
1.2 Graphes orientés et pondérés
Afin de modéliser certains phénomènes plus complexes, les arêtes d’un graphe peuvent posséder certaines caractéristiques :
Les arêtes peuvent être orientées : la relation est alors asymétrique. Par exemple, sur Instagram, A peut suivre B sans que B ne suive A. Les liens sont alors représentés par des flèches.
Les arêtes peuvent être pondérées : tous les liens n’ont pas la même importance. On peut attribuer un poids à chaque arête. Ce poids peut représenter une proximité (le nombre d’e-mails échangés entre deux collègues) ou une distance (le nombre de kilomètres entre deux villes).
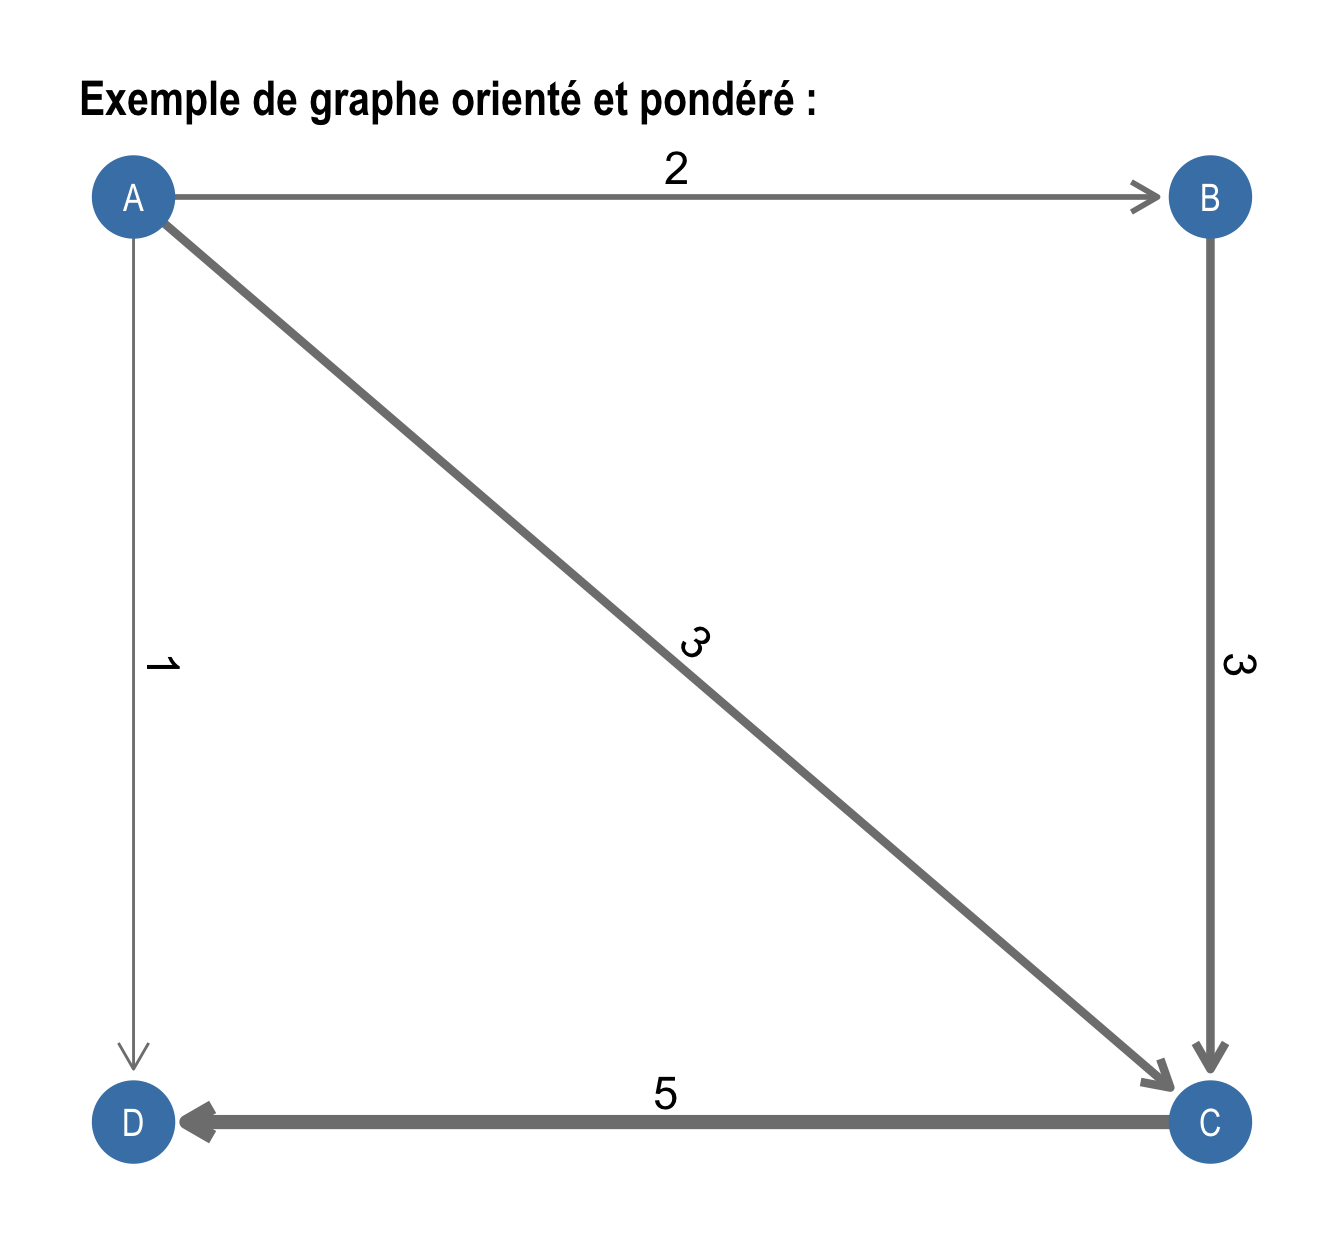
Représenter mathématiquement les graphes orientés ne nécessite aucun changement dans la matrice d’adjacence ou la liste d’arêtes. En revanche, pour un graphe pondéré, la matrice d’adjacence va contenir les poids, et on doit ajouter une colonne “weight” à la liste d’arêtes.
1.3 Les graphes bipartis
Le concept des graphes bipartis apparaît souvent en sciences humaines et sociales. Il s’agit d’un graphe dans lequel les nœuds sont divisés en deux groupes distincts, et les arêtes existent uniquement entre des nœuds appartenant à deux groupes différents.
Les graphes bipartis permettent de modéliser plusieurs phénomènes :
Auteur·trices et Articles : les chercheur·euses sont relié·e·s aux articles qu’iels ont publiés.
Client·es et produits : les acheteur·euses sont relié·e·s aux objets qu’iels ont achetés (c’est la base des systèmes de recommandation).
Administrateur·trices et entreprises : les administrateur·trices sont relié·es aux entreprises qu’iels administrent.
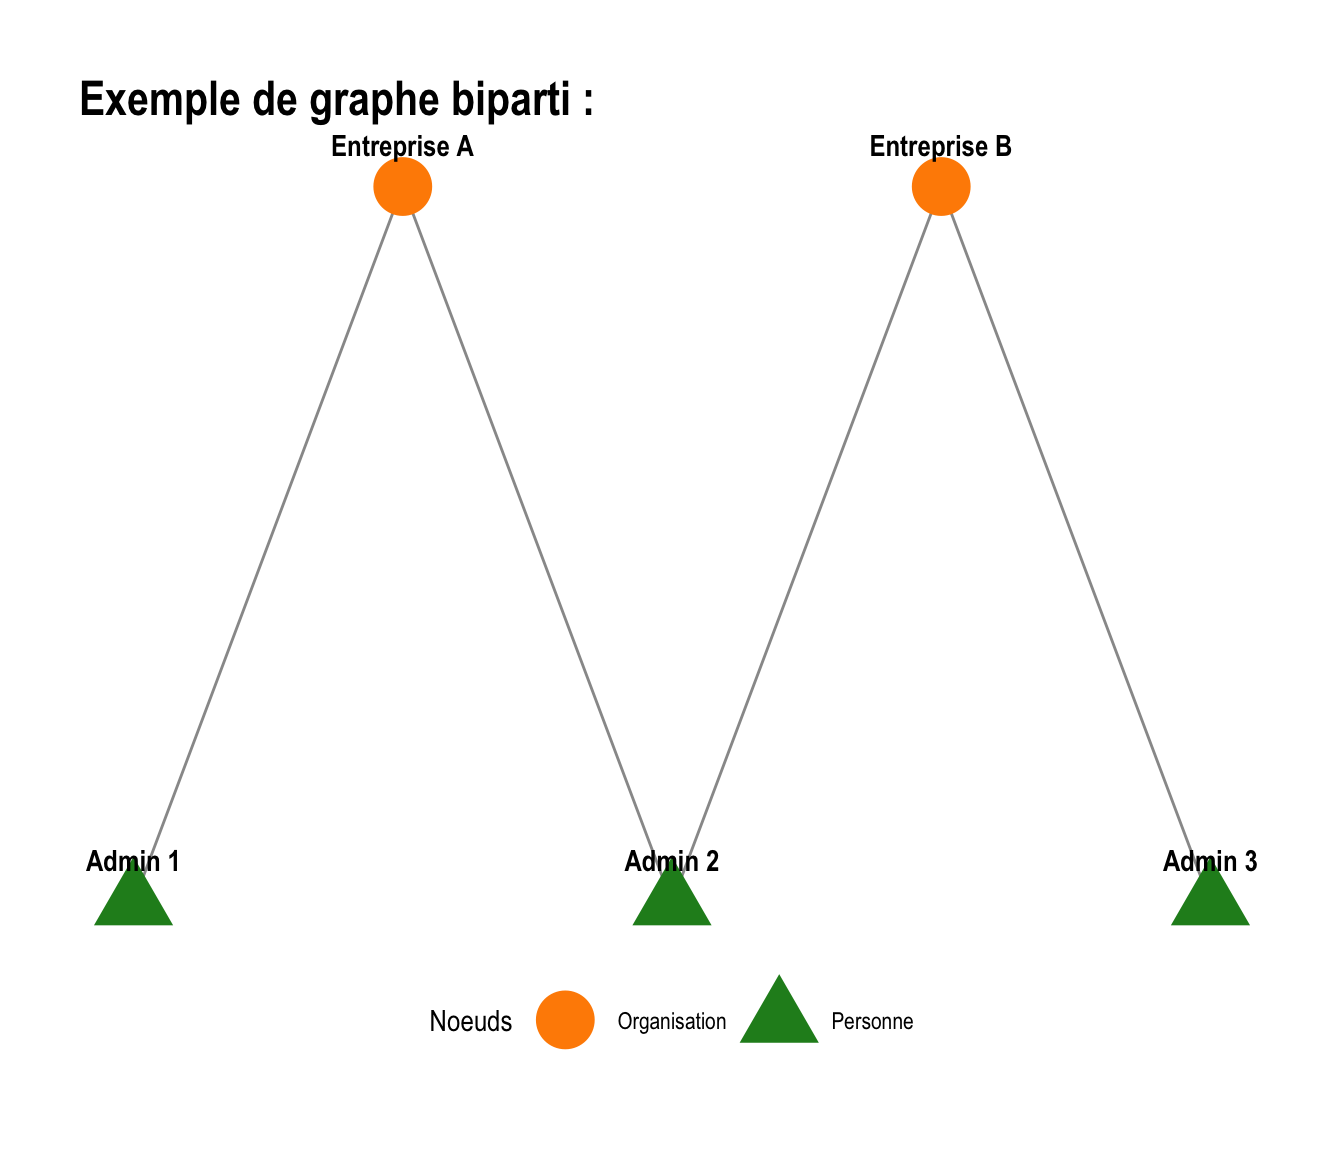
Si nous voulons étudier les relations entre les administrateurs (ou les entreprises), nous allons devoir effectuer une opération mathématique appelée projection. C’est ce que nous ferons dans la suite de ce cours.
2 Modélisation de graphes dans R
2.1 Présentation des bibliothèques
Historiquement, l’analyse de réseaux en R se faisait principalement avec le package igraph. C’est un moteur mathématique très puissant capable de gérer des réseaux de millions de nœuds. Cependant, sa syntaxe est particulière et s’éloigne de la logique du Tidyverse.
Pour pallier cela, nous utiliserons les packages suivants :
igraph: La bibliothèque logique sous-jacente. Nous ferons rarement appel à elle directement, mais elle peut parfois s’avérer utile.tidygraph: Une surcouche qui permet d’utiliser la logique du Tidyverse sur des objetsigraph. Cela nous permettra d’utiliser les fonctions qui nous sont familières (mutate(),filter()) directement sur les nœuds et les arêtes.ggraph: L’équivalent deggplot2dédié exclusivement au dessin de graphes. Encore une fois, c’est une surcouche surigraph(qui permet aussi de dessiner des graphes).
library(tidyverse)
library(igraph)
library(tidygraph)
library(ggraph)
library(ggrepel) # Sert uniquement à la fin, pour ne pas superposer les labels dans ggplot
2.2 Création d’un graphe à partir de données
Pour importer un réseau dans R avec tidygraph, il existe trois approches principales. Le choix de la méthode dépend directement de la manière dont vos données sont structurées.
Chacune de ces méthodes nous donne un objet de type tbl_graph et igraph, qui peut ensuite être utilisé dans plusieurs fonctions.
2.2.1 Approche A : À partir d’une liste d’arêtes
C’est le format le plus fréquent en informatique. On le retrouve typiquement lorsque l’on extrait des journaux de logs (qui a envoyé un mail à qui, qui a cliqué sur quel lien) ou des données de transactions.
Pour créer le graphe, on utilise la fonction as_tbl_graph() de tidygraph.
- Graphe orienté et non-orienté : Par défaut, le graphe est considéré comme orienté. Pour avoir un graphe non-orienté, on ajoute
directed = FALSE. - Ajouter du poids : Il suffit de rajouter une troisième colonne numérique.
tidygraphva automatiquement détecter qu’il s’agit du poids de la relation.
# Création de la liste des arêtes pour un graphe pondéré. On ajoute une colonne "weight" (ex: nombre de messages échangés)
edges_df = data.frame(
  from = c("Alice", "Alice", "Bob"),
  to   = c("Bob", "Charlie", "Charlie"),
  weight = c(12, 2, 5)
)

# Création de l'objet de type graphe non-orienté et pondéré
graph_from_edges = as_tbl_graph(edges_df, directed = FALSE)
graph_from_edges
# A tbl_graph: 3 nodes and 3 edges
#
# An undirected simple graph with 1 component
#
# Node Data: 3 × 1 (active)
name
<chr>
1 Alice
2 Bob
3 Charlie
#
# Edge Data: 3 × 3
from to weight
<int> <int> <dbl>
1 1 2 12
2 1 3 2
3 2 3 52.2.2 Approche B : À partir d’une matrice d’adjacence
La matrice d’adjacence provient fréquemment de calculs statistiques intermédiaires. On peut la dériver à partir d’une matrice de dissimilarités (pour un graphe entre individus) ou à partir d’une matrice de corrélation (pour un graphe entre variables). C’est un format plus lourd que la liste d’arêtes, et il ne peut être utilisé que pour des graphes de petite à moyenne taille.
La fonction à utiliser est également as_tbl_graph(). Si le tableau d’entrée est strictement carré et possède des noms de lignes/colonnes identiques, la fonction comprend qu’il s’agit d’une matrice d’adjacence.
Notons que :
- Si la matrice est symétrique, le graphe sera non-orienté.
- Les valeurs à l’intérieur des cases (autres que 0 et 1) deviennent automatiquement le poids (
weight) des liens.
# Création d'une matrice carrée de corrélation fictive entre 3 variables
adjacency_matrix = matrix(
  c(0, 0.8, 0.1,
    0.8, 0, 0.4,
    0.1, 0.4, 0),
  nrow = 3,
  dimnames = list(c("Var_A", "Var_B", "Var_C"), c("Var_A", "Var_B", "Var_C"))
)

# Opération fréquente de "cutoff"
adjacency_matrix[adjacency_matrix < 0.2] = 0

# Création de l'objet de type graphe non-orienté et pondéré
graph_from_adjacency = as_tbl_graph(adjacency_matrix, directed = FALSE)
graph_from_adjacency
# A tbl_graph: 3 nodes and 2 edges
#
# An unrooted tree
#
# Node Data: 3 × 1 (active)
name
<chr>
1 Var_A
2 Var_B
3 Var_C
#
# Edge Data: 2 × 3
from to weight
<int> <int> <dbl>
1 1 2 0.8
2 2 3 0.42.2.3 Approche C : La construction explicite (Nœuds + Liens)
Cette méthode est utilisée lorsque vos données sont stockées dans une base de données relationnelle avec deux tables distinctes : une table décrivant les individus (leurs attributs) et une table décrivant les relations.
Ici, on n’utilise plus as_tbl_graph() mais la fonction constructrice tbl_graph(), à laquelle on passe explicitement les deux tableaux. Dans la liste des arêtes, les colonnes from et to doivent contenir une clé d’identification unique des nœuds (ici name), que nous préciserons dans l’attribut node_key de tbl_graph() :
# Le tableau des nœuds avec des attributs (ex: le genre)
nodes_df = data.frame(
  name = c("Alice", "Bob", "Charlie"),
  genre = c("F", "M", "M")
)

# Le tableau des liens
edges_df = data.frame(
  from = c("Alice", "Alice", "Bob"),
  to   = c("Bob", "Charlie", "Charlie")
)

# Création de l'objet de type graphe orienté et non-pondéré
graph_from_db = tbl_graph(nodes = nodes_df, edges = edges_df, node_key="name", directed = TRUE)
graph_from_db
# A tbl_graph: 3 nodes and 3 edges
#
# A directed acyclic simple graph with 1 component
#
# Node Data: 3 × 2 (active)
name genre
<chr> <chr>
1 Alice F
2 Bob M
3 Charlie M
#
# Edge Data: 3 × 2
from to
<int> <int>
1 1 2
2 1 3
3 2 32.3 Application : Le graphe biparti Star Wars
Penchons-nous maintenant sur un cas concret : nous allons charger le jeu de données starwars (de dplyr) et construire un graphe biparti de type personnages-films.
Commençons par observer le jeu de données :
starwars# A tibble: 87 × 14
name height mass hair_color skin_color eye_color birth_year sex gender
<chr> <int> <dbl> <chr> <chr> <chr> <dbl> <chr> <chr>
1 Luke Sk… 172 77 blond fair blue 19 male mascu…
2 C-3PO 167 75 <NA> gold yellow 112 none mascu…
3 R2-D2 96 32 <NA> white, bl… red 33 none mascu…
4 Darth V… 202 136 none white yellow 41.9 male mascu…
5 Leia Or… 150 49 brown light brown 19 fema… femin…
6 Owen La… 178 120 brown, gr… light blue 52 male mascu…
7 Beru Wh… 165 75 brown light blue 47 fema… femin…
8 R5-D4 97 32 <NA> white, red red NA none mascu…
9 Biggs D… 183 84 black light brown 24 male mascu…
10 Obi-Wan… 182 77 auburn, w… fair blue-gray 57 male mascu…
# ℹ 77 more rows
# ℹ 5 more variables: homeworld <chr>, species <chr>, films <list>,
# vehicles <list>, starships <list>Ce jeu de données est particulier, car il possède des données emboîtées. En effet, la colonne films contient des listes de plusieurs éléments (les films dans lesquels les personnages apparaissent). Pour “désemboîter” ces données, nous allons utiliser la fonction unnest(), qui démultiplie le nombre de lignes pour chaque élément de films :
sw_edges = starwars %>%
  select(name, films) %>%
  unnest(films) %>%
  rename(character = name, film = films)

head(sw_edges)
# A tibble: 6 × 2
character film
<chr> <chr>
1 Luke Skywalker A New Hope
2 Luke Skywalker The Empire Strikes Back
3 Luke Skywalker Return of the Jedi
4 Luke Skywalker Revenge of the Sith
5 Luke Skywalker The Force Awakens
6 C-3PO A New Hope Maintenant que notre liste d’arêtes est prête, nous appliquons la méthode vue dans l’Approche A pour générer notre objet graphe :
# Création du graphe biparti non-orienté
graph_sw_biparti = as_tbl_graph(sw_edges, directed = FALSE)
graph_sw_biparti
# A tbl_graph: 94 nodes and 173 edges
#
# An undirected simple graph with 1 component
#
# Node Data: 94 × 1 (active)
name
<chr>
1 Luke Skywalker
2 C-3PO
3 R2-D2
4 Darth Vader
5 Leia Organa
6 Owen Lars
7 Beru Whitesun Lars
8 R5-D4
9 Biggs Darklighter
10 Obi-Wan Kenobi
# ℹ 84 more rows
#
# Edge Data: 173 × 2
from to
<int> <int>
1 1 88
2 1 89
3 1 90
# ℹ 170 more rowsIci, nous allons également ajouter des attributs aux nœuds pour savoir s’il s’agit d’un personnage ou d’un film, ce qui sera nécessaire pour l’affichage par la suite. On crée la variable type qui contient des booléens (pour les calculs, TRUE si c’est un personnage) et la variable type_str contenant des chaînes de caractères (pour l’affichage).
graph_sw_biparti = graph_sw_biparti %>%
  activate(nodes) %>% # Les modifications suivantes portent sur les nœuds
  mutate(
    type = name %in% sw_edges$character,
    type_str = ifelse(type, "character", "film")
  )

# On n'affiche que le tableau de nœuds
graph_sw_biparti %>%
  activate(nodes) %>%
  as_tibble()
# A tibble: 94 × 3
name type type_str
<chr> <lgl> <chr>
1 Luke Skywalker TRUE character
2 C-3PO TRUE character
3 R2-D2 TRUE character
4 Darth Vader TRUE character
5 Leia Organa TRUE character
6 Owen Lars TRUE character
7 Beru Whitesun Lars TRUE character
8 R5-D4 TRUE character
9 Biggs Darklighter TRUE character
10 Obi-Wan Kenobi TRUE character
# ℹ 84 more rows2.4 La projection d’un graphe biparti
Notre graph_sw_biparti actuel connecte les personnages aux films. Si nous voulons analyser qu’un seul type de nœuds, on doit effectuer une projection biparti.
C’est ici que tidygraph montre ses limites et que igraph prend le relais grâce à la fonction bipartite_projection(). Pour que cette fonction marche, elle a besoin d’une colonne contenant des booléens nommée type, permettant de séparer le graphe en deux (ce que nous avons créé au point précédent) :
projections = bipartite_projection(graph_sw_biparti)

# On extrait le graphe qui nous intéresse (les personnages) et on le remet en format `tidygraph` :
graph_characters = as_tbl_graph(projections$proj2)
graph_characters
# A tbl_graph: 87 nodes and 1793 edges
#
# An undirected simple graph with 1 component
#
# Node Data: 87 × 2 (active)
name type_str
<chr> <chr>
1 Luke Skywalker character
2 C-3PO character
3 R2-D2 character
4 Darth Vader character
5 Leia Organa character
6 Owen Lars character
7 Beru Whitesun Lars character
8 R5-D4 character
9 Biggs Darklighter character
10 Obi-Wan Kenobi character
# ℹ 77 more rows
#
# Edge Data: 1,793 × 3
from to weight
<int> <int> <dbl>
1 1 2 4
2 1 3 5
3 1 4 4
# ℹ 1,790 more rowsDans notre nouveau réseau, R a automatiquement créé une variable weight (le poids du lien). Ce poids correspond au nombre de films que les deux personnages ont en commun.
Pour rendre l’analyse plus pertinente et nettoyer notre futur graphique, nous allons filtrer ce réseau pour ne garder que les relations “fortes”, c’est-à-dire les personnages qui ont partagé au moins 2 films ensemble :
# On active les arêtes (edges) pour filtrer par poids,
# puis on supprime les nœuds qui se retrouveraient isolés suite au filtrage
graph_characters_red = graph_characters %>%
  activate(edges) %>%
  filter(weight >= 3) %>% # supprime les arêtes trop légères
  activate(nodes) %>%
  filter(!node_is_isolated()) # permet d'enlever les nœuds isolés
graph_characters_red
# A tbl_graph: 23 nodes and 134 edges
#
# An undirected simple graph with 1 component
#
# Node Data: 23 × 2 (active)
name type_str
<chr> <chr>
1 Luke Skywalker character
2 C-3PO character
3 R2-D2 character
4 Darth Vader character
5 Leia Organa character
6 Owen Lars character
7 Beru Whitesun Lars character
8 Obi-Wan Kenobi character
9 Anakin Skywalker character
10 Chewbacca character
# ℹ 13 more rows
#
# Edge Data: 134 × 3
from to weight
<int> <int> <dbl>
1 1 2 4
2 1 3 5
3 1 4 4
# ℹ 131 more rowsNotre graphe des personnages de Star Wars est maintenant prêt. Voyons maintenant ce que nous pouvons faire avec.
3 Visualisations avec ggraph
La première chose que nous pouvons faire avec les graphes, c’est de les représenter. Pour cela, le package ggraph (https://ggraph.data-imaginist.com/) est très utile : il permet d’utiliser la même grammaire que ggplot2 (les geom_, les aes(), les theme()), mais s’applique sur des objets de type graphe. Il suffit d’apprendre le nom des nouvelles géométries dédiées aux graphes, mais la logique reste identique.
3.1 Introduction aux Layouts
Un problème majeur lorsque l’on affiche un graphe, c’est qu’il faut arriver à placer les points. En effet, les nœuds d’un réseau n’ont pas de coordonnées naturelles, il s’agit ainsi de les définir.
C’est ici qu’intervient le layout : ce dernier consiste en un algorithme qui calcule des coordonnées pour chaque nœud en fonction de la structure du graphe, afin de rendre le dessin lisible.
Il existe des dizaines de layouts possibles, voici les plus fréquents :
layout = "circle": place tous les nœuds en cercle. Parfait pour les petits graphes avec peu de liens.layout = "fr"(Fruchterman-Reingold) : ce layout simule des ressorts entre les nœuds liés (qui s’attirent) et une force magnétique entre tous les nœuds (qui se repoussent).layout = "kk"(Kamada-Kawai) : Un autre algorithme “physique”, très bon pour équilibrer les distances, souvent plus symétrique que le"fr"sur les graphes de taille moyenne.layout = "manual": permet de placer manuellement les points en donnant les coordonnéesxetydes nœuds (ces coordonnées doivent être dans les attributs des nœuds).
Attention cependant, les algorithmes “physiques” commencent par des positions aléatoires des nœuds avant de faire agir les forces. Pour fixer le hasard et avoir un document reproductible, vous devez utiliser set.seed() avant de dessiner un graphe.
Commençons par un visuel simple sur notre graphe des personnages de Star Wars :
# On fixe la seed
set.seed(2026)
# On initialise le graphique (similaire à ggplot())
ggraph(graph_characters_red, layout = "fr") +
  # On ajoute la géométrie des arêtes (les lignes)
  geom_edge_link() +
  # On ajoute la géométrie des nœuds (les points)
  geom_node_point()
3.2 Personnalisation
3.2.1 Le graphe des personnages de Star Wars
Ce premier jet est difficilement lisible. Nous allons utiliser ici une grammaire similaire à ggplot2 (par exemple aes()) pour améliorer l’apparence visuelle de notre graphe.
Plus spécifiquement, nous allons :
- Donner une épaisseur aux arêtes (avec
edge_width) à partir de la colonneweight(le nombre de films en commun). - Ajouter de la transparence (
alpha) aux lignes pour ne pas écraser les points. - Ajouter le nom des personnages avec
geom_node_text(). L’optionrepel = TRUEest nécessaire pour éviter que les labels se chevauchent.
ggraph(graph_characters_red, layout = "fr") +
  geom_edge_link(aes(edge_width = weight), alpha=0.3, color="gray50") +
  geom_node_point(size=5, color="steelblue") +
  # Ajout du texte sur les nœuds
  geom_node_text(aes(label = name), repel = TRUE, size = 3) +
  # Taille maximale et minimale des arêtes
  scale_edge_width(range = c(0.5, 3)) +
  # Titre
  labs(title = "Réseau des personnages de Star Wars") +
  # Thème général
  theme_graph()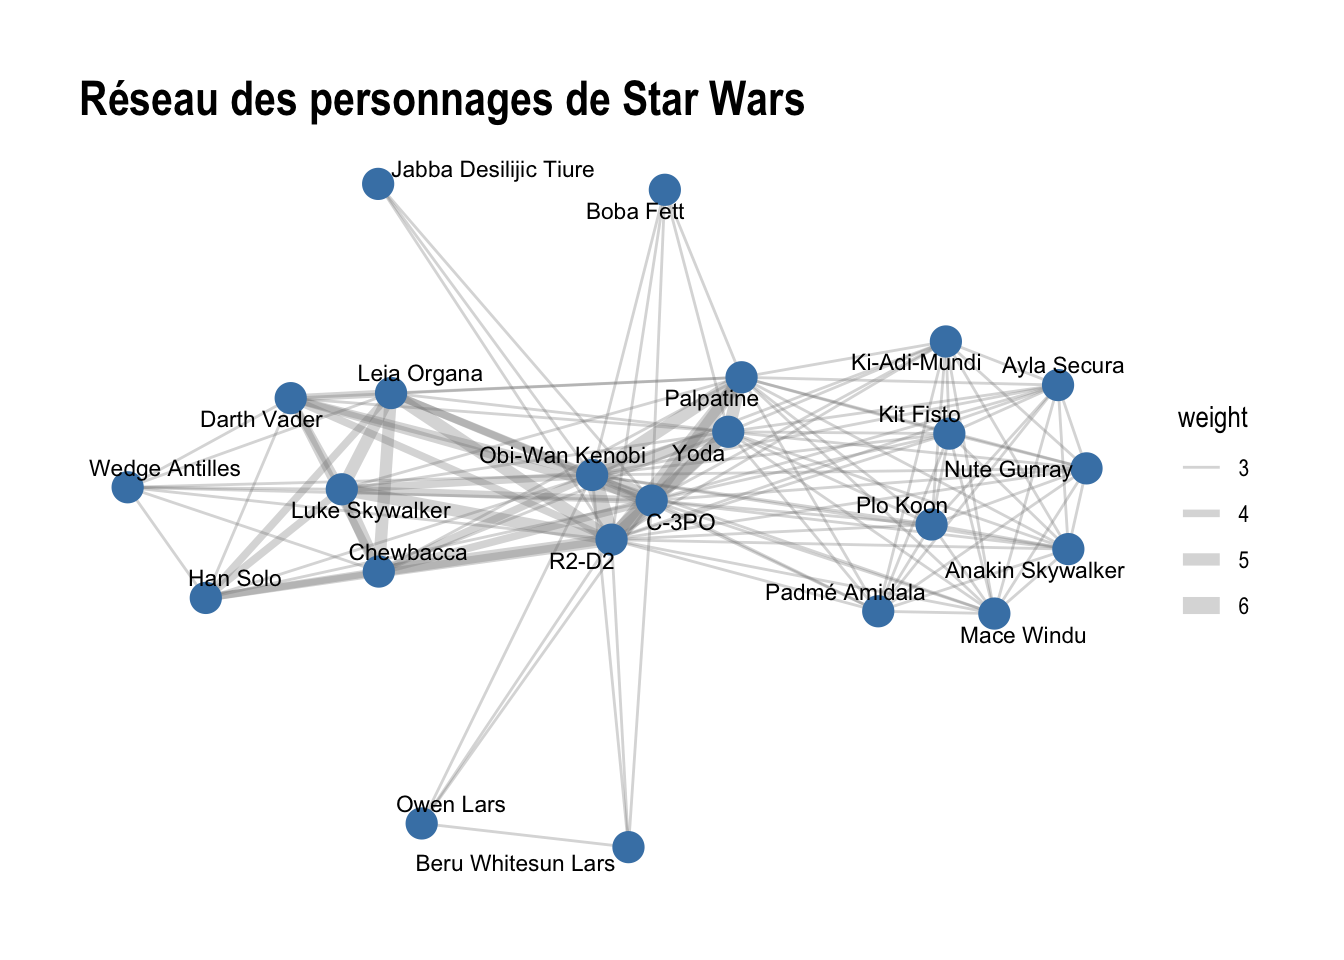
3.2.2 Le graphe biparti
Comme avec ggplot2, la grammaire de ggraph est très souple et permet de nombreux affichages possibles (quelques exemples sur https://r-graph-gallery.com/package/ggraph.html). Pour prendre un autre exemple, nous allons maintenant afficher notre graphe biparti graph_sw_biparti, qui contient à la fois les films et les personnages.
Puisque nous avions créé une colonne type_str lors de sa création, nous pouvons l’injecter dans l’esthétique color des nœuds. Nous utiliserons également le layout = "bipartite" conçu spécialement pour séparer les deux groupes de nœuds.
# L'option "bipartite" place les nœuds sur deux axes verticaux
ggraph(graph_sw_biparti, layout = "bipartite") +
  geom_edge_link(alpha = 0.15) +
  # On colore les nœuds selon leur catégorie
  geom_node_point(aes(color = type_str), size = 4) +
  geom_node_text(aes(label = name), repel = TRUE, size=3) +
  # On personnalise les couleurs
  scale_color_manual(values = c("film" = "darkred",
                                "character" = "steelblue")) +
  # On tourne le graphique à l'horizontale pour une meilleure lecture
  coord_flip() +
  theme_graph()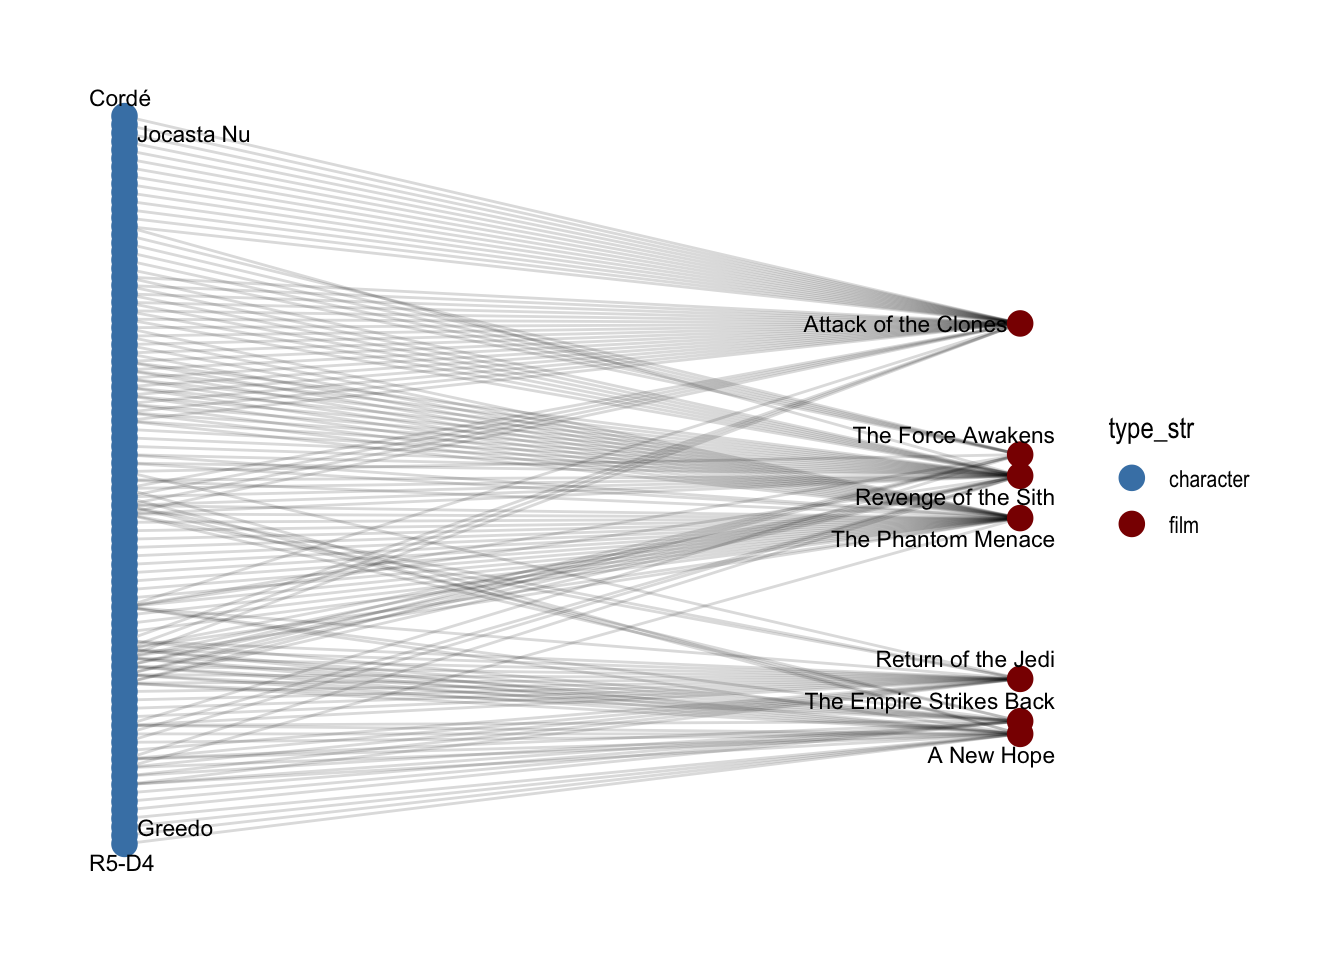
Les options sont extrêmement nombreuses et nous n’avons pas le temps de les voir toutes ici. Mais d’autres exemples d’affichage de graphes seront donnés par la suite.
4 Les mesures de centralité
L’affichage d’un réseau peut être intéressant lorsque celui-ci est de taille raisonnable, mais cette approche reste limitée pour en comprendre la structure. Afin de l’analyser, il existe plusieurs mesures ou indices que l’on peut calculer pour comprendre comment notre réseau est constitué.
Pour cela, il existe deux principaux types d’indicateurs :
- Les indices globaux : ils décrivent le réseau dans son ensemble. On peut s’intéresser à la densité du réseau (le nombre de liens existants), son diamètre (le plus long plus court chemin), ou le nombre moyen de voisins. Ces mesures servent principalement à comparer des réseaux entre eux, ce que nous n’allons pas faire ici.
- Les indices locaux (sur les nœuds ou les arêtes) : ils attribuent un score à chaque nœud ou chaque arête selon sa position structurelle. Les principaux indices ici sont ceux qu’on appelle les mesures de centralité.
La “centralité” d’un nœud ou d’une arête n’est pas un concept formellement unique et il existe plusieurs manières de la concevoir. En réalité, il existe plusieurs mesures de centralité qui permettent de capturer différents aspects de la “centralité” de ces objets. On peut en obtenir une liste exhaustive avec ?centrality, mais nous allons nous concentrer ici sur les principales mesures de centralité sur les nœuds :
- La centralité de degré (degree) : C’est la mesure la plus simple. On compte le nombre de voisins directs d’un nœud. Dans notre cas, c’est la popularité immédiate (avec combien de personnages différents a-t-il partagé au moins deux films ?).
- La centralité d’intermédiarité (betweenness) : Elle mesure à quel point un nœud se trouve sur les chemins les plus courts qui relient tous les autres couples de nœuds du réseau. Elle met en valeur les “nœuds ponts”, qui permettent de relier plusieurs parties du réseau entre elles.
- La centralité de proximité (closeness) : Elle calcule l’inverse de la somme des distances de ce nœud à tous les autres. Un nœud avec une forte proximité est structurellement “proche” de tout le monde et peut diffuser une information très rapidement dans le réseau.
- La centralité PageRank : utilisée par le moteur de recherche de Google, cet indicateur estime que l’importance d’un nœud dépend de l’importance de ses voisins. Être connecté à trois nœuds isolés donne moins de poids que d’être connecté à un seul nœud lui-même hyper-central.
Avertissement
Attention, car certaines de ces mesures nécessitent que le graphe soit constitué d’une seule composante connexe (qu’il n’y ait pas de groupes de nœuds complètement séparés). Si ce n’est pas le cas, il est possible d’extraire la composante principale avec le code suivant :
main_graph = graph_characters_red %>%
  mutate(componant = group_components()) %>%
  filter(componant == 1)
4.1 Application
4.1.1 Calculs des centralités
La librairie tidygraph permet de calculer aisément ces indicateurs à l’aide de mutate(), en combinant les fonctions natives du moteur mathématique. Ces mesures sont stockées directement dans un objet de type graphe, dans la partie concernant les nœuds du graphe :
graph_centralities = graph_characters_red %>%
  activate(nodes) %>%
  mutate(
    degree = centrality_degree(),
    betweenness = centrality_betweenness(),
    closeness = centrality_closeness(),
    pagerank = centrality_pagerank()
  )
graph_centralities
# A tbl_graph: 23 nodes and 134 edges
#
# An undirected simple graph with 1 component
#
# Node Data: 23 × 6 (active)
name type_str degree betweenness closeness pagerank
<chr> <chr> <dbl> <dbl> <dbl> <dbl>
1 Luke Skywalker character 10 0.571 0.0294 0.0384
2 C-3PO character 22 33.0 0.0455 0.0797
3 R2-D2 character 22 33.0 0.0455 0.0797
4 Darth Vader character 10 0.571 0.0294 0.0384
5 Leia Organa character 10 0.571 0.0294 0.0384
6 Owen Lars character 4 0 0.025 0.0200
7 Beru Whitesun Lars character 4 0 0.025 0.0200
8 Obi-Wan Kenobi character 22 33.0 0.0455 0.0797
9 Anakin Skywalker character 12 0 0.0312 0.0432
10 Chewbacca character 10 0.571 0.0294 0.0384
# ℹ 13 more rows
#
# Edge Data: 134 × 3
from to weight
<int> <int> <dbl>
1 1 2 4
2 1 3 5
3 1 4 4
# ℹ 131 more rowsOn peut ensuite extraire un classement des nœuds selon la mesure choisie :
# On extrait le tibble des nœuds
centralities_df = graph_centralities %>%
  as_tibble()

# On affiche le classement selon la centralité d'intermédiarité
degree_ranking = centralities_df %>%
  select(name, degree) %>%
  arrange(desc(degree))
degree_ranking
# A tibble: 23 × 2
name degree
<chr> <dbl>
1 C-3PO 22
2 R2-D2 22
3 Obi-Wan Kenobi 22
4 Yoda 17
5 Palpatine 17
6 Anakin Skywalker 12
7 Nute Gunray 12
8 Padmé Amidala 12
9 Ayla Secura 12
10 Mace Windu 12
# ℹ 13 more rows
Note
Si vous regardez l’aide sur les centralités, on peut voir que la plupart de ces mesures possèdent un argument weights, pour prendre en compte les poids des arêtes. Cependant, attention, ces poids peuvent représenter deux quantités opposées : des proximités ou des distances.
Dans notre réseau de personnages, il s’agit de proximités (le nombre de films en commun), et l’on peut construire un poids de type distance en prenant (par exemple) l’inverse de cette quantité :
graph_characters_red = graph_characters_red %>%
  activate(edges)%>%
  mutate(inv_weight = 1/weight)
Certains indices attendent des poids de type proximité (degré, pagerank) et d’autres attendent des poids de type distance (intermédiarité, proximité). Avant d’utiliser une mesure, il faut bien regarder dans l’aide quel type de poids est attendu.
Ainsi, si nous avions voulu nos centralités en version pondérée, il aurait fallu faire :
graph_w_centralities = graph_characters_red %>%
  activate(nodes) %>%
  mutate(
    degree = centrality_degree(weights=weight),
    betweenness = centrality_betweenness(weights=inv_weight),
    closeness = centrality_closeness(weights=inv_weight),
    pagerank = centrality_pagerank(weights=weight)
  )
graph_w_centralities
# A tbl_graph: 23 nodes and 134 edges
#
# An undirected simple graph with 1 component
#
# Node Data: 23 × 6 (active)
name type_str degree betweenness closeness pagerank
<chr> <chr> <dbl> <dbl> <dbl> <dbl>
1 Luke Skywalker character 40 0 0.111 0.0435
2 C-3PO character 80 21.9 0.156 0.0848
3 R2-D2 character 84 71.9 0.162 0.0886
4 Darth Vader character 36 0 0.102 0.0397
5 Leia Organa character 40 0 0.111 0.0435
6 Owen Lars character 12 0 0.0800 0.0186
7 Beru Whitesun Lars character 12 0 0.0800 0.0186
8 Obi-Wan Kenobi character 80 21.9 0.156 0.0848
9 Anakin Skywalker character 36 0 0.0990 0.0395
10 Chewbacca character 40 0 0.111 0.0435
# ℹ 13 more rows
#
# Edge Data: 134 × 4
from to weight inv_weight
<int> <int> <dbl> <dbl>
1 1 2 4 0.25
2 1 3 5 0.2
3 1 4 4 0.25
# ℹ 131 more rowsQue l’on aurait pu explorer en créant le tibble correspondant :
w_centralities_df = graph_w_centralities %>%
  as_tibble()
4.1.2 Représentation graphique
Utilisons maintenant l’indicateur PageRank pour modifier l’esthétique de notre réseau. La taille et la couleur des nœuds refléteront directement ce score d’influence globale.
ggraph(graph_centralities, layout = "fr") +
  geom_edge_link(aes(edge_width = weight), alpha=0.3, color="gray50") +
  # La taille et la couleur des nœuds dépendent de pagerank
  geom_node_point(aes(size = pagerank, color = pagerank)) +
  geom_node_text(aes(label = name), repel = TRUE, size = 3) +
  # Personnalisation des couleurs des nœuds
  scale_color_gradient(low = "lightblue", high = "red3") +
  # Taille maximale et minimale des nœuds
  scale_size(range = c(3, 11)) +
  scale_edge_width(range = c(0.5, 3)) +
  labs(title = "Réseau des personnages de Star Wars") +
  theme_graph() +
  # Suppression de la légende
  theme(legend.position = "none")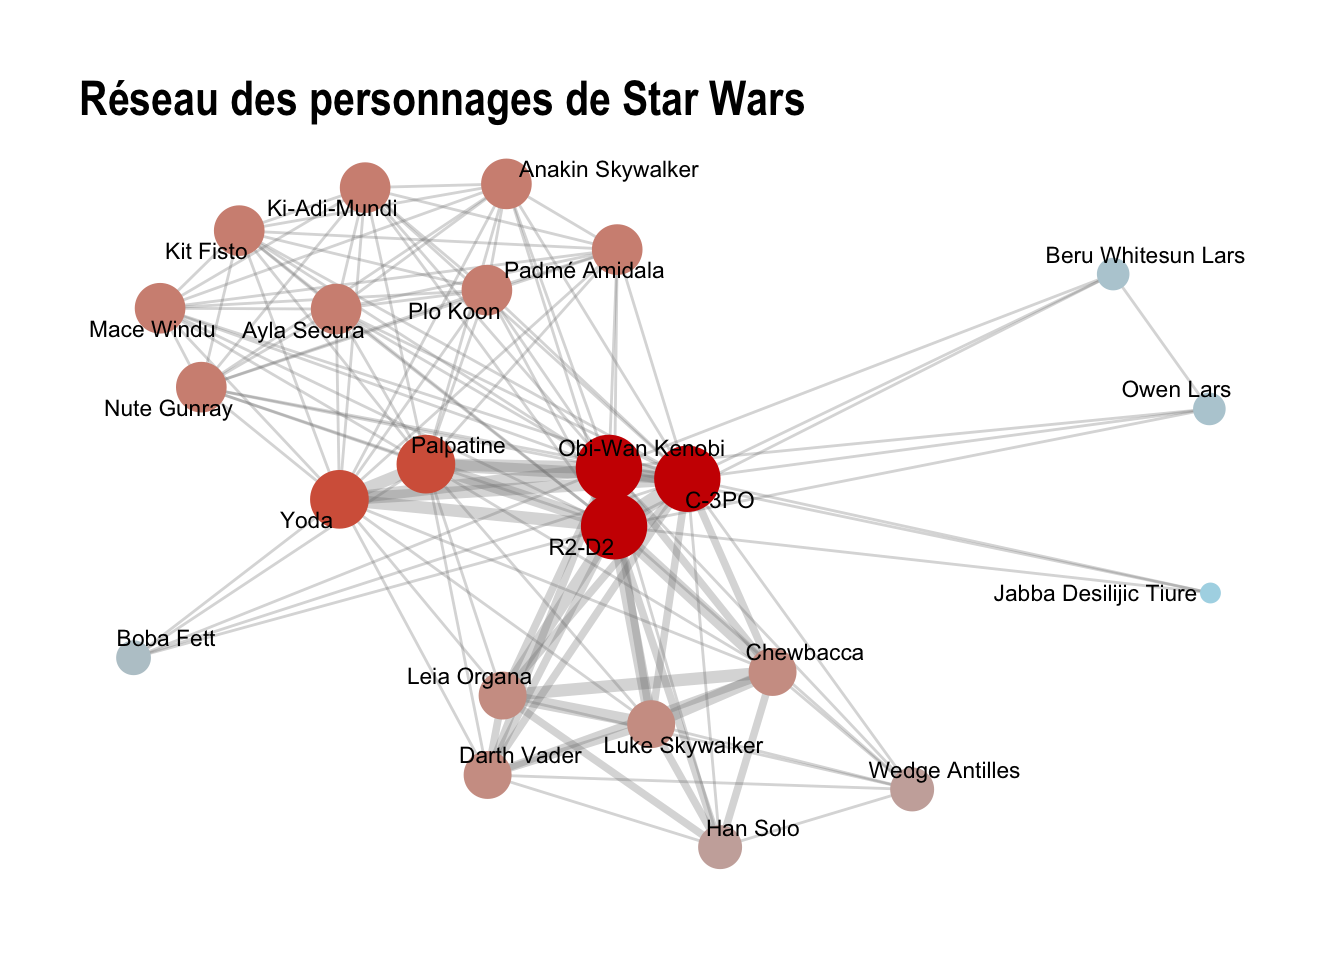
5 Détection de communautés
Un des autres aspects de l’étude de la structure du graphe est de voir s’il existe des groupes naturels parmi les différents nœuds. En théorie des graphes, on appelle ces groupes des communautés. De manière similaire à la variance intra-classe et inter-classes, l’objectif est de regrouper les nœuds de telle sorte qu’il y ait beaucoup de liens à l’intérieur d’un groupe, et très peu de liens entre les groupes.
5.1 La Modularité et la méthode de Louvain
Pour trouver la meilleure partition possible, il faut une fonction objectif à optimiser. Dans les réseaux, ce score s’appelle la Modularité (souvent notée \(Q\)).
Cette dernière compare le nombre de liens à l’intérieur d’un groupe avec le nombre de liens entre les communautés. La modularité prend des valeurs entre -1/2 et 1 :
- Si \(Q\) est proche de -1/2 : Il y a de nombreux liens entre les communautés et peu à l’intérieur de ces dernières.
- Si \(Q\) est proche de 0 : Il y a autant de liens entre les communautés qu’à l’intérieur.
- Si \(Q\) s’approche de 1 : Il y a de nombreux liens dans les communautés et peu entre ces dernières.
Les algorithmes de détection de communautés, comme la méthode de Louvain que nous appliquerons dans la section suivante, vont tester des milliers de combinaisons en déplaçant les nœuds d’un groupe à l’autre, et s’arrêteront lorsqu’ils auront trouvé le score de modularité \(Q\) maximum. Notons que cette méthode, contrairement à la plupart des méthodes de clustering que nous avons vues, ne nécessite pas d’indiquer un nombre de groupes en amont : elle va trouver un nombre optimal de communautés elle-même.
5.2 Application
Appliquons cela au réseau de personnages de Star Wars. Le package tidygraph nous offre plusieurs algorithmes via les fonctions group_*(), comme par exemple group_louvain() pour utiliser la méthode de Louvain. Cette fonction peut s’utiliser comme une mesure de centralité, à l’intérieur de mutate() :
graph_communities = graph_characters_red %>%
  activate(nodes) %>%
  mutate(community = as.factor(group_louvain(weights=weight)), # On utilise les poids (attractions) des arêtes
         pagerank = centrality_pagerank())
graph_communities
# A tbl_graph: 23 nodes and 134 edges
#
# An undirected simple graph with 1 component
#
# Node Data: 23 × 4 (active)
name type_str community pagerank
<chr> <chr> <fct> <dbl>
1 Luke Skywalker character 1 0.0384
2 C-3PO character 1 0.0797
3 R2-D2 character 1 0.0797
4 Darth Vader character 1 0.0384
5 Leia Organa character 1 0.0384
6 Owen Lars character 1 0.0200
7 Beru Whitesun Lars character 1 0.0200
8 Obi-Wan Kenobi character 1 0.0797
9 Anakin Skywalker character 2 0.0432
10 Chewbacca character 1 0.0384
# ℹ 13 more rows
#
# Edge Data: 134 × 4
from to weight inv_weight
<int> <int> <dbl> <dbl>
1 1 2 4 0.25
2 1 3 5 0.2
3 1 4 4 0.25
# ℹ 131 more rowsL’algorithme a séparé notre graphe en 2 communautés. On peut les visualiser sur le graphe que nous avons construit précédemment :
ggraph(graph_communities, layout = "fr") +
  geom_edge_link(aes(edge_width = weight), alpha=0.3, color="gray50") +
  # La taille dépend de pagerank, la couleur par rapport à la communauté
  geom_node_point(aes(size = pagerank, color = community)) +
  geom_node_text(aes(label = name), repel = TRUE, size = 3) +
  scale_size(range = c(3, 11)) +
  scale_edge_width(range = c(0.5, 3)) +
  labs(title = "Réseau des personnages de Star Wars") +
  theme_graph() +
  theme(legend.position = "none")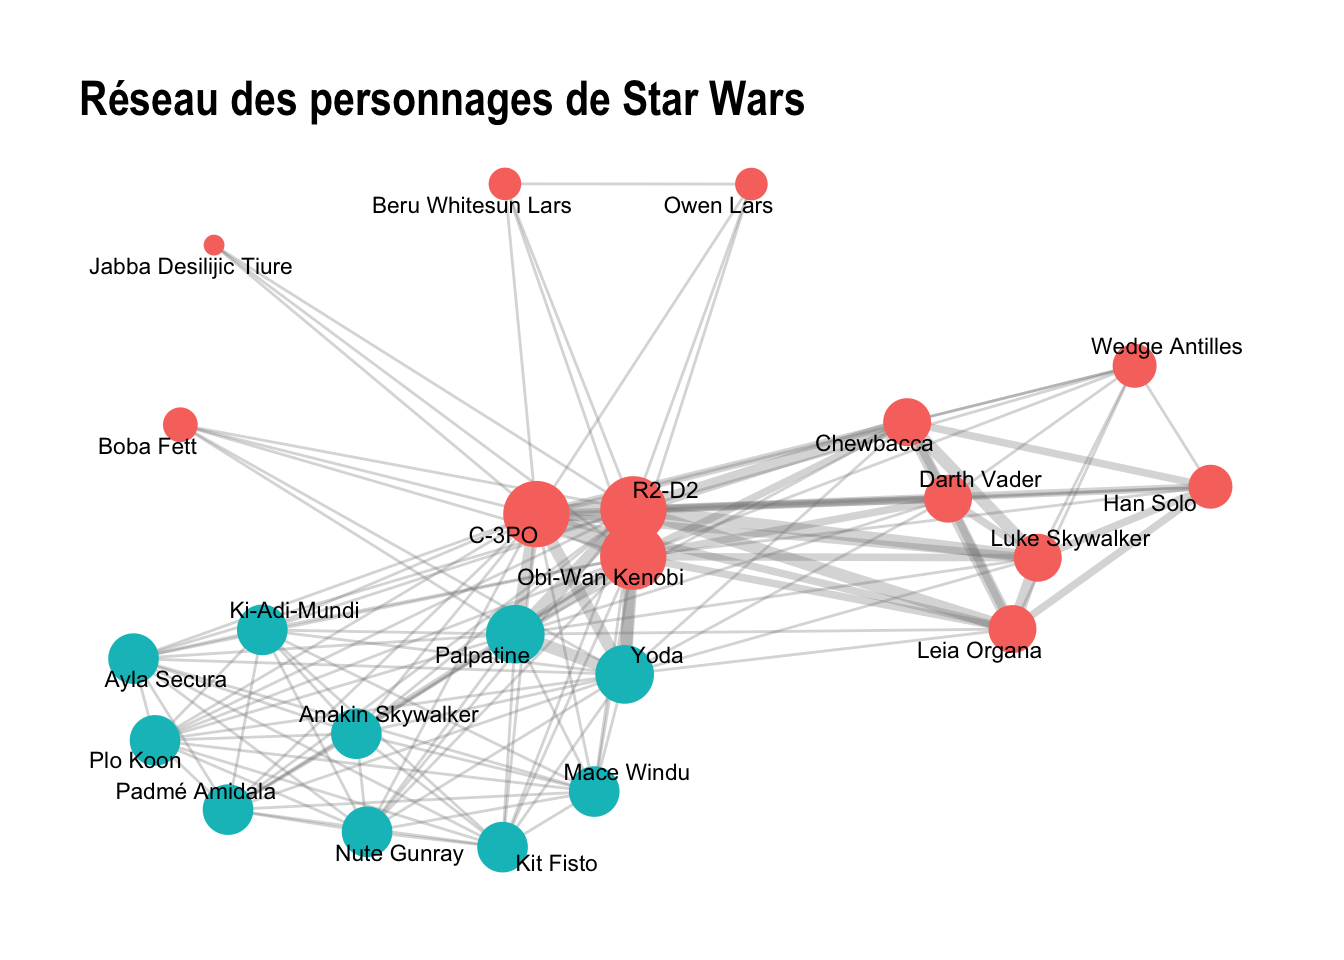
Si vous observez le graphique, l’algorithme a séparé les personnages principalement par rapport à leur appartenance à la génération de films (la prélogie d’un côté, la trilogie originale de l’autre).
Comme la détection de communautés s’apparente fortement à une méthode de clustering sur les nœuds d’un graphe, nous pouvons utiliser les méthodes de comparaison vues dans ce chapitre pour étudier les liens entre ces communautés et des variables initialement présentes dans le jeu de données (tests du chi2 et F-ratio, coefficient AMI, etc.).
6 Les Dissimilarités
Nous avons vu comment créer un graphe à partir d’un jeu de données, mais parfois, il s’avère que les données brutes sont initialement sous la forme d’un réseau (ex: des interactions sur un site web, des échanges de mails). Les méthodes que nous avons entrevues ci-dessus nous permettent d’analyser ce réseau, mais il est possible de vouloir utiliser des méthodes d’analyse de données ou de machine learning plus classiques.
Pour faire le lien entre un réseau et ces méthodes, la solution est souvent la construction d’une matrice de dissimilarité (ou distance). Grâce à cette matrice, nous pourrons alors appliquer de nombreuses méthodes traditionnelles d’analyse de données.
6.1 Les dissimilarités sur un graphe
Il existe plusieurs façons de calculer une dissimilarité entre deux nœuds d’un réseau. Les plus courantes sont les suivantes :
- La distance du plus court chemin ou distance géodésique : C’est la plus intuitive. Combien de sauts (potentiellement pondérés) faut-il faire au minimum pour aller du nœud \(i\) au nœud \(j\) ?
- La distance de marche aléatoire (Random Walk) : Si je me promène au hasard de nœud en nœud, combien de sauts (potentiellement pondérés) me faudra-t-il en moyenne pour atteindre \(j\) depuis \(i\) ?
- La distance structurelle (Jaccard / Cosinus) : Deux nœuds \(i\) et \(j\) sont considérés comme “proches” s’ils partagent les mêmes voisins. Il s’agit en réalité d’un indice de similarité, que l’on peut facilement transformer en dissimilarité.
6.2 Calcul de la distance de plus court chemin
Calculons ici la matrice des distances du plus court chemin. Attention : si le réseau possède plusieurs composantes complètement déconnectées, la distance entre deux nœuds appartenant à des composantes distinctes est “infinie”. Il s’agira alors de remplacer cette valeur par quelque chose de très grand, ou de considérer chaque composante indépendamment les unes des autres. Ce n’est pas le cas dans notre réseau de personnages.
On calcule ces distances avec la fonction distances() de igraph. Nous allons utiliser notre pondération de type “distance” pour calculer la taille des chemins, mais il s’agira pour cela de lui faire prendre le nom de weights :
matrice_distances = graph_characters_red %>%
  activate(edges) %>%
  rename(attr_weight=weight, weight=inv_weight) %>%
  distances()
matrice_distances[1:5, 1:5]
Luke Skywalker C-3PO R2-D2 Darth Vader Leia Organa
Luke Skywalker 0.00 0.2500000 0.2000000 0.25 0.20
C-3PO 0.25 0.0000000 0.1666667 0.25 0.25
R2-D2 0.20 0.1666667 0.0000000 0.25 0.20
Darth Vader 0.25 0.2500000 0.2500000 0.00 0.25
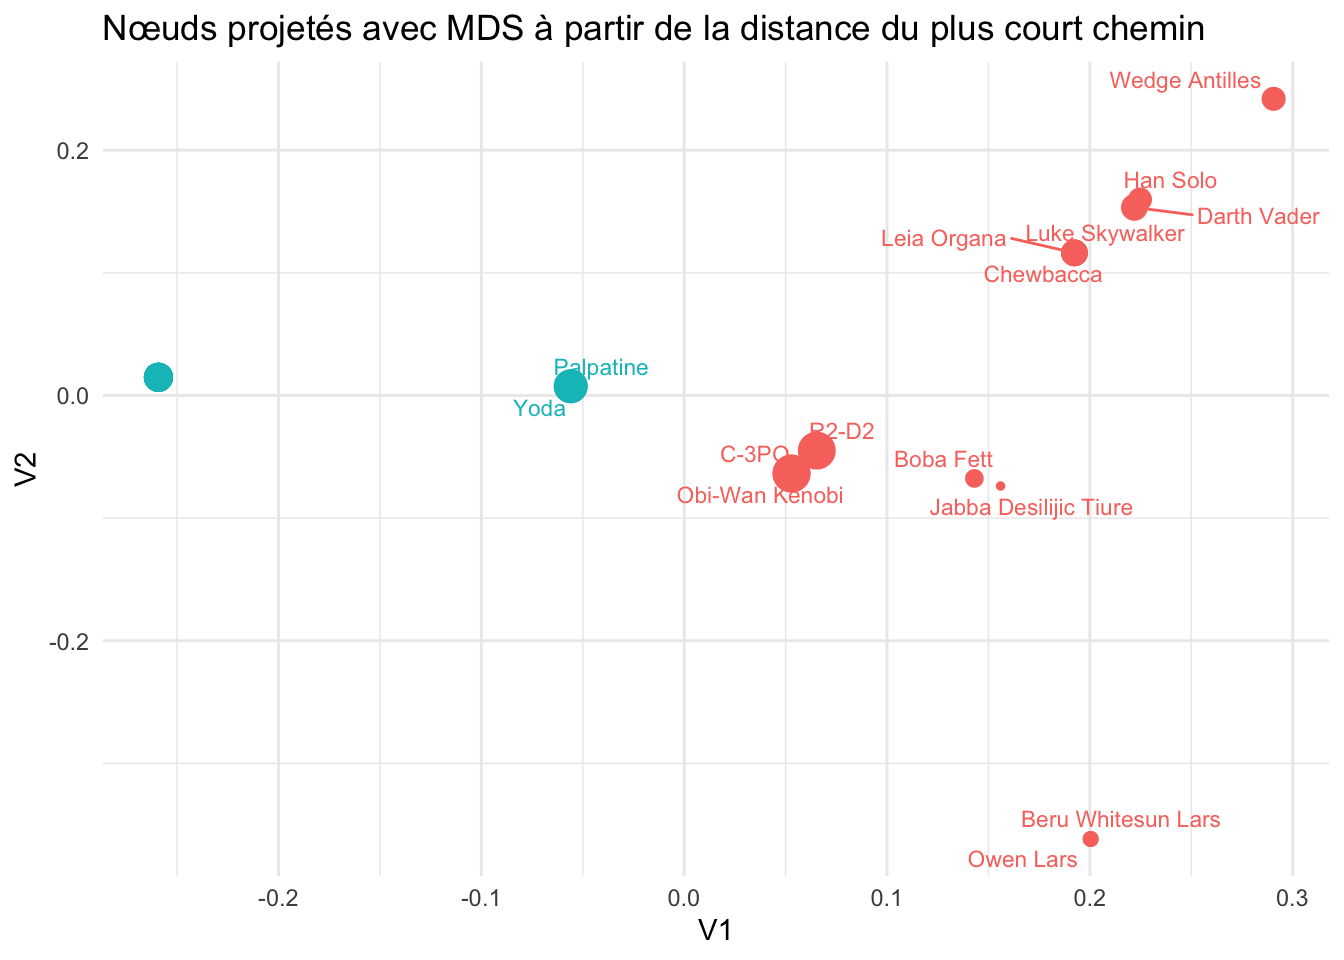
Leia Organa 0.20 0.2500000 0.2000000 0.25 0.00En guise d’exemple, nous pouvons maintenant utiliser le MDS (Multidimensional Scaling) pour représenter nos nœuds dans le plan. On va pour cela utiliser la fonction construite dans le cours précédent et pondérer les nœuds par leur degré :
# La fonction pour le MDS pondéré
weighted_mds = function(dist, weights=NULL, k_max=NULL) {
  n = nrow(dist)
  if (is.null(weights) || length(weights) != n) {
    weights = rep(1, n)
  }
  weights = weights / sum(weights)
  if (is.null(k_max) || k_max > (n-1)) {
    k_max = n-1
  }
  H = diag(n) - matrix(1/n, n, n)
  B = -0.5 * H %*% (dist^2) %*% H
  eigen_B = eigen(B)
  eigen_val = eigen_B$values
  eigen_vec = eigen_B$vectors
  eigen_val[eigen_val < 0] = 0
  coord = eigen_vec[, 1:k_max] %*% diag(sqrt(eigen_val[1:k_max]))
  return(list(eigenvalues=eigen_val, coordinates=coord))
}

# L'extraction des degrés pour les poids
degrees = graph_characters_red %>%
  activate(nodes) %>%
  mutate(degree=centrality_degree()) %>%
  as_tibble() %>%
  pull(degree)

# On fait le MDS pondéré
mds_res = weighted_mds(matrice_distances, weights=degrees)
On peut maintenant afficher notre carte factorielle des nœuds du graphe :
# On crée un dataframe
mds_df = as.data.frame(mds_res$coordinates)

# On ajoute les quantités désirées
mds_df$degree = degrees
mds_df$name = colnames(matrice_distances)
mds_df$community = as_tibble(graph_communities)$community

# On trace les nœuds avec ggplot
ggplot(mds_df, aes(x = V1, y = V2, color = community, size=degree)) +
  geom_point() +
  geom_text_repel(aes(label = name), size = 3, show.legend = FALSE) +
  labs(title = "Nœuds projetés avec MDS à partir de la distance du plus court chemin") +
  theme_minimal() +
  theme(legend.position = "none")