library(tidyverse)
library(caret) # pour la segmentation du jeu de données
library(glmnet) # pour la régression logistique régularisée1 Introduction
Nous allons mettre ici en oeuvre certaines pratiques du Machine Learning en effectuant une régression logistique régularisée. Nous allons utiliser ici le jeu de données heart_disease.csv (venant de https://www.kaggle.com/datasets/dileep070/heart-disease-prediction-using-logistic-regression) qui porte sur le risque de développer une maladie cardiovasculaire chez des patient·es. Plusieurs colonnes décrivent différentes caractéristiques (démographiques, comportementales, médicales) des patient·es, et la variable cible TenYearCHD dit si la personne a développé une maladie cardiovasculaire dans le 10 années qui suivent les mesures (1 pour oui, 0 pour non). Il s’agira donc de prédire cette dernière variable en fonction de (presque) toutes les autres.
Nous allons utiliser ici les packages suivants :
On fixe la graine pour avoir toujours les mêmes résultats :
set.seed(2026)1.1 Les données
On charge maintenant le jeu de données et on élimine les lignes contenant des valeurs manquantes :
df = read_csv("data/heart_disease.csv") %>%
  drop_na()
Rows: 4238 Columns: 16
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
dbl (16): male, age, education, currentSmoker, cigsPerDay, BPMeds, prevalent...
ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.On transforme les variables catégorielles comme telles :
df = df %>%
  mutate_at(vars(male, currentSmoker, BPMeds, prevalentStroke, prevalentHyp, diabetes, TenYearCHD), as.factor)
Observons ces variables :
summary(df) male age education currentSmoker cigsPerDay
0:2034 Min. :32.00 Min. :1.00 0:1868 Min. : 0.000
1:1622 1st Qu.:42.00 1st Qu.:1.00 1:1788 1st Qu.: 0.000
Median :49.00 Median :2.00 Median : 0.000
Mean :49.56 Mean :1.98 Mean : 9.022
3rd Qu.:56.00 3rd Qu.:3.00 3rd Qu.:20.000
Max. :70.00 Max. :4.00 Max. :70.000
BPMeds prevalentStroke prevalentHyp diabetes totChol sysBP
0:3545 0:3635 0:2517 0:3557 Min. :113.0 Min. : 83.5
1: 111 1: 21 1:1139 1: 99 1st Qu.:206.0 1st Qu.:117.0
Median :234.0 Median :128.0
Mean :236.9 Mean :132.4
3rd Qu.:263.2 3rd Qu.:144.0
Max. :600.0 Max. :295.0
diaBP BMI heartRate glucose TenYearCHD
Min. : 48.00 Min. :15.54 Min. : 44.00 Min. : 40.00 0:3099
1st Qu.: 75.00 1st Qu.:23.08 1st Qu.: 68.00 1st Qu.: 71.00 1: 557
Median : 82.00 Median :25.38 Median : 75.00 Median : 78.00
Mean : 82.91 Mean :25.78 Mean : 75.73 Mean : 81.86
3rd Qu.: 90.00 3rd Qu.:28.04 3rd Qu.: 82.00 3rd Qu.: 87.00
Max. :142.50 Max. :56.80 Max. :143.00 Max. :394.00 On voit que, malheureusement, les variables BPMeds, prevalentStroke et diabetes sont fortement déséquilibrées dans ce jeu de données. Idéalement, il faudrait les stratifier pour qu’elles ne manquent pas dans tous les folds testés, mais le peu de mesures fait que c’est difficile à réaliser.
Nous avons donc un jeu de données avec 3656 individus et 16 variables (15 variables indépendantes et 1 variable dépendante).
df# A tibble: 3,656 × 16
male age education currentSmoker cigsPerDay BPMeds prevalentStroke
<fct> <dbl> <dbl> <fct> <dbl> <fct> <fct>
1 1 39 4 0 0 0 0
2 0 46 2 0 0 0 0
3 1 48 1 1 20 0 0
4 0 61 3 1 30 0 0
5 0 46 3 1 23 0 0
6 0 43 2 0 0 0 0
7 0 63 1 0 0 0 0
8 0 45 2 1 20 0 0
9 1 52 1 0 0 0 0
10 1 43 1 1 30 0 0
# ℹ 3,646 more rows
# ℹ 9 more variables: prevalentHyp <fct>, diabetes <fct>, totChol <dbl>,
# sysBP <dbl>, diaBP <dbl>, BMI <dbl>, heartRate <dbl>, glucose <dbl>,
# TenYearCHD <fct>1.2 Création du jeu d’entraînement-validation et du jeu de test
Nous allons nous occuper ici de construire le jeu d’entraînement et validation (qui va servir à la cross-validation) et le jeu de test. Le package caret est très utile pour cela, car il permet de construire des partitions respectant une certaine stratification. En l’occurrence, il est préférable que les proportions de 0 et de 1 dans la variable cible soient identiques dans les deux jeux de données.
On construit donc nos indices pour le jeu de test (de taille 20%) avec la fonction createDataPartition(). Le premier argument de la fonction prends la variable que l’on cherche à stratifier :
test_idx = createDataPartition(df$TenYearCHD, p=0.2)$Resample1
head(test_idx, 20)
[1] 6 10 18 36 41 46 71 77 79 94 95 109 120 123 132 150 167 168 174
[20] 179Puis, on crée nos jeux de test et d’entraînement-validation:
df_test = df[test_idx, ]
df_train = df[-test_idx, ]
On vérifie les dimensions pour s’assurer que les jeux font à peu près la bonne taille :
dim(df_test)[1] 732 16dim(df_train)[1] 2924 16Et que les proportions de 1 et de 0 pour TenYearCHD soient correctes dans les deux jeux :
mean(as.numeric(df_test$TenYearCHD))[1] 1.153005mean(as.numeric(df_train$TenYearCHD))[1] 1.1521892 La régression logistique régularisée
Avant de lancer la procédure de cross-validation, nous allons tester la méthode de regression logistique régularisée sur notre jeu d’entraînement en entier. Cela nous permettra également de voir comment calculer les différentes mesures sur les résultat de cette dernière.
Pour effectuer cette régression logistique régularisée, on utilse la fonction glmnet() du package glmnet. Voici les arguments les plus importants pour cette fonction :
- Le premier argument (
x) doit contenir les variables d’entrées. - Le deuxième argument (
y) doit contenir la variable binaire que l’on cherche à prédire. - L’argument
familyprécise quel type de régression utiliser. Pour faire de la régression logistique binaire, on précisefamily="binomial". - L’argument
lambdaest la paramètre de régularisation. Plus celui-ci est élevé, plus la régularisation est forte. - L’argument
alpha(entre 0 et 1) précise si il faut utiliser la régularisation de Lasso (alpha=1, valeur par défaut) ou Ridge (alpha=0). Des valeurs intermédiaires réalise une mixture des deux régularisations (appelée aussi elasticnet).
Avant toutes choses, on commence par transfomer nos entrées en version compatible avec glmnet() à l’aide de makeX() :
input_train = makeX(df_train %>% select(-TenYearCHD))Puis on effectue une régression logistique binaire avec régularisation de Lasso, avec un lambda de 0.01 :
glm_res = glmnet(input_train,
                 df_train$TenYearCHD,
                 family="binomial",
                 lambda=0.01)
Cette fonction nous donne de nombreux retour (pour les voir names(glm_res)), comme par exemple les coefficients de régression résultant :
glm_res$beta21 x 1 sparse Matrix of class "dgCMatrix"
s0
male0 -3.400385e-01
male1 .
age 5.533827e-02
education .
currentSmoker0 .
currentSmoker1 .
cigsPerDay 1.014080e-02
BPMeds0 .
BPMeds1 .
prevalentStroke0 -1.815476e-01
prevalentStroke1 1.410868e-14
prevalentHyp0 -1.082836e-01
prevalentHyp1 3.081669e-02
diabetes0 .
diabetes1 .
totChol 7.392367e-04
sysBP 1.261535e-02
diaBP .
BMI .
heartRate .
glucose 4.841896e-03On voit que certains coefficients ont été mis à zéro, ce qui est une propriété de la régularisation de type Lasso.
On va maintenant s’intéresser à faire des prédictions sur le jeu de test, qui s’obtiennent avec predict() (l’argument type="class" nous donne les classes, et non pas les odd-logs) :
input_test = makeX(df_test %>% select(-TenYearCHD))
predict_test = factor(predict(glm_res, input_test, type="class"),
                      levels=c(0, 1))
On peut alors comparer ces classes avec nos vrais valeurs, selon l’exactitude, la précision, le rappel et le F1 (avec des fonctions contenues dans le package caret) :
mean(predict_test == df_test$TenYearCHD) # On teste où les vecteurs sont égaux. [1] 0.8469945precision(predict_test, df_test$TenYearCHD, relevant="1")[1] 0.5recall(predict_test, df_test$TenYearCHD, relevant="1")[1] 0.008928571F_meas(predict_test, df_test$TenYearCHD, relevant="1")[1] 0.01754386Ici, nous avons directement utilisé la valeur de lambda=0.01, regardons dans la partie suivante si nous pouvons trouver un meilleur lambda pour optimiser ces différentes mesures.
3 La cross-validation
Nous allons donc faire une cross-validation à 5 folds pour voir si nous pouvons trouver les meilleures valeurs de lambda pour chaque mesure. Cette optimisation va s’effectuer sur le jeu d’entraînement-validation, pour ensuite voir ce que sont ces mesures sur le jeu de test.
On commence par attribuer nos folds sur le jeu d’entraînement-validation, en faisant attention de bien stratifier :
folds_list = createFolds(df_train$TenYearCHD, k=5)La réponse est une liste de 5 éléments, chacun contenant les indices des individus appartenant à ce fold.
On définit maintenant toutes les valeurs de lambda que nous volons tester (il faut parfois faire quelques essais-erreurs pour trouver des valeurs qui donnent des résultats convaincants) :
lambda_vec = seq(0, 0.02, 0.0001) # Toutes les valeurs de 0 à 0.05 avec un pas de 0.001On prépare une liste contenant des matrices pour stocker les différents résultats
results_list = list(accuracy=matrix(NA, nrow=length(lambda_vec), ncol=length(folds_list)),
                    precision=matrix(NA, nrow=length(lambda_vec), ncol=length(folds_list)),
                    recall=matrix(NA, nrow=length(lambda_vec), ncol=length(folds_list)),
                    F1=matrix(NA, nrow=length(lambda_vec), ncol=length(folds_list)))
On peut maintenant faire la boucle sur les différentes valeurs de lambda et les différents folds :
for(id_lambda in 1:length(lambda_vec)){
  for(id_fold in 1:length(folds_list)){
    # On récupère les indices de ce fold
    fold_idx = folds_list[[id_fold]]

    # On construit les jeux d'entraînement et de validation pour ce fold
    df_train_fold = df_train[-fold_idx, ]
    df_valid_fold = df_train[fold_idx, ]

    # On effectue la régression logistique régularisée sur le jeu d'entraînement de ce fold
    input_train_fold = makeX(df_train_fold %>% select(-TenYearCHD))
    glm_res_fold = glmnet(input_train_fold,
                          df_train_fold$TenYearCHD,
                          family="binomial",
                          lambda=lambda_vec[id_lambda])

    # On fait des prédictions sur le jeu de validation de ce fold
    input_valid = makeX(df_valid_fold %>% select(-TenYearCHD))
    predict_valid_fold = factor(predict(glm_res_fold, input_valid, type="class"),
                                levels=c(0, 1))

    # On calcule les différentes mesures et on les stocke dans la matrice correspondante
    accuracy = mean(predict_valid_fold == df_valid_fold$TenYearCHD)
    precision = precision(predict_valid_fold, df_valid_fold$TenYearCHD, relevant="1")
    recall = recall(predict_valid_fold, df_valid_fold$TenYearCHD, relevant="1")
    F1 = F_meas(predict_valid_fold, df_valid_fold$TenYearCHD, relevant="1")


    results_list$accuracy[id_lambda, id_fold] = accuracy
    results_list$precision[id_lambda, id_fold] = precision
    results_list$recall[id_lambda, id_fold] = recall
    results_list$F1[id_lambda, id_fold] = F1
  }
}
On va maintenant calculer la moyenne de chaque mesure pour chaque valeur de lambda :
mean_results = lapply(results_list, rowMeans, na.rm = TRUE)On transforme cette liste de vecteurs en un data frame pour pouvoir faire des graphiques :
mean_results_df = as.data.frame(mean_results)
mean_results_df$lambda = lambda_vec
as_tibble(mean_results_df)
# A tibble: 201 × 5
accuracy precision recall F1 lambda
<dbl> <dbl> <dbl> <dbl> <dbl>
1 0.853 0.614 0.0787 0.138 0
2 0.852 0.610 0.0764 0.135 0.0001
3 0.852 0.618 0.0764 0.135 0.0002
4 0.852 0.618 0.0764 0.135 0.0003
5 0.852 0.618 0.0764 0.135 0.0004
6 0.852 0.618 0.0764 0.135 0.0005
7 0.852 0.598 0.0742 0.131 0.0006
8 0.852 0.598 0.0742 0.131 0.0007
9 0.852 0.604 0.0742 0.131 0.0008
10 0.852 0.591 0.0719 0.127 0.0009
# ℹ 191 more rowsEt on affiche les graphiques :
mean_results_df %>%
  pivot_longer(cols=-lambda, names_to="measure", values_to="value") %>%
  ggplot(aes(x=lambda, y=value)) +
  geom_line() +
  facet_wrap(~measure, scales="free_y")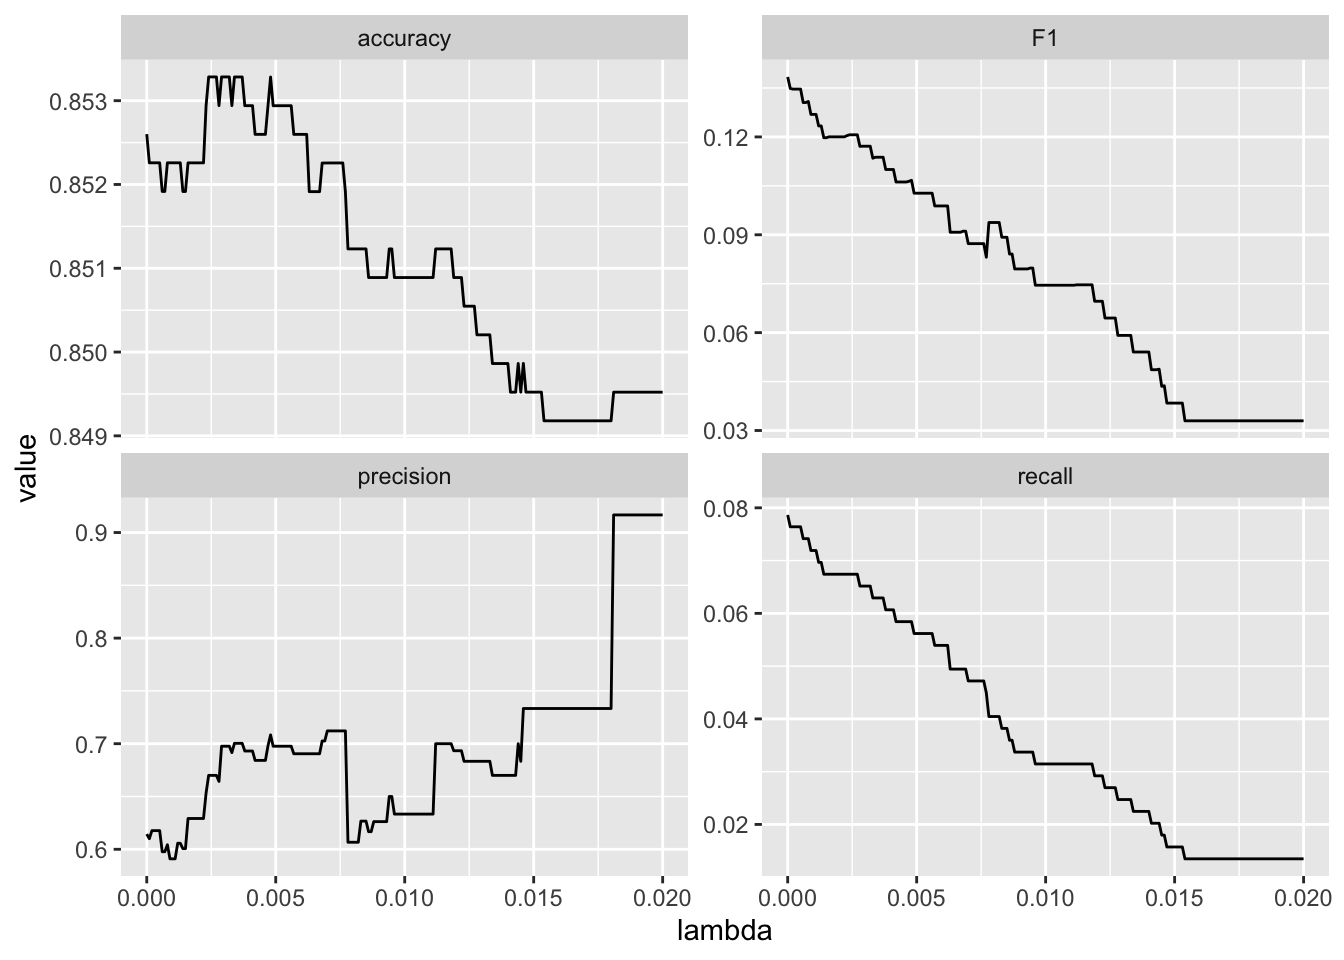
On voit que la précision et le F1 sont parfois inexistant. Cela arrive lorsque notre algorithme ne classe aucun point comme des 1, il est alors impossible de calculer la précision et le F1.
Note
Dans une réelle application, on va plutôt utiliser la fonction cv.glmnet(), qui s’occupe intégralement de la cross-validation. Regardez l’aide pour l’utiliser.
4 Le “meilleur modèle”
Capturons les valeurs de lambda où le rappel est maximal, car notre intérêt est de capturer au maximum les personnes présentant un risque. On classe le jeu de données selon les différentes mesures par ordre de priorité :
mean_results_df %>%
  arrange(desc(recall), desc(precision), desc(F1), desc(accuracy)) %>%
  head(10)
accuracy precision recall F1 lambda
1 0.8526010 0.6144048 0.07865169 0.1383933 0e+00
2 0.8522585 0.6176772 0.07640449 0.1346606 2e-04
3 0.8522585 0.6176772 0.07640449 0.1346606 3e-04
4 0.8522585 0.6176772 0.07640449 0.1346606 4e-04
5 0.8522585 0.6176772 0.07640449 0.1346606 5e-04
6 0.8522585 0.6100092 0.07640449 0.1348525 1e-04
7 0.8522585 0.6042949 0.07415730 0.1308631 8e-04
8 0.8519166 0.5976772 0.07415730 0.1305396 6e-04
9 0.8519166 0.5976772 0.07415730 0.1305396 7e-04
10 0.8522585 0.5909615 0.07191011 0.1269060 9e-04La valeur lambda=0.0005 semble donner de bons résultats équilibrés (c’est très relatif). On va maintenant entraîner ce modèle sur tout le jeu d’entraînement :
glm_best_res = glmnet(input_train,
                      df_train$TenYearCHD,
                      family="binomial",
                      lambda=0.0005)
predict_test = factor(predict(glm_best_res, input_test, type="class"),
levels=c(0, 1))
mean(predict_test == df_test$TenYearCHD)[1] 0.8538251precision(predict_test, df_test$TenYearCHD, relevant="1")[1] 0.7777778recall(predict_test, df_test$TenYearCHD, relevant="1")[1] 0.0625F_meas(predict_test, df_test$TenYearCHD, relevant="1")[1] 0.1157025Le rappel reste malheureusement très médiocre. Pour finir, regardons quelles variables ont été utilisées :
glm_best_res$beta21 x 1 sparse Matrix of class "dgCMatrix"
s0
male0 -5.079851e-01
male1 .
age 6.201731e-02
education -5.748881e-02
currentSmoker0 -4.695605e-02
currentSmoker1 .
cigsPerDay 1.544342e-02
BPMeds0 -1.942817e-03
BPMeds1 5.996268e-15
prevalentStroke0 -7.053044e-01
prevalentStroke1 3.150973e-13
prevalentHyp0 -1.894822e-01
prevalentHyp1 3.463048e-02
diabetes0 -6.436081e-02
diabetes1 2.144174e-14
totChol 2.525594e-03
sysBP 1.582116e-02
diaBP -5.906920e-03
BMI 6.986211e-03
heartRate -2.954879e-03
glucose 6.725591e-03A ce niveau de faible régularisation, presque aucune variable n’a été mise de côté.