library(tidyverse)
library(FactoMineR)
library(factoextra)
library(psych)1 Introduction
Nous avons déjà exploré les méthodes factorielles avec l’Analyse en Composantes Principales (ACP), le Positionnement Multidimensionnel (MDS) et l’Analyse Factorielle des Correspondances (AFC). Seulement, ces outils s’appliquent à des données plutôt simples. Pour analyser des jeux de données plus complexes, nous allons devoir mobiliser des méthodes factorielles plus avancées. Nous allons voir ici :
L’Analyse des Correspondances Multiples (ACM), qui permet d’analyser des données composées de plusieurs variables qualitatives. C’est une extension directe de l’AFC, mais qui s’applique sur des données constituées de plus de 2 variables catégorielles.
L’Analyse Factorielle Multiple (AFM), qui traite de tableaux de données où les variables sont structurées en groupes thématiques. Elle traite chaque groupe de variable séparément (via des ACP et des ACM) puis les combine pour obtenir une analyse globale. Sa force est de pouvoir traiter des variables catégorielles et numériques ensemble et d’équilibrer l’influence de chaque groupe : un bloc de 50 variables compte autant qu’un groupe de 3 variables. Elle est souvent utilisée pour analyser des questionnaires structurés par thématiques.
Nous utiliserons à nouveau le package FactoMineR pour les calculs, ainsi que factoextra pour les visualisations. Le package psych nous servira au calcul d’un indice, le alpha de Cronbach, permettant de valider la cohérence de nos groupes dans l’AFM :
2 L’Analyse des Correspondances Multiples (ACM)
L’ACM s’applique sur des données contenant uniquement des variables catégorielles. La première étape consiste à transformer ce jeu de données en tableau disjonctif complet, en recodant les variables catégorielles avec des dummies :
| Individu | Genre | Transport |
|---|---|---|
| P1 | Homme | Vélo |
| P2 | Femme | Voiture |
| P3 | Homme | Bus |
| Individu | Femme | Homme | Bus | Vélo | Voiture |
|---|---|---|---|---|---|
| P1 | 0 | 1 | 0 | 1 | 0 |
| P2 | 1 | 0 | 0 | 0 | 1 |
| P3 | 0 | 1 | 1 | 0 | 0 |
L’ACM n’est ensuite rien d’autre qu’une AFC appliquée sur ce tableau disjonctif complet. Ce tableau est donc considéré comme une table de contingence individus \(\times\) modalités. Cette approche a plusieurs conséquences :
- Biplot individus-modalités : Contrairement à l’AFC qui croise deux variables, l’ACM permet de projeter les individus avec les modalités. On peut ainsi voir les attractions entre individus et modalités.
- Calculs sur les variables : On peut calculer des quantités sur un groupe de modalités faisant partie d’une même variable, permettant ainsi de comprendre l’effet global d’une variable.
- Poids des variables : Les variables possédant plus de modalités ont une inertie plus forte. Il est donc parfois nécessaire de regrouper les modalités avant l’analyse, pour avoir des variables avec un nombre de modalités équivalent.
Nous allons voir tous ces concepts plus en détails avec la pratique.
2.1 Chargement des données et pré-traitements
Nous allons utiliser ici le jeu de données obesity_risk.csv, issu de l’UCI (https://archive-beta.ics.uci.edu/dataset/544). Il concerne l’estimation des niveaux d’obésité basés sur les habitudes alimentaires et la condition physique. Il est composé de nombreuses variables catégorielles (dont la signification est donnée sur le site de l’UCI) :
obesity_risk_df = read_csv("data/obesity_risk.csv")Rows: 2111 Columns: 17
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
chr (9): Gender, family_history_with_overweight, FAVC, CAEC, SMOKE, SCC, CAL...
dbl (8): Age, Height, Weight, FCVC, NCP, CH2O, FAF, TUE
ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.obesity_risk_df# A tibble: 2,111 × 17
Gender Age Height Weight family_history_with_over…¹ FAVC FCVC NCP CAEC
<chr> <dbl> <dbl> <dbl> <chr> <chr> <dbl> <dbl> <chr>
1 Female 21 1.62 64 yes no 2 3 Some…
2 Female 21 1.52 56 yes no 3 3 Some…
3 Male 23 1.8 77 yes no 2 3 Some…
4 Male 27 1.8 87 no no 3 3 Some…
5 Male 22 1.78 89.8 no no 2 1 Some…
6 Male 29 1.62 53 no yes 2 3 Some…
7 Female 23 1.5 55 yes yes 3 3 Some…
8 Male 22 1.64 53 no no 2 3 Some…
9 Male 24 1.78 64 yes yes 3 3 Some…
10 Male 22 1.72 68 yes yes 2 3 Some…
# ℹ 2,101 more rows
# ℹ abbreviated name: ¹family_history_with_overweight
# ℹ 8 more variables: SMOKE <chr>, CH2O <dbl>, SCC <chr>, FAF <dbl>, TUE <dbl>,
# CALC <chr>, MTRANS <chr>, NObeyesdad <chr>Nous allons isoler les variables catégorielles de ce jeu de données et les transformer en facteurs. Le jeu de données initial, contenant les variables numériques, va cependant nous servir plus tard pour distinguer les individus :
mca_df = obesity_risk_df %>%
  select(where(is.character)) %>%
  mutate_all(as.factor)
On peut voir un aperçu de ces variables qui vont servir à l’analyse :
summary(mca_df) Gender family_history_with_overweight FAVC CAEC
Female:1043 no : 385 no : 245 Always : 53
Male :1068 yes:1726 yes:1866 Frequently: 242
no : 51
Sometimes :1765
SMOKE SCC CALC MTRANS
no :2067 no :2015 Always : 1 Automobile : 457
yes: 44 yes: 96 Frequently: 70 Bike : 7
no : 639 Motorbike : 11
Sometimes :1401 Public_Transportation:1580
Walking : 56
NObeyesdad
Insufficient_Weight:272
Normal_Weight :287
Obesity_Type_I :351
Obesity_Type_II :297
Obesity_Type_III :324
Overweight_Level_I :290
Overweight_Level_II:290 2.2 Effectuer l’ACM
Pour effectuer l’ACM, on utilise la fonction ACM() :
mca_res = MCA(mca_df, graph=FALSE)Comme avec toutes les fonctions de FactoMineR, le résultat de cette fonction contient un grand nombre d’informations :
mca_res**Results of the Multiple Correspondence Analysis (MCA)**
The analysis was performed on 2111 individuals, described by 9 variables
*The results are available in the following objects:
name description
1 "$eig" "eigenvalues"
2 "$var" "results for the variables"
3 "$var$coord" "coord. of the categories"
4 "$var$cos2" "cos2 for the categories"
5 "$var$contrib" "contributions of the categories"
6 "$var$v.test" "v-test for the categories"
7 "$var$eta2" "coord. of variables"
8 "$ind" "results for the individuals"
9 "$ind$coord" "coord. for the individuals"
10 "$ind$cos2" "cos2 for the individuals"
11 "$ind$contrib" "contributions of the individuals"
12 "$call" "intermediate results"
13 "$call$marge.col" "weights of columns"
14 "$call$marge.li" "weights of rows" On voit qu’il y a quelques nouveaux résultats que nous explorerons plus loin. On y trouve aussi le fameux tableau disjonctif complet ayant servi à l’analyse :
as_tibble(mca_res$call$Xtot)# A tibble: 2,111 × 30
Female Male family_history_with_ov…¹ family_history_with_…² FAVC_no FAVC_yes
<int> <int> <int> <int> <int> <int>
1 1 0 0 1 1 0
2 1 0 0 1 1 0
3 0 1 0 1 1 0
4 0 1 1 0 1 0
5 0 1 1 0 1 0
6 0 1 1 0 0 1
7 1 0 0 1 0 1
8 0 1 1 0 1 0
9 0 1 0 1 0 1
10 0 1 0 1 0 1
# ℹ 2,101 more rows
# ℹ abbreviated names: ¹family_history_with_overweight_no,
# ²family_history_with_overweight_yes
# ℹ 24 more variables: CAEC_Always <int>, CAEC_Frequently <int>, CAEC_no <int>,
# CAEC_Sometimes <int>, SMOKE_no <int>, SMOKE_yes <int>, SCC_no <int>,
# SCC_yes <int>, CALC_Always <int>, CALC_Frequently <int>, CALC_no <int>,
# CALC_Sometimes <int>, Automobile <int>, Bike <int>, Motorbike <int>, …Comme pour toutes les méthodes factorielles, nous pouvons afficher la compression d’informations effectuée via le screeplot :
fviz_eig(mca_res, ncp=20, addlabels=TRUE)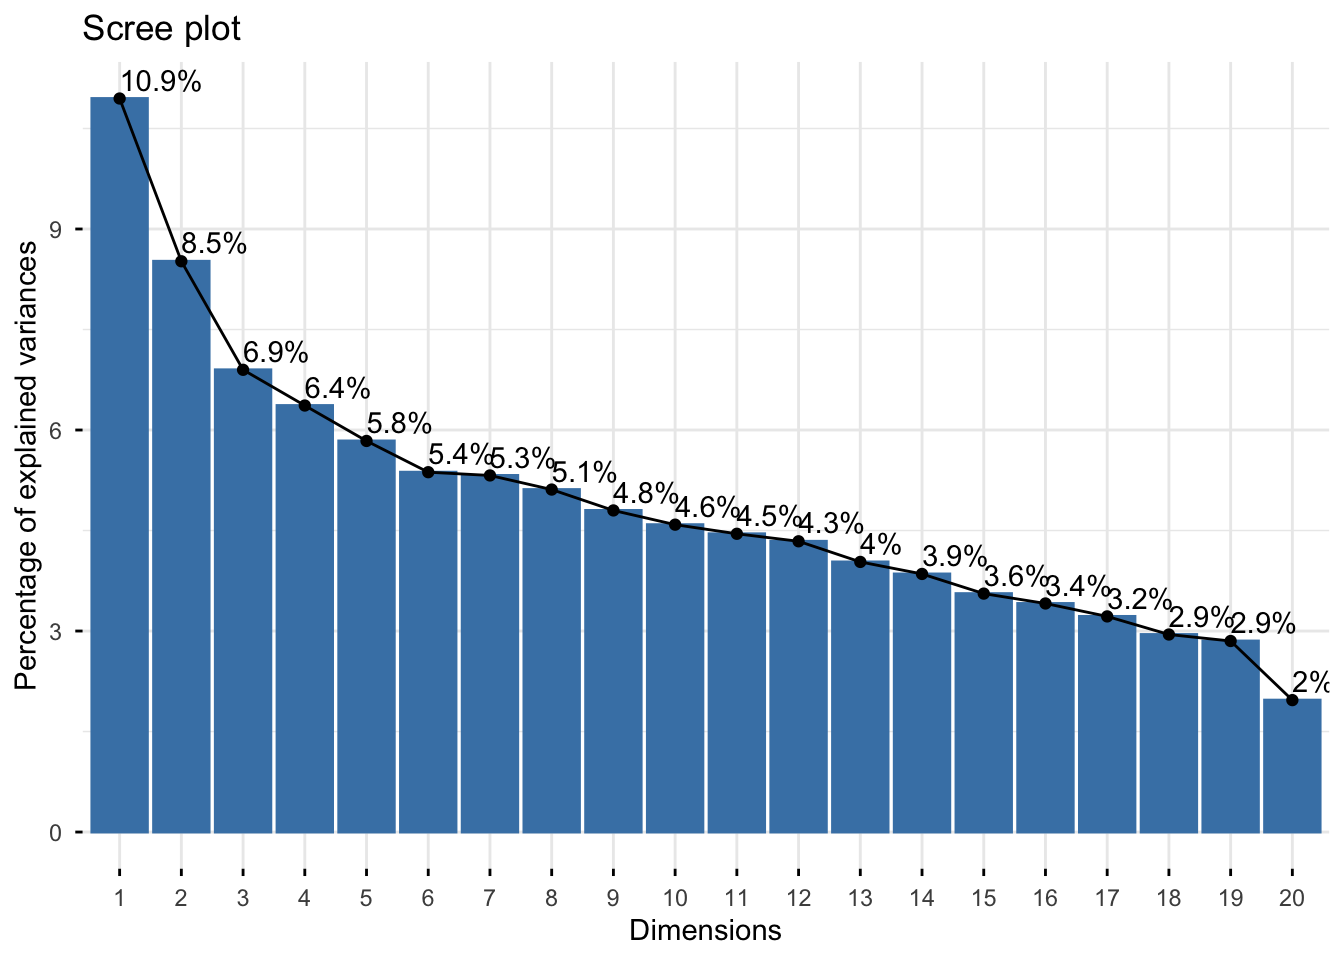
Avec ACM, les pourcentages de variance expliquée sont fréquemment faibles (au vu de la structure disjonctive). Avec 10-15% d’inertie exprimée sur un axe, c’est déjà le signe d’une structure latente forte.
2.3 Les individus, les modalités et les variables
Comme l’ACM est en réalité une AFC sur le tableau individus-modalités, on peut afficher le biplot :
fviz_mca_biplot(mca_res)
Il y a cependant ici trop d’individus, qui sont en plus anonymes. Ce n’est donc pas très utile.
Un des graphiques les plus fondamentaux est en général l’espace des modalités, qui s’obtient avec fviz_mca_var() :
fviz_mca_var(mca_res, repel=TRUE)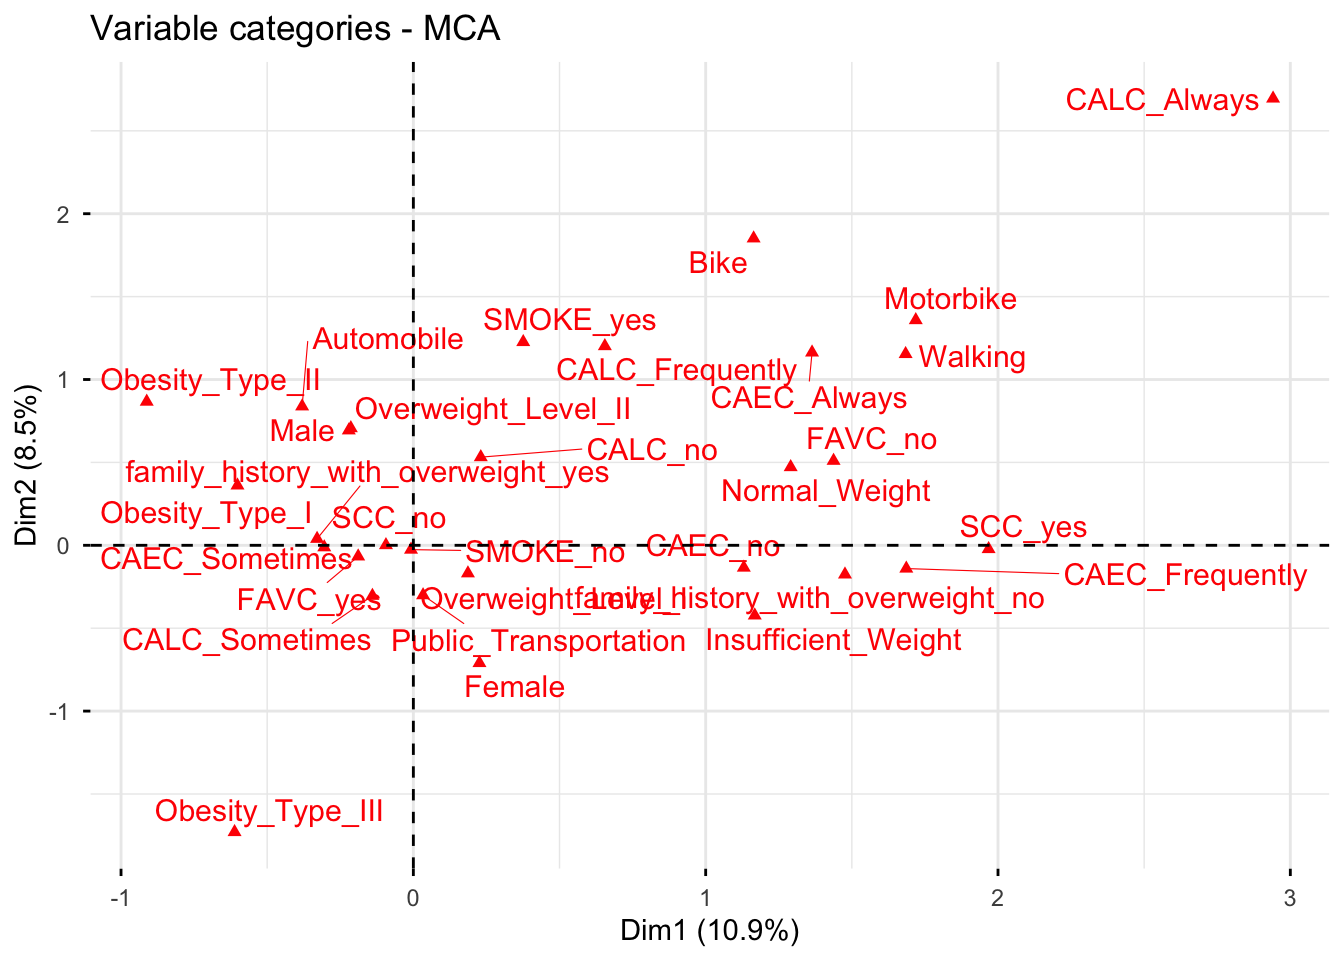
Il est généralement bienvenu ici de colorer les différentes modalités selon les variables dont elles sont issues. Il n’existe pas de méthode directe pour y arriver, et il nous faut construire un vecteur qui contient toutes les appartenances des modalités.
On commence donc par construire le tableau croisé avec toutes les modalités afin d’extraire le nombre de modalités par variable :
cross_tab = table(mca_df)
nb_mods = dim(cross_tab)
Puis on construit un vecteur contenant le nom des variables répétées par le nombre de modalités :
mod_var = as.factor(rep(names(mca_df), nb_mods))
mod_var
[1] Gender Gender
[3] family_history_with_overweight family_history_with_overweight
[5] FAVC FAVC
[7] CAEC CAEC
[9] CAEC CAEC
[11] SMOKE SMOKE
[13] SCC SCC
[15] CALC CALC
[17] CALC CALC
[19] MTRANS MTRANS
[21] MTRANS MTRANS
[23] MTRANS NObeyesdad
[25] NObeyesdad NObeyesdad
[27] NObeyesdad NObeyesdad
[29] NObeyesdad NObeyesdad
9 Levels: CAEC CALC family_history_with_overweight FAVC Gender ... SMOKEOn peut ainsi construire le tableau des modalités colorées par variables :
fviz_mca_var(mca_res,
             repel = TRUE,
             col.var = mod_var,
             mean.point = FALSE,
             legend.title = "Variables")
Ignoring unknown labels:
• fill : "Variables"
• linetype : "Variables"
• shape : "Variables"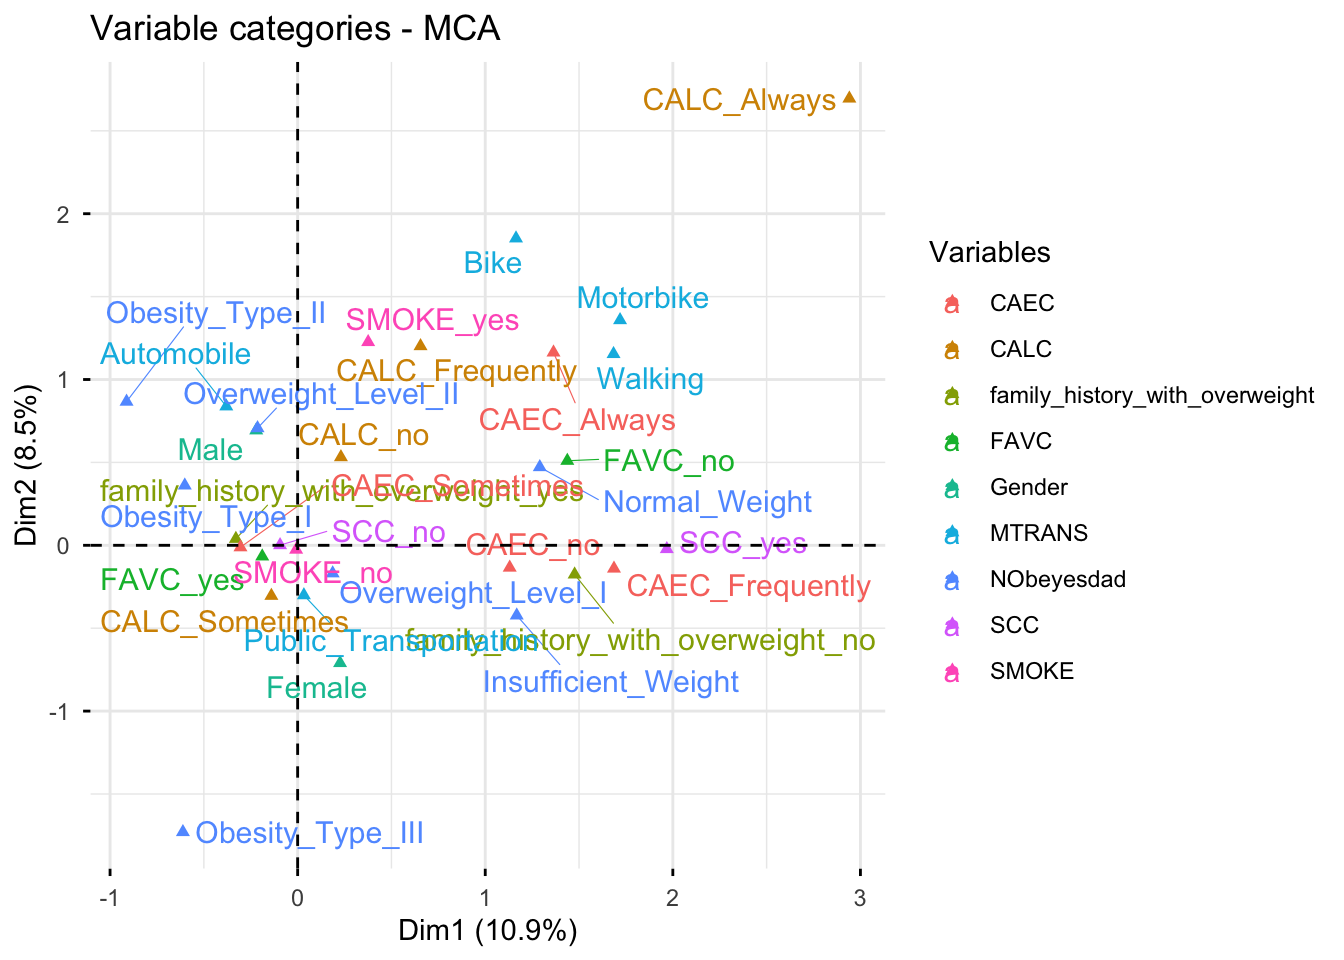
L’interprétation est ici similaire à l’AFC :
- Si deux modalités sont proches, cela signifie qu’elles apparaissent souvent ensemble.
- Plus une modalité est loin du centre, plus elle est rare et discriminante. Les modalités banales sont au centre.
- Le centre (pondéré) pour chaque groupe de modalités est l’origine (l’affichage des centres non-pondérés a été désactivé avec
mean.point = FALSE).
2.4 Les quantités dérivées
Comme avec une ACP ou une AFC, nous pouvons observer les contributions et les cos2 (qualité de la représentation) pour les individus ou les modalités par rapport à des axes :
# Les contributions des modalités à la formation des axes 1 et 2
fviz_contrib(mca_res, choice="var", axes=1:2)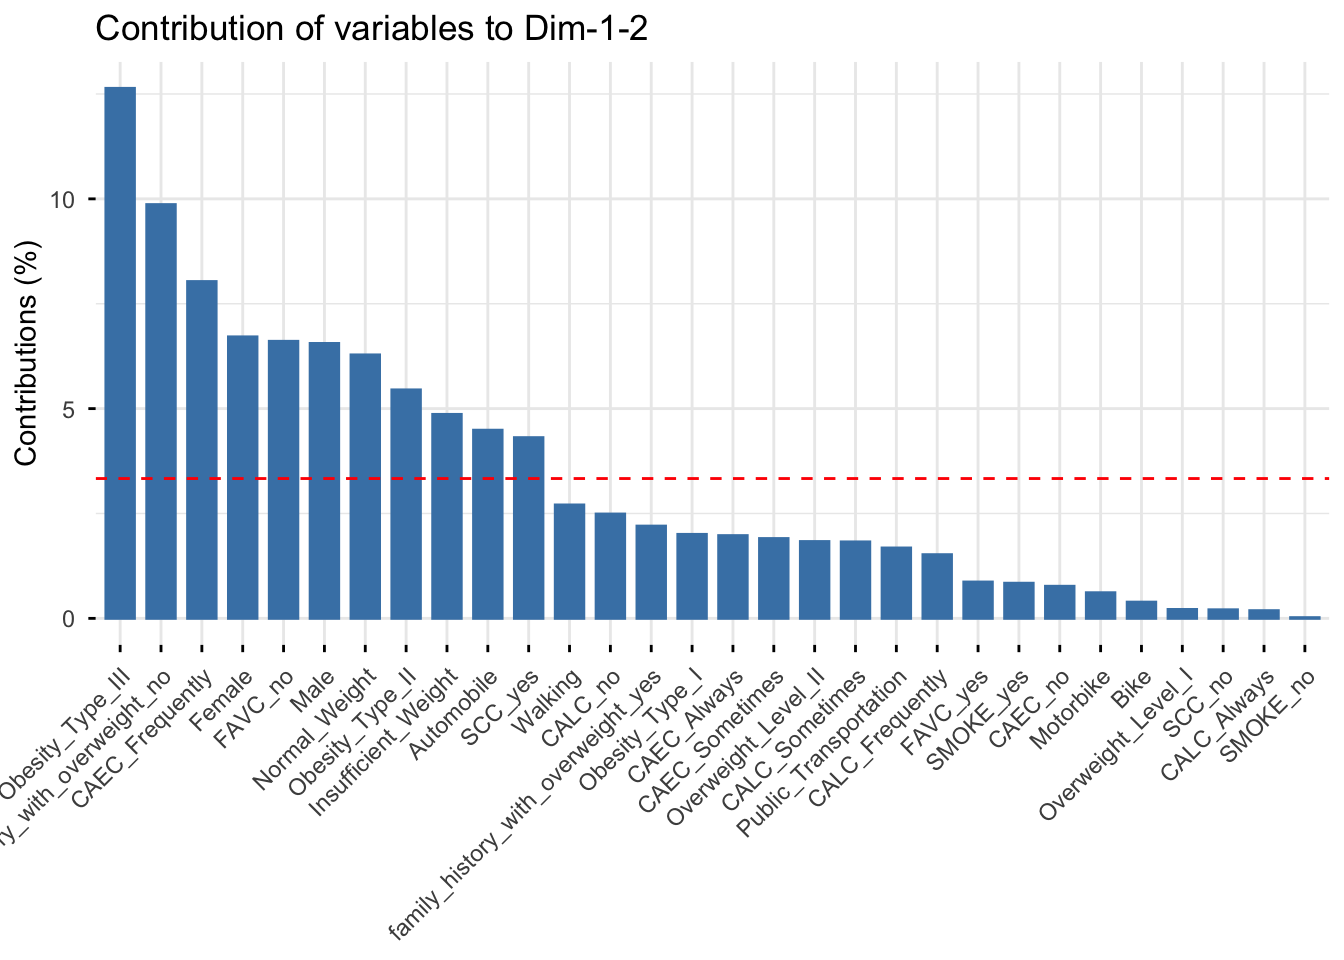
# Les cosinus carrés des modalités (qualité de représentation) sur les axes 1 et 2
fviz_cos2(mca_res, choice="var", axes=1:2)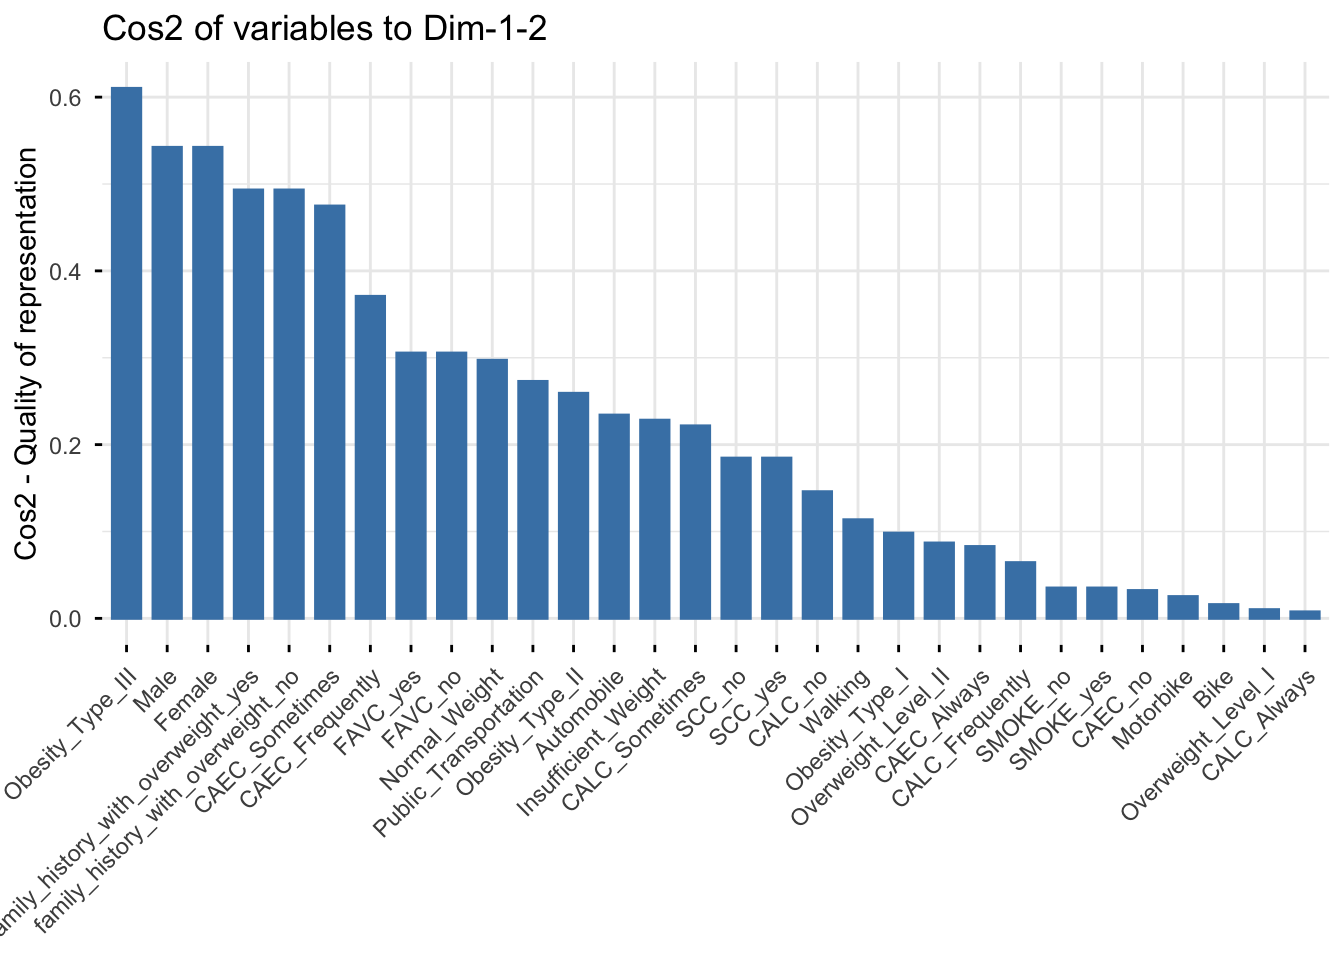
Il y a cependant une nouvelle quantité, spécifique à l’ACM : les eta2 pour chaque variable. Ces dernières sont équivalentes au R-carré dans une ANOVA. Elles mesurent (entre 0 et 1) à quel point une variable “explique” la position des individus sur un axe. On peut les obtenir avec mca_res$var$eta2, ou sous forme graphique en précisant l’argument choice="mca.cor" dans fviz_mca_var() :
mca_res$var$eta2 Dim 1 Dim 2 Dim 3 Dim 4
Gender 0.049949343 4.922932e-01 0.04617184 0.0597556587
family_history_with_overweight 0.486285108 6.890321e-03 0.02393898 0.0749188736
FAVC 0.271310496 3.413942e-02 0.01422001 0.0405184946
CAEC 0.481242816 3.677268e-02 0.41718731 0.2975323605
SMOKE 0.003007511 3.200038e-02 0.01901449 0.0342322302
SCC 0.184501466 2.435545e-05 0.05274251 0.0003804865
CALC 0.047449741 1.984228e-01 0.26819005 0.0747067406
MTRANS 0.127275489 2.761423e-01 0.02064599 0.1569215438
NObeyesdad 0.647974999 7.121907e-01 0.58659966 0.5978120095
Dim 5
Gender 0.066170822
family_history_with_overweight 0.003869082
FAVC 0.025715495
CAEC 0.102329138
SMOKE 0.042310337
SCC 0.050296044
CALC 0.199987175
MTRANS 0.073372797
NObeyesdad 0.661704101fviz_mca_var(mca_res, choice="mca.cor", repel = TRUE, title="Correlation des variables (Eta2)")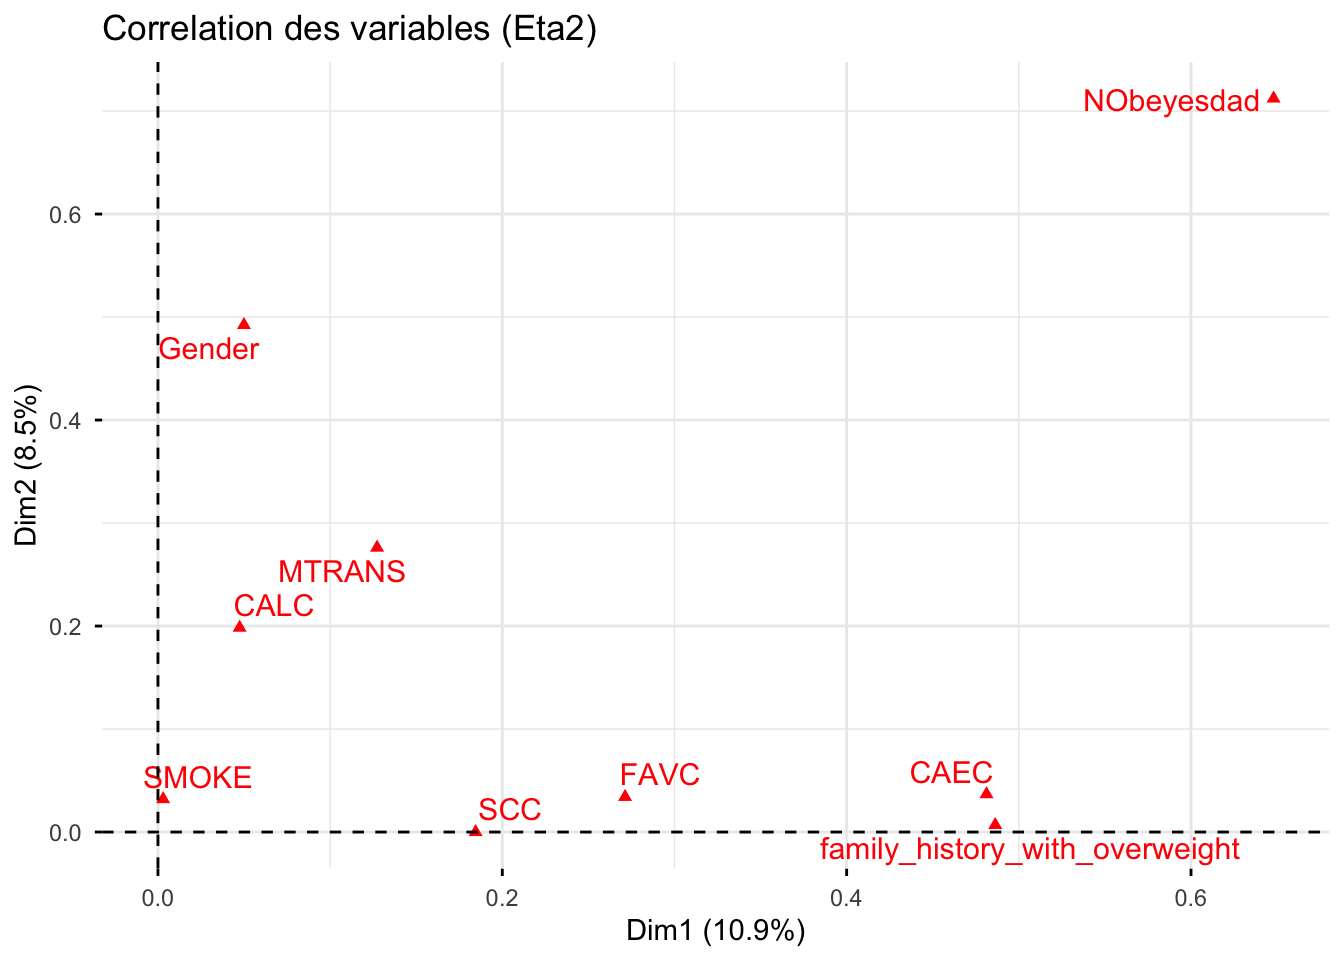
2.5 Les graphiques avancés
Avec tous ces éléments, nous pouvons affiner nos graphiques afin d’améliorer leur lisibilité.
On peut par exemple n’afficher que les modalités les plus contributives aux 2 premiers axes :
fviz_mca_var(mca_res,
             col.var = mod_var,
             repel = TRUE,
             mean.point = FALSE,
             select.var=list(contrib=15))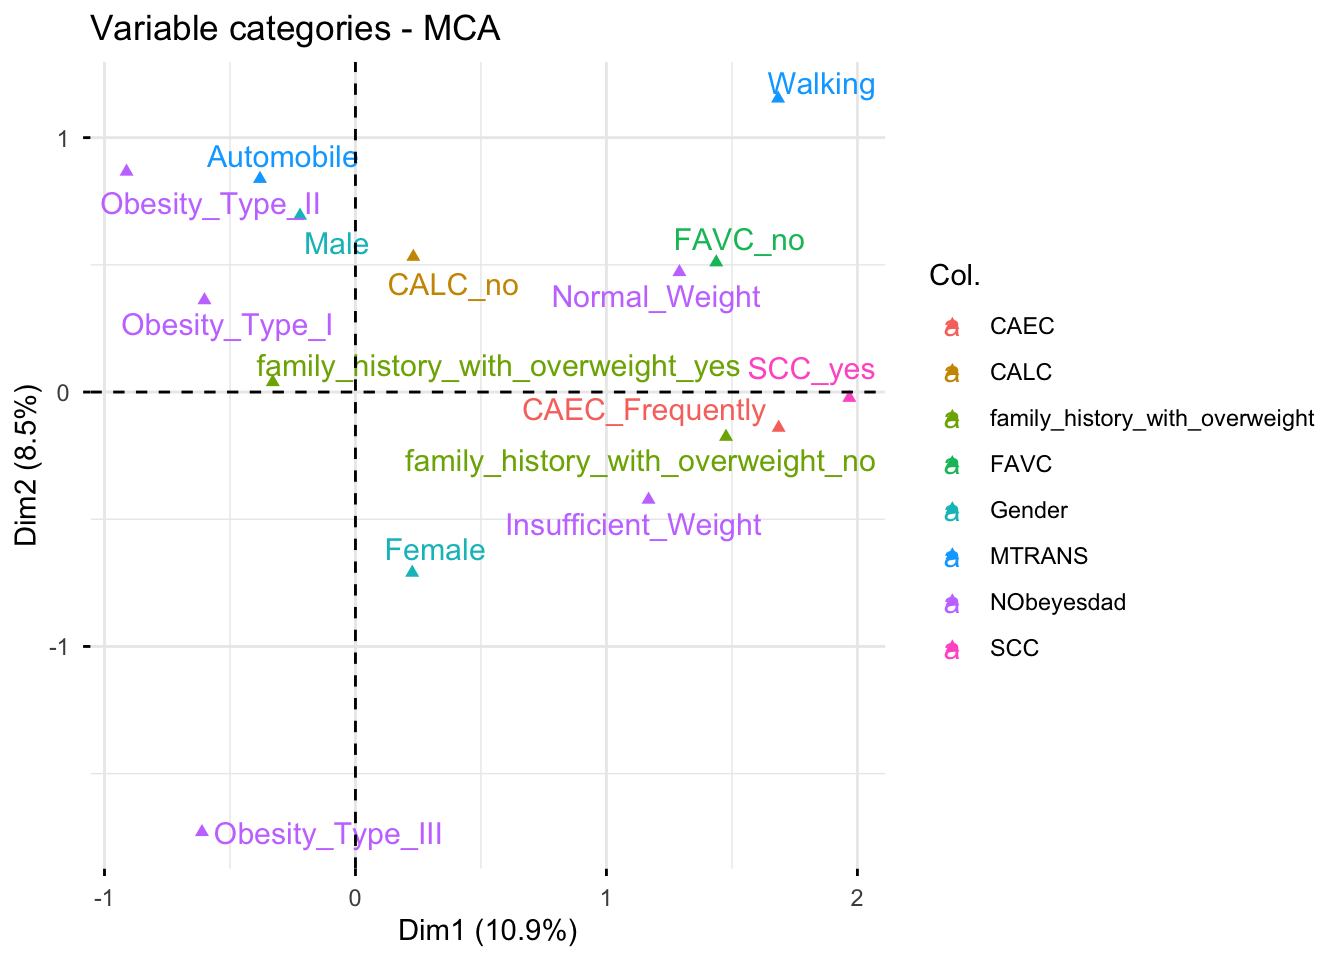
Concernant l’affichage des individus, des variables numériques (ou catégorielles, supplémentaires ou non) peuvent nous permettre de comprendre leur position sur le plan factoriel. On peut par exemple afficher le poids des individus de la manière suivante :
fviz_mca_ind(mca_res,
             geom = "point",
             alpha.ind = 0.6,
             col.ind = obesity_risk_df$Weight,
             gradient.cols = c("#00AFBB", "#E7B800", "#FC4E07"),
             legend.title = "Poids (kg)")
Ignoring unknown labels:
• fill : "Poids (kg)"
• linetype : "Poids (kg)"
• shape : "Poids (kg)"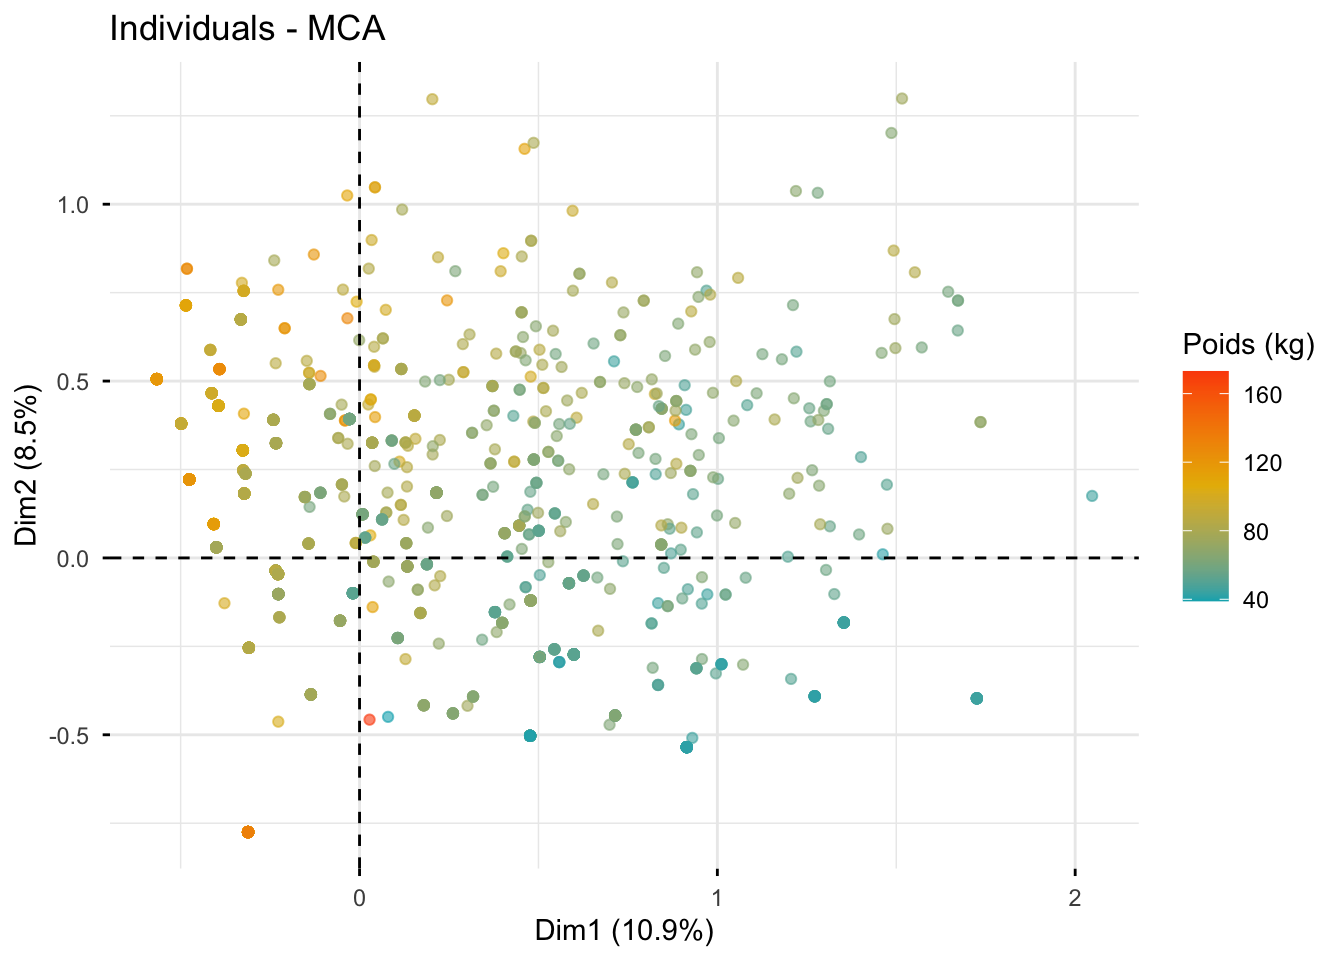
On voit que l’axe 1 explique en grande partie le poids des individus.
Une fonctionnalité intéressante des fonctions de factoextra est de pouvoir afficher des ellipses résumant la position des différents groupes de points (bon à savoir : si vous précisez l’argument ellipse.type="confidence", vous tracez des ellipses sur la position moyenne des individus) :
fviz_mca_biplot(mca_res,
                geom.ind = "point",
                repel = TRUE,
                alpha.ind = 0, # On rend les points invisibles
                col.var = mod_var,
                col.ind = obesity_risk_df$Gender,
                select.var=list(contrib=15),
                mean.point = FALSE,
                addEllipses = TRUE) # L'argument pour mettre des ellipses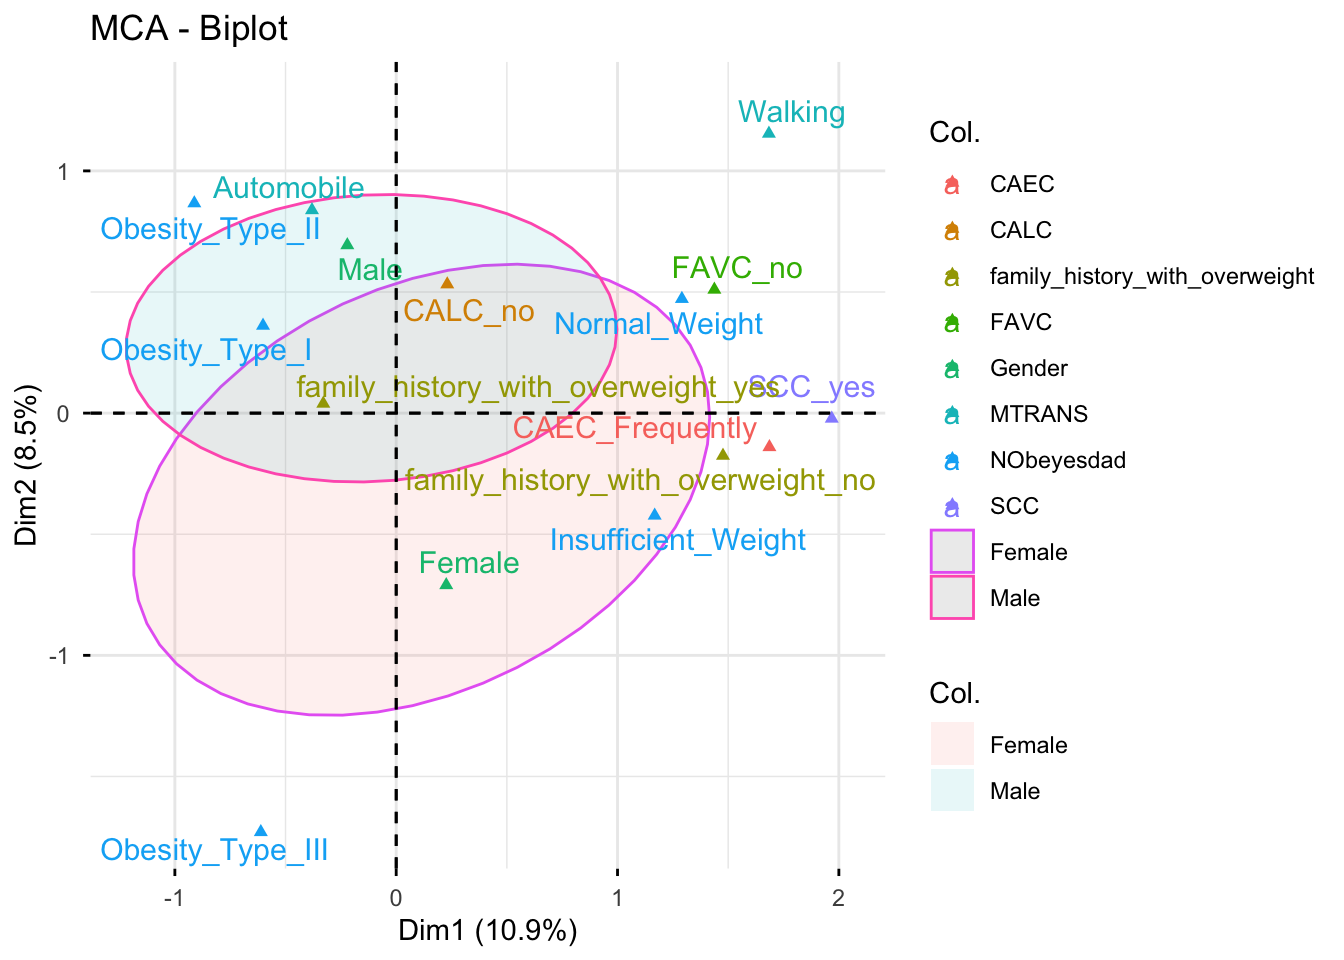
D’ailleurs, la fonction plotellipses() de FactoMineR permet de tracer automatiquement toutes les ellipses pour nos variables catégorielles (supplémentaires ou non) ayant été entrées dans la fonction MCA() :
plotellipses(mca_res,
             means = FALSE) # Ellipse sur les individus, par sur les moyennes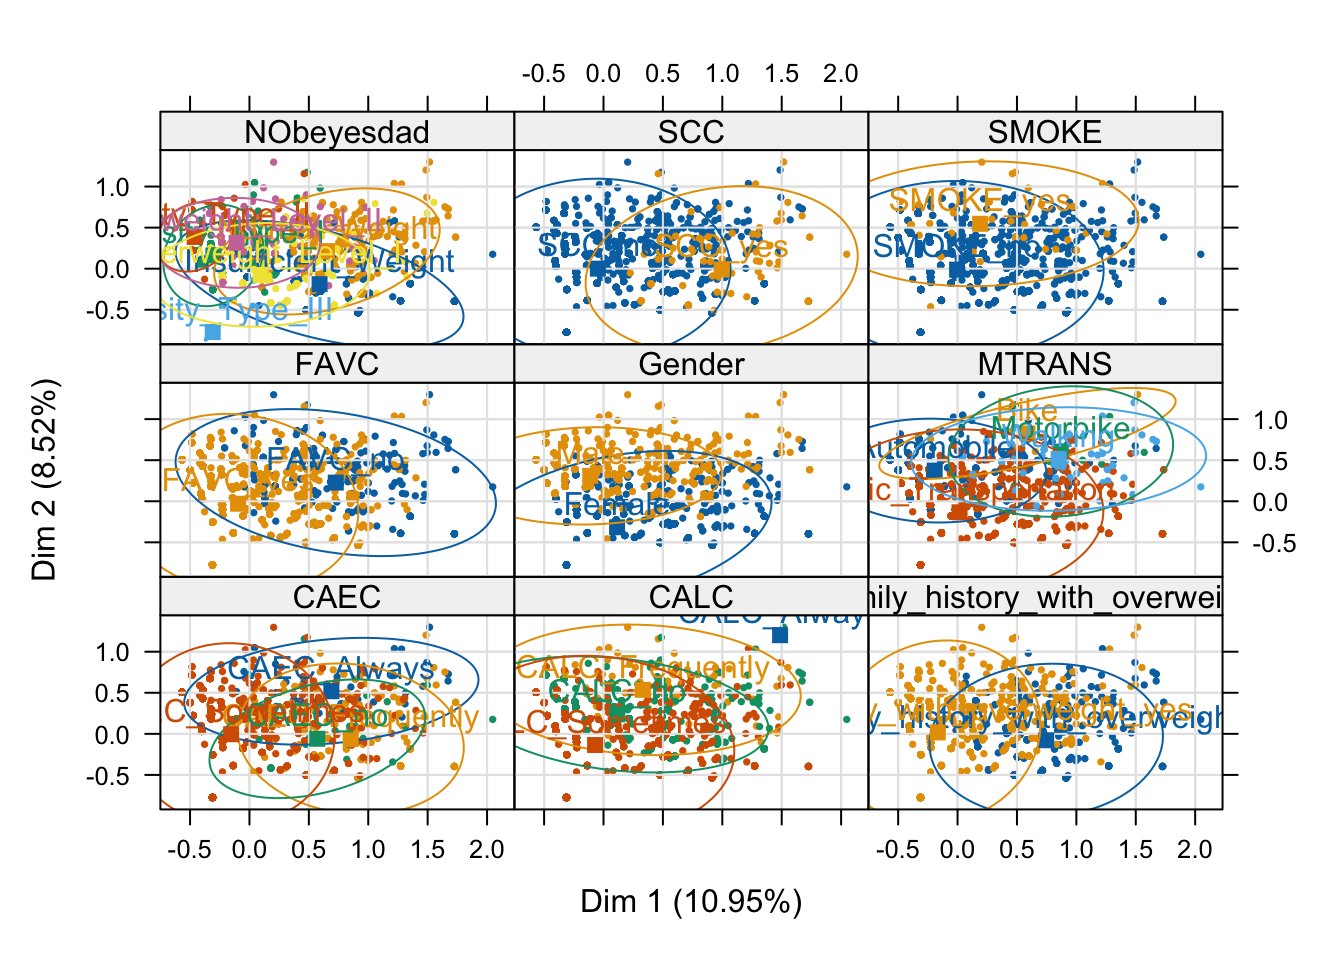
3 L’Analyse Factorielle Multiple (AFM)
L’AFM s’applique sur des tableaux de données où les variables sont structurées en groupes ou blocs. Contrairement à l’ACP ou l’ACM, elle permet d’analyser simultanément des blocs de variables quantitatives ET qualitatives. Elle propose donc d’analyser un jeu de données qui a la forme suivante :
| Individu | Age | Score | Sexe | Emploi |
|---|---|---|---|---|
| P1 | 25 | 12.5 | H | Oui |
| P2 | 42 | 18.0 | F | Oui |
| P3 | 33 | 9.5 | H | Non |
| Individu | Age | Score |
|---|---|---|
| P1 | 25 | 12.5 |
| P2 | 42 | 18.0 |
| P3 | 33 | 9.5 |
| Individu | Sexe | Emploi |
|---|---|---|
| P1 | H | Oui |
| P2 | F | Oui |
| P3 | H | Non |
L’AFM n’est ensuite rien d’autre qu’une ACP globale appliquée sur l’ensemble de ces données, après avoir équilibré chaque bloc. Pour cela, elle réalise d’abord une analyse séparée sur chaque groupe (une ACP pour les blocs numériques, une ACM pour les blocs catégoriels), puis agrège les différents résultats. Cette approche a plusieurs conséquences :
Équilibre des poids : L’algorithme divise chaque bloc par sa première valeur propre. Ainsi, on évite qu’un groupe contenant 50 variables n’écrase mathématiquement un groupe n’en contenant que 3. Chaque bloc pèse le même poids dans la construction de l’espace global.
Représentation des groupes : L’AFM offre des graphiques permettant de projeter non pas les variables, mais les blocs entiers. On peut ainsi évaluer visuellement la proximité et les corrélations entre les différents blocs.
Individus partiels : En plus de projeter l’individu “moyen” au centre de gravité de ses réponses, l’AFM permet de projeter ses “points partiels”. On peut ainsi voir la position d’un même individu s’il n’était évalué que par le Bloc 1, puis que par le Bloc 2, révélant ses éventuelles contradictions.
Passons à la pratique pour mieux comprendre tout ceci.
3.1 Chargement et pré-traitements
Nous allons utiliser ici le jeu de données bfi issu du package psych. Ce dernier contient les réponses de 2800 personnes à 25 questions mesurant les 5 grands traits de personnalité (Agréabilité, Conscience, Extraversion, Névrosisme, Ouverture) nommés en psychologie les Big Five. Il contient également 3 variables socioéconomiques. Pour plus de détails, regardez l’aide (?bfi) sur ce jeu de données :
data(bfi)
as_tibble(bfi)
# A tibble: 2,800 × 28
A1 A2 A3 A4 A5 C1 C2 C3 C4 C5 E1 E2 E3
<int> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
1 2 4 3 4 4 2 3 3 4 4 3 3 3
2 2 4 5 2 5 5 4 4 3 4 1 1 6
3 5 4 5 4 4 4 5 4 2 5 2 4 4
4 4 4 6 5 5 4 4 3 5 5 5 3 4
5 2 3 3 4 5 4 4 5 3 2 2 2 5
6 6 6 5 6 5 6 6 6 1 3 2 1 6
7 2 5 5 3 5 5 4 4 2 3 4 3 4
8 4 3 1 5 1 3 2 4 2 4 3 6 4
9 4 3 6 3 3 6 6 3 4 5 5 3 NA
10 2 5 6 6 5 6 5 6 2 1 2 2 4
# ℹ 2,790 more rows
# ℹ 15 more variables: E4 <int>, E5 <int>, N1 <int>, N2 <int>, N3 <int>,
# N4 <int>, N5 <int>, O1 <int>, O2 <int>, O3 <int>, O4 <int>, O5 <int>,
# gender <int>, education <int>, age <int>Ce jeu de données contient plusieurs valeurs manquantes (NA). Pour simplifier l’analyse, on enlève toutes les lignes qui en contiennent :
bfi = bfi %>%
  drop_na()
Le groupe des variables socioéconomiques va être utilisé comme groupe supplémentaire. Cependant, un groupe doit être défini avec un seul type de variables (numériques ou catégorielles). Nous allons donc recoder la variable age en variable catégorielle et préciser les différents niveaux des variables gender et education. Le jeu de données résultant sera celui qui nous servira à l’analyse :
afm_df = bfi %>%
  mutate(gender = ifelse(gender == 1, "male", "female"),
         education = case_when(
           education == 1 ~ "HS",
           education == 2 ~ "finished HS",
           education == 3 ~ "some college",
           education == 4 ~ "college grad",
           education == 5 ~ "grad degree"),
         age_cat = cut(age, breaks=3, labels=c("young", "adult", "senior"))) %>%
  select(-age)
Il s’agit maintenant de définir nos blocs de variables. Pour cela, on doit préciser leur taille, leur type et leur nom :
grp_sizes = c(5, 5, 5, 5, 5, 3)
grp_types = c("s", "s", "s", "s", "s", "n")
grp_names = c("Agréabilité", "Conscience", "Extraversion",
              "Névrosisme", "Ouverture", "Démographie")
Les groupes peuvent être définis comme "s" (contenant des variables numériques) et "n" (contenant des variables catégorielles). Il existe aussi les options "c" (numériques non-réduites), "m" (variables mixtes) et "f" (table de contingence). Il est cependant recommandé de ne pas les utiliser sans une bonne maîtrise des outils statistiques sous-jacents, car l’interprétation devient difficile.
3.2 Le alpha de Cronbach
Pour valider la construction de nos blocs, on peut s’aider d’un indice nommé le alpha de Cronbach. Ce dernier mesure la cohérence interne d’un groupe de variables numériques en analysant les corrélations croisées. Son score varie de 0 à 1 et une valeur supérieure à 0.6 est généralement considérée comme acceptable pour dire que le groupe mesure un concept latent identique.
On peut obtenir cette mesure à l’aide de la fonction alpha() du package pysch :
alpha_A = afm_df %>% select(A1:A5) %>% alpha(check.keys=TRUE)Warning in alpha(., check.keys = TRUE): Some items were negatively correlated with the first principal component and were automatically reversed.
This is indicated by a negative sign for the variable name.alpha_A$total$raw_alpha[1] 0.7053653alpha_C = afm_df %>% select(C1:C5) %>% alpha(check.keys=TRUE)Warning in alpha(., check.keys = TRUE): Some items were negatively correlated with the first principal component and were automatically reversed.
This is indicated by a negative sign for the variable name.alpha_C$total$raw_alpha[1] 0.7318992alpha_E = afm_df %>% select(E1:E5) %>% alpha(check.keys=TRUE)Warning in alpha(., check.keys = TRUE): Some items were negatively correlated with the first principal component and were automatically reversed.
This is indicated by a negative sign for the variable name.alpha_E$total$raw_alpha[1] 0.768522alpha_N = afm_df %>% select(N1:N5) %>% alpha(check.keys=TRUE)
alpha_N$total$raw_alpha[1] 0.8155808alpha_O = afm_df %>% select(O1:O5) %>% alpha(check.keys=TRUE)Warning in alpha(., check.keys = TRUE): Some items were negatively correlated with the first principal component and were automatically reversed.
This is indicated by a negative sign for the variable name.alpha_O$total$raw_alpha[1] 0.6117688Nos groupes semblent tous être relativement cohérents.
3.3 Effectuer l’AFM
L’AFM s’effectue avec la fonction MFA(). Il faut lui donner tous les vecteurs servant à la définition de nos groupes, et num.group.sup = 6 précise que le 6ème groupe est en réalité un groupe de variables supplémentaires :
mfa_res = MFA(afm_df,
              name.group = grp_names,
              group = grp_sizes,
              type = grp_types,
              num.group.sup = 6,
              graph = FALSE)
Examinons l’objet de retour :
mfa_res**Results of the Multiple Factor Analysis (MFA)**
The analysis was performed on 2236 individuals, described by 28 variables
*Results are available in the following objects :
name description
1 "$eig" "eigenvalues"
2 "$separate.analyses" "separate analyses for each group of variables"
3 "$group" "results for all the groups"
4 "$partial.axes" "results for the partial axes"
5 "$inertia.ratio" "inertia ratio"
6 "$ind" "results for the individuals"
7 "$quanti.var" "results for the quantitative variables"
8 "$quali.var.sup" "results for the categorical supplementary variables"
9 "$summary.quanti" "summary for the quantitative variables"
10 "$summary.quali" "summary for the categorical variables"
11 "$global.pca" "results for the global PCA" On voit que ce dernier contient de nombreuses sorties inhabituelles, comme par exemple :
$group: Contient des statistiques sur les groupes entiers, considérés comme “une seules variables”.$inertia.ratio: Contient l’accord global entre les différents groupes.$ind$coord.partiel: Contient la position de l’individu calculée pour chaque bloc séparément.
Et bien d’autres que nous n’aurons pas le temps d’examiner en détail ici. Le nombre de résultats montre la complexité de cette analyse, qui s’effectue d’abord sur chaque bloc et ensuite de manière globale, permettant de calculer de nombreuses quantités à plusieurs échelons.
Comme pour toutes les méthodes factorielles, nous pouvons examiner l’information exprimée sur chaque axe :
fviz_eig(mfa_res, addlabels=TRUE)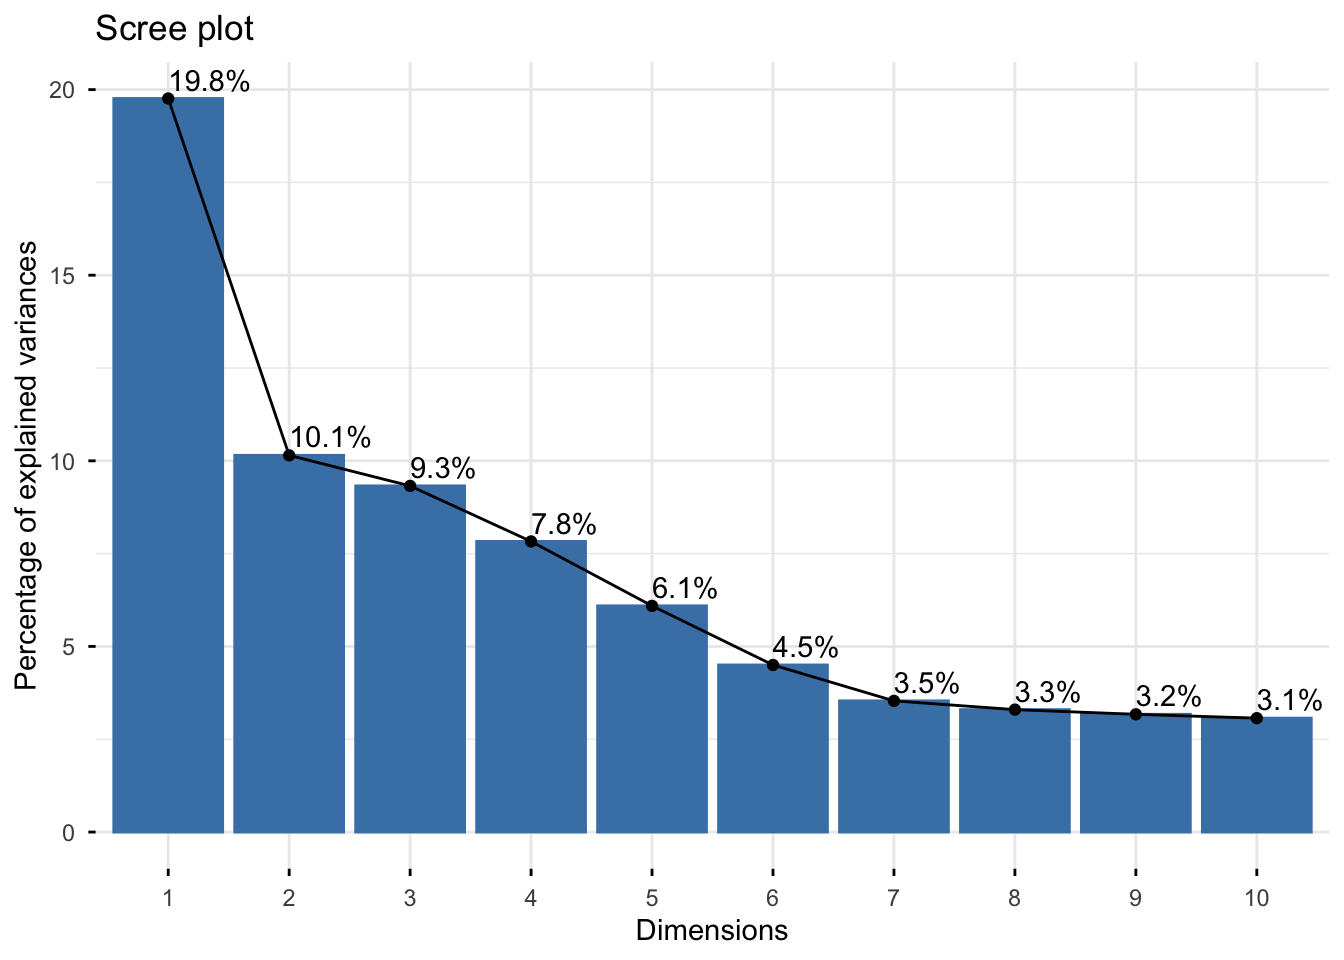
4 Sorties de l’AFM
Comme avec une ACP classique, on peut voir le cercle des corrélations :
fviz_mfa_var(mfa_res)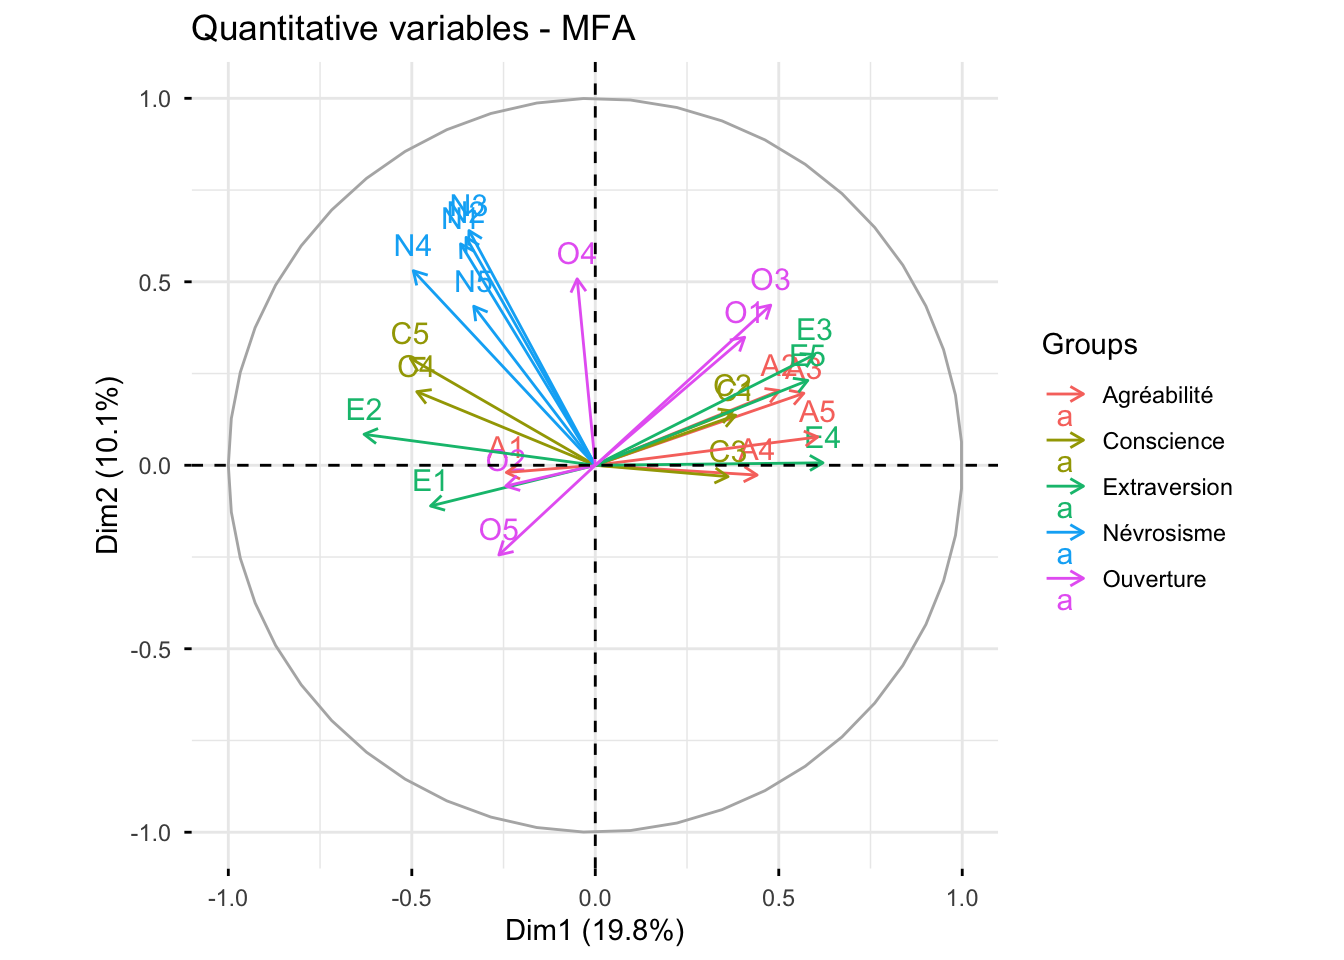
Ainsi que les coordonnées des individus (que nous colorions avec age_cat) :
fviz_mfa_ind(mfa_res,
             geom="point",
             habillage = "age_cat",
             addEllipses = TRUE,
             col.quali.var.sup = rgb(1, 1, 1, 0)) # élimine l'affichage des variables supplémentaires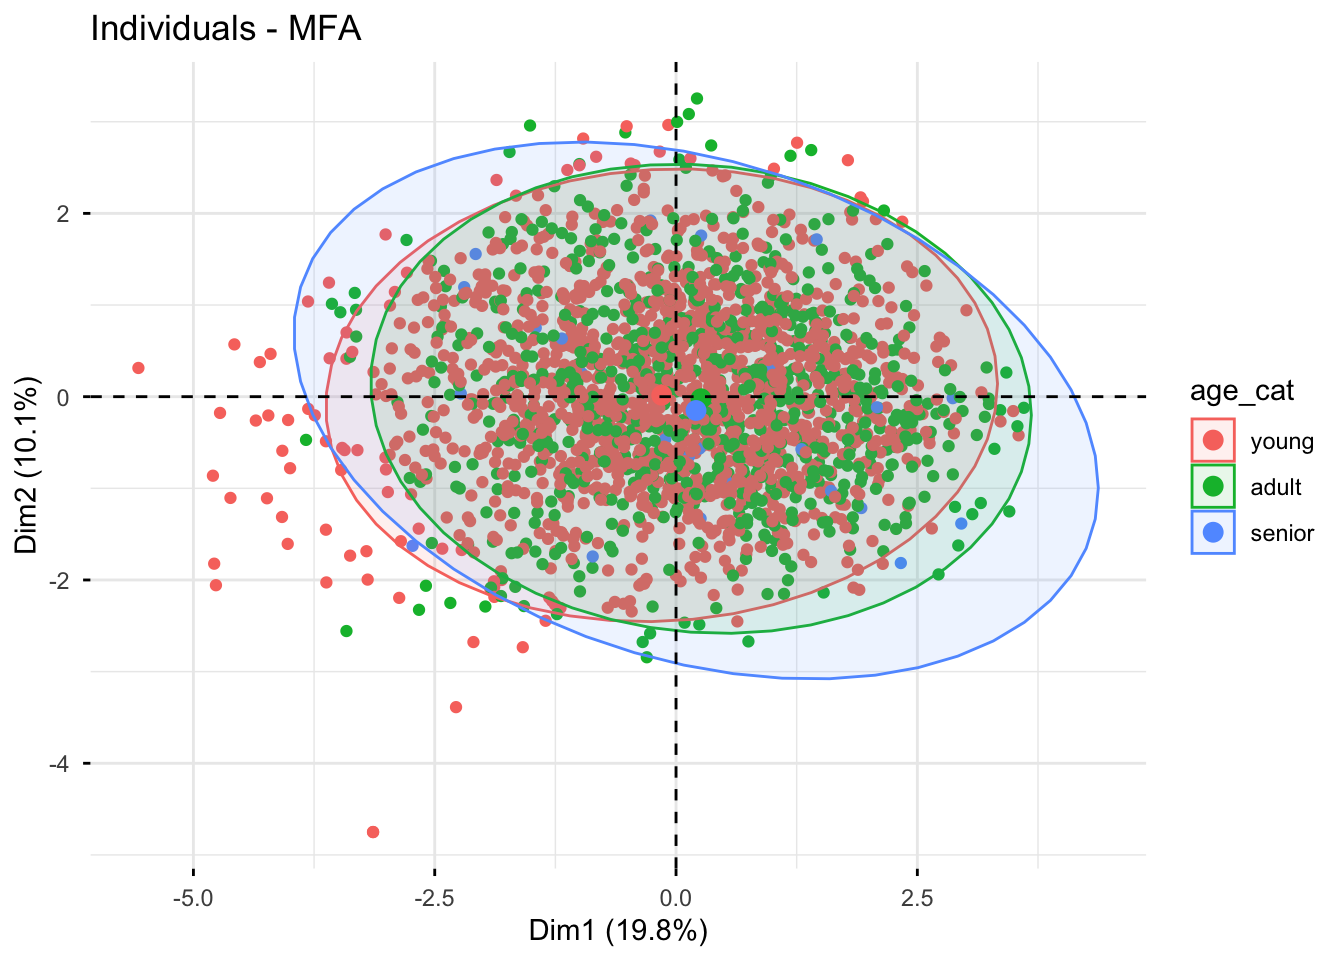
Cependant, il existe également des graphiques plus spécifiques, comme par exemple les coordonnées des groupes (c’est l’affiche de l’information contenue dans mfa_res$group$coord) :
fviz_mfa_var(mfa_res, choice = "group", repel = TRUE)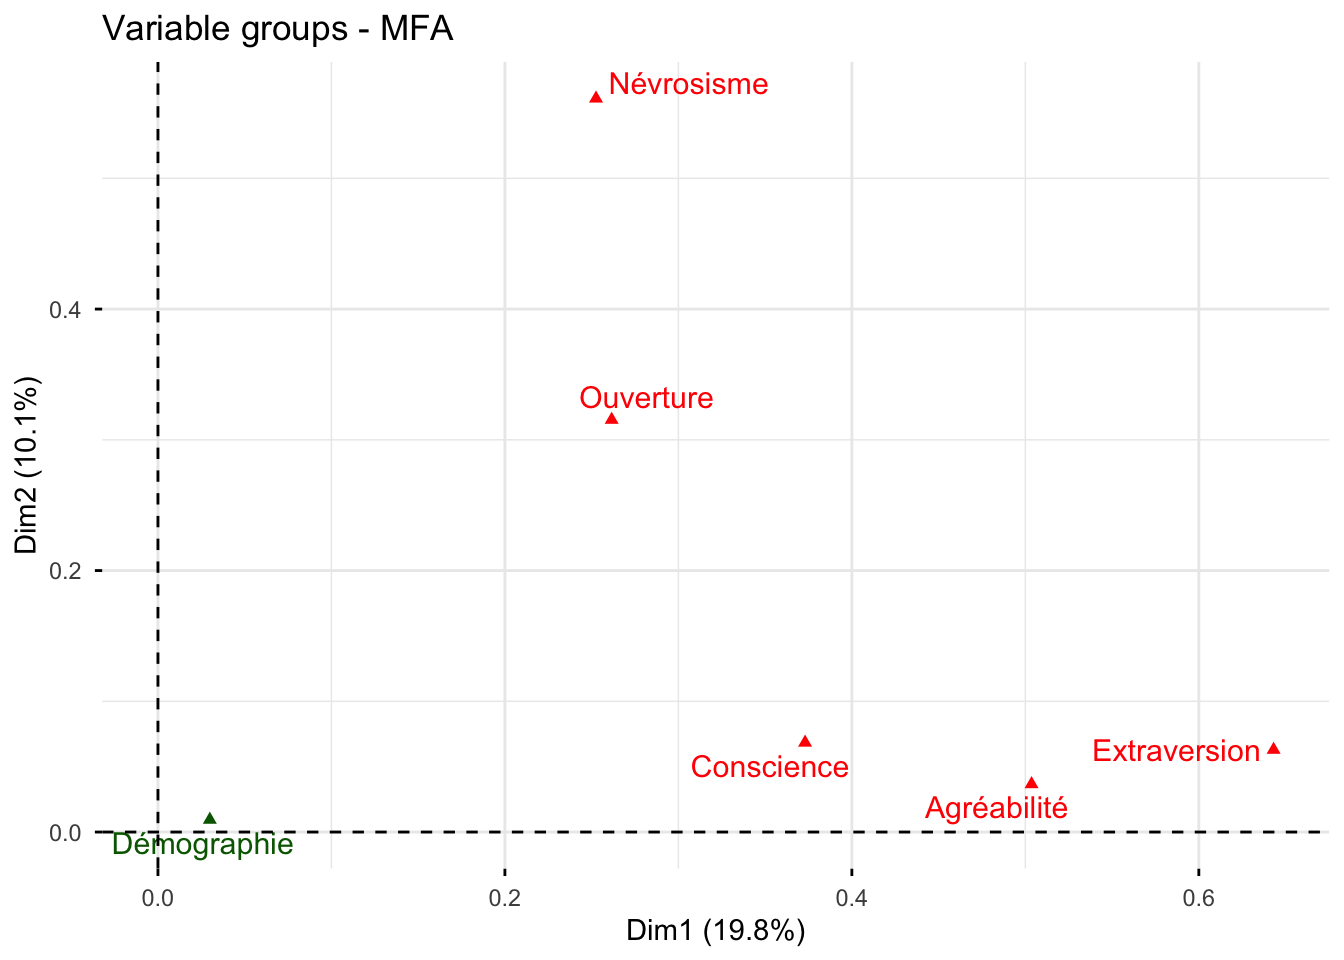
On voit que ces coordonnées sont entre 0 et 1. Elles représentent en réalité une intensité de liaison entre chaque groupe et les différents axes (formellement \(\text{coord}_{g, \alpha} = \frac{\sum_{i \in g} \text{corr}(i, \alpha)^2}{\lambda_{g, \alpha}}\)). C’est un concept proche des contributions, mais contrairement à ces dernières qui sont relatives (la somme des contributions sur un axe donne 100%), l’intensité de liaison peut être partagée entre plusieurs groupes de variables.
Dans notre résultat, “Extraversion”, “Agréabilité” et “Conscience” sont fortement liés à l’axe 1, et “Névrosisme” et “Ouverture” plutôt à l’axe 2.
Le deuxième graphique spécifique à l’AFM est l’espace des individus partiels. Il est plus aisé à interpréter lorsque les individus ne sont pas anonymes, car il se focalise sur ces derniers. Ici, nous allons extraire les 5 individus les mieux représentés sur les deux premiers axes afin de les représenter :
n_top = 5
perc_12 = rowSums(mfa_res$ind$cos2[, 1:2]) # la somme des cos2 sur l'axe 1 et 2
top_ind_indices = order(perc_12, decreasing=TRUE)[1:n_top] # les indices des individus avec les cos2 les plus élevées
On affiche ensuite ce graphique en précisant les indices de ces individus :
fviz_mfa_ind(mfa_res,
             select.ind = list(cos2=n_top),
             geom = "point",
             partial = top_ind_indices,
             repel = TRUE)
Warning in fviz_mfa_ind(mfa_res, select.ind = list(cos2 = n_top), geom =
"point", : You've already selected individuals. Partial points are only
calculated for them.Warning: This manual palette can handle a maximum of 13 values. You have
supplied 25Warning: Removed 12 rows containing missing values or values outside the scale range
(`geom_segment()`).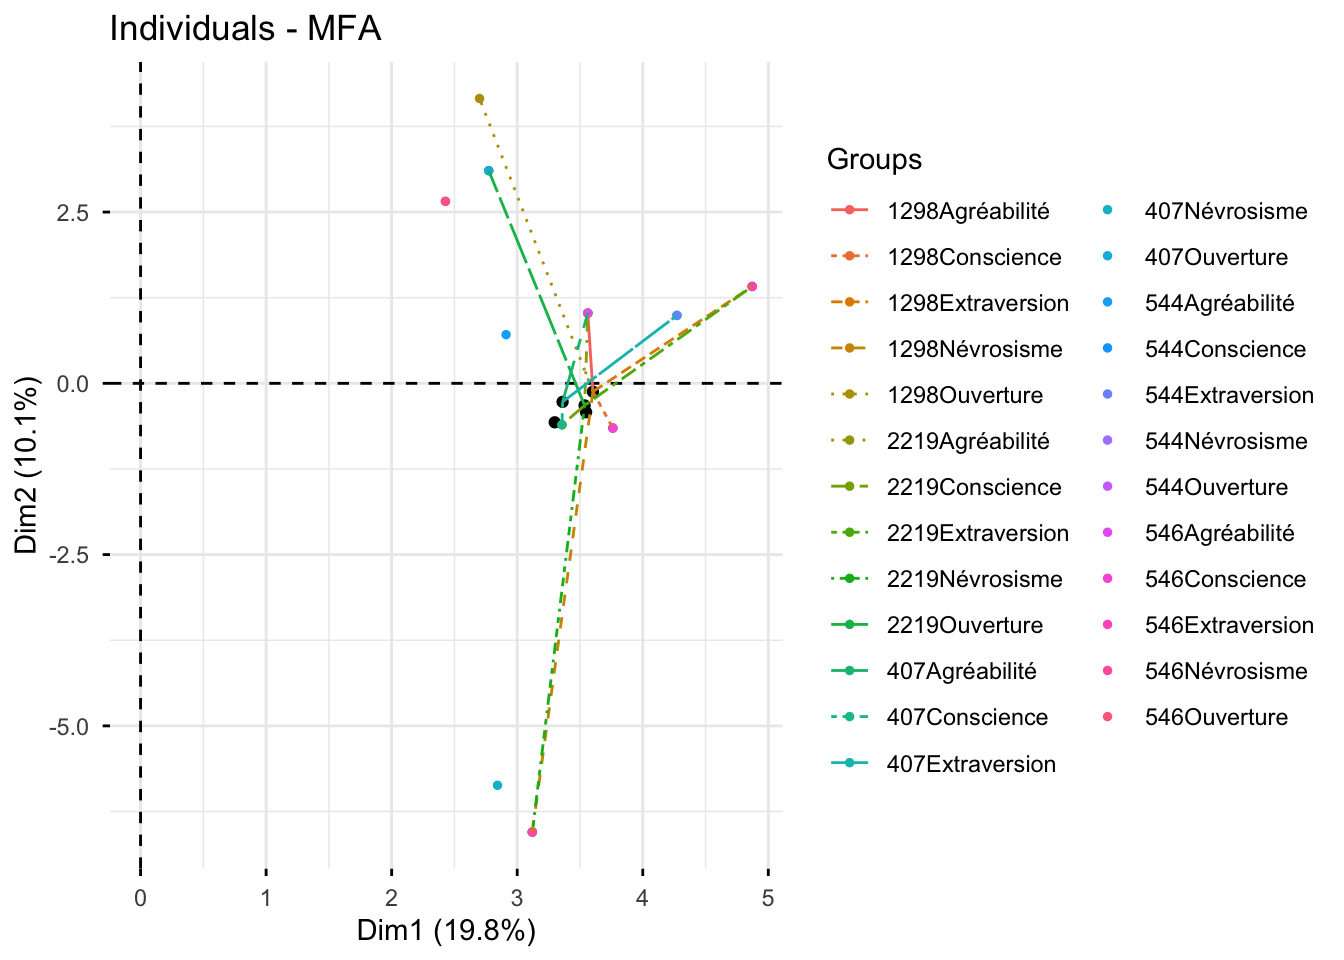
Chaque branche représente ici la position de l’individu par rapport à un seul bloc de variables, et le centre est le profil global, qui est le barycentre des autres points.
Ainsi, les différentes branches de l’étoile montrent les “contradictions” entre son profil global et ses profils par rapport aux différents blocs. Une étoile compacte dénote donc une personnalité cohérente, alors qu’une étoile avec de longues branches dénote des tensions et contradictions fortes entre ses différents traits de personnalité.