Régression multiple sur les données SeoulBike

Auteur·rice

Guillaume Guex

Présentation

Dans ce notebook (https://bookdown.org/yihui/rmarkdown/), nous allons donner un exemple de régression multiple sur les données SeoulBikeData.csv (https://archive.ics.uci.edu/dataset/560/seoul+bike+sharing+demand), qui contiennent des informations sur le nombre de locations de vélos à Séoul en fonction de différentes variables explicatives (température, humidité, saison, etc).

Chargement des données et pré-traitements

On commence par charger les données et jeter un coup d’œil rapide à leur structure.

# Charger les bibliothèques nécessaires
library(tidyverse)
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2     
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
library(knitr)

# Charger les données
seoul_bike = read.csv("SeoulBikeData.csv", stringsAsFactors = TRUE)

# Afficher les premières lignes des données
kable(head(seoul_bike))
Date Rented.Bike.Count Hour Temperature.C. Humidity… Wind.speed..m.s. Visibility..10m. Dew.point.temperature.C. Solar.Radiation..MJ.m2. Rainfall.mm. Snowfall..cm. Seasons Holiday Functioning.Day
01/12/2017 254 0 -5.2 37 2.2 2000 -17.6 0 0 0 Winter No Holiday Yes
01/12/2017 204 1 -5.5 38 0.8 2000 -17.6 0 0 0 Winter No Holiday Yes
01/12/2017 173 2 -6.0 39 1.0 2000 -17.7 0 0 0 Winter No Holiday Yes
01/12/2017 107 3 -6.2 40 0.9 2000 -17.6 0 0 0 Winter No Holiday Yes
01/12/2017 78 4 -6.0 36 2.3 2000 -18.6 0 0 0 Winter No Holiday Yes
01/12/2017 100 5 -6.4 37 1.5 2000 -18.7 0 0 0 Winter No Holiday Yes

On regarde combien de lignes possède le jeu de données.

nrow(seoul_bike)
[1] 8760

Il y a 8760 observations, ce qui correspond à une observation par heure pendant une année (365 jours x 24 heures = 8760).

On va retirer les variables “Date” et “Heure, qui ne sont pas pertinentes pour notre analyse.

seoul_bike = seoul_bike %>% 
  select(-Date, -Hour)
glimpse(seoul_bike)
Rows: 8,760
Columns: 12
$ Rented.Bike.Count        <int> 254, 204, 173, 107, 78, 100, 181, 460, 930, 4…
$ Temperature.C.           <dbl> -5.2, -5.5, -6.0, -6.2, -6.0, -6.4, -6.6, -7.…
$ Humidity...              <int> 37, 38, 39, 40, 36, 37, 35, 38, 37, 27, 24, 2…
$ Wind.speed..m.s.         <dbl> 2.2, 0.8, 1.0, 0.9, 2.3, 1.5, 1.3, 0.9, 1.1, …
$ Visibility..10m.         <int> 2000, 2000, 2000, 2000, 2000, 2000, 2000, 200…
$ Dew.point.temperature.C. <dbl> -17.6, -17.6, -17.7, -17.6, -18.6, -18.7, -19…
$ Solar.Radiation..MJ.m2.  <dbl> 0.00, 0.00, 0.00, 0.00, 0.00, 0.00, 0.00, 0.0…
$ Rainfall.mm.             <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, …
$ Snowfall..cm.            <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, …
$ Seasons                  <fct> Winter, Winter, Winter, Winter, Winter, Winte…
$ Holiday                  <fct> No Holiday, No Holiday, No Holiday, No Holida…
$ Functioning.Day          <fct> Yes, Yes, Yes, Yes, Yes, Yes, Yes, Yes, Yes, …
La variable “Functioning.Day” indique si le service de location de vélos est fonctionnel. On va retirer les jours où ce n’est pas le cas, car ils n’apportent pas d’information pertinente pour notre analyse, puis retirer cette variable.

seoul_bike = seoul_bike %>%
  filter(Functioning.Day == "Yes") %>%
  select(-Functioning.Day)

On observe maintenant nos variables restantes et notre nombre d’individus

glimpse(seoul_bike)
Rows: 8,465
Columns: 11
$ Rented.Bike.Count        <int> 254, 204, 173, 107, 78, 100, 181, 460, 930, 4…
$ Temperature.C.           <dbl> -5.2, -5.5, -6.0, -6.2, -6.0, -6.4, -6.6, -7.…
$ Humidity...              <int> 37, 38, 39, 40, 36, 37, 35, 38, 37, 27, 24, 2…
$ Wind.speed..m.s.         <dbl> 2.2, 0.8, 1.0, 0.9, 2.3, 1.5, 1.3, 0.9, 1.1, …
$ Visibility..10m.         <int> 2000, 2000, 2000, 2000, 2000, 2000, 2000, 200…
$ Dew.point.temperature.C. <dbl> -17.6, -17.6, -17.7, -17.6, -18.6, -18.7, -19…
$ Solar.Radiation..MJ.m2.  <dbl> 0.00, 0.00, 0.00, 0.00, 0.00, 0.00, 0.00, 0.0…
$ Rainfall.mm.             <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, …
$ Snowfall..cm.            <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, …
$ Seasons                  <fct> Winter, Winter, Winter, Winter, Winter, Winte…
$ Holiday                  <fct> No Holiday, No Holiday, No Holiday, No Holida…
nrow(seoul_bike)
[1] 8465

Les deux variables “Seasons”, “Holiday” sont catégorielles et il faudrait donc les transformer en variables numériques comme vu en cours. Cependant, cette tâche s’effectue de manière automatique en R lorsque l’on effectue une régression . Il n’est donc pas nécessaire d’effectuer d’autres pré-traitements.


Sélection du modèle de régression

Notre regression va s’effectuer sur la variable cible “Rented.Bike.Count”. On commence par afficher le matrice de corrélation entre nos variables numériques ce qui peut servir dans la sélection des variables.

# Calculer la matrice de corrélation
cor_matrix = cor(seoul_bike %>% select_if(is.numeric))
# Afficher la matrice de corrélation
kable(cor_matrix)
Rented.Bike.Count Temperature.C. Humidity… Wind.speed..m.s. Visibility..10m. Dew.point.temperature.C. Solar.Radiation..MJ.m2. Rainfall.mm. Snowfall..cm.
Rented.Bike.Count 1.0000000 0.5627402 -0.2019727 0.1250219 0.2123228 0.4002628 0.2738616 -0.1286261 -0.1516108
Temperature.C. 0.5627402 1.0000000 0.1664252 -0.0384808 0.0282621 0.9144670 0.3548435 0.0521489 -0.2177458
Humidity… -0.2019727 0.1664252 1.0000000 -0.3373524 -0.5485418 0.5394024 -0.4572727 0.2369169 0.1101265
Wind.speed..m.s. 0.1250219 -0.0384808 -0.3373524 1.0000000 0.1804276 -0.1771701 0.3262219 -0.0249313 -0.0037893
Visibility..10m. 0.2123228 0.0282621 -0.5485418 0.1804276 1.0000000 -0.1825864 0.1530461 -0.1703518 -0.1228597
Dew.point.temperature.C. 0.4002628 0.9144670 0.5394024 -0.1771701 -0.1825864 1.0000000 0.0985250 0.1268125 -0.1497598
Solar.Radiation..MJ.m2. 0.2738616 0.3548435 -0.4572727 0.3262219 0.1530461 0.0985250 1.0000000 -0.0741573 -0.0733799
Rainfall.mm. -0.1286261 0.0521489 0.2369169 -0.0249313 -0.1703518 0.1268125 -0.0741573 1.0000000 0.0086041
Snowfall..cm. -0.1516108 -0.2177458 0.1101265 -0.0037893 -0.1228597 -0.1497598 -0.0733799 0.0086041 1.0000000

On voit que la variable la plus corrélée (en valeur absolue) avec “Rented.Bike.Count” est “Temperature.C.” avec une valeur de 0.5627. C’est donc elle qu’il faudrait utiliser pour effectuer une régression avec un seul prédicteur.

Effectuons maintenant une régression multiple avec toutes les variables.

# Effectuer la régression multiple
model_full = lm(Rented.Bike.Count ~ ., data = seoul_bike)
# Afficher le résumé du modèle
summary(model_full)

Call:
lm(formula = Rented.Bike.Count ~ ., data = seoul_bike)

Residuals:
    Min      1Q  Median      3Q     Max 
-1521.6  -290.5   -51.6   200.2  2388.5 

Coefficients:
                           Estimate Std. Error t value Pr(>|t|)    
(Intercept)              1095.58958  105.33805  10.401  < 2e-16 ***
Temperature.C.             29.36879    3.99851   7.345 2.25e-13 ***
Humidity...               -12.80340    1.12733 -11.357  < 2e-16 ***
Wind.speed..m.s.           65.63340    5.48185  11.973  < 2e-16 ***
Visibility..10m.           -0.01392    0.01096  -1.270    0.204    
Dew.point.temperature.C.    6.39355    4.20086   1.522    0.128    
Solar.Radiation..MJ.m2.  -121.41359    8.30863 -14.613  < 2e-16 ***
Rainfall.mm.              -51.73625    4.73360 -10.930  < 2e-16 ***
Snowfall..cm.              52.24610   12.20140   4.282 1.87e-05 ***
SeasonsSpring            -155.96574   15.37514 -10.144  < 2e-16 ***
SeasonsSummer            -248.91432   18.74725 -13.277  < 2e-16 ***
SeasonsWinter            -290.26902   21.53193 -13.481  < 2e-16 ***
HolidayNo Holiday         142.71072   24.19296   5.899 3.80e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 471.3 on 8452 degrees of freedom
Multiple R-squared:  0.4624,    Adjusted R-squared:  0.4617 
F-statistic: 605.9 on 12 and 8452 DF,  p-value: < 2.2e-16

Si on doit retirer du modèle une variable, on va regarder la plus grande valeur propre, il s’agit ici de (à part l’intercept que l’on ne va retirer) de “Visibility..10m.” (p-value = 0.204). On peut donc faire un nouveau modèle sans cette dernière.

# Régression sans "Visibility..10m."
model_refined = lm(Rented.Bike.Count ~ . - `Visibility..10m.`, 
                        data = seoul_bike)
# Afficher le résumé du modèle
summary(model_refined)

Call:
lm(formula = Rented.Bike.Count ~ . - Visibility..10m., data = seoul_bike)

Residuals:
     Min       1Q   Median       3Q      Max 
-1500.09  -289.76   -50.88   200.20  2395.01 

Coefficients:
                         Estimate Std. Error t value Pr(>|t|)    
(Intercept)              1048.929     98.730  10.624  < 2e-16 ***
Temperature.C.             29.698      3.990   7.443 1.08e-13 ***
Humidity...               -12.440      1.090 -11.408  < 2e-16 ***
Wind.speed..m.s.           65.034      5.462  11.907  < 2e-16 ***
Dew.point.temperature.C.    6.072      4.193   1.448    0.148    
Solar.Radiation..MJ.m2.  -119.433      8.161 -14.634  < 2e-16 ***
Rainfall.mm.              -51.501      4.730 -10.888  < 2e-16 ***
Snowfall..cm.              52.630     12.198   4.315 1.62e-05 ***
SeasonsSpring            -151.615     14.989 -10.115  < 2e-16 ***
SeasonsSummer            -250.539     18.704 -13.395  < 2e-16 ***
SeasonsWinter            -284.918     21.117 -13.493  < 2e-16 ***
HolidayNo Holiday         143.157     24.191   5.918 3.39e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 471.3 on 8453 degrees of freedom
Multiple R-squared:  0.4623,    Adjusted R-squared:  0.4616 
F-statistic: 660.7 on 11 and 8453 DF,  p-value: < 2.2e-16

C’est maintenant “Dew.point.temperature.C.” qui a la plus grande p-valeur (0.148), on la retire également.

# Régression sans "Visibility..10m." et "Dew.point.temperature.C."
model_refined = lm(Rented.Bike.Count ~ . - `Visibility..10m.` - 
                     `Dew.point.temperature.C.`, data = seoul_bike)
# Afficher le résumé du modèle
summary(model_refined)

Call:
lm(formula = Rented.Bike.Count ~ . - Visibility..10m. - Dew.point.temperature.C., 
    data = seoul_bike)

Residuals:
     Min       1Q   Median       3Q      Max 
-1405.60  -292.24   -49.35   201.32  2397.89 

Coefficients:
                         Estimate Std. Error t value Pr(>|t|)    
(Intercept)              916.0797    36.4638  25.123  < 2e-16 ***
Temperature.C.            35.3176     0.9281  38.054  < 2e-16 ***
Humidity...              -10.9346     0.3288 -33.252  < 2e-16 ***
Wind.speed..m.s.          64.7072     5.4574  11.857  < 2e-16 ***
Solar.Radiation..MJ.m2. -122.0988     7.9516 -15.355  < 2e-16 ***
Rainfall.mm.             -52.3113     4.6972 -11.137  < 2e-16 ***
Snowfall..cm.             51.2456    12.1613   4.214 2.54e-05 ***
SeasonsSpring           -152.6058    14.9747 -10.191  < 2e-16 ***
SeasonsSummer           -247.9027    18.6167 -13.316  < 2e-16 ***
SeasonsWinter           -285.9263    21.1065 -13.547  < 2e-16 ***
HolidayNo Holiday        142.7706    24.1914   5.902 3.74e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 471.4 on 8454 degrees of freedom
Multiple R-squared:  0.4622,    Adjusted R-squared:  0.4615 
F-statistic: 726.5 on 10 and 8454 DF,  p-value: < 2.2e-16

Tous les coefficients sont significatifs, on peut donc se satisfaire de ce modèle.


Interprétations des résultats

Regardons à nouveau le résumé de notre modèle affiné.

summary(model_refined)

Call:
lm(formula = Rented.Bike.Count ~ . - Visibility..10m. - Dew.point.temperature.C., 
    data = seoul_bike)

Residuals:
     Min       1Q   Median       3Q      Max 
-1405.60  -292.24   -49.35   201.32  2397.89 

Coefficients:
                         Estimate Std. Error t value Pr(>|t|)    
(Intercept)              916.0797    36.4638  25.123  < 2e-16 ***
Temperature.C.            35.3176     0.9281  38.054  < 2e-16 ***
Humidity...              -10.9346     0.3288 -33.252  < 2e-16 ***
Wind.speed..m.s.          64.7072     5.4574  11.857  < 2e-16 ***
Solar.Radiation..MJ.m2. -122.0988     7.9516 -15.355  < 2e-16 ***
Rainfall.mm.             -52.3113     4.6972 -11.137  < 2e-16 ***
Snowfall..cm.             51.2456    12.1613   4.214 2.54e-05 ***
SeasonsSpring           -152.6058    14.9747 -10.191  < 2e-16 ***
SeasonsSummer           -247.9027    18.6167 -13.316  < 2e-16 ***
SeasonsWinter           -285.9263    21.1065 -13.547  < 2e-16 ***
HolidayNo Holiday        142.7706    24.1914   5.902 3.74e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 471.4 on 8454 degrees of freedom
Multiple R-squared:  0.4622,    Adjusted R-squared:  0.4615 
F-statistic: 726.5 on 10 and 8454 DF,  p-value: < 2.2e-16

Significativité globale du modèle

On voit que le R² ajusté est de 0.4615, ce qui indique que le modèle explique 46.15% de la variance totale de la variable cible “Rented.Bike.Count” (estimé sur la population). De plus, on voit sur la ligne suivante que le test du F rejette l’hypothèse nulle : “le R² théorique est égal à zéro” avec un p-valeur < 2.2e-16, ce qui indique que le modèle est globalement très significatif.

Étude des coefficients

Si on regarde maintenant les coefficients, on peut interpréter ceux-ci comme l’effet moyen d’une augmentation d’une unité de la variable explicative.

On a donc comme effet positif sur le nombre de location de vélos les variables :

  • Temperature.C.
  • Wind.speed..m.s.
  • Snowfall..cm.
  • La modalité “No Holiday” de la variable “Holiday” (il y a plus de vélos loués hors des vacances)

Et comme effet négatif les variables :

  • Humidity….
  • Visibility..km.
  • La modalité “Spring” de la variable “Seasons”
  • La modalité “Summer” de la variable “Seasons”
  • La modalité “Winter” de la variable “Seasons”

Comme la modalité “Autumn” de la variable “Seasons” n’est pas présente dans le modèle, c’est elle qui sert de référence pour les autres modalités. Les autres saisons ayant un effet négatif, on en déduit que l’automne est la saison où il y a le plus de locations de vélos en moyenne à autres variables constantes.

Pour voir l’effet le plus important sans prendre en compte les unités, on va calculer les coefficients standardisés \(\beta\).

# Cet opération nécessite une librairie supplémentaire
library(QuantPsyc) 
Le chargement a nécessité le package : boot
Le chargement a nécessité le package : MASS

Attachement du package : 'MASS'
L'objet suivant est masqué depuis 'package:dplyr':

    select

Attachement du package : 'QuantPsyc'
L'objet suivant est masqué depuis 'package:base':

    norm
# Calculer les coefficients standardisés
standardized_coeffs = lm.beta::lm.beta(model_refined)
# Afficher les coefficients standardisés
kable(as.data.frame(standardized_coeffs$standardized.coefficients))
standardized_coeffs$standardized.coefficients
(Intercept) NA
Temperature.C. 0.6655204
Humidity… -0.3487079
Wind.speed..m.s. 0.1041882
Solar.Radiation..MJ.m2. -0.1650370
Rainfall.mm. -0.0916608
Snowfall..cm. 0.0354265
SeasonsSpring -0.1035778
SeasonsSummer -0.1694689
SeasonsWinter -0.1940661
HolidayNo Holiday 0.0476082

On voit que la variable ayant l’effet standardisé le plus important est celui de “Temperature.C.” (0.6655), ce qui indique que c’est la variable la plus importante pour expliquer le nombre de locations de vélos à Séoul. C’était également la plus corrélée avec la variable cible.


Vérification des hypothèses de travail

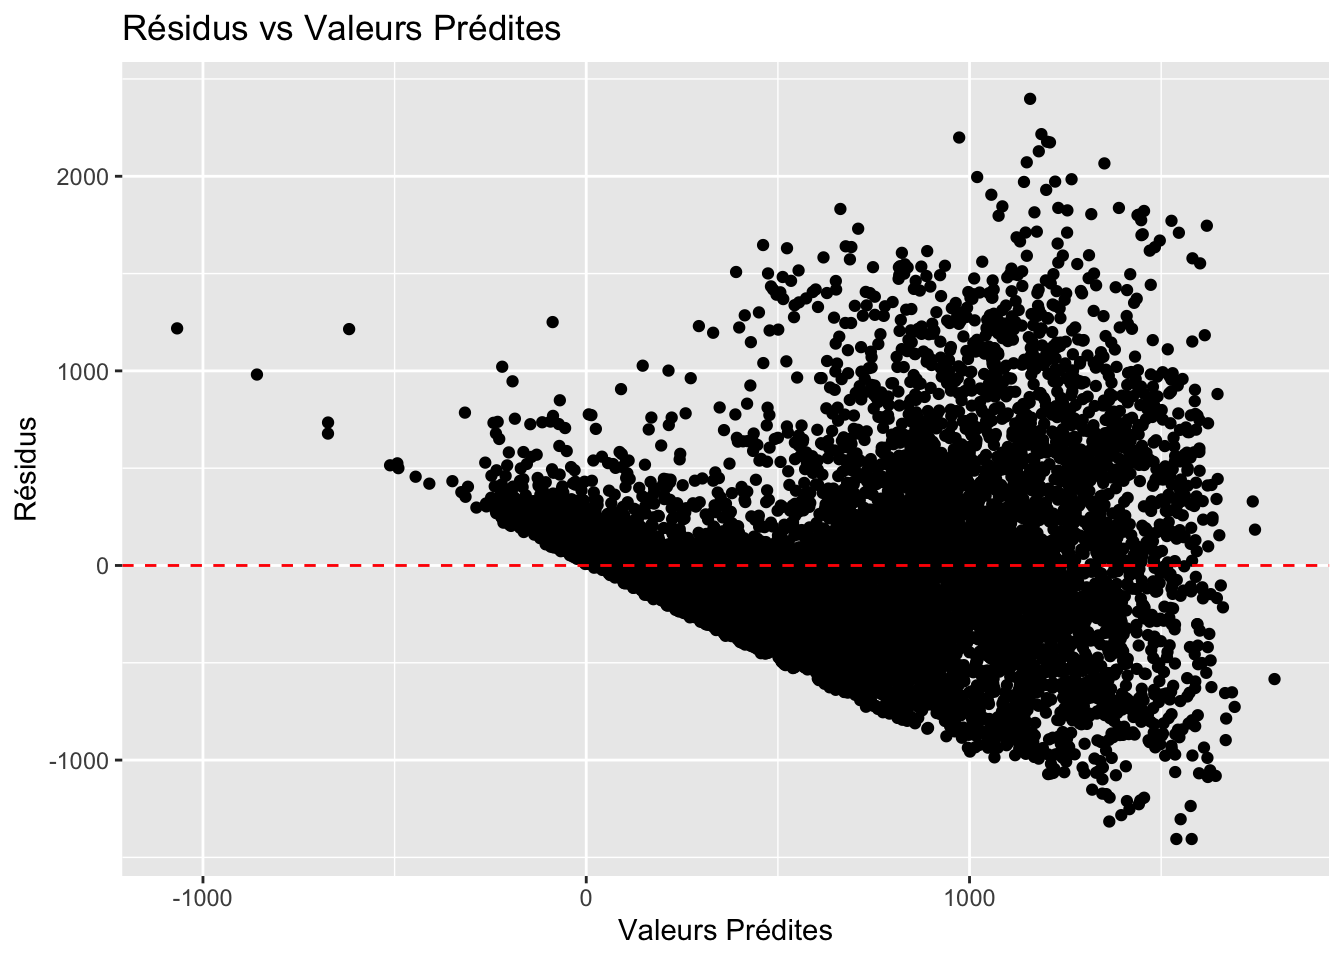
Il est important de vérifier que les hypothèses du modèle linéaire sont respectées. On va donc regarder le diagramme des résidus.

# Obtenir les résidus du modèle et les valeurs prédites
residuals = model_refined$residuals
predictied_values = model_refined$fitted.values
# Tracer les résidus
ggplot() +
  geom_point(aes(x = predictied_values, y = residuals)) +
  geom_hline(yintercept = 0, linetype = "dashed", color = "red") +
  labs(title = "Résidus vs Valeurs Prédites",
       x = "Valeurs Prédites",
       y = "Résidus")

Ce graphique montre que qu’il n’y a pas une tendance non-linéaire particulière, la linéarité est respectée. En revanche, pour ce qui est de la normalité et surtout l’homoscédasticité, ces hypothèses ne semblent pas être respectées. Il faudra donc mettre une certaine réserve dans la communication de nos résultats.

La forme particulière de ce graphique s’explique par le fait la variable cible ne peut pas être négative (on ne peut pas louer un nombre négatif de vélos), ce qui crée une sorte de “limite” pour les résidus négatifs. C’est ce qui rend ce modèle de régression moins fiable.