Dans ce notebook (https://bookdown.org/yihui/rmarkdown/), nous allons donner un exemple d’ACP sur les données realestate_data.xlsx (https://archive.ics.uci.edu/dataset/477/real+estate+valuation+data+set), qui contiennent des informations sur les prix de l’immobilier à Taïwan. Ce jeu de données est généralement utilisé pour prédire le prix de l’immobilier en fonction de différentes variables explicatives (âge du bâtiment, distance aux transports, positon, etc).
Chargement des données et pré-traitements
On commence par charger les données et jeter un coup d’œil à leur structure.
# Charger les bibliothèques nécessaireslibrary(tidyverse)
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
Welcome to factoextra!
Want to learn more? See two factoextra-related books at https://www.datanovia.com/en/product/practical-guide-to-principal-component-methods-in-r/
library(knitr)library(psych)
Attachement du package : 'psych'

Les objets suivants sont masqués depuis 'package:ggplot2':

    %+%, alpha
# Charger les donnéesreal_estate =read_excel("realestate_data.xlsx")# Afficher les premières lignes des donnéeskable(head(real_estate))
No
transaction_date
house_age
distance_to_station
n_stores
latitude
longitude
house_price_unit
1
2012.917
32.0
84.87882
10
24.98298
121.5402
37.9
2
2012.917
19.5
306.59470
9
24.98034
121.5395
42.2
3
2013.583
13.3
561.98450
5
24.98746
121.5439
47.3
4
2013.500
13.3
561.98450
5
24.98746
121.5439
54.8
5
2012.833
5.0
390.56840
5
24.97937
121.5425
43.1
6
2012.667
7.1
2175.03000
3
24.96305
121.5125
32.1
On regarde combien de lignes possède le jeu de données.
nrow(real_estate)
[1] 414
Il y a 414 observations.
La variable “transaction_date” contient une date, qui n’a pas été lue correctement. On ne va garder que l’année qui se situe avant le point
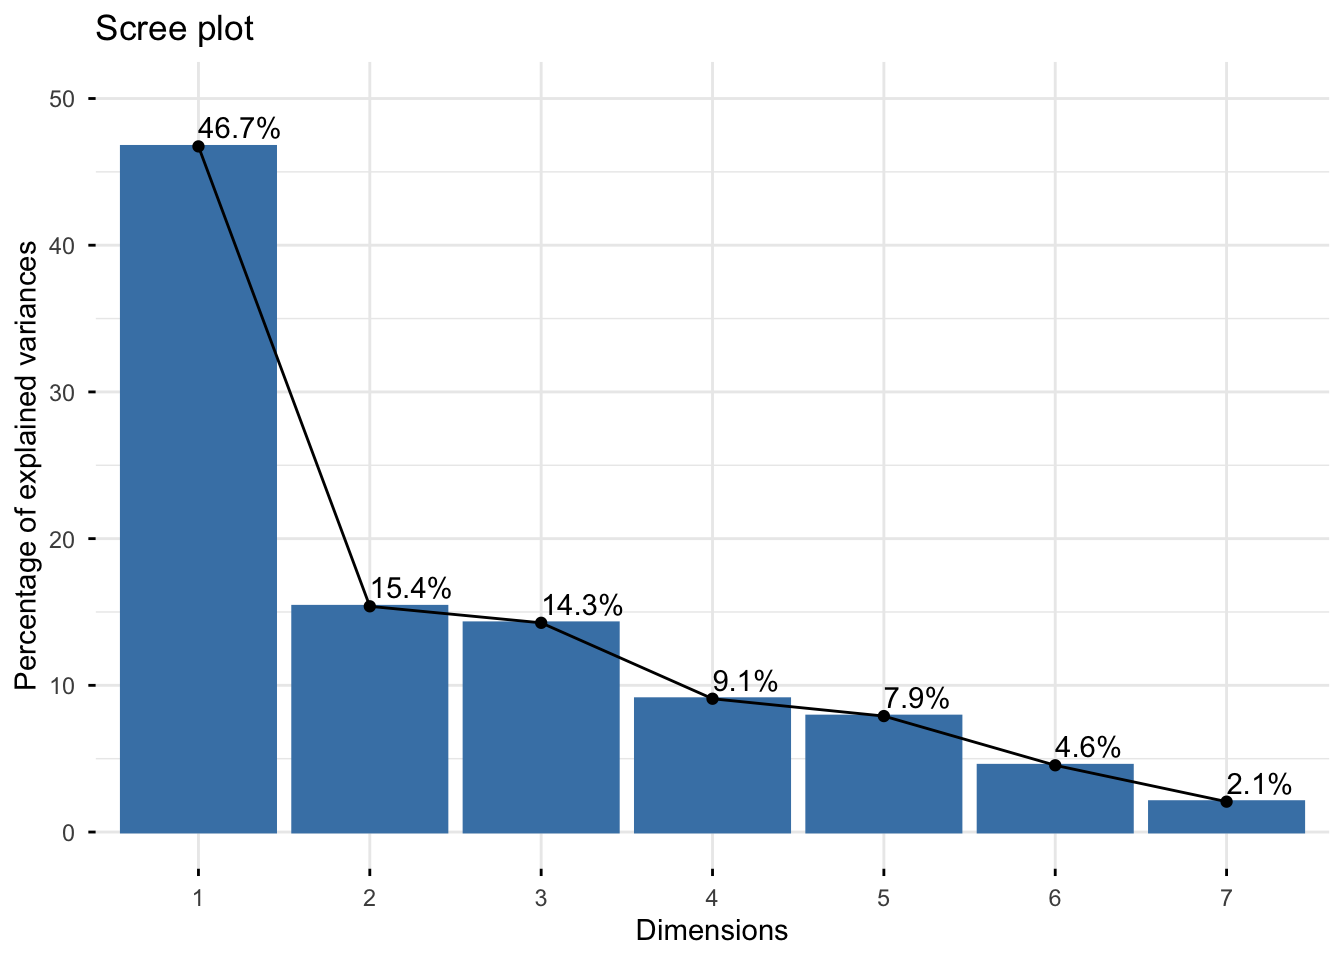
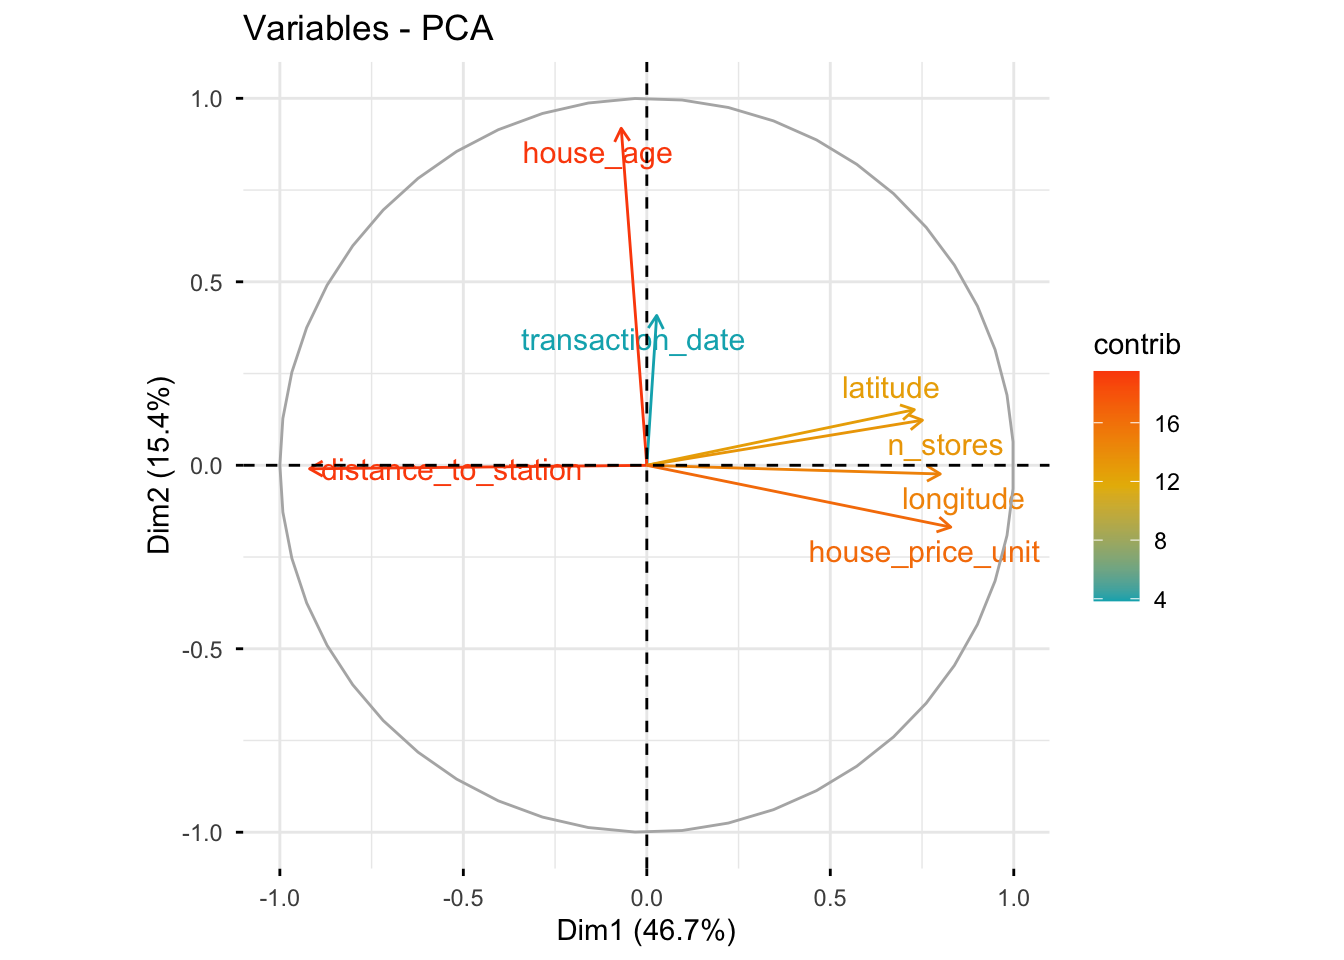
Les communalités (vues plus loin) des variables sur les deux premiers facteurs ont été utilisées pour la coloration. Ce graphique exprime 46.7% + 15.4% = 62.1% de la variance totale.
Ce graphique montre que le premier facteur comprends les variables :
(positivement) le prix au m2
(positivement) la latitude
(positivement) la longitude
(positivement) le nombre de commerces
(négativement) la distance aux transports publics
On pourrait nommer cette axe “Attractivité du bâtiment”.
Le deuxième facteur lie :
(positivement) âge de la maison
(positivement) date de vente
En réalité cet axe est presque entièrement lié à l’âge de la maison, qui semble orthogonale à toutes les autres variables.
Ce graphique est basé sur les saturations (correlations entre variables et facteurs)
Les saturations carrées exprime le pourcentage de variance d’une variable expliquée par un facteur.
kable(saturations^2)
Dim.1
Dim.2
transaction_date
0.0007258
0.1666592
house_age
0.0048706
0.8432959
distance_to_station
0.8446239
0.0000922
n_stores
0.5641055
0.0151139
latitude
0.5314686
0.0229817
longitude
0.6395548
0.0005623
house_price_unit
0.6861518
0.0284122
Et les communalités sont la somme de ces dernières sur les deux premiers facteurs.
kable(rowSums(saturations^2))
x
transaction_date
0.1673850
house_age
0.8481665
distance_to_station
0.8447161
n_stores
0.5792194
latitude
0.5544503
longitude
0.6401171
house_price_unit
0.7145640
On voit que les variables “house_age” (84.81%), “distance_to_station” (84.47%) et “house_price_unit” (71.45%) sont les mieux exprimées sur ces axes.
Coordonnées factorielles
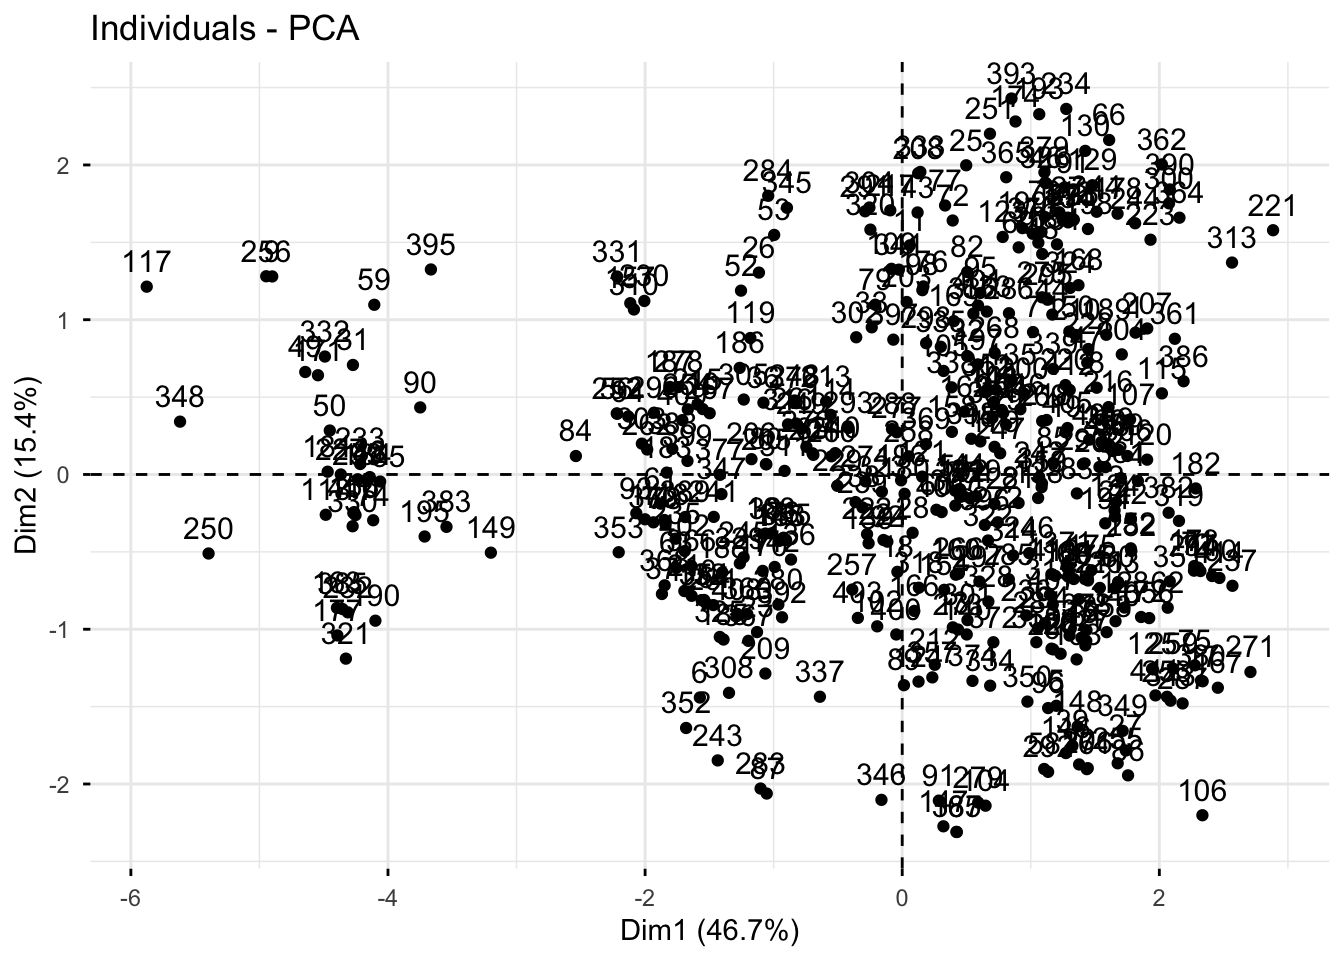
On peut observer les coordonnées factorielles des observations sur les deux premiers facteurs.
fviz_pca_ind(pca_res)
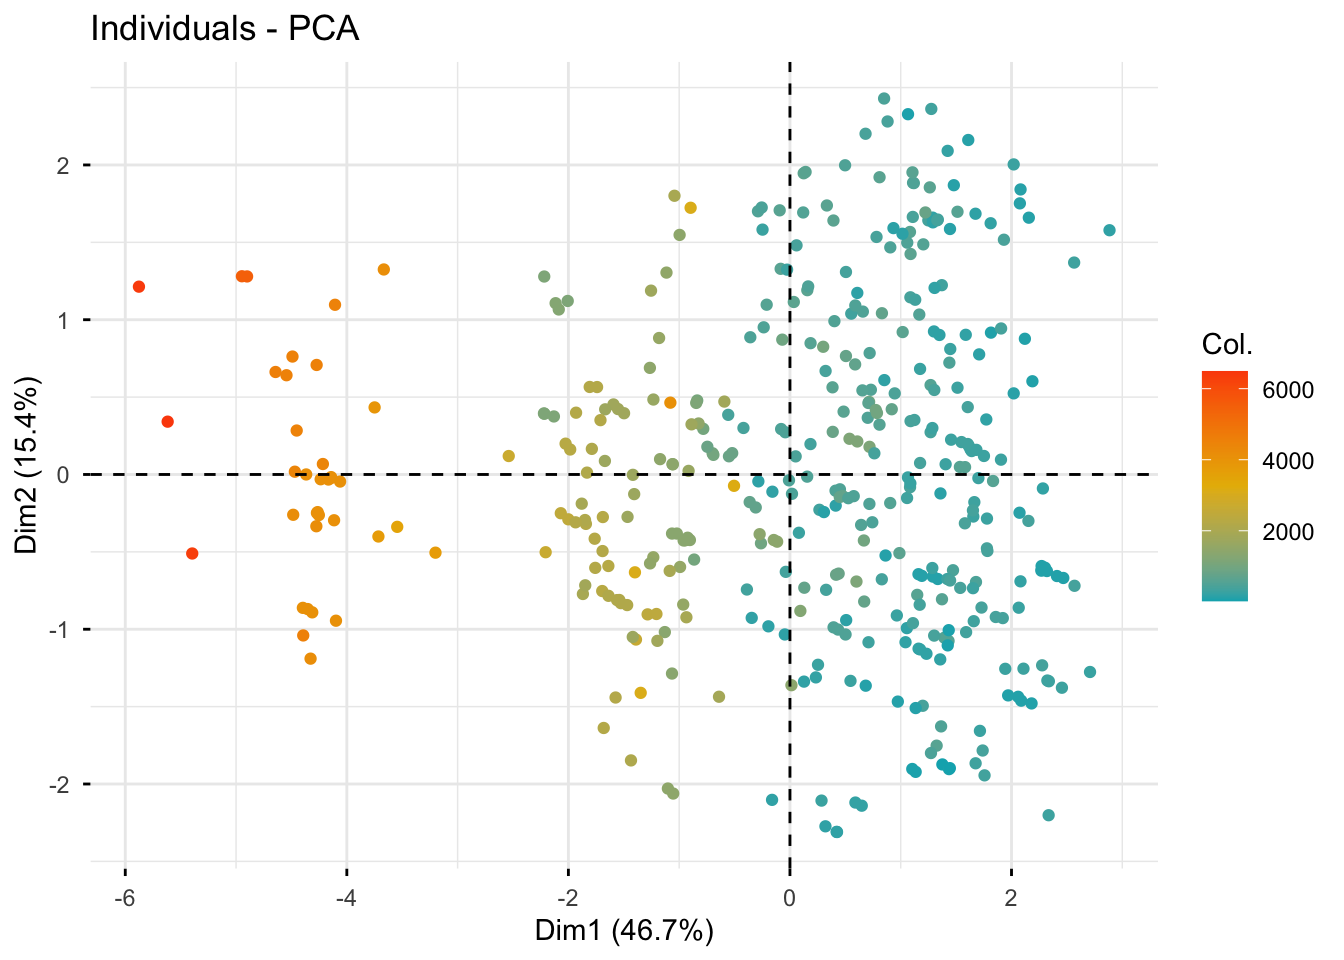
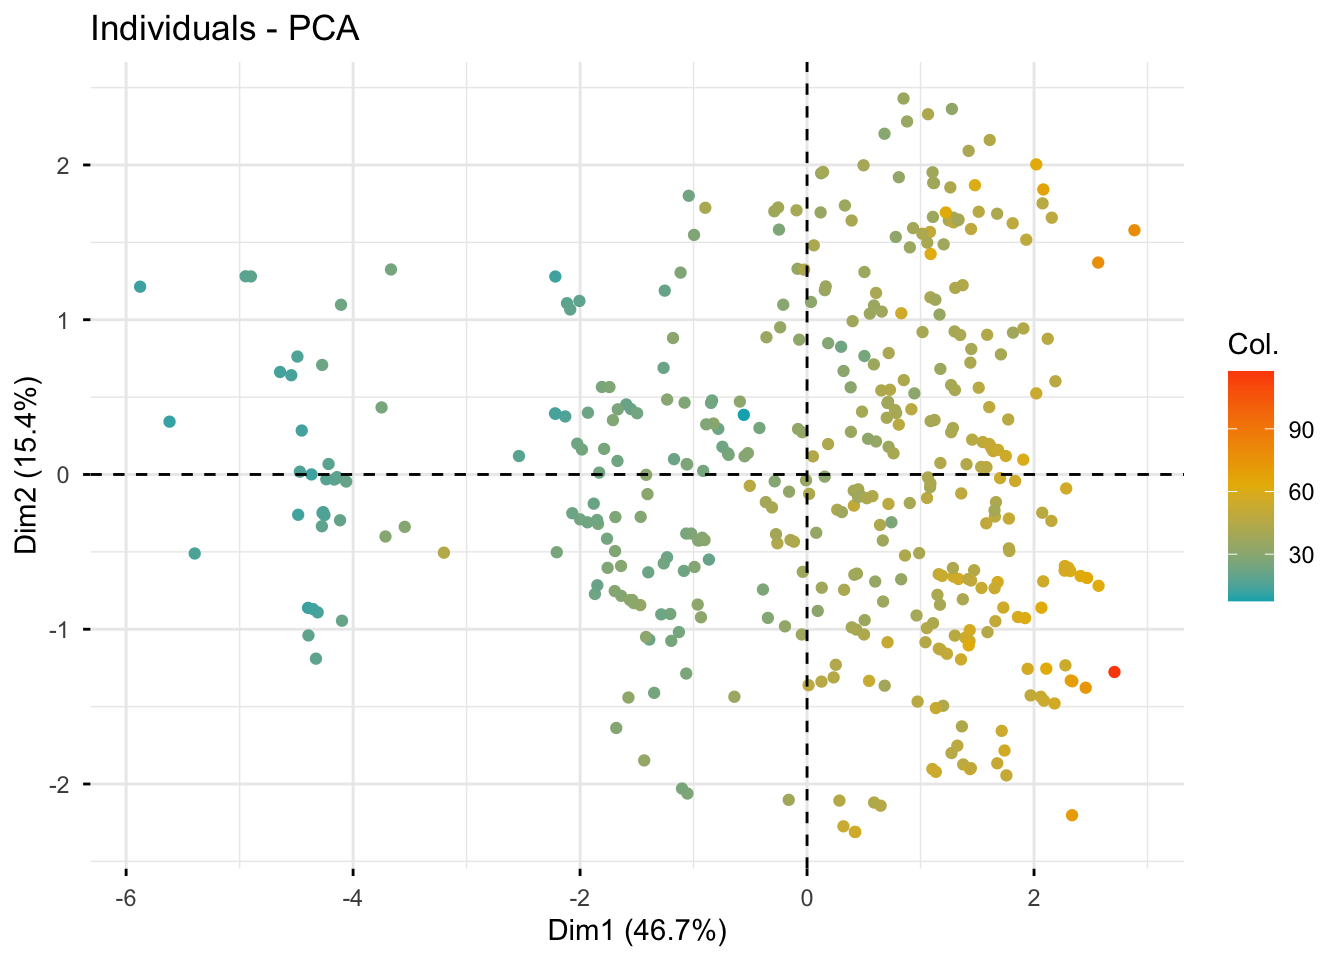
Les individus étant anonymes dans ce jeu de données, ce graphique n’est pas très informatif. On pourrait les colorer selon une variable catégorielle, mais il n’y en a pas dans ce jeu de données.
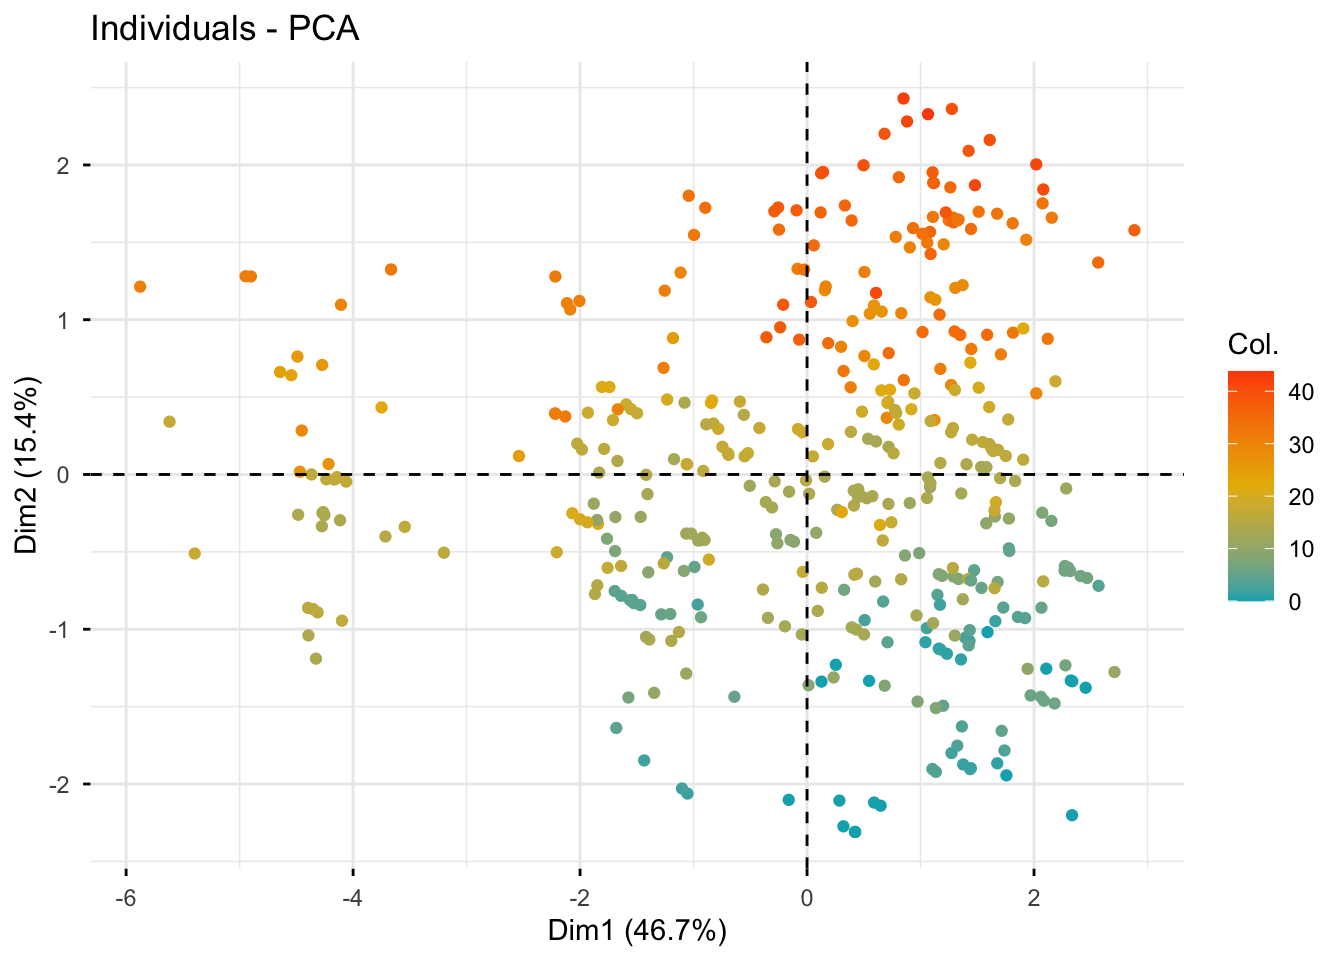
Nous allons ici les colorer selon un gradient d’une des variables numériques. Commençons par “house_age”.
On observe que les maisons plus proches des transports publics (en bleu) se situent à droite du graphique (corrélation négative avec le premier facteur).