data = read.csv("notes.csv")Objectif
Dans cet exemple, nous allons effectuer une régression multiple sur le fichier des notes présenté en cours. Nous allons aussi voir comment selectionner au mieux un modèle avec une méthode très simple (des méthodes plus avancées existent, mais celle-ci est très intuitive et permet de comprendre les enjeux de la sélection de modèle). Enfin, nous allons tester les hypothèses de travail de la régression multiple à l’aide du diagramme des résidus.
Chargement des données
On commence par charger le fichier de données :
Et on récupère le nombre de lignes et le nombre de colonnes dans des variables :
n = dim(data)[1]
p = dim(data)[2]
Régression multiple “à la main”
La régression va s’effectuer sur la note de géographie. Pour calculer la solution de la régression multiple, on commence par construire les matrices \(\mathbf{X}\) des prédicteurs (avec une colonne de \(1\) pour l’ordonnée à l’origine) et le vecteur \(y\) des valeurs à prédire :
y = as.matrix(data$geographie)
X_s1 = as.matrix(data[,-2])
X = cbind(rep(1,n), X_s1)
Puis, on applique la formule vue en cours \(\mathbf{b} = (\mathbf{X}'\mathbf{X})^{-1}\mathbf{X}'\mathbf{y}\) pour calculer les coefficients de régression :
b = solve( t(X) %*% X ) %*% t(X) %*% yRégression avec lm()
Dans R, nous pouvons utiliser la fonction lm() pour faire la régression multiple. Voici comment faire la régression avec tous les prédicteurs :
solution_regression = lm(geographie~., data)On peut ensuite afficher les résultats de la régression avec la fonction summary() :
summary(solution_regression)
Call:
lm(formula = geographie ~ ., data = data)

Residuals:
    Min      1Q  Median      3Q     Max
-3.5676 -0.7147  0.1925  0.9758  2.4374

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)     1.2393     1.0802   1.147   0.2578
francais       -0.2474     0.1582  -1.563   0.1255
physique       -0.2827     0.1742  -1.623   0.1121
chimie          0.1885     0.1897   0.994   0.3260
histoire        0.1688     0.1180   1.430   0.1600
mathematiques   0.4053     0.1532   2.645   0.0115 *
philosophie     0.2097     0.1508   1.390   0.1718
allemand        0.2862     0.1384   2.068   0.0448 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.463 on 42 degrees of freedom
Multiple R-squared:  0.4729,    Adjusted R-squared:  0.385
F-statistic: 5.382 on 7 and 42 DF,  p-value: 0.0001875
La matrice des corrélations s’obtient avec :
cor(data) francais geographie physique chimie histoire mathematiques
francais 1.0000000 0.2303500 0.2220856 0.3874116 0.3731734 0.3792400
geographie 0.2303500 1.0000000 0.3278506 0.5328013 0.4649331 0.4917937
physique 0.2220856 0.3278506 1.0000000 0.6701086 0.4717724 0.5115377
chimie 0.3874116 0.5328013 0.6701086 1.0000000 0.5628448 0.5550321
histoire 0.3731734 0.4649331 0.4717724 0.5628448 1.0000000 0.2634750
mathematiques 0.3792400 0.4917937 0.5115377 0.5550321 0.2634750 1.0000000
philosophie 0.4013254 0.2255641 0.1293331 0.2343086 0.1982596 0.2511257
allemand 0.3784944 0.4974999 0.5334160 0.6372141 0.5887260 0.3298212
philosophie allemand
francais 0.40132536 0.37849441
geographie 0.22556414 0.49749986
physique 0.12933313 0.53341604
chimie 0.23430859 0.63721407
histoire 0.19825959 0.58872598
mathematiques 0.25112573 0.32982118
philosophie 1.00000000 -0.06049144
allemand -0.06049144 1.00000000Sélection de modèle
Nous allons utiliser une méthode de sélection de modèle très simple. Nous allons sortir un par un les prédicteurs qui possèdent la valeur p la plus élevée, jusqu’à ce que tous les prédicteurs soient significatifs.
On commence par faire le modèle complet :
model_complet = lm(geographie~., data)
summary(model_complet)
Call:
lm(formula = geographie ~ ., data = data)

Residuals:
    Min      1Q  Median      3Q     Max
-3.5676 -0.7147  0.1925  0.9758  2.4374

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)     1.2393     1.0802   1.147   0.2578
francais       -0.2474     0.1582  -1.563   0.1255
physique       -0.2827     0.1742  -1.623   0.1121
chimie          0.1885     0.1897   0.994   0.3260
histoire        0.1688     0.1180   1.430   0.1600
mathematiques   0.4053     0.1532   2.645   0.0115 *
philosophie     0.2097     0.1508   1.390   0.1718
allemand        0.2862     0.1384   2.068   0.0448 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.463 on 42 degrees of freedom
Multiple R-squared:  0.4729,    Adjusted R-squared:  0.385
F-statistic: 5.382 on 7 and 42 DF,  p-value: 0.0001875
On voit que le prédicteur chimie a une valeur p de 0.326, ce qui est très élevé. On va donc le retirer du modèle et refaire la régression
opt_model = lm(geographie ~ . -chimie, data)
summary(opt_model)
Call:
lm(formula = geographie ~ . - chimie, data = data)

Residuals:
    Min      1Q  Median      3Q     Max
-3.4138 -0.6358  0.3382  0.9909  2.1947

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)     1.2536     1.0800   1.161  0.25212
francais       -0.2455     0.1582  -1.552  0.12806
physique       -0.2232     0.1636  -1.365  0.17945
histoire        0.1898     0.1161   1.635  0.10926
mathematiques   0.4492     0.1467   3.062  0.00379 **
philosophie     0.2364     0.1484   1.593  0.11858
allemand        0.3345     0.1296   2.581  0.01334 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.463 on 43 degrees of freedom
Multiple R-squared:  0.4605,    Adjusted R-squared:  0.3852
F-statistic: 6.116 on 6 and 43 DF,  p-value: 0.0001077
L’ordonnée à l’origine semble la moins significative, on la retire :
opt_model = lm(geographie ~ . -chimie -1, data)
summary(opt_model)
Call:
lm(formula = geographie ~ . - chimie - 1, data = data)

Residuals:
    Min      1Q  Median      3Q     Max
-3.4713 -0.7403  0.3875  0.9567  2.5719

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
francais       -0.2220     0.1575  -1.409 0.165848
physique       -0.1990     0.1629  -1.222 0.228249
histoire        0.1771     0.1160   1.527 0.133931
mathematiques   0.5021     0.1400   3.587 0.000836 ***
philosophie     0.3215     0.1295   2.482 0.016966 *
allemand        0.3604     0.1281   2.813 0.007312 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.468 on 44 degrees of freedom
Multiple R-squared:  0.9504,    Adjusted R-squared:  0.9436
F-statistic: 140.4 on 6 and 44 DF,  p-value: < 2.2e-16
C’est maintenant le prédicteur physique qui a la p-valeur la plus élevée (0.228), on le retire donc :
opt_model = lm(geographie ~ . -chimie -physique -1, data)
summary(opt_model)
Call:
lm(formula = geographie ~ . - chimie - physique - 1, data = data)

Residuals:
    Min      1Q  Median      3Q     Max
-3.4444 -0.8875  0.2969  0.9237  2.5781

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
francais       -0.1902     0.1562  -1.217  0.22984
histoire        0.1480     0.1141   1.296  0.20144
mathematiques   0.4188     0.1230   3.407  0.00139 **
philosophie     0.2932     0.1282   2.288  0.02689 *
allemand        0.3045     0.1203   2.530  0.01496 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.476 on 45 degrees of freedom
Multiple R-squared:  0.9487,    Adjusted R-squared:  0.943
F-statistic: 166.3 on 5 and 45 DF,  p-value: < 2.2e-16
Avec une valeur p de 0.230, c’est francais qui sort du modèle :
opt_model = lm(geographie ~ . -chimie -physique -francais -1, data)
summary(opt_model)
Call:
lm(formula = geographie ~ . - chimie - physique - francais -
    1, data = data)

Residuals:
    Min      1Q  Median      3Q     Max
-3.2826 -0.8084  0.4489  0.9491  2.6116

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
histoire        0.1378     0.1144   1.205  0.23450
mathematiques   0.3809     0.1196   3.186  0.00259 **
philosophie     0.2137     0.1108   1.928  0.06002 .
allemand        0.2603     0.1153   2.257  0.02879 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.484 on 46 degrees of freedom
Multiple R-squared:  0.947, Adjusted R-squared:  0.9424
F-statistic: 205.4 on 4 and 46 DF,  p-value: < 2.2e-16
Au tour de l’histoire (p=0.309), on va maintenant écrire la formule avec les prédicteurs restants :
opt_model = lm(geographie ~ mathematiques + philosophie + allemand -1, data)
summary(opt_model)
Call:
lm(formula = geographie ~ mathematiques + philosophie + allemand -
    1, data = data)

Residuals:
    Min      1Q  Median      3Q     Max
-3.5454 -1.1152  0.3651  1.0175  3.0257

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
mathematiques  0.37794    0.12010   3.147 0.002863 **
philosophie    0.25387    0.10620   2.390 0.020885 *
allemand       0.34272    0.09333   3.672 0.000614 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.491 on 47 degrees of freedom
Multiple R-squared:  0.9453,    Adjusted R-squared:  0.9418
F-statistic: 270.8 on 3 and 47 DF,  p-value: < 2.2e-16
Tous les prédicteurs sont significatifs, on s’arrête là. Le \(R^2\)-ajusté de ce modèle est de 0.94, ce qui est plutôt bon.
Tester les hypothèses de travail
Pour tester les hypothèses de travail, on va afficher les diagramme des résidus :
plot(opt_model$fitted.values, opt_model$residuals)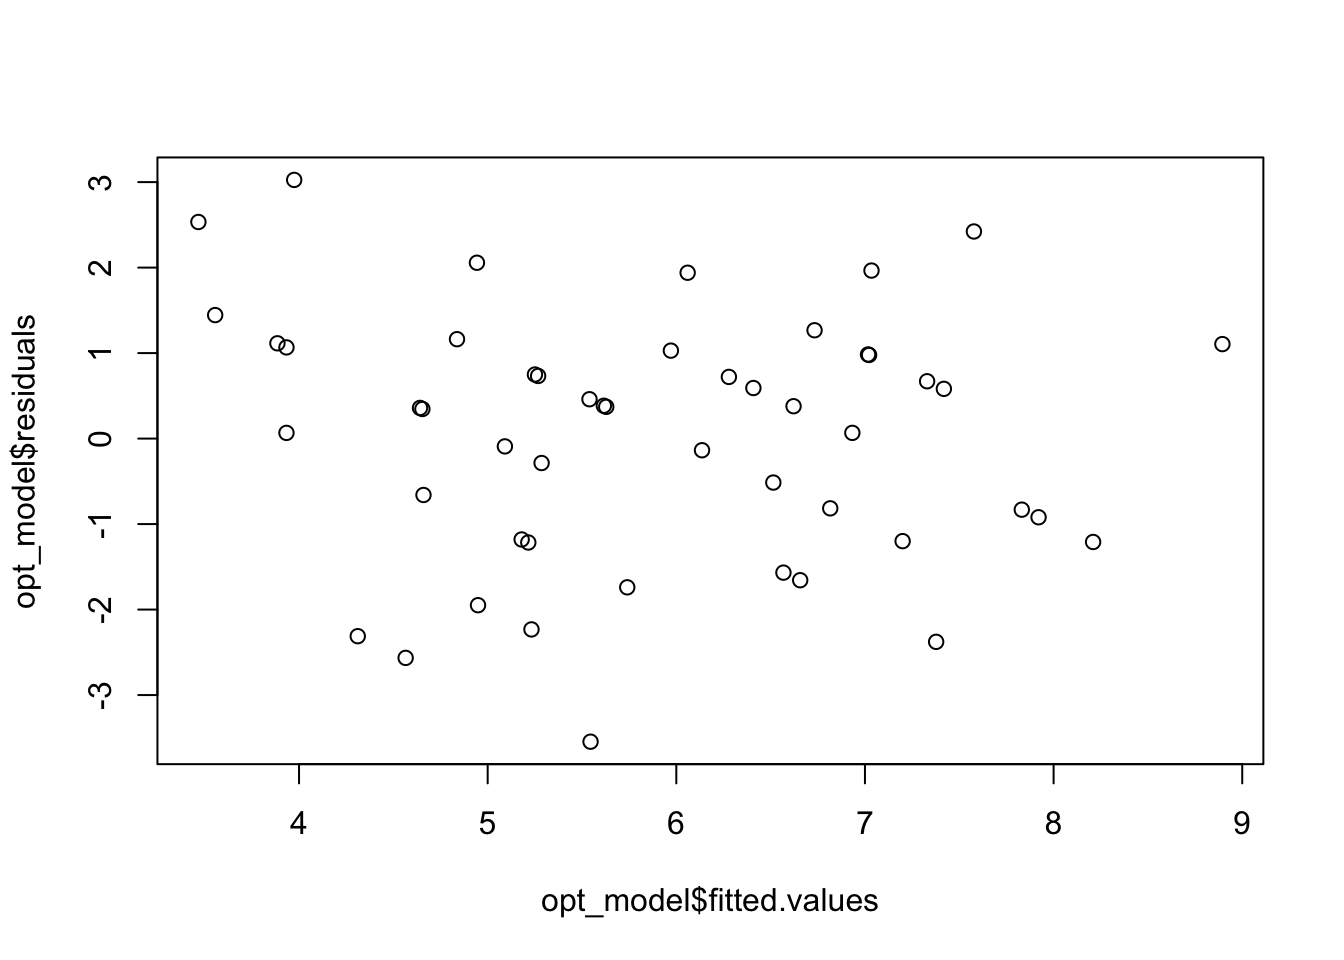
Il n’y a pas d’hétéroscédasticité, les résidus semblent répartis selon une loi normale, et la linéarité apparaît vraisemblable. Les hypothèses de travail peuvent être considérées comme valides.