import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn import tree
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split, GridSearchCV
import graphviz
file_path = \
  "/content/drive/MyDrive/Colab Notebooks/ml_data/TP7/contraceptive.tsv"
data = pd.read_csv(file_path, sep="\t")
data| Wife_age | Wife_education | Husband_education | Children | Wife_religion | Wife_working | Husband_occupation | Standard-of-living | Media_exposure | target | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 24 | 2 | 3 | 3 | 1 | 1 | 2 | 3 | 0 | 1 |
| 1 | 45 | 1 | 3 | 10 | 1 | 1 | 3 | 4 | 0 | 1 |
| 2 | 43 | 2 | 3 | 7 | 1 | 1 | 3 | 4 | 0 | 1 |
| 3 | 42 | 3 | 2 | 9 | 1 | 1 | 3 | 3 | 0 | 1 |
| 4 | 36 | 3 | 3 | 8 | 1 | 1 | 3 | 2 | 0 | 1 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 1468 | 33 | 4 | 4 | 2 | 1 | 0 | 2 | 4 | 0 | 3 |
| 1469 | 33 | 4 | 4 | 3 | 1 | 1 | 1 | 4 | 0 | 3 |
| 1470 | 39 | 3 | 3 | 8 | 1 | 0 | 1 | 4 | 0 | 3 |
| 1471 | 33 | 3 | 3 | 4 | 1 | 0 | 2 | 2 | 0 | 3 |
| 1472 | 17 | 3 | 3 | 1 | 1 | 1 | 2 | 4 | 0 | 3 |
1473 rows × 10 columns
occ_dummies = pd.get_dummies(data["Husband_occupation"], prefix="occ")
inputs = pd.concat([data.drop(["Husband_occupation", "target"], axis=1),
                    occ_dummies], axis=1)
outputs = data["target"]
classif_tree = tree.DecisionTreeClassifier(ccp_alpha=0.005).fit(inputs, outputs)
gvz_data = tree.export_graphviz(classif_tree, out_file=None,
feature_names=inputs.columns,
filled=True, rounded=True,
special_characters=True)
graph = graphviz.Source(gvz_data)
graph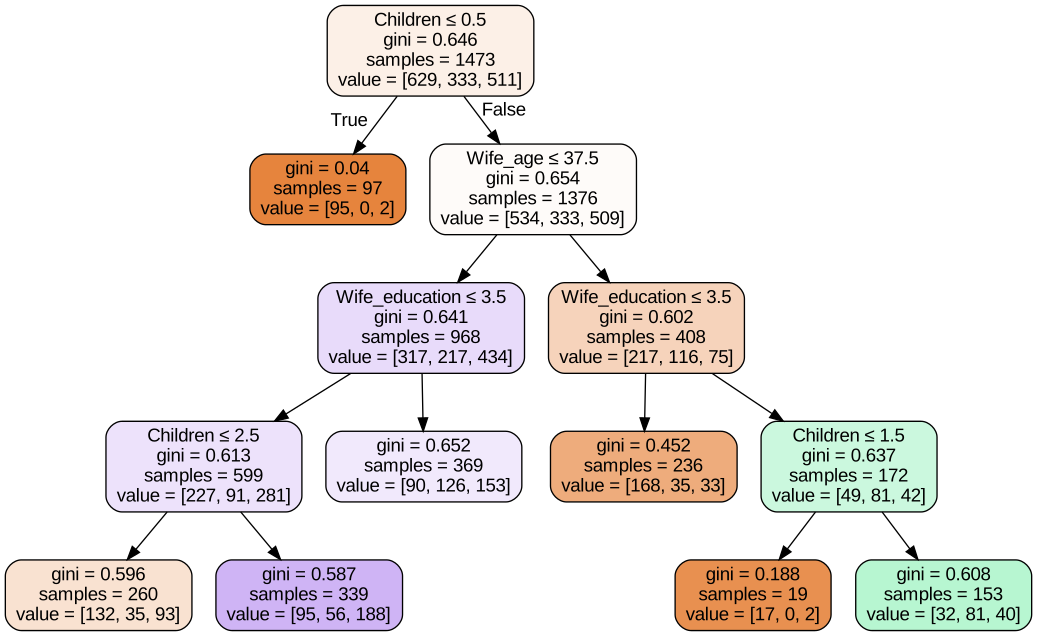
inputs_tv, inputs_test, outputs_tv, outputs_test = train_test_split(inputs,
                                                                    outputs)
logreg_param = {"C": np.linspace(0.001, 2, 20)}
logreg_grid = GridSearchCV(LogisticRegression(max_iter=1000), logreg_param).fit(
inputs_tv, outputs_tv)print(f"Logreg best param: {logreg_grid.best_params_}")
print(f"Score: {logreg_grid.best_estimator_.score(inputs_test, outputs_test)}")Logreg best param: {'C': 0.10621052631578948}
Score: 0.4823848238482385forest_hyperp = {"max_depth": range(1, 11)}
forest_grid = GridSearchCV(RandomForestClassifier(), forest_hyperp).fit(
inputs_tv, outputs_tv)print(f"Forest best param: {forest_grid.best_params_}")
print(f"Score: {forest_grid.best_estimator_.score(inputs_test, outputs_test)}")Forest best param: {'max_depth': 9}
Score: 0.5745257452574526grad_hyperp = {"max_depth": range(1, 11)}
grad_grid = GridSearchCV(GradientBoostingClassifier(), grad_hyperp).fit(
inputs_tv, outputs_tv)print(f"GB best param: {grad_grid.best_params_}")
print(f"Score: {grad_grid.best_estimator_.score(inputs_test, outputs_test)}")GB best param: {'max_depth': 2}
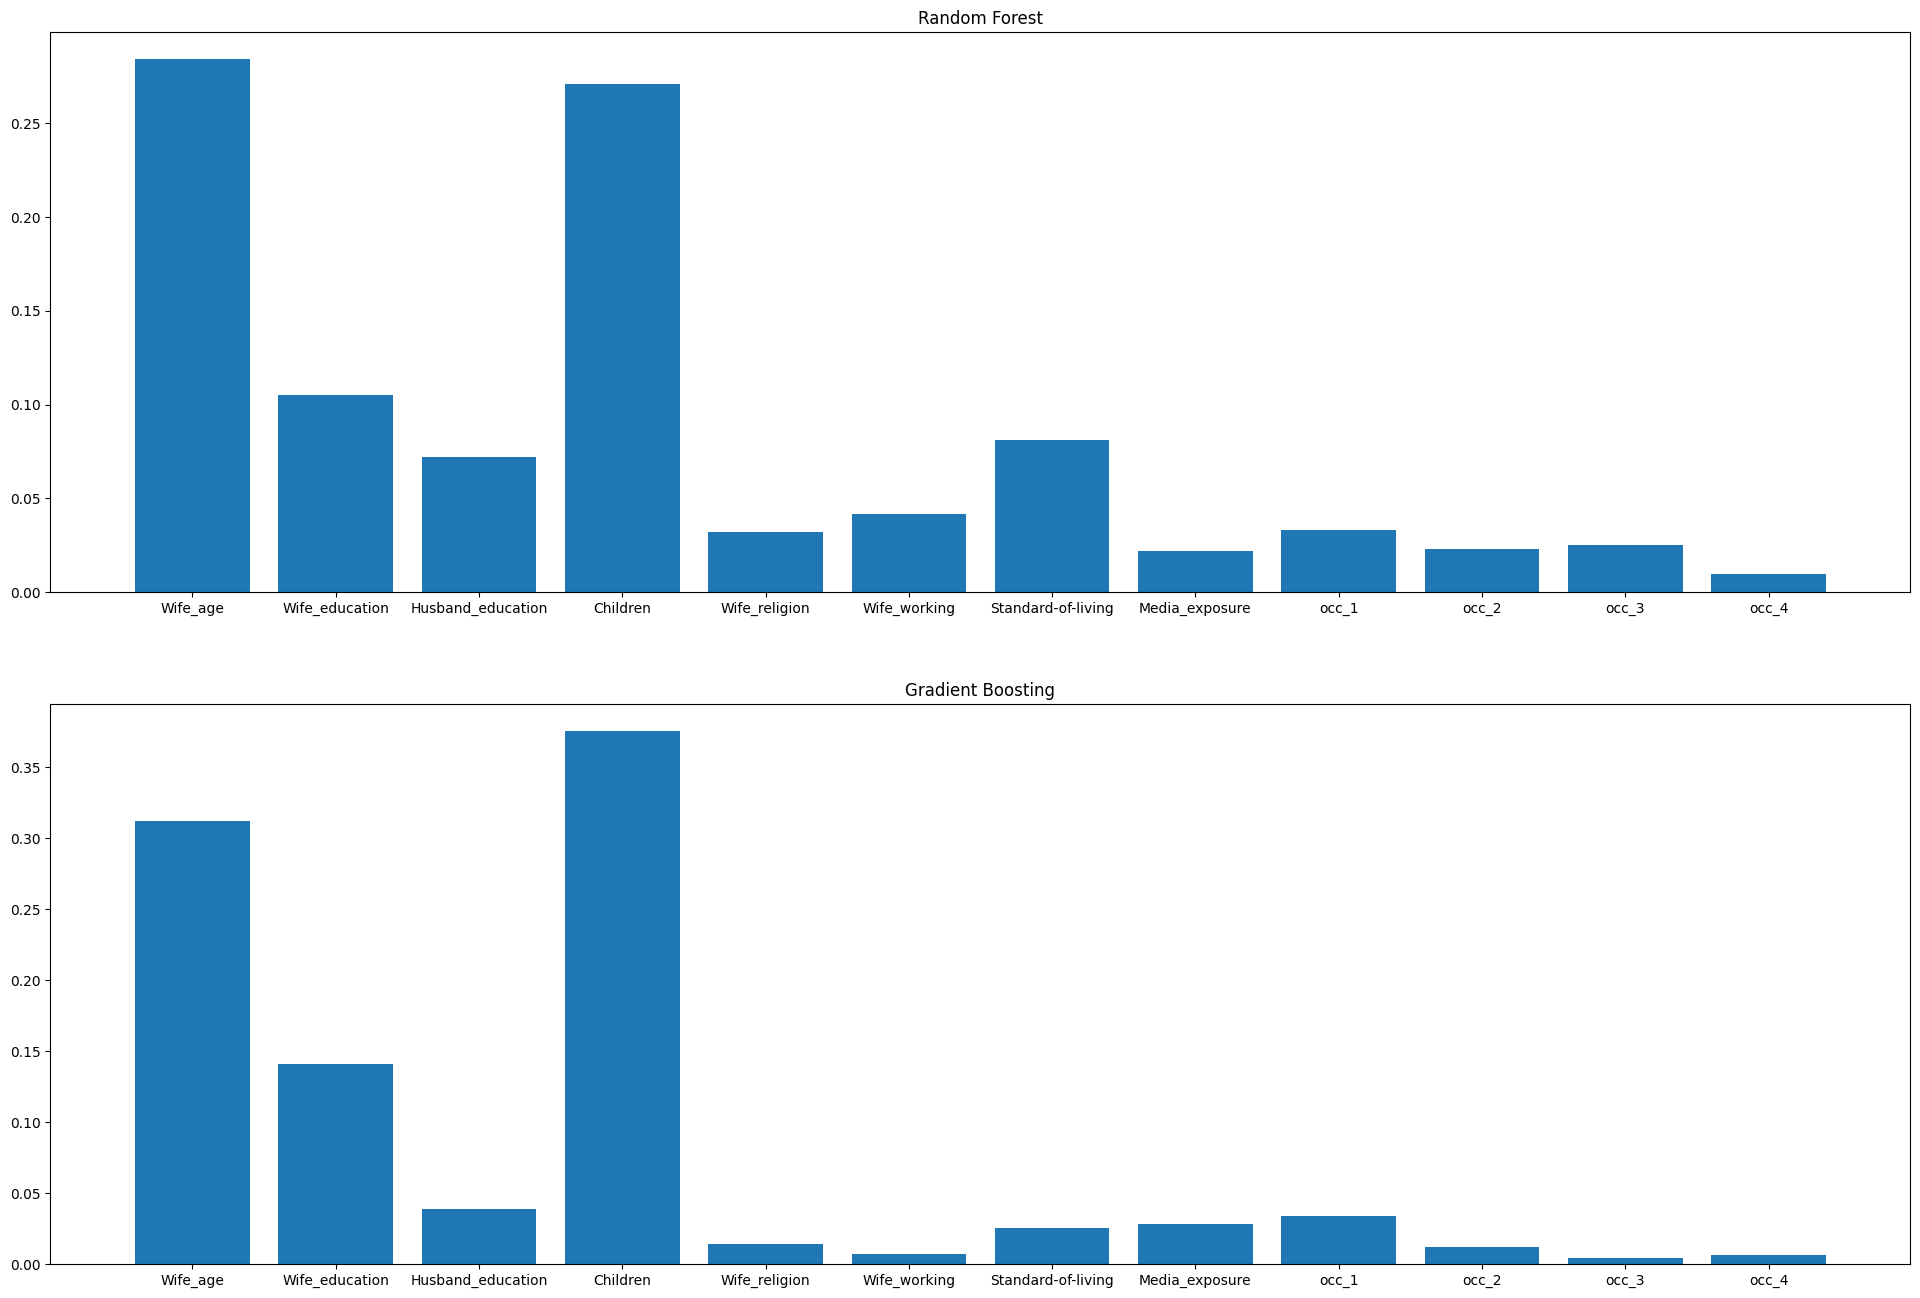
Score: 0.5772357723577236grad_grid.best_estimator_.feature_importances_array([0.31193486, 0.1412974 , 0.03908564, 0.3757166 , 0.01428982,
0.00699875, 0.02562592, 0.02850556, 0.0336479 , 0.01214036,
0.00404404, 0.00671316])plt.rcParams['figure.figsize'] = [24, 16]
fig, axs = plt.subplots(2, 1)
# Forest classification
axs[0].bar(inputs.columns, forest_grid.best_estimator_.feature_importances_)
axs[0].set_title("Random Forest")
# Gradient boosting
axs[1].bar(inputs.columns, grad_grid.best_estimator_.feature_importances_)
axs[1].set_title("Gradient Boosting")
plt.plot()