!pip install -qq transformers
TP 12 : BERT fine-tuning
Dans ce TP, nous allons construire un modèle d’analyse des sentiments avec comme base un modèle BERT pré-entrainé. Nous allons ajouter une couche entièrement connectée à la sortie (du premier token) d’un modèle BERT, projetant le vecteur de contexte de BERT sur un seul neurone sensé représenter le log-odd de la séquence d’appartenir à la classe “sentiment positif”.
Pour entrainer notre modèle, nous allons utiliser le jeu de données “Large Movie Review Dataset” (https://www.kaggle.com/datasets/lakshmi25npathi/imdb-dataset-of-50k-movie-reviews), qui contient 50’000 évaluations de films faites par des utilisateurs sur IMDB. Ces reviews ont une annotation comme étant positives ou négatives.
Notre module d’analyse des sentiments va ensuite servir (même si l’entrainement sur des évaluations de films est discutable pour cette utilisation) à évaluer le sentiment positif/négatif qui se dégage à l’intérieur de chaque livre des Misérables.
Le modèle BERT pré-entrainé sera issu de https://huggingface.co/, où l’on peut trouver une grande quantité de modèles pré-entrainés. Ces modèles se téléchargent et s’utilisent généralement en utilisant la librairie transformers, qu’il faut prélablement installer.
On va utiliser les librairies suivantes :
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.gridspec import GridSpec
import os
import torch
import torch.nn as nn
from torch.utils.data import Dataset, DataLoader, random_split
import transformers
from transformers import BertModel, BertTokenizer, \
  get_linear_schedule_with_warmup
from tqdm import tqdm
Et nous allons utiliser l’accélération graphique, si elle est disponible :
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(device)cuda:01. Construction et finetuning du modèle
Avant de construire notre modèle, regardons nos données. On les charge et les affiche. La colonne “review” contient la critique, et la colonne “sentiment” l’appréciation, qui peut être “positive” ou “negative”. Il s’agira de traduire ces deux colonnes dans des données utilisables par notre modèle. Nous y reviendrons après avoir examiné le modèle que nous allons utiliser.
data_path = "/content/drive/MyDrive/Colab Notebooks/" \
              "ml_data/TP12/IMDB Dataset.csv"
data = pd.read_csv(data_path)
data| review | sentiment | |
|---|---|---|
| 0 | One of the other reviewers has mentioned that ... | positive |
| 1 | A wonderful little production. <br /><br />The... | positive |
| 2 | I thought this was a wonderful way to spend ti... | positive |
| 3 | Basically there's a family where a little boy ... | negative |
| 4 | Petter Mattei's "Love in the Time of Money" is... | positive |
| ... | ... | ... |
| 49995 | I thought this movie did a down right good job... | positive |
| 49996 | Bad plot, bad dialogue, bad acting, idiotic di... | negative |
| 49997 | I am a Catholic taught in parochial elementary... | negative |
| 49998 | I'm going to have to disagree with the previou... | negative |
| 49999 | No one expects the Star Trek movies to be high... | negative |
50000 rows × 2 columns
Après avoir trouvé un modèle qui semble convenir sur https://huggingface.co/, nous pouvons sauvegarder son nom dans une variable. Ici deux modèles sont suggérés :
"bert-base-uncased": le modèle qui est le plus fréquemment utilisé lorsque l’on utilise BERT, mais qui est relativement volumineux."prajjwal1/bert-mini": un modèle miniature de BERT, permettant des calculs plus rapides au détriment d’une moins bonne représentation des séquences d’entrée.
Vous pouvez décommenter le modèle qui vous convient, ou en trouver encore un autre. Les deux modèles sont “uncased”, c’est-à-dire qu’ils ne prennent pas en compte les majuscules.
# model_name = "bert-base-uncased"
model_name = "prajjwal1/bert-mini"
Les modèles de la librairie transformers proposent des tokenisateurs associés, permettant ainsi de pré-traiter les données textuelles de manière à les rendre compatible avec les entrées attendues. Nous allons charger le tokenisateur de type BERT basé sur le nom de notre modèle.
model_name.split("-")[0]'prajjwal1/bert'tokenizer = BertTokenizer.from_pretrained(model_name)Regardons quelques opérations qu’il est possible d’effectuer avec cet objet, tel que la séparation et la transformation en identifiants numériques d’une chaine de caractères.
example_text = "We are going to train a model, for sentiment classification!"
tokens = tokenizer.tokenize(example_text)
token_ids = tokenizer.convert_tokens_to_ids(tokens)
print(example_text)
print(tokens)
print(token_ids)
We are going to train a model, for sentiment classification!
['we', 'are', 'going', 'to', 'train', 'a', 'model', ',', 'for', 'sentiment', 'classification', '!']
[2057, 2024, 2183, 2000, 3345, 1037, 2944, 1010, 2005, 15792, 5579, 999]La méthode encode_plus() permet un traitement plus complet d’une chaine de caractères, en donnant non seulement la traduction en identifiants numériques des différents tokens, mais aussi le masque pour le méchanisme d’attention. Différentes options sont possibles, telles que la longueur maximale des séquences (max_length=32) et le type de tenseurs à donner (tenseurs de Pytorch avec return_tensors="pt").
encoding = tokenizer.encode_plus(
    example_text,
    truncation=True,
    max_length=32,
    add_special_tokens=True,
    return_token_type_ids=False,
    padding="max_length",
    return_attention_mask=True,
    return_tensors="pt"
)
print(encoding["input_ids"])
print(encoding["attention_mask"])
tensor([[ 101, 2057, 2024, 2183, 2000, 3345, 1037, 2944, 1010, 2005,
15792, 5579, 999, 102, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0]])
tensor([[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0]])Cette méthode nous permet donc de construire une transformation que nous allons utiliser sur notre dataset, où l’on précise la longueur maximale des séquences et le tokenisateur à utiliser.
def my_transform(text, tokenizer, max_length):

  # L'encodage
  encoding = tokenizer.encode_plus(
      text,
      truncation=True,
      max_length=max_length,
      add_special_tokens=True,
      return_token_type_ids=False,
      padding="max_length",
      return_attention_mask=True,
      return_tensors="pt",
  )
  # Retour de l'encodage et du masque
  return encoding["input_ids"].flatten(), encoding["attention_mask"].flatten()
Il est temps de créer notre classe héritée de torch.utils.data.Dataset. Nous transformons les sorties en valeurs numériques (avec 1 = “positive”, 0 = “negative”), puis en array numpy. Lorsqu’un élément du dataset est demandé, nous appliquons la transformation (donnée en argument) et transformons la sortie en tenseur.
class MyDataset(Dataset):

  # Constructeur
  def __init__(self, data_path, transform, tokenizer, sent_len):
    # On charge les données
    df = pd.read_csv(data_path)
    self.inputs = df.review.to_numpy()
    self.probs = (df.sentiment == "positive").to_numpy()
    self.transform = transform
    self.tokenizer = tokenizer
    self.sent_len = sent_len

  # Longueur
  def __len__(self):
    return len(self.probs)

  # Un élément
  def __getitem__(self, index):
    input = self.transform(str(self.inputs[index]),
                           self.tokenizer,
                           self.sent_len)
    prob = torch.tensor(self.probs[index], dtype=torch.float32)
    return input, prob
Créons une instance de notre classe pour notre dataset, et regardons un élément. Une séquence d’entiers et le masque sont donnés comme éléments d’entrée.
max_length = 512
data_path = "/content/drive/MyDrive/Colab Notebooks/" \
              "ml_data/TP12/IMDB Dataset.csv"
my_data = MyDataset(data_path, my_transform, tokenizer, max_length)
my_data[0]
((tensor([ 101, 2028, 1997, 1996, 2060, 15814, 2038, 3855, 2008, 2044,
3666, 2074, 1015, 11472, 2792, 2017, 1005, 2222, 2022, 13322,
1012, 2027, 2024, 2157, 1010, 2004, 2023, 2003, 3599, 2054,
3047, 2007, 2033, 1012, 1026, 7987, 1013, 1028, 1026, 7987,
1013, 1028, 1996, 2034, 2518, 2008, 4930, 2033, 2055, 11472,
2001, 2049, 24083, 1998, 4895, 10258, 2378, 8450, 5019, 1997,
4808, 1010, 2029, 2275, 1999, 2157, 2013, 1996, 2773, 2175,
1012, 3404, 2033, 1010, 2023, 2003, 2025, 1037, 2265, 2005,
1996, 8143, 18627, 2030, 5199, 3593, 1012, 2023, 2265, 8005,
2053, 17957, 2007, 12362, 2000, 5850, 1010, 3348, 2030, 4808,
1012, 2049, 2003, 13076, 1010, 1999, 1996, 4438, 2224, 1997,
1996, 2773, 1012, 1026, 7987, 1013, 1028, 1026, 7987, 1013,
1028, 2009, 2003, 2170, 11472, 2004, 2008, 2003, 1996, 8367,
2445, 2000, 1996, 17411, 4555, 3036, 2110, 7279, 4221, 12380,
2854, 1012, 2009, 7679, 3701, 2006, 14110, 2103, 1010, 2019,
6388, 2930, 1997, 1996, 3827, 2073, 2035, 1996, 4442, 2031,
3221, 21430, 1998, 2227, 20546, 2015, 1010, 2061, 9394, 2003,
2025, 2152, 2006, 1996, 11376, 1012, 7861, 2103, 2003, 2188,
2000, 2116, 1012, 1012, 26030, 2015, 1010, 7486, 1010, 18542,
10230, 1010, 7402, 2015, 1010, 8135, 1010, 16773, 1010, 3493,
1998, 2062, 1012, 1012, 1012, 1012, 2061, 8040, 16093, 28331,
1010, 2331, 14020, 1010, 26489, 6292, 24069, 1998, 22824, 10540,
2024, 2196, 2521, 2185, 1012, 1026, 7987, 1013, 1028, 1026,
7987, 1013, 1028, 1045, 2052, 2360, 1996, 2364, 5574, 1997,
1996, 2265, 2003, 2349, 2000, 1996, 2755, 2008, 2009, 3632,
2073, 2060, 3065, 2876, 1005, 1056, 8108, 1012, 5293, 3492,
4620, 4993, 2005, 7731, 9501, 1010, 5293, 11084, 1010, 5293,
7472, 1012, 1012, 1012, 11472, 2987, 1005, 1056, 6752, 2105,
1012, 1996, 2034, 2792, 1045, 2412, 2387, 4930, 2033, 2004,
2061, 11808, 2009, 2001, 16524, 1010, 1045, 2481, 1005, 1056,
2360, 1045, 2001, 3201, 2005, 2009, 1010, 2021, 2004, 1045,
3427, 2062, 1010, 1045, 2764, 1037, 5510, 2005, 11472, 1010,
1998, 2288, 17730, 2000, 1996, 2152, 3798, 1997, 8425, 4808,
1012, 2025, 2074, 4808, 1010, 2021, 21321, 1006, 15274, 4932,
2040, 1005, 2222, 2022, 2853, 2041, 2005, 1037, 15519, 1010,
13187, 2040, 1005, 2222, 3102, 2006, 2344, 1998, 2131, 2185,
2007, 2009, 1010, 2092, 5450, 2098, 1010, 2690, 2465, 13187,
2108, 2357, 2046, 3827, 7743, 2229, 2349, 2000, 2037, 3768,
1997, 2395, 4813, 2030, 3827, 3325, 1007, 3666, 11472, 1010,
2017, 2089, 2468, 6625, 2007, 2054, 2003, 8796, 10523, 1012,
1012, 1012, 1012, 2008, 2015, 2065, 2017, 2064, 2131, 1999,
3543, 2007, 2115, 9904, 2217, 1012, 102, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0]),
tensor([1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0])),
tensor(1.))Séparons notre jeu de données en jeux d’entrainement, validation et test, avec les proportions 70% - 15% - 15%.
valid_ratio = 0.15
test_ratio = 0.15
valid_size = int(valid_ratio * len(my_data))
test_size = int(test_ratio * len(my_data))
train_size = len(my_data) - valid_size - test_size
my_data_train, my_data_valid, my_data_test = \
  random_split(my_data, [train_size, valid_size, test_size])
print(train_size, valid_size, test_size)
35000 7500 7500Créons les Dataloaders, avec batch de 32. Le paramètre num_workers nous permet d’attribuer plus de processus chargés d’envoyer les données.
batch_size = 16
train_loader = DataLoader(my_data_train, batch_size, num_workers=2)
valid_loader = DataLoader(my_data_valid, batch_size, num_workers=2)
test_loader = DataLoader(my_data_test, batch_size, num_workers=2)
La classe transformers.BertModel nous permet des créer des instances de modèles pré-entrainés, grâce à sa méthode from_pretrained(), à partir d’un nom de modèle Hugging Face. Le modèle est téchargé et mis en mémoire.
bert_model = BertModel.from_pretrained(model_name)En passant un exemple de notre jeu de données dans ce modèle, nous pouvons voir la sortie, qui est constituée de deux éléments last_hidden_state et pooler_output. Ces deux sorties contiennent :
last_hidden_state: les sorties cachées de la dernière couche du modèle, avec un vecteur d’une taille définie (par la modèle) pour chaque token d’entrée.pooler_output: le vecteur caché du premier élément de la phrase, correspondant au token [CLS], et qui sert de résumé pour toute la phrase.
input, _ = my_data[0]
bert_output = bert_model(input_ids=input[0].unsqueeze(0),
                         attention_mask=input[1].unsqueeze(0))
bert_output.keys()
odict_keys(['last_hidden_state', 'pooler_output'])print(bert_output["last_hidden_state"].shape)
print(bert_output["pooler_output"].shape)torch.Size([1, 512, 256])
torch.Size([1, 256])Nous allons maintenant créer un modèle qui consiste en : * Un modèle pré-entrainé de type BERT. * Une couche entièrement connectée qui prend le premier état caché de la sortie du modèle BERT (avec dropout) et l’envoie sur une seule sortie, nous servant ainsi de log-odds pour le sentiment positif.
Notez que la taille du vecteur caché peut s’obtenir en utilisant l’attribut bert.config.hidden_size, permettant ainsi de définir le bon nombre de neurones dans la couche entièrement connectée.
class SentClassifier(nn.Module):

  def __init__(self, bert_model_name):
    super(SentClassifier, self).__init__()
    self.bert = BertModel.from_pretrained(bert_model_name)
    self.drop = nn.Dropout(p=0.3)
    self.full = nn.Linear(self.bert.config.hidden_size, 1)

  def forward(self, input_ids, attention_mask):
    bert_output = self.bert(input_ids, attention_mask)
    dropout = self.drop(bert_output["pooler_output"])
    logits = self.full(dropout)
    return logits
Vérifions que notre modèle fonctionne correctement en lui envoyant une entrée de notre jeu de données.
my_model = SentClassifier(model_name)
my_model.to(device)
my_model(input[0].unsqueeze(0).to(device), input[1].unsqueeze(0).to(device))
tensor([[-0.5546]], device='cuda:0', grad_fn=<AddmmBackward0>)L’entrainement du modèle va s’effectuer d’une manière légèrement plus complexe que les dernières fois. Nous allons utiliser ici un ordonnanceur pour le taux d’apprentissage, avec une instance de classe obtenu avec la fonction transformers.get_linear_schedule_with_warmup(). Cette instance permet de faire varier le taux d’apprentissage en fonction des itérations. Le taux d’apprentissage commence à 0, monte rapidement jusqu’à sa valeur maximale définie dans l’optimisateur, puis diminue lentement jusqu’à le nombre d’itérations maximal (len(train_loader) * n_epochs). Cette procédure permet de chercher plus efficacement un minimum dans la fonctionnelle. Pour en savoir plus, voir https://huggingface.co/docs/transformers/main_classes/optimizer_schedules#transformers.get_linear_schedule_with_warmup.optimizer.
La fonction de perte est torch.nn.BCEWithLogitsLoss() qui permet de comparer une sortie entre un log-odd vs une valeur binaire.
n_epochs = 10
optimizer = torch.optim.AdamW(my_model.parameters(), lr=2e-5)
scheduler = get_linear_schedule_with_warmup(
  optimizer,
  num_warmup_steps=0,
  num_training_steps=len(train_loader) * n_epochs
)
loss_fn = nn.BCEWithLogitsLoss()
Nous allons aussi implémenter un arrêt prématuré dans notre entrainement. Pour cela, nous allons sauver le modèle (sous checkpoint_path) à chaque fois que celui-ci diminue la perte de validation, et nous arrêterons l’entrainement si la perte d’entrainement n’a pas diminué durant patience epochs. Il nous suffira de revenir au dernier modèle sauvé pour avoir celui qui présente les meilleurs performances de validation.
patience = 3
checkpoint_path = "checkpoint.pt"
Nous allons maintenant effectuer l’entrainement. Vous pouvez lire les commentaires ci-dessous pour avoir les détails.
# Valeur initiale de la perte minimale obtenue (artificiellement
# élevée initialement) pour l'arrêt prématuré
lowest_valid_loss = 1e5
# Le conteur de patience
patience_counter = 0
# La boucle sur les epochs
for epoch in range(n_epochs):

  print(f"Epoch {epoch + 1}/{n_epochs}")

  # --- Training

  my_model.train()
  sum_train_loss = 0
  sum_train_acc = 0
  # La boucle sur le loader d'entrainement
  for (input_ids, masks), outputs in tqdm(train_loader):
    input_ids = input_ids.to(device)
    masks = masks.to(device)
    outputs = outputs.to(device).unsqueeze(1)

    optimizer.zero_grad()
    logits = my_model(input_ids, masks)
    loss = loss_fn(logits, outputs)
    loss.backward()
    # On procède ici au gradient clipping, pour être sur que celui-ci
    # ne déborde pas.
    nn.utils.clip_grad_norm_(my_model.parameters(), max_norm=1.0)
    # Notre optimisateur et notre ordonnanceur son mis à jour
    optimizer.step()
    scheduler.step()

    sum_train_loss += loss.detach().item()
    sum_train_acc += ((logits.flatten() > 0) ==
                      outputs.flatten()).detach().sum().item()

  # --- Validation

  my_model.eval()
  sum_valid_loss = 0
  sum_valid_acc = 0
  for (input_ids, masks), outputs in tqdm(valid_loader):
    input_ids = input_ids.to(device)
    masks = masks.to(device)
    outputs = outputs.to(device).unsqueeze(1)

    logits = my_model(input_ids, masks)
    loss = loss_fn(logits, outputs)

    sum_valid_loss += loss.detach()
    sum_valid_acc += ((logits.flatten() > 0) ==
                      outputs.flatten()).detach().sum().item()

  train_loss = sum_train_loss/len(train_loader)
  train_acc = sum_train_acc/len(train_loader.dataset)
  valid_loss = sum_valid_loss/len(valid_loader)
  valid_acc = sum_valid_acc/len(valid_loader.dataset)

  print(f"Train loss: {train_loss:.4f}, Valid loss: {valid_loss:.4f}")
  print(f"Train accuracy: {train_acc:.2%}, Valid accuracy: {valid_acc:.2%}")

  # --- Pour l'arrêt prématuré

  # Si la perte de validation est plus petite que la dernière enregistrée,
  # on effectue un checkpoint du modèle
  if valid_loss < lowest_valid_loss:
    print(f"***{valid_loss:.4f} < {lowest_valid_loss:.4f}, saving.***")
    torch.save({"model_state_dict": my_model.state_dict(),
                "optimizer_state_dict": optimizer.state_dict(),
                "scheduler_state_dict": scheduler.state_dict()},
               checkpoint_path)
    lowest_valid_loss = valid_loss
    patience_counter = 0
  # Sinon, on augmente le compteur de patience
  else:
    patience_counter += 1

  # Si le compteur de patience atteint la limite, on arrête l'entrainement
  if patience_counter >= patience:
    print("Early stopping")
    break

# On charge le dernier modèle sauvé
checkpoint_dict = torch.load(checkpoint_path, map_location=torch.device(device))
my_model.load_state_dict(checkpoint_dict["model_state_dict"])
optimizer.load_state_dict(checkpoint_dict["optimizer_state_dict"])
scheduler.load_state_dict(checkpoint_dict["scheduler_state_dict"])
Epoch 1/10100%|██████████| 2188/2188 [05:12<00:00, 7.00it/s]
100%|██████████| 469/469 [00:51<00:00, 9.19it/s]Train loss: 0.3672, Valid loss: 0.2758
Train accuracy: 83.77%, Valid accuracy: 89.27%
***0.2758 < 100000.0000, saving.***
Epoch 2/10100%|██████████| 2188/2188 [04:56<00:00, 7.37it/s]
100%|██████████| 469/469 [00:55<00:00, 8.44it/s]Train loss: 0.2549, Valid loss: 0.2999
Train accuracy: 90.20%, Valid accuracy: 90.03%
Epoch 3/10100%|██████████| 2188/2188 [04:54<00:00, 7.42it/s]
100%|██████████| 469/469 [00:50<00:00, 9.28it/s]Train loss: 0.2184, Valid loss: 0.3119
Train accuracy: 92.20%, Valid accuracy: 90.64%
Epoch 4/10100%|██████████| 2188/2188 [04:56<00:00, 7.38it/s]
100%|██████████| 469/469 [00:51<00:00, 9.02it/s]Train loss: 0.1898, Valid loss: 0.3355
Train accuracy: 93.84%, Valid accuracy: 90.61%
Early stoppingEffectuons maintenant l’évaluation du modèle sur le jeu de test. On va également sauver chaque sortie en terme de probabilité, afin de voir la répartition de ces dernières.
my_model.eval()
sum_test_loss = 0
sum_test_acc = 0
real_sent = []
pred_sent = []
for (input_ids, masks), outputs in tqdm(test_loader):
  input_ids = input_ids.to(device)
  masks = masks.to(device)
  outputs = outputs.to(device).unsqueeze(1)

  logits = my_model(input_ids, masks).detach()
  loss = loss_fn(logits, outputs).detach()
  sum_test_acc += ((logits.flatten() > 0) == outputs.flatten()).sum().item()
  probs = torch.sigmoid(logits)

  real_sent.extend([real_prob.item() for real_prob in outputs.flatten()])
  pred_sent.extend([pred_prob.item() for pred_prob in probs.flatten()])
  sum_test_loss += loss.item()

print(f"\nLoss : {sum_test_loss/len(test_loader):.4f}")
print(f"Accuracy : {sum_test_acc/len(test_loader.dataset):.2%}")
100%|██████████| 469/469 [00:51<00:00, 9.17it/s]
Loss : 0.2641
Accuracy : 89.48%
On peut tracer les boxplots des probabilités prédites pour les critiques négatives et positives. Il y a quelques critiques (par rapport à la taille du jeu de test) avec une probabilité contre-intuitive par rapport à leur appréciation, mais la majorité semble concentré sur les pôles adéquats.
real_sent = np.array(real_sent)
pred_sent = np.array(pred_sent)
unique_real_sent = list(set(real_sent))
binned_pred_sent = [np.array(pred_sent)[np.where(real_sent == sent)[0]]
                    for sent in unique_real_sent]

plt.rcParams["figure.figsize"] = [12, 9]
plt.boxplot(binned_pred_sent, positions=unique_real_sent)
plt.show()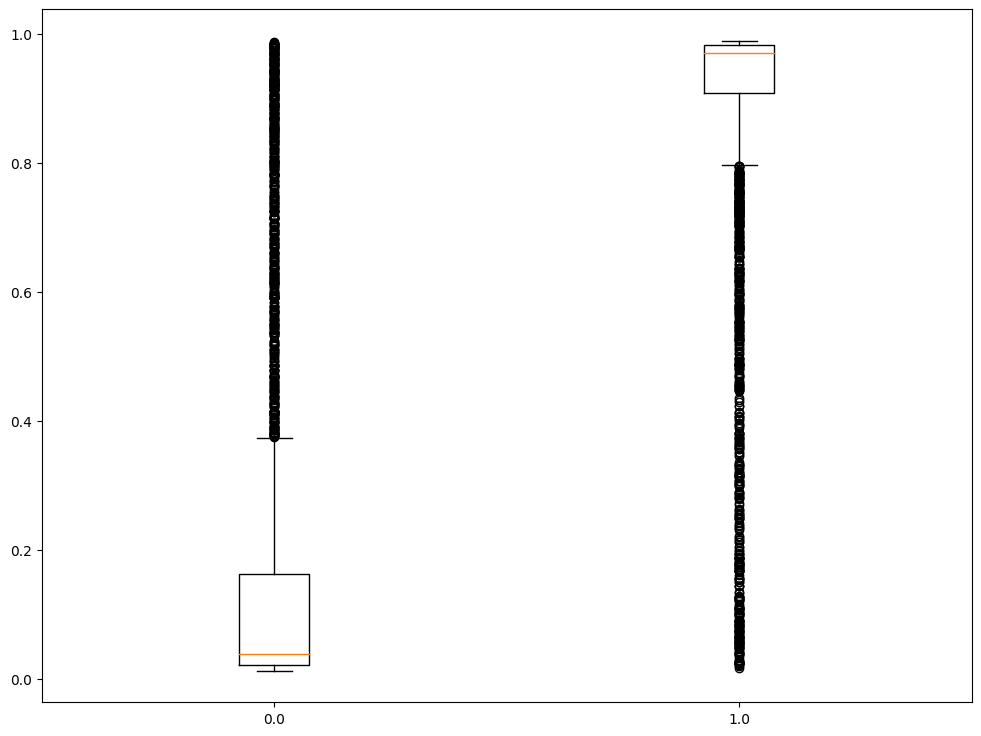
On sauve maintenant le modèle dans le drive, afin de pouvoir l’utiliser dans la deuxième partie sans la phase d’entrainement.
# model_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/" \
#              "TP12/sent_analyser_bert_base.pt"
model_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/" \
             "TP12/sent_analyser_bert_mini.pt"
torch.save({"model_state_dict": my_model.state_dict(),
            "optimizer_tat_dict": optimizer.state_dict(),
            "scheduler_state_dict": scheduler.state_dict()},
            model_path)
2. Utilisation du modèle pour l’analyse des sentiments
Passons maintenant à la partie où nous allons utiliser notre modèle d’analyse des sentiments sur le corpus des Misérables.
Comme cette deuxième partie peut être utilisée de manière indépendante de la première partie, nous allons redéfinir ici plusieurs éléments, tout en rechargeant le modèle entrainé.
# --- Le nom du modèle à charger

model_name = "prajjwal1/bert-mini"
model_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/" \
              "TP12/sent_analyser_bert_mini.pt"
# model_name = "bert-base-uncased"
# model_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/" \
#              "TP12/sent_analyser_bert_base.pt"

# --- La longueur maximale des séquences

max_length = 512

# --- Définition du modèle et chargement

class SentClassifier(nn.Module):

  def __init__(self, bert_model_name):
    super(SentClassifier, self).__init__()
    self.bert = BertModel.from_pretrained(bert_model_name)
    self.drop = nn.Dropout(p=0.3)
    self.full = nn.Linear(self.bert.config.hidden_size, 1)

  def forward(self, input_ids, attention_mask):
    bert_output = self.bert(input_ids, attention_mask)
    dropout = self.drop(bert_output["pooler_output"])
    logits = self.full(dropout)
    return logits

sent_classif = SentClassifier(model_name)
model_dict = torch.load(model_path, map_location=torch.device(device))
sent_classif.load_state_dict(model_dict["model_state_dict"])

# --- Le tokenisateur

tokenizer = BertTokenizer.from_pretrained(model_name)

# --- la transformation

def my_transform(text, tokenizer, max_length):
  # L'encodage
  encoding = tokenizer.encode_plus(text, truncation=True, max_length=max_length,
      add_special_tokens=True, return_token_type_ids=False, return_tensors="pt",
      return_attention_mask=True, padding="max_length")
  # Retour de l'encodage et du masque
  return encoding["input_ids"].flatten(), encoding["attention_mask"].flatten()
Définissons maintenant une classe héritée de torch.utils.data.Dataset qui permet de donner des entrées compatibles avec notre modèle à partir d’un livre de notre corpus. Pour cela, nous divisons notre livre en blocs, de au plus max_length tokens, et transformons ces blocs en tenseurs grâce à notre transformation.
class MyDocument(Dataset):
    def __init__(self, file_path, tokenizer, max_length, transform):
        self.file_path = file_path
        self.tokenizer = tokenizer
        self.max_length = max_length
        self.transform = transform

        with open(self.file_path, "r") as f:
          self.text = f.read()

        # On encode avec le tokenizer pour estimer le nombre de tokens
        tokens = self.tokenizer.encode_plus(self.text)["input_ids"]
        n_tokens = len(tokens)
        # Le nombre de blocs
        n_blocs = int(n_tokens / max_length) + 1
        # Les blocs résultant (avec ids des tokens)
        id_blocs = np.array_split(tokens[1:-1], n_blocs)
        # On converti à nouveau en texte
        self.blocs = [" ".join(self.tokenizer.convert_ids_to_tokens(id_bloc))
                      for id_bloc in id_blocs]

    def __len__(self):
        return len(self.blocs)

    def __getitem__(self, idx):
        return self.transform(self.blocs[idx], self.tokenizer, self.max_length)
On teste notre classe Dataset avec le premier livre.
file_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/TP10/" \
            "by_book/book_01.txt"
doc_data = MyDocument(file_path, tokenizer, max_length, my_transform)
L’entrée et le masque correspondant au premier bloc sont affichés.
doc_data[0](tensor([ 101, 1999, 10679, 1010, 1049, 1012, 2798, 1011, 8173, 1011,
29316, 1001, 1001, 2310, 2078, 1001, 1001, 1057, 2026, 1001,
1001, 15544, 2063, 1001, 1001, 1048, 2001, 3387, 1997, 1040,
1517, 1517, 2002, 2001, 2019, 2214, 2158, 1997, 2055, 10920,
1011, 2274, 2086, 1997, 2287, 1025, 2002, 2018, 4548, 1996,
2156, 1997, 1040, 1517, 1517, 2144, 12518, 1012, 2348, 2023,
6987, 2038, 2053, 4434, 3649, 2007, 1996, 2613, 9415, 1997,
2054, 2057, 2024, 2055, 2000, 14396, 1010, 2009, 2097, 2025,
2022, 3565, 1001, 1001, 13109, 1001, 1001, 1057, 3560, 1010,
2065, 6414, 2005, 1996, 8739, 1997, 6635, 1001, 1001, 23384,
1999, 2035, 2685, 1010, 2000, 5254, 2182, 1996, 2536, 11256,
1998, 12629, 2029, 2018, 2042, 1999, 9141, 2055, 2032, 2013,
1996, 2200, 2617, 2043, 2002, 3369, 1999, 1996, 5801, 1012,
2995, 2030, 6270, 1010, 2008, 2029, 2003, 2056, 1997, 2273,
2411, 14133, 2004, 2590, 1037, 2173, 1999, 2037, 3268, 1010,
1998, 2682, 2035, 1999, 2037, 4078, 1001, 1001, 9543, 1001,
1001, 29464, 2015, 1010, 2004, 2008, 2029, 2027, 2079, 1012,
1049, 1012, 2026, 1001, 1001, 15544, 2063, 1001, 1001, 1048,
2001, 1996, 2365, 1997, 1037, 10674, 1997, 1996, 3323, 1997,
28443, 1025, 6516, 2002, 6272, 2000, 1996, 11760, 1997, 1996,
3347, 1012, 2009, 2001, 2056, 2008, 2010, 2269, 1010, 4078,
1001, 1001, 9543, 1001, 1001, 13749, 2032, 2000, 2022, 1996,
8215, 1997, 2010, 2219, 2695, 1010, 2018, 2496, 2032, 2012,
1037, 2200, 2220, 2287, 1010, 7763, 2030, 3174, 1010, 1999,
10388, 2007, 1037, 7661, 2029, 2003, 2738, 4235, 15157, 1999,
5768, 2945, 1012, 1999, 8741, 1997, 2023, 3510, 1010, 2174,
1010, 2009, 2001, 2056, 2008, 2798, 2026, 1001, 1001, 15544,
2063, 1001, 1001, 1048, 2580, 1037, 2307, 3066, 1997, 2831,
1012, 2002, 2001, 2092, 2719, 1010, 2295, 2738, 2460, 1999,
21120, 1010, 11552, 1010, 19415, 1010, 9414, 1025, 1996, 2878,
1997, 1996, 2034, 4664, 1997, 2010, 2166, 2018, 2042, 7422,
2000, 1996, 2088, 1998, 2000, 22111, 1012, 1996, 4329, 2234,
1025, 2824, 4594, 2169, 2060, 2007, 13511, 1025, 1996, 5768,
2945, 1010, 11703, 1001, 1001, 10047, 4383, 1010, 9505, 1010,
14682, 2091, 1010, 2020, 15484, 1012, 1049, 1012, 2798, 2026,
1001, 1001, 15544, 2063, 1001, 1001, 1048, 11367, 2000, 3304,
2012, 1996, 2200, 2927, 1997, 1996, 4329, 1012, 2045, 2010,
2564, 2351, 1997, 1037, 28935, 1001, 1001, 1040, 2100, 1997,
1996, 3108, 1010, 2013, 2029, 2016, 2018, 2146, 4265, 1012,
2002, 2018, 2053, 2336, 1012, 2054, 2165, 2173, 2279, 1999,
1996, 6580, 1997, 1049, 1012, 2026, 1001, 1001, 15544, 2063,
1001, 1001, 1048, 1029, 1996, 10083, 1997, 1996, 2413, 2554,
1997, 1996, 2214, 1001, 1001, 4372, 2420, 1010, 1996, 2991,
1997, 2010, 2219, 2155, 1010, 1996, 13800, 21177, 1001, 1001,
1055, 1997, 1521, 6109, 1010, 2029, 2020, 1010, 3383, 1010,
2130, 2062, 8598, 1001, 1001, 13749, 2000, 1996, 12495, 1001,
1001, 8624, 2040, 7021, 2068, 2013, 1037, 3292, 1010, 2007,
1996, 23848, 1001, 1001, 9152, 1001, 1001, 1042, 14147, 4204,
1997, 7404, 1010, 1517, 2106, 2122, 3426, 1996, 4784, 1997,
14916, 1001, 1001, 4895, 23247, 1998, 22560, 2000, 16216, 1001,
1001, 28549, 2378, 1001, 1001, 8823, 1999, 2032, 1029, 2001,
2002, 102]),
tensor([1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1]))Regardons si nous pouvons passer une entrée dans notre modèle, pour voir si tout fonctionne.
input, mask = doc_data[0]
sent_classif.eval()
sent_classif(input.unsqueeze(0), mask.unsqueeze(0))
tensor([[3.3805]], grad_fn=<AddmmBackward0>)Nous créons maintenant une fonction qui prend une instance de notre classe Dataset en entrée et permet d’estimer le sentiment de chaque bloc.
def get_sentiments(file_data, model, batch_size):
  file_data_loader = DataLoader(file_data, batch_size)

  file_sents = []
  model.eval()
  for inputs, masks in file_data_loader:
    logits = model(inputs, masks).detach()
    probs = torch.sigmoid(logits)
    file_sents.extend(probs.flatten().tolist())

  return file_sents
On va executer cette fonction sur tout notre corpus, et sauvegarder les sentiments prédits dans une liste (livre) de liste (blocs).
corpus_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/TP10/by_book"
batch_size = 64

file_names = os.listdir(corpus_path)
file_names.sort()

corpus_sents = []
for i, file_name in tqdm(enumerate(file_names)):

  file_path = f"{corpus_path}/{file_name}"
  file_data = MyDocument(file_path, tokenizer, max_length, my_transform)
  file_sents = get_sentiments(file_data, sent_classif, batch_size)

  corpus_sents.append(file_sents)
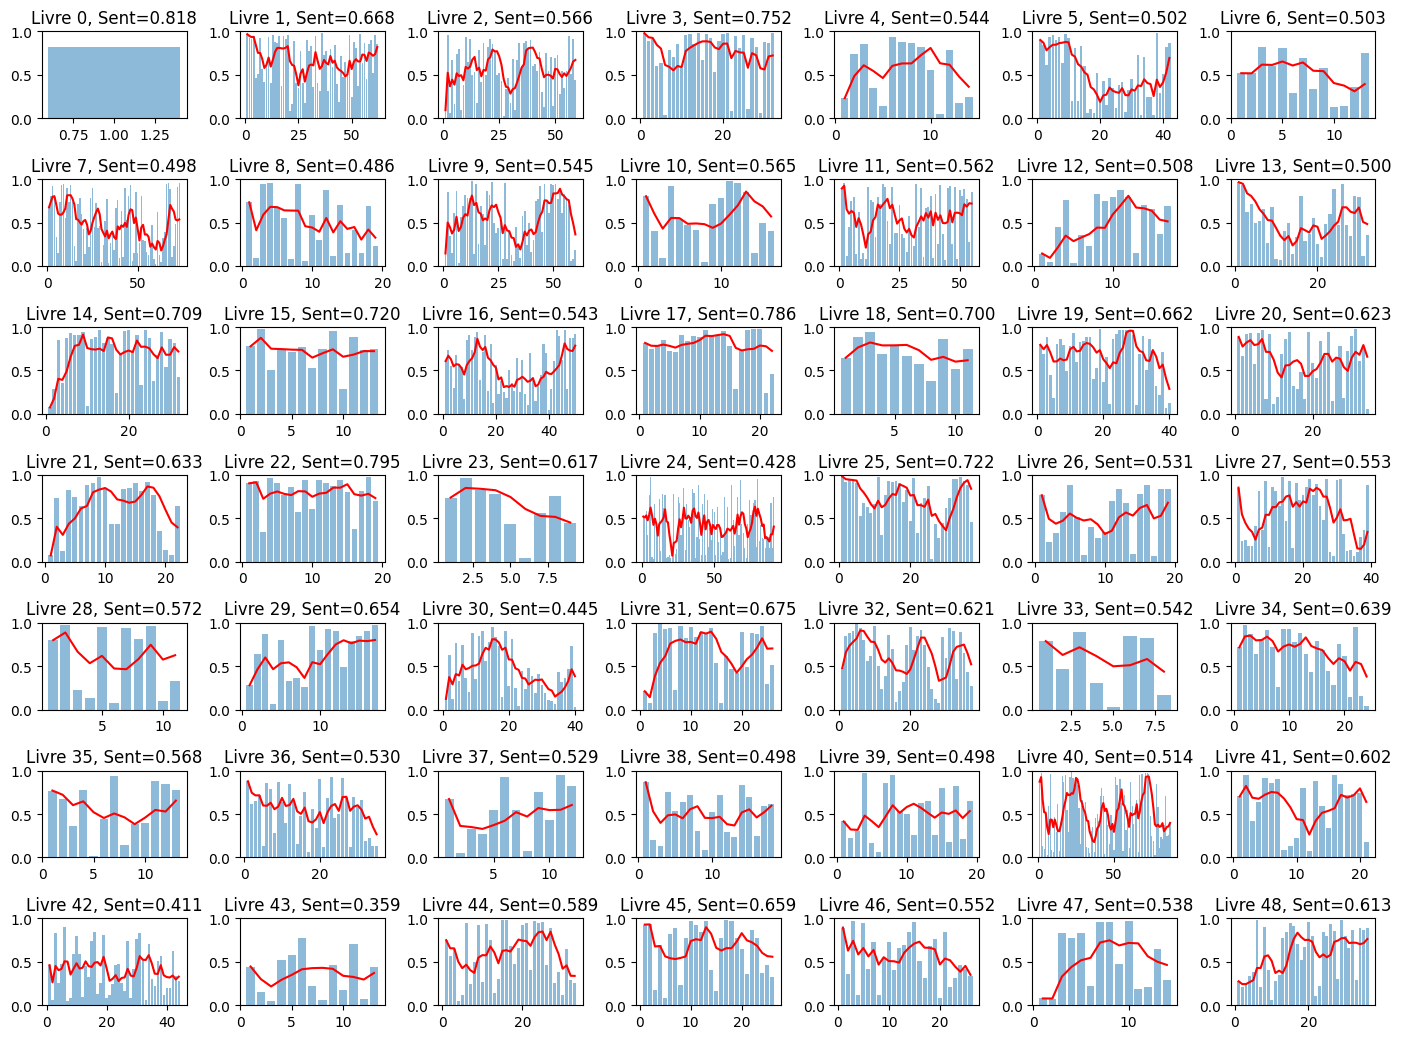
49it [03:40, 4.50s/it]On affiche le sentiment calculé sur chaque bloc, avec une moyenne mobile sur une fenêtre de ma_window_size. De plus, les sentiments moyens de chaque livre et du corpus sont calculés.
ma_window_size = 5

nx_grid = int(np.sqrt(len(corpus_sents)))
ny_grid= int(np.ceil(len(corpus_sents) / nx_grid))
plt.rcParams["figure.figsize"] = [ny_grid*2, nx_grid*1.5]

fig = plt.figure()
grid_layout = GridSpec(nx_grid, ny_grid)

total_sent, total_part = 0, 0
for i, file_sents in enumerate(corpus_sents):

  # Pour calculer la moyenne mobile
  mov_avg_df = pd.Series(file_sents).rolling(ma_window_size, min_periods=1)
  mov_avg = mov_avg_df.mean().to_list()

  x_range = list(range(1, len(file_sents) + 1))

  ax = fig.add_subplot(grid_layout[i])
  ax.bar(x_range, file_sents, alpha=0.5)
  ax.plot(x_range, mov_avg, color="red")
  ax.set_ylim([0, 1])
  ax.set_title(f"Livre {i}, Sent={np.mean(file_sents):.3f}")

  # On fait la somme du sentiment et comptons le nombre de blocs
  total_sent += np.sum(file_sents)
  total_part += len(file_sents)

grid_layout.tight_layout(fig)

print(f"Sentiment moyen total = {total_sent/total_part:.3f}")
Sentiment moyen total = 0.568