TP 10 : Analyses de données textuelles

Dans ce TP, nous allons effectuer quelques méthodes d’analyse textuelle sur les Misérables de Victor Hugo. Le texte des 5 tomes a été obtenu via le projet gutenberg (https://www.gutenberg.org/) et nous allons utiliser le texte en anglais.

Plusieurs librairies offrent des outils de traitement de données textuelles en Python, tel que nltk, sklearn, spacy, gensim, et flair. Ici, nous allons utiliser :

  • Spacy (https://spacy.io/) : qui fournit plusieurs modèles de langage permettant d’effectuer des tâches de tokenisation, tagging et parsing. De nombreuses autres méthodes sont également disponibles.

  • Gensim (https://radimrehurek.com/gensim/) : qui se concentre sur les méthodes de topic modeling et d’embedding, et qui permet de charger certains modèles pré-entrainés.

Notez que Python possède de nombreuses fonctionnalités permettant de traiter les chaînes de caractères (voir p.ex. https://www.w3schools.com/python/python_ref_string.asp ) et la librairie re permet de gerer les expression régulières (https://docs.python.org/3/library/re.html). Avec ces deux éléments, il est déjà possible de créer de nombreux traitements en partant de zéro.

Les librairies nécessaires sont les suivantes :

import pandas as pd
import numpy as np
import os
from tqdm import tqdm
# Permet de créer des décomptes d'objet dans une liste
import collections
import matplotlib.pyplot as plt
# Permet de faire des grilles de graphique
from matplotlib.gridspec import GridSpec
# Pour les colormaps
from matplotlib import colormaps
# Pour traiter les expressions régulières
import re
# Pour les pré-traitements, le tagging et le parsing
import spacy
# Aide pour la décompositon spectrale nécessaire à l'AFC
import scipy
# Pour la LDA et les word embeddings : gensim.
# Installation sur colab
!pip install gensim
# Importation
import gensim
from gensim.models import TfidfModel, LdaModel, CoherenceModel, Word2Vec
# Pour projeter les coordonnées
from sklearn.manifold import TSNE
Requirement already satisfied: gensim in /usr/local/lib/python3.12/dist-packages (4.4.0)
Requirement already satisfied: numpy>=1.18.5 in /usr/local/lib/python3.12/dist-packages (from gensim) (2.0.2)
Requirement already satisfied: scipy>=1.7.0 in /usr/local/lib/python3.12/dist-packages (from gensim) (1.16.3)
Requirement already satisfied: smart_open>=1.8.1 in /usr/local/lib/python3.12/dist-packages (from gensim) (7.5.0)
Requirement already satisfied: wrapt in /usr/local/lib/python3.12/dist-packages (from smart_open>=1.8.1->gensim) (2.0.1)

1. Pré-traitements et statistiques

1.1 Séparation du texte en plusieurs documents

Le corpus des Misérables en anglais est contenu dans un seul fichier. Seulement, nous allons adopter une structure de données où chaque document de notre corpus est contenu dans un fichier séparé. Pour cela, nous allons séparer notre texte à l’aide d’expressions régulières.

On commence par charger le corpus par lignes.

corpus_path = "/content/drive/MyDrive/Colab Notebooks/" \
              "ml_data/TP10/les_miserables.txt"
with open(corpus_path) as corpus_file:
  corpus_lines = corpus_file.readlines()
corpus_lines[0:11]
['LES MISÉRABLES\n',
 '\n',
 '\n',
 '\n',
 '\n',
 'PREFACE\n',
 '\n',
 '\n',
 'So long as there shall exist, by virtue of law and custom, decrees of\n',
 'damnation pronounced by society, artificially creating hells amid the\n',
 'civilization of earth, and adding the element of human fate to divine\n']

Nous allons maintenant définir des expressions régulières qui permettent d’identifier les lignes séparatrices de notre corpus. Il y a trois échelons possibles: Volume (e.g. “VOLUME I”), livre (e.g. “BOOK FIRST-A JUST MAN”) et chapitre (e.g. “CHAPTER I—M. MYRIEL”).

regex_for_volume = "^VOLUME [A-Z]+$"
regex_for_book = "^BOOK "
regex_for_chapter = "^CHAPTER "

La boucle suivante ajoute les lignes une par une dans une variable, puis sauve cette variable (et la vide) une fois qu’une ligne séparatrice de l’unité choisie apparaît (attention, on sauve également la dernière itération de la variable). Ici, nous allons séparer notre corpus par livre avec regex_for_book (on omet toute les lignes qui contiennent des séparateurs).

book_texts = []
text = ""
# Boucle sur les lignes
for line in corpus_lines:
  # Si c'est une ligne avec "BOOK ...", ou la fin, on sauve le texte
  if re.match(regex_for_book, line) or line == corpus_lines[-1]:
    book_texts.append(text)
    text = ""
  # Ajout de la une ligne si ce n'est pas "VOLUME", "BOOK", "CHAPTER"
  if re.match(regex_for_volume, line) is None and \
     re.match(regex_for_book, line) is None and \
     re.match(regex_for_chapter, line) is None:
    text += line

# Affichage du début des deux premiers chapitres
print(book_texts[0][0:600])
print("----------------------------")
print(book_texts[1][0:600])
LES MISÉRABLES


PREFACE


So long as there shall exist, by virtue of law and custom, decrees of
damnation pronounced by society, artificially creating hells amid the
civilization of earth, and adding the element of human fate to divine
destiny; so long as the three great problems of the century—the
degradation of man through pauperism, the corruption of woman through
hunger, the crippling of children through lack of light—are unsolved;
so long as social asphyxia is possible in any part of the world;—in
other words, and with a still wider significance, so long as ignorance
and poverty exist 
----------------------------


In 1815, M. Charles-François-Bienvenu Myriel was Bishop of D—— He was
an old man of about seventy-five years of age; he had occupied the see
of D—— since 1806.

Although this detail has no connection whatever with the real substance
of what we are about to relate, it will not be superfluous, if merely
for the sake of exactness in all points, to mention here the various
rumors and remarks which had been in circulation about him from the
very moment when he arrived in the diocese. True or false, that which
is said of men often occupies as important a place in their lives, and
above all in t

Finalement, on sauve les différents documents dans un nouveau dossier, afin de n’avoir plus à refaire ce traitement par la suite. Attention de bien nommer les fichiers pour que ceux-ci se trouve dans l’ordre alphabétique (on ajoute un 0 devant le numéro des livres de 0 à 9).

books = "/content/drive/MyDrive/Colab Notebooks/ml_data/TP10/by_book"
# On crée le dossier pour le roman séparé par livre
os.makedirs(books, exist_ok=True)
# On écrit les livres (pour classer, 2 digits, avec un 0 devant pour les unités)
for i, text in enumerate(book_texts):
  with open(f"{books}/book_{i:02d}.txt", "w") as book_file:
    book_file.write(text)

1.2 Traitement du texte et statistiques

Dans cette partie nous allons effectuer le traitement du texte et sortir quelques statistiques sur notre corpus. Nous allons utiliser pour cela Spacy et son modèle de langage "en_core_web_sm" (d’autres sont disponibles sous https://spacy.io/usage/models). On doit télécharger le modèle (qu’une seule fois), puis le charger sous un nom de fonction (ici nlp()).

# La ligne suivante doit être exécutée qu'une fois, decommentez-là lors de la
# permière exécution

# !spacy download "en_core_web_sm"
nlp = spacy.load("en_core_web_sm")

On va lister le dossier du corpus puis classer le nom des fichiers par ordre alphabétique (pour conserver l’ordre de narration du livre).

corpus_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/TP10/by_book"
file_names = os.listdir(corpus_path)
file_names.sort()

Avant d’effectuer notre traitement complet, regardons comment Spacy traite un seul docuement. Nous chargeons le premier fichier et l’affichons.

example_file_path = f"{corpus_path}/{file_names[1]}"
with open(example_file_path, "r") as example_file:
  example_text = example_file.read()
# On affiche le début
example_text[:200]
'\n\n\n\n\nIn 1815, M. Charles-François-Bienvenu Myriel was Bishop of D—— He was\nan old man of about seventy-five years of age; he had occupied the see\nof D—— since 1806.\n\nAlthough this detail has no connec'

En applicant notre fonction nlp() sur notre texte, Spacy va effectuer tout une série d’opérations (un pipeline, voir https://spacy.io/usage/processing-pipelines), dont les résultats seront contenus dans l’objet retourné par cette fonction (ici, example_doc). Notez qu’il est possible de désactiver certaines fonctionnalité du pipeline, si l’on cherche à avoir des résultats plus rapidement.

example_doc = nlp(example_text)

Le nombre de tokens du corpus peut être obtenu avec grâce à la longueur de l’objet.

len(example_doc)
31113

Nous pouvons également itérer sur cet objet, qui donnera alors les tokens un par un. Chacun de ces tokens est en fait un objet qui contient un grand nombre d’informations.

example_sent = list(example_doc.sents)[0]
token_texts = []
token_lemmas = []
token_poss = []
token_tags = []
token_deps = []
token_ent_types = []
token_is_stops = []
token_is_digits = []
token_is_puncts = []

# On boucle sur les tokens
for token in example_sent:
  if not token.is_space:
    token_texts.append(token.text) # Le texte du token
    token_lemmas.append(token.lemma_) # Son lemme
    token_poss.append(token.pos_) # Son tag POS
    token_tags.append(token.tag_) # Son tag POS détaillé
    token_deps.append(token.dep_) # Son tag de parsing
    token_ent_types.append(token.ent_type_) # Son tag NER (si s'en est un)
    token_is_stops.append(token.is_stop) # Si c'est un stopwords
    token_is_digits.append(token.is_digit) # Si c'est un chiffre
    token_is_puncts.append(token.is_punct) # Si c'est une ponctuation

# On affiche dans une DataFrame formatée
sentence_data = pd.DataFrame({"L": token_texts,
                              "lemma_": token_lemmas,
                              "pos_": token_poss,
                              "tag_": token_tags,
                              "dep_": token_deps,
                              "ent_type_": token_ent_types,
                              "is_stop": token_is_stops,
                              "is_digit": token_is_digits,
                              "is_punct": token_is_puncts})
sentence_data
L lemma_ pos_ tag_ dep_ ent_type_ is_stop is_digit is_punct
0 In in ADP IN prep True False False
1 1815 1815 NUM CD pobj DATE False True False
2 , , PUNCT , punct False False True
3 M. M. PROPN NNP compound PERSON False False False
4 Charles Charles PROPN NNP compound PERSON False False False
5 - - PUNCT HYPH punct PERSON False False True
6 François François PROPN NNP compound PERSON False False False
7 - - PUNCT HYPH punct PERSON False False True
8 Bienvenu Bienvenu PROPN NNP compound PERSON False False False
9 Myriel Myriel PROPN NNP nsubj PERSON False False False
10 was be AUX VBD ccomp True False False
11 Bishop Bishop PROPN NNP attr ORG False False False
12 of of ADP IN prep True False False
13 D D PROPN NNP pobj False False False
14 — — PUNCT : punct False False True
15 — — PUNCT : punct False False True
16 He he PRON PRP nsubj True False False
17 was be AUX VBD ccomp True False False
18 an an DET DT det True False False
19 old old ADJ JJ amod False False False
20 man man NOUN NN attr False False False
21 of of ADP IN prep True False False
22 about about ADV RB advmod DATE True False False
23 seventy seventy NUM CD compound DATE False False False
24 - - PUNCT HYPH punct DATE False False True
25 five five NUM CD nummod DATE True False False
26 years year NOUN NNS pobj DATE False False False
27 of of ADP IN prep DATE True False False
28 age age NOUN NN pobj DATE False False False
29 ; ; PUNCT : punct False False True
30 he he PRON PRP nsubj True False False
31 had have AUX VBD aux True False False
32 occupied occupy VERB VBN ROOT False False False
33 the the DET DT det True False False
34 see see NOUN NN dobj True False False
35 of of ADP IN prep True False False
36 D D PROPN NNP pobj False False False
37 — — PUNCT : punct False False True
38 — — PUNCT : punct False False True
39 since since SCONJ IN prep True False False
40 1806 1806 NUM CD pobj DATE False True False
41 . . PUNCT . punct False False True

Pour le tagging des stopwords, Spacy utilise une liste interne.

print(spacy.lang.en.stop_words.STOP_WORDS)
{'three', 'side', 'becomes', '‘d', 'neither', 'among', 'few', 'first', 'anyone', 'thus', '‘re', 'in', 'n’t', 'whose', 'least', 'next', 'since', 'under', 'be', 'while', 'everyone', 'therein', 'might', 'enough', 'less', 'see', 'hence', '’re', 'into', 'forty', 'own', 'someone', 'when', 'or', 'was', 'meanwhile', 'a', 'yourselves', 'although', '‘ve', 'the', 'over', 'sixty', 'part', 'not', 'others', 'moreover', 'afterwards', 'ten', 'further', 'an', 'latter', 'has', 'nowhere', 'noone', 'bottom', 'never', 're', 'anything', 'even', 'where', 'due', 'after', "'ve", 'via', 'other', 'did', 'all', 'using', 'us', 'along', '’s', 'throughout', 'toward', 'show', 'can', 'above', "'re", 'doing', 'him', 'on', 'move', 'her', 'must', 'this', 'wherein', 'too', 'therefore', 'upon', 'only', 'to', 'our', 'beside', 'we', 'hers', "'ll", 'hereupon', 'everywhere', 'cannot', 'then', 'thereupon', 'does', 'more', 'their', 'whatever', 'name', 'once', 'she', 'really', 'much', 'make', 'anywhere', 'besides', 'about', 'last', 'towards', 'and', 'anyway', 'from', 'than', 'against', 'thence', 'often', 'yourself', 'it', 'together', 'am', 'whereas', 'whence', 'such', 'herself', 'wherever', 'thereafter', 'otherwise', 'whom', 'no', 'give', 'now', 'another', 'whole', 'former', 'being', 'have', 'very', 'are', 'though', 'five', 'of', 'here', 'many', 'ours', '‘m', 'before', 'every', 'again', 'hereby', 'ca', 'by', 'else', 'same', 'became', '’ve', 'that', 'twenty', 'becoming', 'they', "'m", 'these', 'out', 'at', 'most', 'go', 'how', 'full', 'behind', 'thru', "'s", 'call', 'except', 'somewhere', 'hereafter', 'various', 'namely', 'put', 'nobody', 'he', 'done', 'take', '‘ll', 'several', 'do', 'formerly', 'so', 'seem', 'herein', 'regarding', 'get', 'none', 'up', "'d", 'below', 'anyhow', 'thereby', 'should', 'either', 'were', 'seemed', 'fifty', 'whether', 'is', 'fifteen', 'nevertheless', 'elsewhere', 'but', 'two', 'whereupon', 'through', 'will', 'those', 'rather', 'beforehand', 'me', 'however', 'unless', 'seems', 'i', "n't", 'within', 'nine', 'which', 'been', 'one', 'just', 'please', '‘s', 'whenever', 'alone', 'who', 'his', 'for', 'keep', 'myself', 'around', 'always', 'per', 'n‘t', '’ll', 'four', 'during', 'them', 'had', 'would', 'back', 'its', 'until', 'become', 'ourselves', 'seeming', 'between', 'you', 'onto', 'both', 'hundred', 'also', 'somehow', 'yours', 'off', 'each', 'whereafter', 'across', 'mostly', 'your', 'my', 'indeed', 'any', 'could', 'third', 'whereby', 'eleven', 'eight', 'nor', 'almost', 'already', 'whither', 'there', 'yet', 'himself', 'as', 'without', 'sometimes', 'because', 'serious', 'something', 'empty', 'sometime', 'themselves', 'itself', 'latterly', 'well', 'amongst', 'what', 'still', 'used', 'twelve', 'down', 'beyond', 'perhaps', 'amount', 'why', 'front', 'may', '’d', 'if', 'made', 'some', 'ever', 'everything', 'say', '’m', 'six', 'top', 'whoever', 'quite', 'mine', 'with', 'nothing'}

Il est possible d’étendre cette liste de la manière suivante (une liste de stopwords universelle n’existe pas).

new_stopwords = ["say", "says", "saying", "said"]
for stopword in new_stopwords:
  nlp.vocab[stopword].is_stop = True

Pour obtenir les statistiques du corpus, nous allons créer une fonction qui les calcule et qui retourne un dictionnaire. Cette fonction va se lancer sur tous les documents de notre corpus.

def get_statistics(doc):

  lemmas = []
  poss = []

  # On boucle sur les tokens, et on sauve leur lemme et leur tag POS
  for token in doc:
    if not (token.is_stop or token.is_punct or token.is_space):
      lemmas.append(token.lemma_.lower())
      poss.append(token.pos_)

  # On boucle sur doc.ents pour obtenir les entités de type "PERSON"
  pers = [ent.text for ent in doc.ents if ent.label_=="PERSON"]

  # Grâce à collections.Counter(), on crée des dictionnaires contenant la
  # fréquence des différents éléments.
  lemma_counts = collections.Counter(lemmas)
  pos_counts = collections.Counter(poss)
  per_counts = collections.Counter(pers)

  statistic_dict = {
      "n_tokens": len(doc), # Le nombre de tokens
      "n_lemmas": len(lemmas), # Le nombre de lemmes
      "n_lemma_types": len(set(lemmas)), # le nombre de lemmes unique
      "top_5_lemmas": {lemma: count for lemma, count in # Les 5 lemmes les plus fréquents
                       sorted(lemma_counts.items(),
                              key=lambda item: item[1],
                              reverse=True)[:6]},
      "pos_distrib": {pos: round(count/len(lemmas)*100, 2) for pos, count in # La distribution des tag POS
                      sorted(pos_counts.items(),
                             key=lambda item: item[1],
                             reverse=True)},
      "top_5_pers": {per: count for per, count in # Les 5 personnages les plus fréquents
                     sorted(per_counts.items(),
                            key=lambda item: item[1],
                            reverse=True)[:6]},
  }

  return(statistic_dict)

En appliquant cette fonction à notre objet d’exemple, on obtient les statistiques.

get_statistics(example_doc)
{'n_tokens': 31113,
 'n_lemmas': 9714,
 'n_lemma_types': 3418,
 'top_5_lemmas': {'bishop': 181,
  'man': 127,
  'good': 66,
  'old': 46,
  'monseigneur': 44,
  'god': 44},
 'pos_distrib': {'NOUN': 46.39,
  'VERB': 23.85,
  'ADJ': 13.17,
  'PROPN': 11.62,
  'ADV': 2.51,
  'NUM': 0.91,
  'ADP': 0.6,
  'AUX': 0.36,
  'X': 0.27,
  'INTJ': 0.26,
  'DET': 0.03,
  'SCONJ': 0.02,
  'PRON': 0.01,
  'PUNCT': 0.01},
 'top_5_pers': {'Magloire': 18,
  'Monseigneur': 7,
  'Mademoiselle Baptistine': 5,
  'M. Myriel': 4,
  'Monseigneur Bienvenu': 4,
  'Te Deum': 3}}

Nous allons maintenant créer une fonction qui sauve le document pré-traité dans un fichier donné en argument. On va sauver chaque phrase dans une ligne séparée, pour pouvoir les retrouver par la suite.

def save_preprocess_doc(doc, output_path):

  with open(output_path, "w") as output_file:
    # l'attibut doc.sents de Spacy contient les phrases, on boucle dessus
    for sent in doc.sents:
      line = ""
      # On boucle sur les tokens
      for token in sent:
        # On ne garde que les token qui ne sont pas des stopwords,
        # des ponctuations ou des espaces.
        if not (token.is_stop or token.is_punct or token.is_space):
          # On écrit le lemme, en minuscule
          line += f"{token.lemma_.lower()} "
      # Si la ligne n'est pas vide, on l'écrit dans le fichier
      if re.sub(r"\s+", "", line) != "":
        output_file.write(line[:-1] + "\n")

On peut tester notre fonction sur notre document d’exemple.

save_preprocess_doc(example_doc, "example_pp.txt")

On va maintenant appliquer nos fonctions sur tous les documents. On fait une boucle sur les noms des fichiers, on charge le document, on le transforme en objet Spacy, puis on lance nos fonctions. Les fichiers traités sont sauvegardés dans un nouveau dossier et les résultats des statistiques sont enregistrés dans une DataFrame, que l’on affiche.

# Notre DataFrame de résultats
stat_results = pd.DataFrame(None, columns=["n_tokens", "n_lemmas",
                                           "n_lemma_types", "top_5_lemmas",
                                           "pos_distrib", "top_5_pers"])
# Notre dossier contenant le corpus pré-traité
corpus_pp_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/TP10/by_book_pp"
os.makedirs(corpus_pp_path, exist_ok=True)
for file_name in tqdm(file_names):
  # Le chemin du fichier
  file_path = f"{corpus_path}/{file_name}"
  # On l'ouvre
  with open(file_path, "r") as text_file:
    text = text_file.read()
  # On le transform en doc spacy
  doc = nlp(text)
  # Les statistiques
  stat_dict = get_statistics(doc)
  # En ligne et dans la Dataframe
  new_row = pd.DataFrame.from_dict(stat_dict, orient="index").T
  stat_results = pd.concat([stat_results, new_row], axis=0, ignore_index=True)
  # La sauvegarde du corpus prétraité
  save_preprocess_doc(doc, f"{corpus_pp_path}/{file_name}")

stat_results
100%|██████████| 49/49 [02:22<00:00,  2.91s/it]
n_tokens n_lemmas n_lemma_types top_5_lemmas pos_distrib top_5_pers
0 149 63 56 {'long': 4, 'les': 2, 'misérables': 2, 'exist'... {'NOUN': 53.97, 'PROPN': 12.7, 'ADJ': 11.11, '... {'FANTINE': 1}
1 31113 9714 3418 {'bishop': 181, 'man': 127, 'good': 66, 'old':... {'NOUN': 46.39, 'VERB': 23.85, 'ADJ': 13.17, '... {'Magloire': 18, 'Monseigneur': 7, 'Mademoisel...
2 29786 9463 2793 {'man': 162, 'jean': 100, 'valjean': 99, 'bish... {'NOUN': 45.78, 'VERB': 26.77, 'ADJ': 12.43, '... {'Jean Valjean': 78, 'Magloire': 25, 'Mademois...
3 15259 5327 2628 {'tholomyès': 52, 'de': 43, 'favourite': 41, '... {'NOUN': 42.03, 'VERB': 21.21, 'PROPN': 19.47,... {'Tholomyès': 40, 'Fantine': 35, 'Favourite': ...
4 6719 2150 1156 {'child': 43, 'mother': 38, 'little': 36, 'wom... {'NOUN': 46.37, 'VERB': 23.07, 'ADJ': 15.86, '... {'Fantine': 7, 'Tholomyès': 4, 'Euphrasie': 3,...
5 21198 6771 2412 {'m.': 98, 'madeleine': 94, 'man': 93, 'javert... {'NOUN': 45.34, 'VERB': 25.86, 'ADJ': 13.85, '... {'Fantine': 54, 'Madeleine': 44, 'M. Madeleine...
6 6026 1822 893 {'m.': 39, 'javert': 38, 'madeleine': 37, 'may... {'NOUN': 38.25, 'VERB': 27.06, 'PROPN': 18.99,... {'M. Madeleine': 33, 'Javert': 24, 'Mayor': 21...
7 36967 11066 2928 {'man': 138, 'm.': 95, 'go': 63, 'little': 62,... {'NOUN': 44.43, 'VERB': 28.32, 'ADJ': 12.25, '... {'Jean Valjean': 37, 'Fantine': 35, 'M. Madele...
8 9542 2952 1239 {'javert': 48, 'm.': 42, 'fantine': 38, 'jean'... {'NOUN': 42.04, 'VERB': 27.98, 'PROPN': 12.64,... {'Fantine': 35, 'Jean Valjean': 27, 'Javert': ...
9 29083 10286 3306 {'man': 90, 'english': 88, 'battle': 81, 'wate... {'NOUN': 47.34, 'VERB': 22.13, 'PROPN': 14.46,... {'Waterloo': 69, 'Blücher': 19, 'Genappe': 12,...
10 7566 2556 1368 {'man': 29, 'boulatruelle': 23, 'm.': 20, 'fal... {'NOUN': 49.96, 'VERB': 24.77, 'ADJ': 11.15, '... {'Jean Valjean': 14, 'Boulatruelle': 12, 'M. M...
11 27681 8692 2631 {'thénardier': 180, 'cosette': 154, 'man': 150... {'NOUN': 45.35, 'VERB': 27.01, 'ADJ': 13.02, '... {'Thénardier': 11, 'Lagny': 6, 'Catherine': 4,...
12 8324 2860 1345 {'jean': 48, 'valjean': 48, 'old': 34, 'cosett... {'NOUN': 45.66, 'VERB': 24.3, 'ADJ': 13.81, 'P... {'Jean Valjean': 39, 'Jean Valjean’s': 4, 'Cat...
13 15973 5292 1947 {'jean': 116, 'valjean': 115, 'javert': 64, 'm... {'NOUN': 41.74, 'VERB': 25.38, 'PROPN': 15.02,... {'Jean Valjean': 88, 'Javert': 38, 'Jean Valje...
14 15696 5349 2182 {'convent': 55, 'mother': 53, 'de': 43, 'nun':... {'NOUN': 44.92, 'VERB': 20.08, 'PROPN': 16.41,... {'Martin Verga': 9, 'Dismas': 4, 'Saint-Benoît...
15 6195 1986 1167 {'man': 27, 'infinite': 18, 'convent': 17, 'cl... {'NOUN': 53.42, 'VERB': 21.1, 'ADJ': 15.66, 'P... {'Jean-Jacques': 1, 'Voltaire': 1, 'Labarre': ...
16 24528 7511 2434 {'fauchelevent': 183, 'man': 96, 'jean': 91, '... {'NOUN': 43.46, 'VERB': 25.16, 'PROPN': 15.22,... {'Jean Valjean': 75, 'Mestienne': 20, 'Madelei...
17 10143 3509 2071 {'paris': 56, 'child': 38, 'gamin': 36, 'littl... {'NOUN': 45.88, 'VERB': 21.37, 'PROPN': 15.45,... {'Jondrette': 3, 'Louis XV': 2, 'Voltaire': 2,...
18 5230 1730 1108 {'m.': 29, 'gillenormand': 29, 'man': 23, 'gre... {'NOUN': 42.6, 'VERB': 21.1, 'ADJ': 15.03, 'PR... {'M. Gillenormand': 5, 'Louis XIV': 2, 'Louis ...
19 19476 6362 2607 {'marius': 95, 'm.': 68, 'de': 63, 'man': 63, ... {'NOUN': 42.36, 'VERB': 22.96, 'PROPN': 17.35,... {'Théodule': 17, 'M. Gillenormand': 12, 'Mariu...
20 16377 5429 2645 {'man': 54, 'marius': 54, 'enjolras': 39, 'cou... {'NOUN': 43.43, 'VERB': 22.31, 'PROPN': 16.45,... {'Combeferre': 23, 'Enjolras': 16, 'Laigle': 1...
21 10709 3454 1667 {'marius': 65, 'm.': 36, 'old': 32, 'man': 31,... {'NOUN': 46.29, 'VERB': 24.67, 'ADJ': 12.57, '... {'M. Mabeuf': 16, 'Théodule': 9, 'Marius': 6, ...
22 9228 2941 1310 {'marius': 81, 'day': 36, 'girl': 35, 'bench':... {'NOUN': 43.08, 'VERB': 26.93, 'ADJ': 14.52, '... {'M. Leblanc': 9, 'Marius': 8, 'Ursule': 8, 'M...
23 4352 1416 931 {'man': 21, 'low': 9, 'social': 9, 'work': 8, ... {'NOUN': 50.92, 'VERB': 19.35, 'ADJ': 15.11, '... {'Luther': 2, 'Condorcet': 2, 'Robespierre': 2...
24 45740 14086 3459 {'marius': 233, 'man': 185, 'jondrette': 147, ... {'NOUN': 44.04, 'VERB': 27.68, 'ADJ': 12.08, '... {'Jondrette': 72, 'M. Leblanc': 34, 'Marius': ...
25 18643 6239 2644 {'man': 83, 'revolution': 54, 'right': 46, 'lo... {'NOUN': 46.31, 'VERB': 20.98, 'ADJ': 14.25, '... {'Louis Philippe': 22, 'Enjolras': 9, 'Robespi...
26 9222 2861 1378 {'marius': 55, 'man': 32, 'know': 25, 'long': ... {'NOUN': 42.4, 'VERB': 26.74, 'PROPN': 13.46, ... {'Marius': 9, 'Mabeuf': 9, 'Javert': 8, 'M. Ma...
27 19010 6227 2429 {'cosette': 117, 'jean': 99, 'valjean': 99, 'm... {'NOUN': 45.62, 'VERB': 24.86, 'ADJ': 14.65, '... {'Jean Valjean': 80, 'Toussaint': 11, 'Jean Va...
28 5147 1616 924 {'gavroche': 30, 'man': 27, 'old': 26, 'montpa... {'NOUN': 44.74, 'VERB': 27.17, 'ADJ': 13.55, '... {'Jean Valjean': 9, 'Cosette': 4, 'Mabeuf': 3,...
29 8297 2540 1159 {'cosette': 52, 'love': 52, 'soul': 22, 'think... {'NOUN': 46.73, 'VERB': 28.23, 'ADJ': 12.09, '... {'Jean Valjean': 11, 'Toussaint': 8, 'Marius':...
30 19202 6144 2261 {'gavroche': 124, 'child': 53, 'thénardier': 5... {'NOUN': 44.68, 'VERB': 26.43, 'ADJ': 12.24, '... {'Montparnasse': 8, 'Guelemer': 5, 'Brujon': 5...
31 12250 4209 2182 {'slang': 74, 'word': 37, 'man': 35, 'le': 30,... {'NOUN': 50.08, 'VERB': 20.81, 'ADJ': 14.8, 'P... {'Slang': 10, 'slang': 3, 'Levantine': 3, 'Vol...
32 18246 5487 2007 {'marius': 151, 'cosette': 83, 'man': 53, 'com... {'NOUN': 40.15, 'VERB': 28.3, 'PROPN': 12.48, ... {'Marius': 14, 'Théodule': 6, 'Cosette': 5, 'E...
33 3868 1278 762 {'go': 19, 'cosette': 14, 'mabeuf': 14, 'day':... {'NOUN': 40.38, 'VERB': 26.92, 'PROPN': 17.21,... {'M. Mabeuf': 10, 'Jean Valjean': 5, 'Marius':...
34 11318 4020 1946 {'rue': 43, 'man': 37, 'insurrection': 29, 're... {'NOUN': 48.03, 'VERB': 20.12, 'PROPN': 15.3, ... {'Lamarque': 4, 'Alexander': 3, 'Mavot': 3, 'L...
35 5879 1920 1073 {'gavroche': 26, 'man': 18, 'old': 17, 'pistol... {'NOUN': 42.5, 'VERB': 23.49, 'PROPN': 18.07, ... {'Combeferre': 5, 'qu’un Dieu': 4, 'qu’un liar...
36 16622 5881 2551 {'rue': 56, 'man': 51, 'de': 49, 'barricade': ... {'NOUN': 42.68, 'VERB': 22.28, 'PROPN': 18.31,... {'Laigle': 18, 'Enjolras': 18, 'Gibelotte': 10...
37 5686 1915 1096 {'war': 27, 'street': 22, 'rue': 20, 'man': 16... {'NOUN': 46.79, 'VERB': 24.07, 'ADJ': 13.84, '... {'Marius': 3, 'Pontmercy': 2, 'Marnix': 2, 'Lo...
38 8872 2801 1210 {'marius': 61, 'barricade': 47, 'enjolras': 25... {'NOUN': 40.81, 'VERB': 29.28, 'PROPN': 12.85,... {'Enjolras': 15, 'Combeferre': 9, 'Marius': 6,...
39 9152 3065 1503 {'jean': 58, 'valjean': 58, 'cosette': 40, 'ga... {'NOUN': 41.99, 'VERB': 24.8, 'PROPN': 15.99, ... {'Jean Valjean': 49, 'Toussaint': 12, 'Jean Va...
40 42720 14285 4027 {'barricade': 167, 'man': 151, 'enjolras': 113... {'NOUN': 48.86, 'VERB': 25.21, 'ADJ': 11.72, '... {'Enjolras': 63, 'Jean Valjean': 49, 'Combefer...
41 9729 3536 1898 {'sewer': 97, 'paris': 57, 'rue': 45, 'city': ... {'NOUN': 47.68, 'VERB': 18.13, 'PROPN': 14.99,... {'Bruneseau': 4, 'Rue': 3, 'Nineveh': 2, 'Henr...
42 21729 7248 2454 {'jean': 127, 'valjean': 126, 'man': 97, 'mari... {'NOUN': 45.09, 'VERB': 26.31, 'ADJ': 11.87, '... {'Jean Valjean': 99, 'Javert': 26, 'Jean Valje...
43 6096 1956 1117 {'javert': 40, 'man': 26, 'jean': 20, 'valjean... {'NOUN': 46.42, 'VERB': 25.77, 'ADJ': 14.37, '... {'Javert': 25, 'Jean Valjean': 17, 'Jean Valje...
44 16027 5172 2260 {'marius': 91, 'man': 73, 'cosette': 62, 'm.':... {'NOUN': 42.07, 'VERB': 23.76, 'PROPN': 15.1, ... {'Jean Valjean': 13, 'Boulatruelle': 6, 'M. Gi...
45 12556 4130 1941 {'cosette': 57, 'jean': 39, 'valjean': 38, 'ma... {'NOUN': 45.96, 'VERB': 23.2, 'ADJ': 13.78, 'P... {'Jean Valjean': 32, 'Marius': 4, 'Jean Valjea...
46 13141 3785 1488 {'marius': 84, 'jean': 79, 'valjean': 79, 'cos... {'NOUN': 39.82, 'VERB': 28.85, 'PROPN': 12.92,... {'Jean Valjean': 67, 'Cosette': 7, 'Marius': 6...
47 6605 2063 952 {'jean': 64, 'valjean': 47, 'cosette': 47, 'da... {'NOUN': 35.24, 'VERB': 27.92, 'PROPN': 17.06,... {'Jean Valjean': 41, 'Jean Valjean’s': 3, 'Tou...
48 18018 5596 1973 {'marius': 99, 'man': 90, 'cosette': 86, 'jean... {'NOUN': 40.19, 'VERB': 27.88, 'PROPN': 13.46,... {'Jean Valjean': 56, 'Monsieur Pontmercy': 10,...

2. Construction de la matrice terme-document, pondération tf-idf et filtrage des mots selon leur fréquence.

Nos premières analyses vont utiliser le corpus avec la table terme-document (la transposée de document-terme). Il y a plusieurs manière de l’obtenir, mais nous allons utiliser ici Gensim, qui propose des objets permettant de la manipuler aisément.

On commence par charger notre corpus en tant que liste de liste (liste de documents, qui sont des listes de tokens). On affiche les 10 premiers tokens du premier document.

corpus_pp_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/TP10/by_book_pp"
file_names = os.listdir(corpus_pp_path)
file_names.sort()
texts = []
for file_name in file_names:
  with open(f"{corpus_pp_path}/{file_name}") as text_file:
    texts.append(text_file.read().split())

texts[0][:10]
['les',
 'misérables',
 'preface',
 'long',
 'shall',
 'exist',
 'virtue',
 'law',
 'custom',
 'decree']

Gensim utilise un objet de type gensim.corpora.Dictionary pour traduire les tokens de notre corpus en identifiant numérique. On doit créer cette objet en donnant notre corpus. Si un token t se traduit par l’identifiant i, alors dictionary[i] donne t et dictionary.token2id[t] donne i.

dictionary = gensim.corpora.Dictionary(texts)
print(len(dictionary))
for key, id in dictionary.token2id.items():
  if id > 10:
    break
  print(f"{key} -> {id}")
17677
1862 -> 0
add -> 1
amid -> 2
artificially -> 3
asphyxia -> 4
book -> 5
century -> 6
child -> 7
civilization -> 8
corruption -> 9
create -> 10

La méthode dictionary.doc2bow(text) va maintenant traduire un texte donné en corpus bag-of-words. Cela nous donnera un liste de couples (id_token, fréquence). On va traduire tout le corpus avec une compréhension de liste.

corpus = [dictionary.doc2bow(text) for text in texts]
corpus[0][:10]
[(0, 1),
 (1, 1),
 (2, 1),
 (3, 1),
 (4, 1),
 (5, 1),
 (6, 1),
 (7, 1),
 (8, 1),
 (9, 1)]

En passant le corpus bag-of-words dans la construction d’un objet gensim.models.TfidfModel, on peut obtenir cette fois notre corpus avec pondération tf-idf.

tfidf = TfidfModel(corpus)
corpus_tfidf = tfidf[corpus]
corpus_tfidf[0][:10]
[(0, np.float64(0.21360152566648632)),
 (1, np.float64(0.005686682294636051)),
 (2, np.float64(0.022468999002229963)),
 (3, np.float64(0.25988862342169544)),
 (4, np.float64(0.21360152566648632)),
 (5, np.float64(0.015242694241619514)),
 (6, np.float64(0.02639825970314883)),
 (7, np.float64(0.0027828262540980316)),
 (8, np.float64(0.050506068959939636)),
 (9, np.float64(0.12102733015606816))]

Nous allons afficher ici les 10 mots avec la plus grande pondération tf-idf dans chacun de nos documents. On affiche le résultat dans une DataFrame. On voit que ces mots sont assez représentatifs des différents livres.

tfidf_df = pd.DataFrame()
for tfidf_doc in corpus_tfidf:
  top_couples = sorted(tfidf_doc, key=lambda item: item[1], reverse=True)[:10]
  top_words = [dictionary[id] for id, _ in top_couples]
  tfidf_df = pd.concat([tfidf_df, pd.Series(top_words)], axis=1,
                       ignore_index=True)
tfidf_df
0 1 2 3 4 5 6 7 8 9 ... 39 40 41 42 43 44 45 46 47 48
0 misérables bishop magloire favourite thénardier madeleine madeleine tilbury fantine wellington ... gavroche enjolras sewer sewer javert marius wedding marius cosette marius
1 artificially magloire bishop tholomyès outfit fantine mayor president javert cuirassier ... lon barricade bruneseau valjean valjean boulatruelle masker cosette valjean cosette
2 crippling myriel valjean blachevelle tholomyès javert javert scaufflaire madeleine waterloo ... où insurgent metre marius quay gillenormand cosette valjean basque baron
3 hauteville monseigneur monseigneur zéphine swing mayor mr. arras simplice english ... fille redoubt cesspool javert canteen cosette gillenormand fauchelevent jean valjean
4 preface d baptistine listolier romance sur champmathieu madeleine maire hougomont ... vont combeferre filth fontis châtelet fauchelevent valjean jean nicolette thénardier
5 unsolved baptistine nineteen fantine truck workroom fantine simplice sister blücher ... valjean gavroche subterranean sand amaze wedding marius motive marius thy
6 world;—in bienvenu knapsack dahlia cosette marguerite brevet usher valjean genappe ... cosette marius city beach parapet grandfather shrove basque adieu changer
7 1862 conventionary gervais bombarda fantine m. valjean champmathieu mayor battle ... blotter cartridge manure shore handing chénier bride pontmercy filles thou
8 asphyxia g labarre fameuil hostelry maire docket maire nun haie ... auvergnat shot trench jean him,—this marry fishwife convict armchair pontmercy
9 pauperism convention madame 1817 fore town faverolles wheelwright portress plateau ... toussaint insurrection vault quay infallibility andré sancy sir armé didst

10 rows × 49 columns

Pour obtenir la matrice terme-document, on applique la fonction gensim.matutils.corpus2dense() sur notre corpus bag-of-words.

term_document = gensim.matutils.corpus2dense(corpus, num_terms=len(dictionary))
term_document.shape
(17677, 49)

Comme le nombre de mots est très élevés pour ce corpus, on va enlever les mots qui apparaissent trop ou pas assez souvent (c’est un traitement fréquent en analyse de données, ces mots ne sont certainement pas assez spécifiques aux différentes parties à analyser, ou trop marignaux). Nous allons pour cela créer une fonction qui donne un dictionnaire contenant la fréquence de chaque terme trouvé dans un corpus bag-of-words.

def get_word_freqs(corpus, dictionary):
  # On transforme le corpus en matrice terme-document
  term_document = gensim.matutils.corpus2dense(corpus,
                                               num_terms=len(dictionary))
  # On fait la somme des colonnes
  frequencies = term_document.sum(axis=1)
  # On construit le dictionnaire
  word_freqs = [(word, frequencies[id])
              for word, id in dictionary.token2id.items()]
  # On le trie
  word_freqs = sorted(word_freqs, key=lambda item: item[1], reverse=True)
  # On le retourne
  return word_freqs

Affichons les mots les plus fréquents de notre corpus.

word_freqs = get_word_freqs(corpus, dictionary)
print(word_freqs[:10])
print(word_freqs[-10:])
[('man', np.float32(2569.0)), ('marius', np.float32(1340.0)), ('jean', np.float32(1218.0)), ('valjean', np.float32(1105.0)), ('come', np.float32(1026.0)), ('like', np.float32(1008.0)), ('cosette', np.float32(1005.0)), ('know', np.float32(968.0)), ('little', np.float32(964.0)), ('day', np.float32(961.0))]
[('twang', np.float32(1.0)), ('ungracious', np.float32(1.0)), ('unlocked', np.float32(1.0)), ('unskilful', np.float32(1.0)), ('vivait', np.float32(1.0)), ('wheedle', np.float32(1.0)), ('yew', np.float32(1.0)), ('york', np.float32(1.0)), ('étrange', np.float32(1.0)), ('”69', np.float32(1.0))]

L’objet dictionnaire de Gensim possède plusieurs méthodes permettant de filtrer certains termes (https://tedboy.github.io/nlps/generated/generated/gensim.corpora.Dictionary.html#gensim.corpora.Dictionary). Ici, nous allons créer une liste de mots qui ne correspondent pas à une fréquence définie (que nous allons poser entre 50 et 1500) et nous utilisons dictionary.filter_tokens() pour les supprimer du dictionnaire. On voit que le nombre de mots a été fortement réduit.

min_freq = 50
max_freq = 1500
banned_word_ids = [dictionary.token2id[word] for word, freq in word_freqs
                   if freq < min_freq or freq > max_freq]
dictionary.filter_tokens(bad_ids=banned_word_ids)
len(dictionary)
973

Nous allons finalement recréer notre objet corpus bag-of-words avec le nouveau dictionnaire.

corpus = [dictionary.doc2bow(text) for text in texts]

3. AFC

Il existe des librairies permettant d’effectuer une AFC en Python (e.g. prince https://pypi.org/project/prince/). Seulement, elle ne sont pas si matures et comme il est relativement aisé d’implémenter sa propre méthode, nous allons la coder ici. La fonction correspondence_analysis(), qui est donnée ci-dessous, permet de sortir toutes les quantitiés d’intérêt de l’AFC.

# Fonction pour la décomposition spectrale
def sorted_eig(matrix, dim_max=None):
    if (dim_max is not None) and dim_max < matrix.shape[0] - 1:
        eigen_values, eigen_vectors = scipy.sparse.linalg.eigs(matrix, dim_max)
    else:
        eigen_values, eigen_vectors = scipy.linalg.eig(matrix)
    sorted_indices = eigen_values.argsort()[::-1]
    eigen_values = eigen_values[sorted_indices]
    eigen_vectors = eigen_vectors[:, sorted_indices]

    return np.real(eigen_values), np.real(eigen_vectors)

# Fonction pour l'analyse de correspondances
def correspondence_analysis(contingency):

    contingency = np.array(contingency)
    n_row, n_col = contingency.shape
    dim_max = min(n_row, n_col) - 1

    total = np.sum(contingency)
    f_row = contingency.sum(axis=1)
    f_row = f_row / sum(f_row)
    f_col = contingency.sum(axis=0)
    f_col = f_col / sum(f_col)
    independency = np.outer(f_row, f_col) * total
    normalized_quotient = contingency / independency - 1

    b_mat = (normalized_quotient * f_col) @ normalized_quotient.T
    k_mat = np.outer(np.sqrt(f_row), np.sqrt(f_row)) * b_mat
    eig_val, eig_vec = sorted_eig(k_mat, dim_max)
    eig_val = np.abs(eig_val[:dim_max])
    eig_vec = eig_vec[:, :dim_max]

    row_coord = np.real(np.outer(1 / np.sqrt(f_row), np.sqrt(eig_val)) * eig_vec)
    col_coord = (normalized_quotient.T * f_row) @ row_coord / np.sqrt(eig_val)
    row_contrib = eig_vec ** 2
    col_contrib = np.outer(f_col, 1 / eig_val) * col_coord ** 2
    row_cos2 = row_coord ** 2
    row_cos2 = (row_cos2.T / row_cos2.sum(axis=1)).T
    col_cos2 = col_coord ** 2
    col_cos2 = (col_cos2.T / col_cos2.sum(axis=1)).T

    # --- Le retour de la fonction
    # dim_max: la dimension maximale de l'AFC
    # eig_val: les valeurs propres
    # row_coord: les coordonnées des lignes
    # col_coord: les coordonnées des colonnes
    # row_contrib: les contributions des lignes
    # col_contrib: les contributions des colonnes
    # row_cos2: le cos2 des lignes
    # col_cos2: le cos2 des colonnes
    return dim_max, eig_val, row_coord, col_coord, \
           row_contrib, col_contrib, row_cos2, col_cos2

Construisons la matrice terme-document.

term_document = gensim.matutils.corpus2dense(corpus,
                                             num_terms=len(dictionary))
term_document.shape
(973, 49)

Et effectuons l’AFC.

dim_max, eig_val, row_coord, col_coord, row_contrib, col_contrib, \
row_cos2, col_cos2 = correspondence_analysis(term_document)

On peut maintenant examiner les différents axes:

  • Si l’on divise chaque valeur propre par la somme des valeurs propres, on obtient le pourcentage d’inertie exprimé sur chaque axe.
  • Les contributions nous permettent de savoir quels mots ont le plus contribué à la création de chaque axe (en pourcentage). Ce résultat permet parfois de “nommer les axes”.
n_top = 5
for dim in range(10):
  # Le pourcentage de variance
  p_var = eig_val[dim] / sum(eig_val)
  # Les mots qui contribuent le plus
  top_contrib_ids = np.argsort(row_contrib[:, dim])[::-1][:n_top]
  contrib_dic = {dictionary[id]: round(row_contrib[id, dim]*100,2)
                 for id in top_contrib_ids}
  # On affiche
  print(f"Axe {dim} ({p_var:.2%}): {contrib_dic}")
Axe 0 (8.72%): {'english': np.float32(3.57), 'wellington': np.float32(3.41), 'battle': np.float32(3.26), 'barricade': np.float32(2.47), 'waterloo': np.float32(2.43)}
Axe 1 (6.41%): {'fauchelevent': np.float32(10.77), 'coffin': np.float32(4.74), 'marius': np.float32(4.67), 'digger': np.float32(4.48), 'prioress': np.float32(3.95)}
Axe 2 (5.91%): {'fauchelevent': np.float32(7.72), 'bishop': np.float32(4.75), 'coffin': np.float32(2.99), 'barricade': np.float32(2.84), 'digger': np.float32(2.62)}
Axe 3 (5.45%): {'wellington': np.float32(6.01), 'english': np.float32(5.51), 'sewer': np.float32(5.17), 'waterloo': np.float32(4.77), 'battle': np.float32(3.39)}
Axe 4 (4.90%): {'sewer': np.float32(15.93), 'valjean': np.float32(3.58), 'javert': np.float32(3.2), 'jean': np.float32(3.18), 'paris': np.float32(2.53)}
Axe 5 (4.74%): {'sewer': np.float32(8.49), 'madeleine': np.float32(6.45), 'javert': np.float32(5.18), 'mayor': np.float32(4.22), 'barricade': np.float32(4.06)}
Axe 6 (4.48%): {'gavroche': np.float32(6.7), 'marius': np.float32(5.64), 'thénardier': np.float32(4.17), 'montparnasse': np.float32(3.75), 'jean': np.float32(3.14)}
Axe 7 (3.96%): {'bishop': np.float32(11.29), 'magloire': np.float32(4.3), 'valjean': np.float32(3.9), 'madeleine': np.float32(3.65), 'jean': np.float32(3.61)}
Axe 8 (3.81%): {'slang': np.float32(29.72), 'language': np.float32(5.52), 'sewer': np.float32(3.84), 'bishop': np.float32(2.56), 'montparnasse': np.float32(1.77)}
Axe 9 (3.30%): {'jondrette': np.float32(5.25), 'gavroche': np.float32(4.66), 'fauchelevent': np.float32(3.24), 'tholomyès': np.float32(2.91), 'montparnasse': np.float32(2.59)}

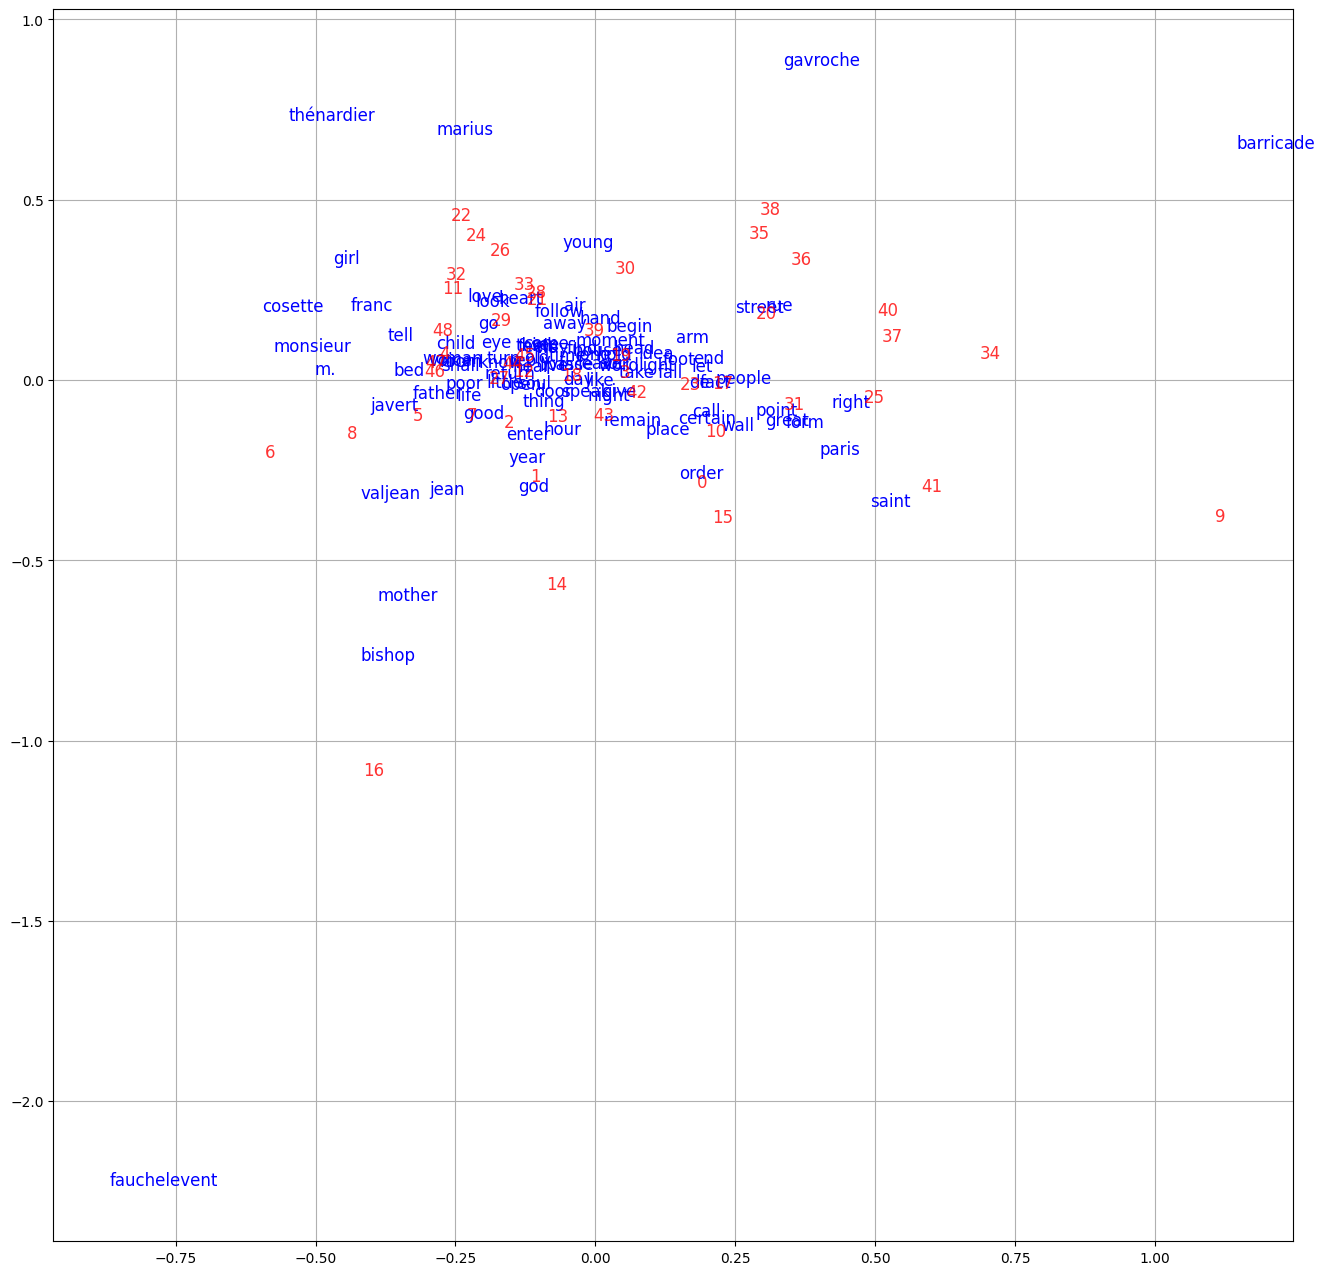
On va maintenant afficher les coordonnées de 100 termes les plus fréquents et des documents sur le même graphique, selon les axes sélectionnés sur la première ligne. C’est le biplot. On peut intérpréter le produit scalaire entre les points de différents types (terme-document) comme des attirances, et la distance entre deux points de même type (terme-terme, document-document) exprime leur dissemblance en terme de profil de fréquences (via la distance du chi2).

axes = [0, 1]

# Taille du graphique
plt.rcParams["figure.figsize"] = [16, 16]

# Filtre sur les mots les plus fréquents
top_n = 100
word_freqs = get_word_freqs(corpus, dictionary)
top_words = [word for word, _ in word_freqs[:top_n]]
top_word_ids = [dictionary.token2id[word] for word in top_words]
top_row_coord = row_coord[top_word_ids, :]

# On fait une matrice de toutes les coordonées
all_coord = np.concatenate([top_row_coord, col_coord])

# --- Plot

fig, ax = plt.subplots()

ax.scatter(all_coord[:, axes[0]], all_coord[:, axes[1]], alpha=0, color="white")

for i, txt in enumerate(top_words):
    ax.annotate(txt, (top_row_coord[i, axes[0]], top_row_coord[i, axes[1]]),
                size=12, color="blue")

for i, txt in enumerate(range(len(corpus))):
    ax.annotate(txt, (col_coord[i, axes[0]], col_coord[i, axes[1]]),
                size=12, color="red", alpha=0.8)

ax.grid()
plt.show()


4. L’allocation de Dirichlet latente

Nous allons maintenant faire une allocation de Dirichlet latente avec Gensim. On utilise pour cela la classe gensim.models.LdaModel, qui utilise notre corpus en bag-of-words, un nombre de thèmes fixé et notre dictionnaire. L’instance de la classe résultante va contenir tous les résultats pertinents de la méthode.

lda_model = LdaModel(corpus, num_topics=5, id2word=dictionary, passes=10)

On peut obtenir les principaux mots utilisés dans chaque thème avec la méthode show_topics().

lda_model.show_topics()
[(0,
  '0.026*"jean" + 0.024*"fauchelevent" + 0.023*"valjean" + 0.012*"cosette" + 0.011*"madeleine" + 0.011*"father" + 0.010*"m." + 0.009*"good" + 0.009*"know" + 0.008*"come"'),
 (1,
  '0.028*"jean" + 0.026*"valjean" + 0.008*"take" + 0.007*"like" + 0.007*"long" + 0.006*"day" + 0.006*"javert" + 0.006*"old" + 0.006*"come" + 0.006*"hand"'),
 (2,
  '0.009*"rue" + 0.009*"barricade" + 0.008*"gavroche" + 0.007*"enjolras" + 0.007*"like" + 0.006*"street" + 0.006*"de" + 0.006*"come" + 0.006*"paris" + 0.006*"take"'),
 (3,
  '0.014*"m." + 0.010*"little" + 0.009*"good" + 0.008*"woman" + 0.008*"bishop" + 0.008*"old" + 0.007*"know" + 0.007*"day" + 0.007*"child" + 0.007*"like"'),
 (4,
  '0.026*"marius" + 0.016*"cosette" + 0.011*"thénardier" + 0.009*"come" + 0.008*"know" + 0.008*"go" + 0.008*"day" + 0.008*"old" + 0.007*"time" + 0.007*"father"')]

Laa répartition des thèmes dans un document particulier s’obtient avec get_document_topics().

lda_model.get_document_topics(corpus[1], minimum_probability=0)
[(0, np.float32(3.856128e-05)),
 (1, np.float32(0.004535061)),
 (2, np.float32(0.0013868642)),
 (3, np.float32(0.9938374)),
 (4, np.float32(0.00020212517))]

Les mesures de cohérence sont obtenues avec un objet de classe gensim.models.CoherenceModel, qui utilise par défault la mesure \(C_v\) (pour plus de détails concernant ces mesures, voir http://svn.aksw.org/papers/2015/WSDM_Topic_Evaluation/public.pdf).

coherence_model = CoherenceModel(lda_model, texts=texts, dictionary=dictionary)
coherence_model.get_coherence()
np.float64(0.3349543563436549)

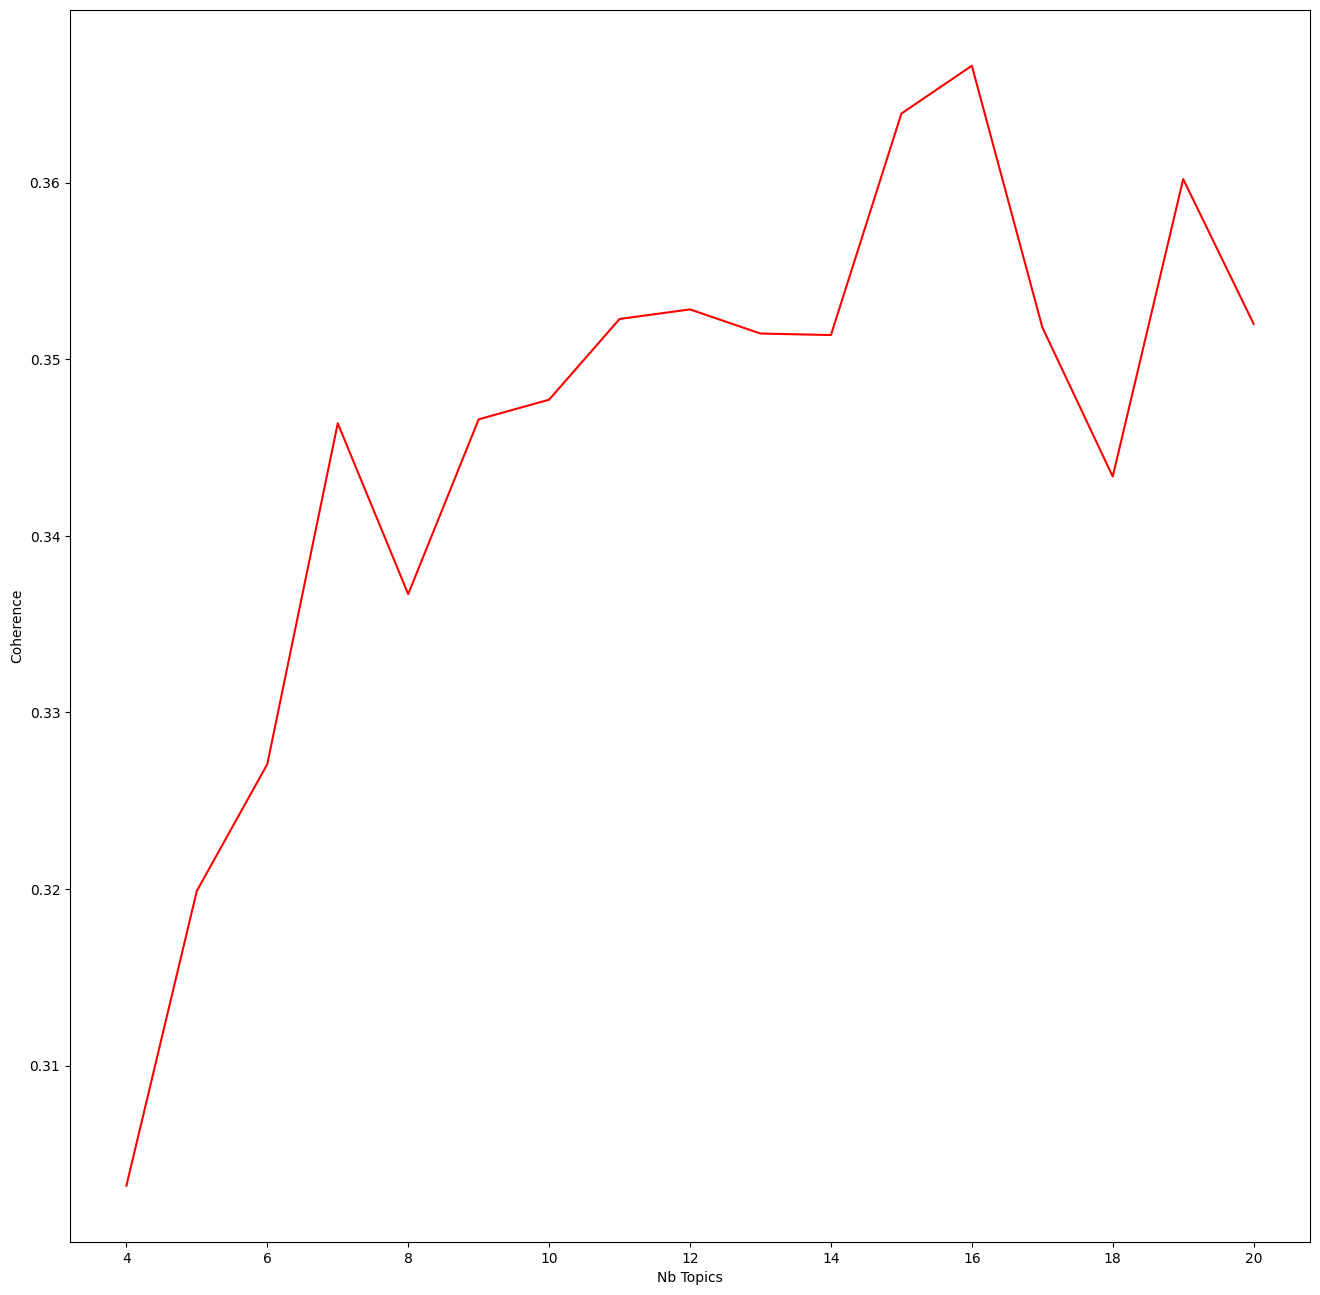
On pourrait effectuer une recherche des meilleurs hyperparmètres \(k\), \(\alpha\), et \(\eta\) pour notre corpus en maximisant cette mesure de cohérence. Seulement, comme l’optimisation de tous les hyperparamètres peut s’avérer très lente, nous n’allons optimiser ici que le nombre de thèmes. On va créer 3 modèles pour chaque valeur de \(k\), afin de limiter l’effet de l’initialisation aléatoire.

ks = list(range(4, 21))
n_tests = 3
coherences = []
for k in tqdm(ks):
  sum_coherence = 0
  for _ in range(n_tests):
    lda_model = LdaModel(corpus, id2word=dictionary,
                        num_topics=k, passes=10)
    sum_coherence += CoherenceModel(lda_model, texts=texts,
                                    dictionary=dictionary).get_coherence()

  coherences.append(sum_coherence / n_tests)
100%|██████████| 17/17 [08:17<00:00, 29.28s/it]

Cette boucle nous permet de tracer la courbe de la cohérence en fonction du nombre de thèmes.

fig, ax = plt.subplots()
ax.plot(ks, coherences, c="red")
ax.set_xlabel("Nb Topics")
ax.set_ylabel("Coherence")
plt.plot()

On va retenir le nombre de thèmes qui maximise la cohérence, et on entraine un modèle avec cet hyperparamètre.

optimal_k = ks[np.argmax(coherences)]
lda_model = LdaModel(corpus, num_topics=optimal_k, id2word=dictionary,
                     passes=10)

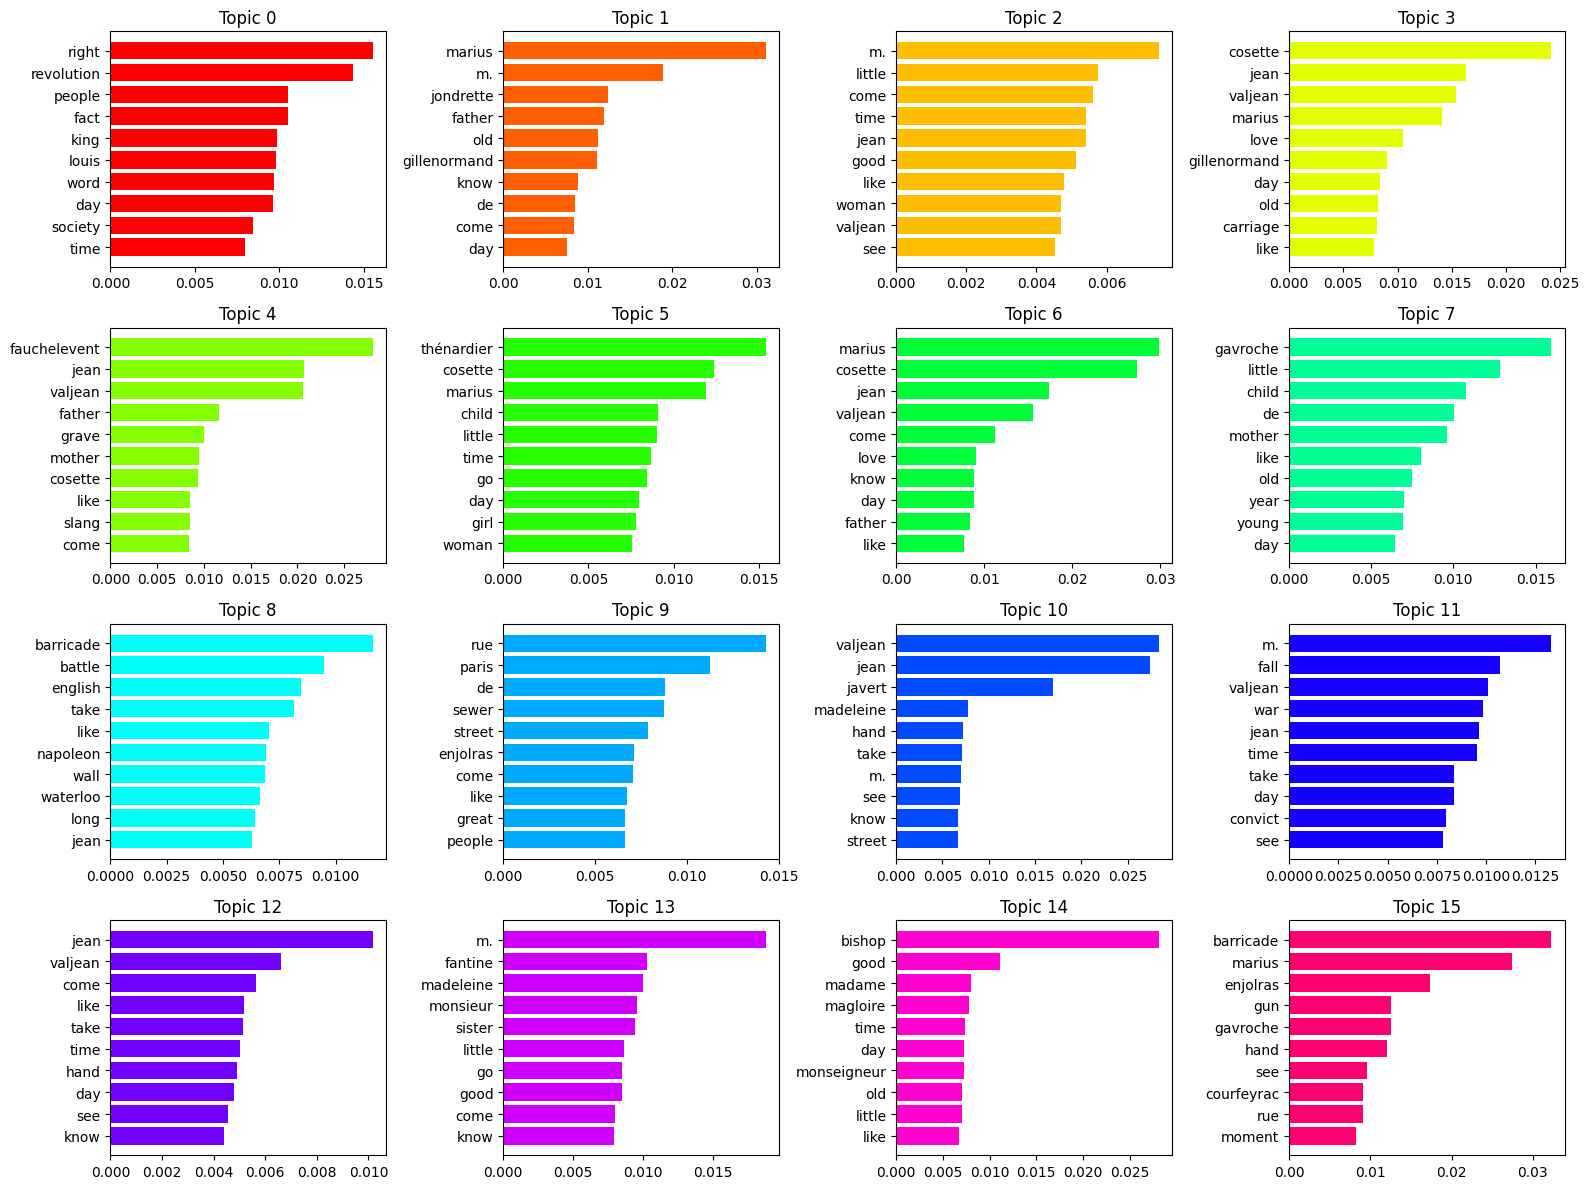
Dans des graphiques en barres, nous allons afficher la répartition des 10 mots les plus utilisés par thème. Cela nous permettra de les interpréter.

# Pour les couleurs des topics
topic_color = colormaps["hsv"](np.linspace(0.0, 1.0, lda_model.num_topics + 1))

# Pour avoir le nombre d'éléments sur les lignes et colonnes
nx_grid = int(np.sqrt(lda_model.num_topics))
ny_grid= int(np.ceil(lda_model.num_topics / nx_grid))

# On reformate la taille de la figure et on fait une grille
plt.rcParams["figure.figsize"] = [ny_grid*4, nx_grid*3]
fig = plt.figure()
gride_layout = GridSpec(nx_grid, ny_grid)

# Boucle sur les topics
for i in range(lda_model.num_topics):

  # Les 10 mots le plus fréquents dans le topic
  top_words = lda_model.show_topic(i, topn=10)
  words = [word for word, _ in top_words]
  freqs = [freq for _, freq in top_words]

  # On ajoute la figure
  ax = fig.add_subplot(gride_layout[i])
  ax.barh(words, freqs, color=topic_color[i])
  ax.set_title(f"Topic {i}")
  ax.invert_yaxis()

gride_layout.tight_layout(fig)

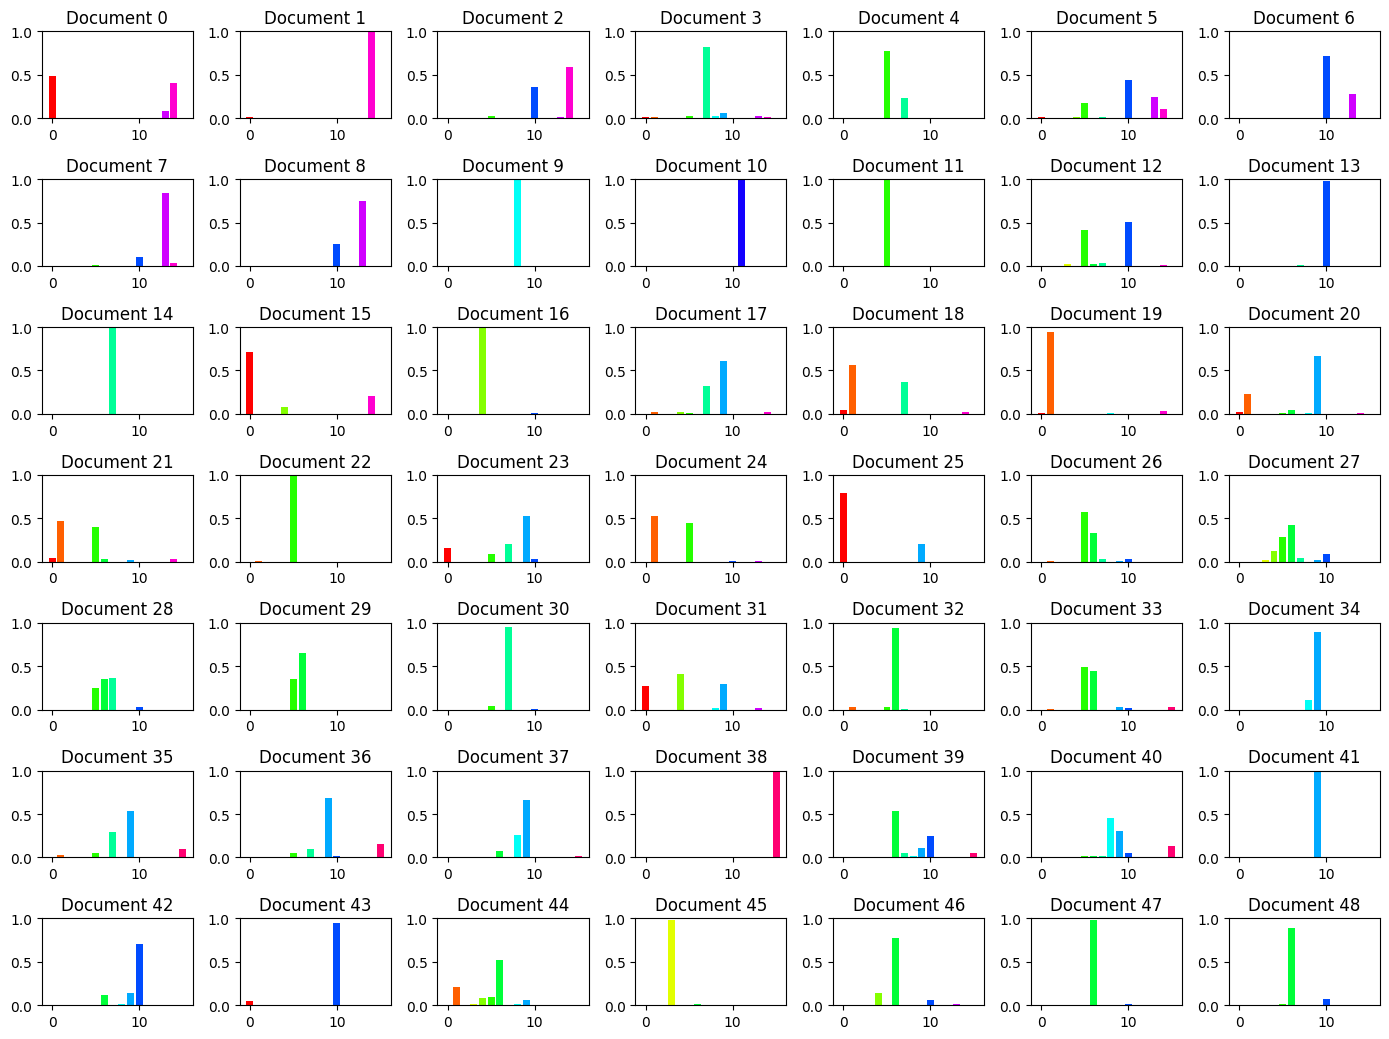
On fait de même pour la répartition des thèmes dans les documents. En combinant l’interprétation de la sortie précédante avec celle-ci, on peut fréquemment avoir quelques observations pertinentes sur notre corpus.

# Pour avoir le nombre d'éléments sur les lignes et colonnes
nx_grid = int(np.sqrt(len(corpus)))
ny_grid= int(np.ceil(len(corpus) / nx_grid))

# On reformate la taille de la figure et on fait une grille
plt.rcParams["figure.figsize"] = [ny_grid*2, nx_grid*1.5]
fig = plt.figure()
gride_layout = GridSpec(nx_grid, ny_grid)

# Boucle sur les topics
for i, document in enumerate(corpus):

  # Les topics dans le document
  topics_freqs = lda_model.get_document_topics(document, minimum_probability=0)
  topics = [topic for topic, _ in topics_freqs]
  freqs = [freq for _, freq in topics_freqs]

  # On ajoute la figure
  ax = fig.add_subplot(gride_layout[i])
  ax.bar(topics, freqs, color=topic_color)
  ax.set_title(f"Document {i}")
  ax.set_ylim([0, 1])

gride_layout.tight_layout(fig)


5. Word2Vec

Finalement, nous allons utiliser Gensim pour entrainer un modèle de type Word2Vec sur notre corpus. Cela nous permettra de visuliser une carte sémantique et syntaxique basée sur Les Misérables.

Gensim contient beaucoup de méthodes de word embedding, ainsi que des outils pour charger des word embeddings venant de sources externes (e.g. de https://wikipedia2vec.github.io/wikipedia2vec/ ou de https://fasttext.cc/docs/en/crawl-vectors.html).

On commence par charger à nouveau notre corpus, mais en ne gardant uniquement que la séparation en tokens et en phrases. Le résultat de cette opération est une liste de phrases qui sont des listes de tokens.

corpus_pp_path = "/content/drive/MyDrive/Colab Notebooks/ml_data/TP10/by_book_pp"
file_names = os.listdir(corpus_pp_path)

sentences = []
for file_name in file_names:
  with open(f"{corpus_pp_path}/{file_name}") as text_file:
    text_sentences = text_file.readlines()
    text_token_sentences = [text_sentence.split() for
                            text_sentence in text_sentences]
    sentences.extend(text_token_sentences)

sentences[0]
['les', 'misérables', 'preface']

On utilise la classe gensim.models.Word2Vec pour créer notre embedding avec les mots de fréquence minimale 100 (min_count=100), une fenêtre de +/-5 tokens (window=5), une dimension d’embedding de 300 (vector_size=300) et avec la méthode skip-gram (sg=1). L’objet de retour (ici wv_model) contient de nombreuses informations sur le résultat.

wv_model = Word2Vec(sentences, min_count=100, window=5, vector_size=300, sg=1)

On peut voir le vocabulaire qui a été transformé en vecteur avec l’attribut wv.vocab.

wv_vocab = wv_model.wv.key_to_index
wv_words = list(wv_vocab.keys())
len(wv_words)
441

Vérifions au préalable si certains mots sont bien dans notre embedding.

print("gavroche" in wv_words)
print("cosette" in  wv_words)
print("valjean" in  wv_words)
True
True
True

Le vecteur d’un mot particulier est donné avec la méthode wv_model.wv.get_vector(). On affiche les 10 premières coordonnées de “cosette”.

wv_model.wv.get_vector("cosette")[0:10]
array([ 0.05388348,  0.13285135,  0.02303923,  0.09333002, -0.17121944,
       -0.11159007,  0.01827363,  0.19811545,  0.02285229,  0.00781742],
      dtype=float32)

On peut obtenir la similarité du cosinus (https://en.wikipedia.org/wiki/Cosine_similarity) entre des couples mots. Avec les word embeddings, on utilise quasiment exclusivement cette similarité pour mesurer la proximité entre les vecteurs.

print(wv_model.wv.similarity("valjean", "cosette"))
print(wv_model.wv.similarity("valjean", "gavroche"))
print(wv_model.wv.similarity("cosette", "gavroche"))
0.7357849
0.5357821
0.7114197

Il est également possible d’avoir les mots les plus similaires à un mot donné.

wv_model.wv.most_similar("cosette")
[('marius', 0.9010487794876099),
 ('pause', 0.8781106472015381),
 ('fantine', 0.8774930238723755),
 ('continue', 0.8492462635040283),
 ('listen', 0.8447422385215759),
 ('soon', 0.841275155544281),
 ('thou', 0.8387840986251831),
 ('think', 0.8310457468032837),
 ('exclaim', 0.8307632803916931),
 ('forget', 0.8289012312889099)]
wv_model.wv.most_similar("valjean")
[('convict', 0.8336817622184753),
 ('recognize', 0.8170298933982849),
 ('cosette', 0.7357848882675171),
 ('remain', 0.7288203835487366),
 ('moment', 0.7040982842445374),
 ('javert', 0.6979842185974121),
 ('pause', 0.6869488954544067),
 ('seek', 0.6815629601478577),
 ('silence', 0.6744802594184875),
 ('prisoner', 0.6727491617202759)]

Des “calculs” sont possibles dans la méthode wv_model.wv.most_similar().

wv_model.wv.most_similar(positive=["monsieur", "cosette"], negative=["valjean"])
[('sister', 0.875137984752655),
 ('daughter', 0.8691832423210144),
 ('yes', 0.8655902743339539),
 ('address', 0.8439401388168335),
 ('gentleman', 0.8371121883392334),
 ('reply', 0.8236821293830872),
 ('brother', 0.8223061561584473),
 ('want', 0.8195735216140747),
 ('sir', 0.8143653273582458),
 ('resume', 0.8104207515716553)]

On va maintenant afficher les mots les plus fréquents de notre embedding. Commençons par extraire les 100 premiers mots du corpus.

n_top_words = 100
word_freq = [(word, wv_model.wv.get_vecattr(wv_vocab[word], 'count')) for
             word in wv_words]
word_freq = sorted(word_freq, key=lambda item: item[1], reverse=True)
top_words = word_freq[:n_top_words]
top_words[:10]
[('man', np.int64(2569)),
 ('marius', np.int64(1340)),
 ('jean', np.int64(1218)),
 ('valjean', np.int64(1105)),
 ('come', np.int64(1026)),
 ('like', np.int64(1008)),
 ('cosette', np.int64(1005)),
 ('know', np.int64(968)),
 ('little', np.int64(964)),
 ('day', np.int64(961))]

On extrait leurs coordonnées avec wv_model.wv.get_vector().

top_vectors = np.empty((len(top_words), 300), dtype="f")
for i, (word, _) in enumerate(top_words):
  top_vectors[i] = wv_model.wv.get_vector(word)
top_vectors.shape
(100, 300)

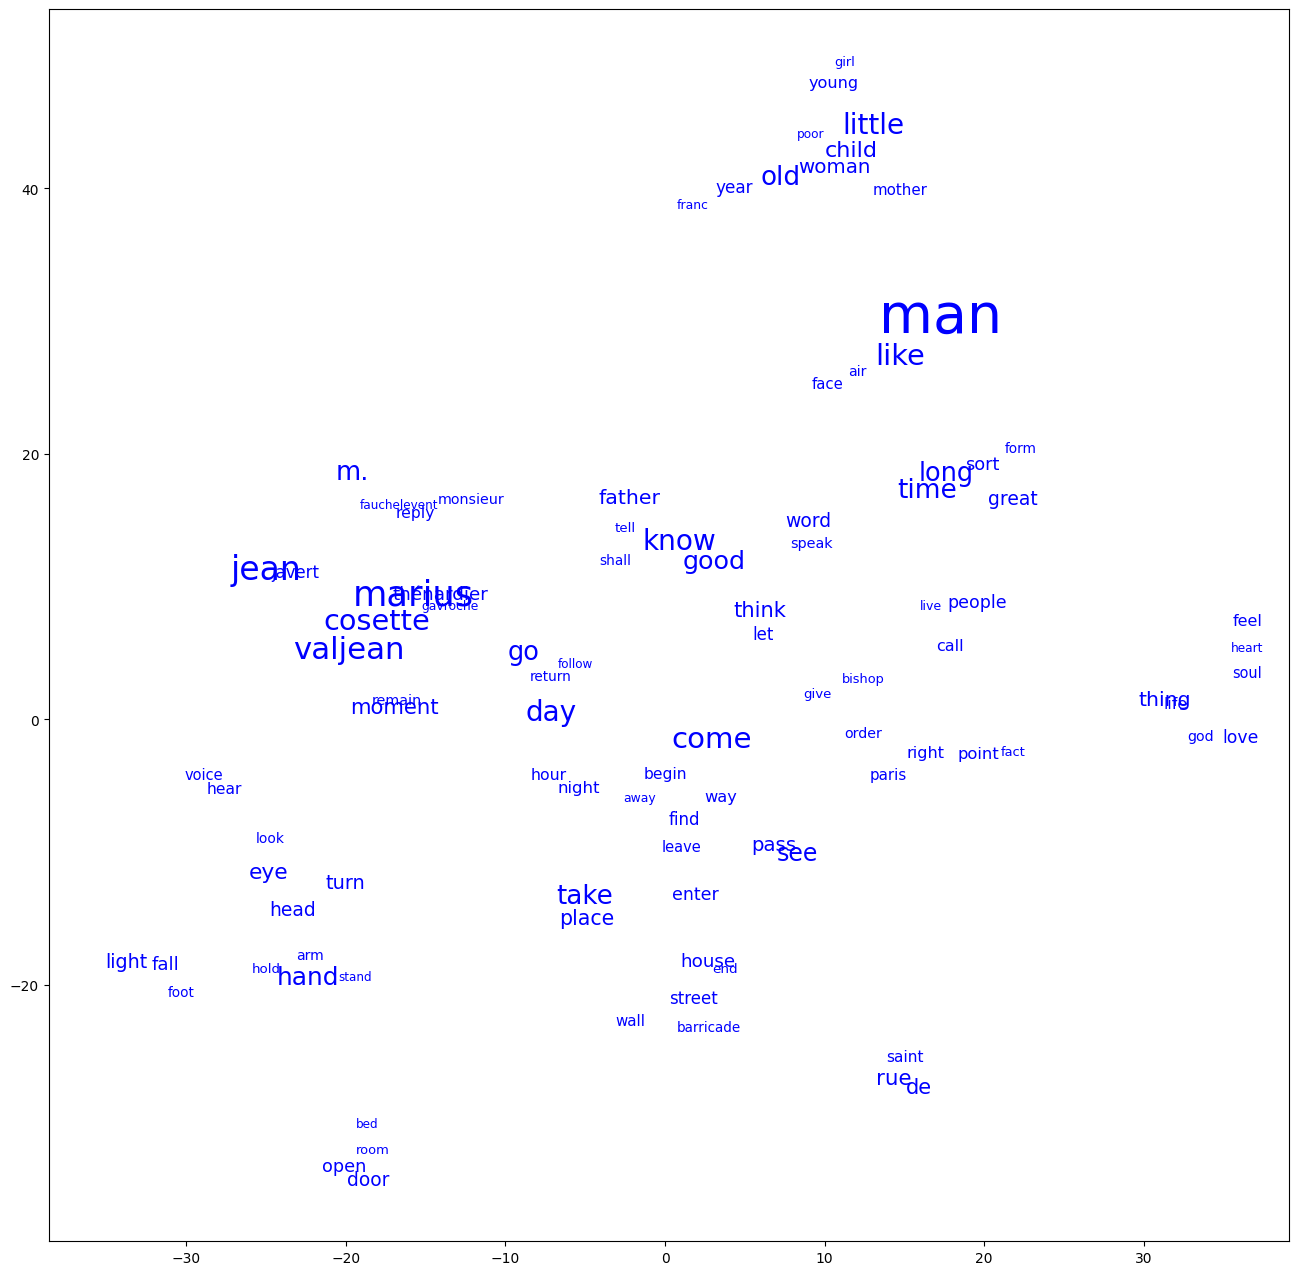
On effectue une projection tSNE de ces vecteurs dans un espace à 2 dimensions.

coords_2d = TSNE(n_components=2, perplexity=5,
                 init="pca",
                 learning_rate="auto").fit_transform(top_vectors)

Et on affiche les vecteurs. La structure entre les différents mots permet d’obtenir de l’information sur l’utilisation ce ces mots dans le corpus.

plt.rcParams["figure.figsize"] = [16, 16]
plt.scatter(coords_2d[:,0], coords_2d[:,1], alpha=0)
for word, x, y in zip(top_words, coords_2d[:,0], coords_2d[:,1]):
    plt.annotate(word[0], xy=(x, y), xytext=(0, 0), textcoords="offset points",
                 size=(word[1]/top_words[0][1])**(0.7)*40,
                 color="blue")
plt.show()