Dans ce TP, nous allons effectuer une Analyse factorielle des correspondances (AFC) dans un cadre d’analyse des données textuelles, c’est-à-dire en utilisant la matrice documents-termes.
L’AFC est très utilisée dans ce cadre, en particulier dans le monde francophone grâce à l’impulsion de Jean-Paul Benzécri. Elle permet de produire une visualisation pertinente des proximités entre les différents documents d’un corpus (vis-à-vis de leur utilisation du vocabulaire) et permet l’affichage simultané des documents et des mots, ce qui aide dans l’interprétation des positions des documents.
Nous allons utiliser ici la librairie FactoMineR (http://factominer.free.fr/index_fr.html), qui possède de nombreuses méthodes d’analyses factorielles. La librairie factoextra possède plusieurs fonctions utiles dans l’affichage des résultats de FactoMineR.
library(tidyverse)
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
library(readtext)library(quanteda)
Package version: 4.4
Unicode version: 14.0
ICU version: 71.1
Parallel computing: disabled
See https://quanteda.io for tutorials and examples.

Attachement du package : 'quanteda'

L'objet suivant est masqué depuis 'package:readtext':

    texts
library(FactoMineR)library(factoextra)
Welcome to factoextra!
Want to learn more? See two factoextra-related books at https://www.datanovia.com/en/product/practical-guide-to-principal-component-methods-in-r/
library(plotly)
Warning: le package 'plotly' a été compilé avec la version R 4.6.1
Attachement du package : 'plotly'

L'objet suivant est masqué depuis 'package:ggplot2':

    last_plot

L'objet suivant est masqué depuis 'package:stats':

    filter

L'objet suivant est masqué depuis 'package:graphics':

    layout
1 Pré-traitements
1.1 Chargement et création de l’objet tokens
Encore une fois, nous allons charger notre corpus avec readtext() :
texts_df =readtext("data/manifesto/*.txt")
Nous allons créer l’objet tokens (à partir de l’objet corpus) quanteda en enlevant la ponctuation, les symboles, etc. :
L’objet de type document-feature (document-terme) se crée avec la fonction dfm() :
dfm_obj =dfm(tokens_obj)
On convertit cet objet en dataframe R :
dfm_df =convert(dfm_obj, to="data.frame")
La première colonne contient les noms des documents, on l’utilise pour créer les noms des lignes (et enlever cette colonne) :
dfm_df = dfm_df %>%column_to_rownames("doc_id")
Cette matrice est maintenant purement numérique et peut être utilisée dans les fonctions de FactoMineR.
2 L’AFC
2.1 La fonction CA()
L’analyse factorielle des correspondances s’effectue avec la fonction CA() (“correspondence analysis”) de FactoMineR. Par défaut, cette fonction va afficher automatiquement les graphiques résultants. On peut désactiver cette option avec graph=F :
ca_res =CA(dfm_df, graph=F)
Le retour de cette fonction possède plusieurs éléments, que l’on peut voir avec names(), ou même en affichant la variable du retour :
ca_res
**Results of the Correspondence Analysis (CA)**
The row variable has  9  categories; the column variable has 7674 categories
The chi square of independence between the two variables is equal to 72144.29 (p-value =  3.094457e-186 ).
*The results are available in the following objects:

   name              description
1  "$eig"            "eigenvalues"
2  "$col"            "results for the columns"
3  "$col$coord"      "coord. for the columns"
4  "$col$cos2"       "cos2 for the columns"
5  "$col$contrib"    "contributions of the columns"
6  "$row"            "results for the rows"
7  "$row$coord"      "coord. for the rows"
8  "$row$cos2"       "cos2 for the rows"
9  "$row$contrib"    "contributions of the rows"
10 "$call"           "summary called parameters"
11 "$call$marge.col" "weights of the columns"
12 "$call$marge.row" "weights of the rows"
Nous verrons plus loin comment utiliser ces différentes valeurs. Pour le moment voyons comment afficher le biplot à partir de cette sortie.
2.2 Le biplot
Pour tracer le biplot, il suffit d’appliquer la fonction plot() sur notre objet de sortie :
plot(ca_res)
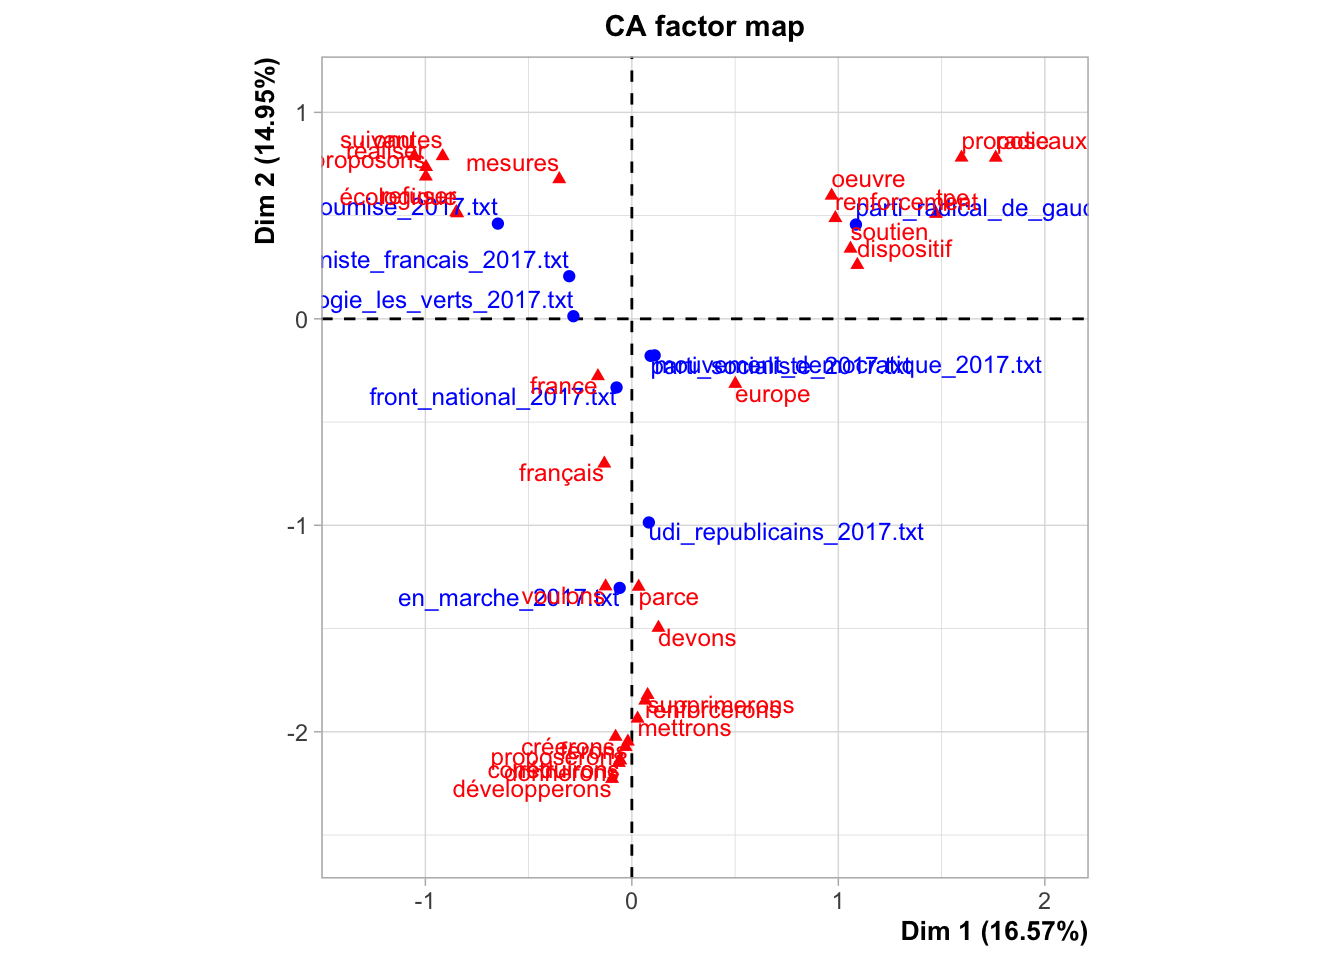
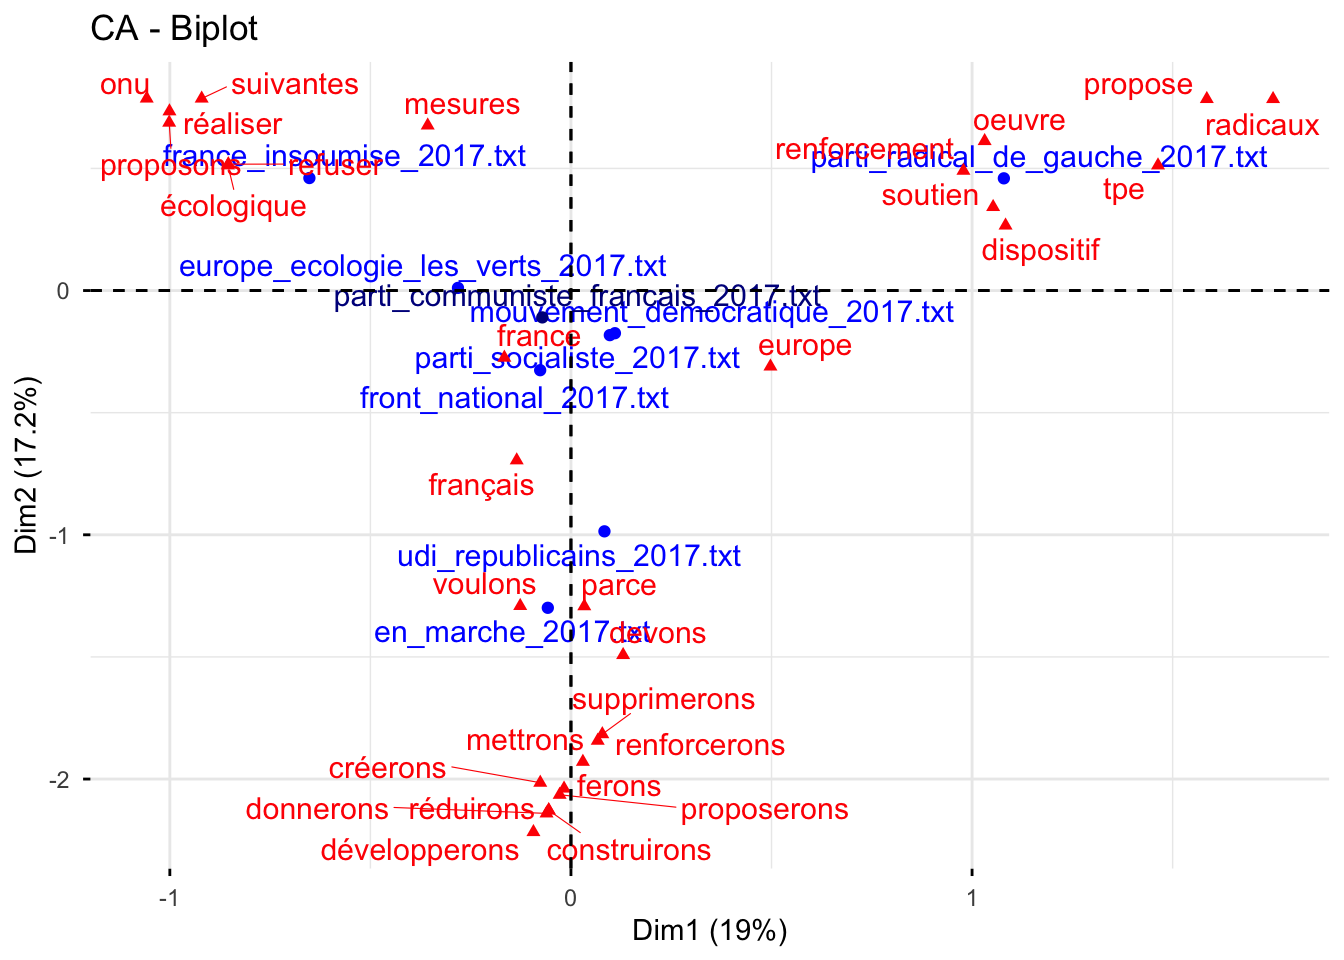
Le problème est qu’il y a beaucoup trop de mots pour y voir quelque chose. On utilise les paramètres selectCol="contrib 30" (sélectionne les 30 mots avec la plus grande contribution aux axes affichés) et unselect=1 (rend invisibles les points non-sélectionnés) pour afficher un sous-ensemble de points (on désactive également l’auto-positionnement des labels avec autoLab="no" et on diminue la taille de la police avec cex=0.8) :
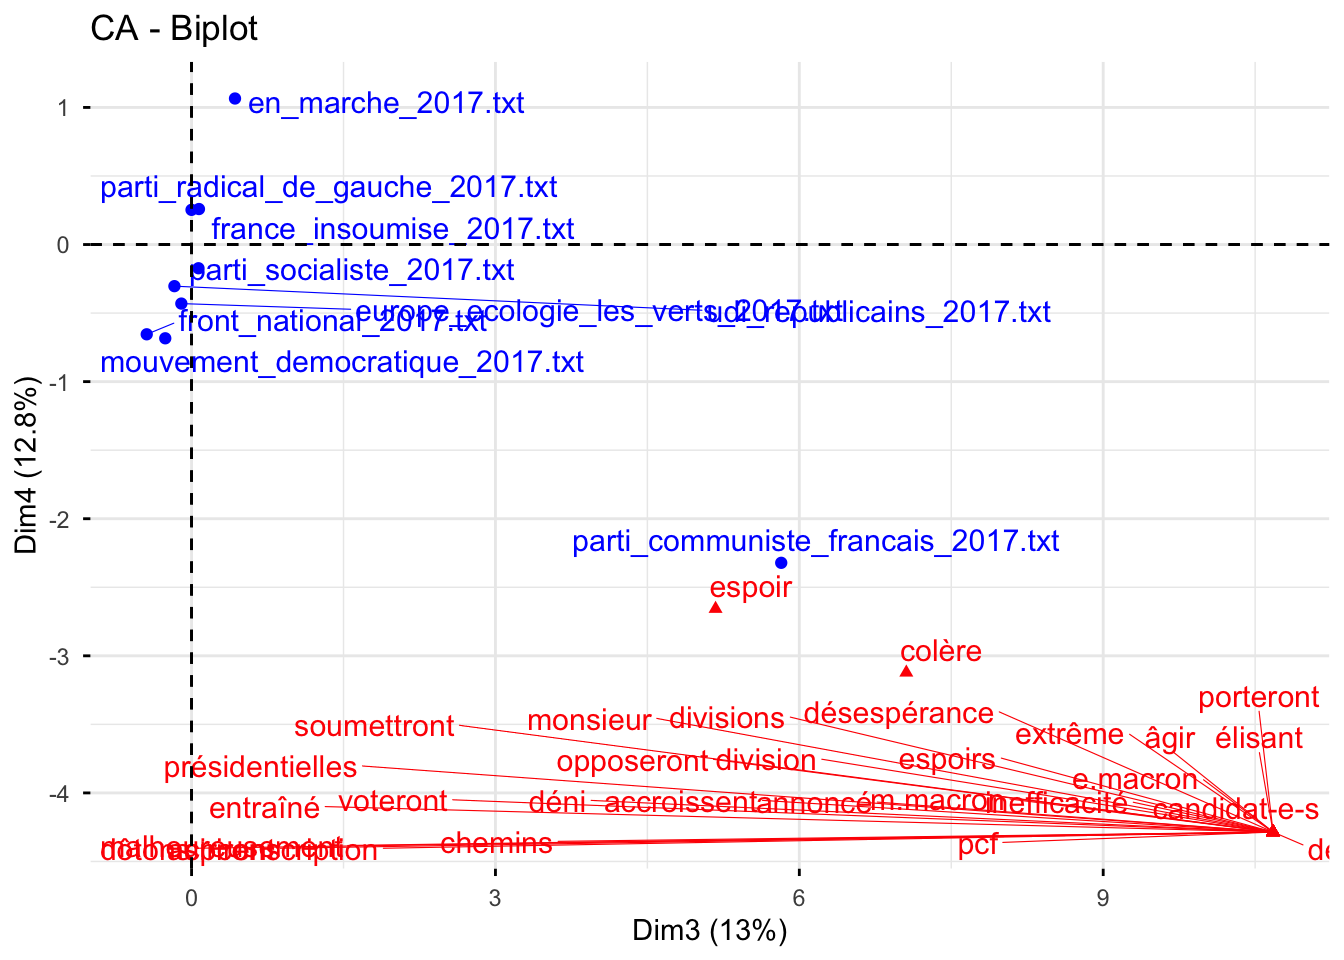
Mais ici, le document du Parti communiste français, par son particularisme, semble absorber toute l’inertie.
2.3 Lignes ou colonnes supplémentaires
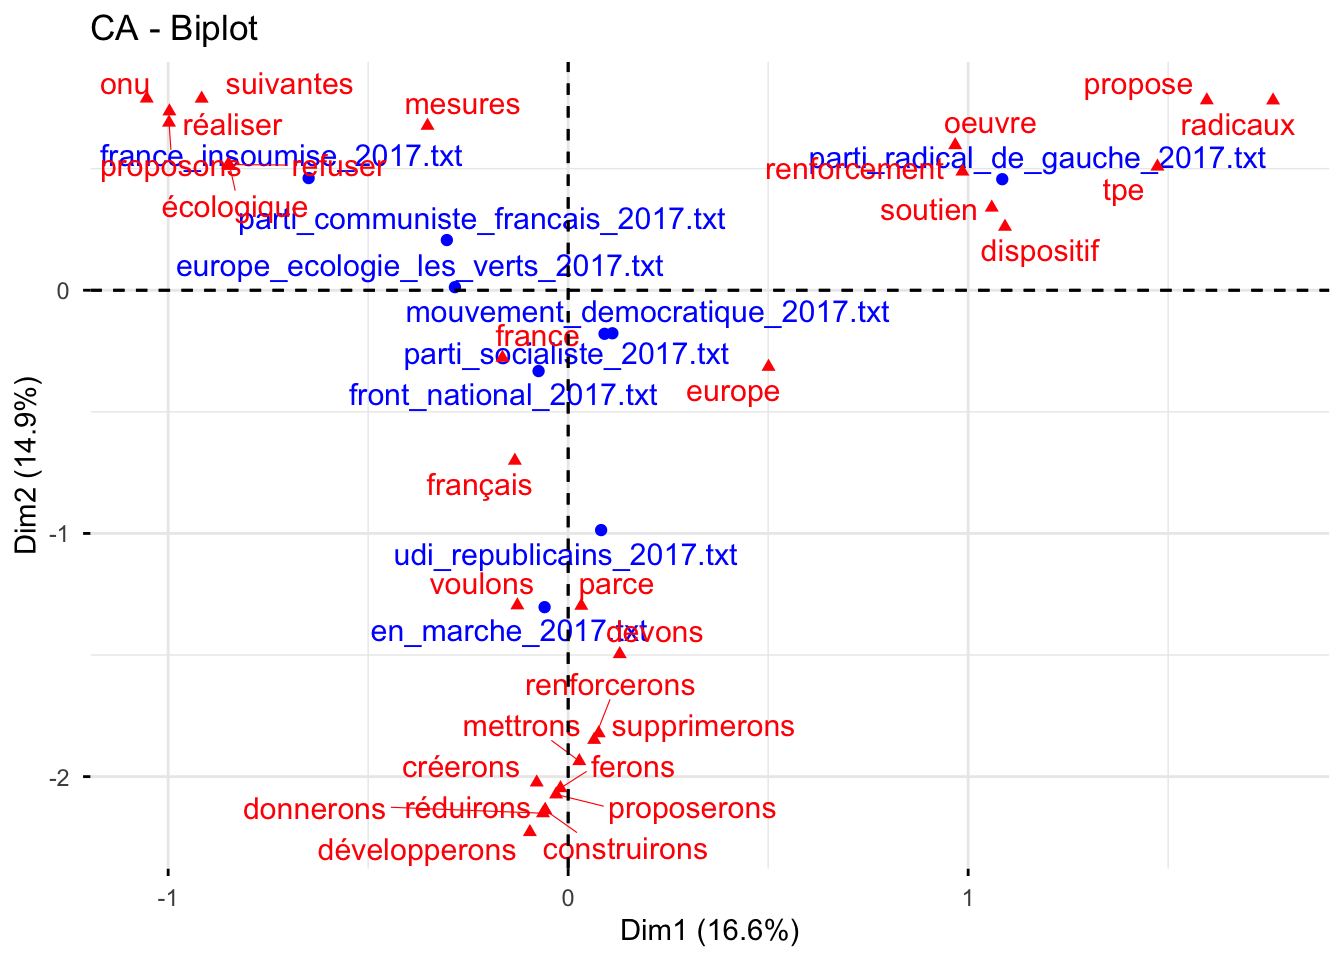
Comme le document du Parti communiste français est si particulier, on peut éventuellement refaire une AFC en le mettant comme ligne supplémentaire. Attention, on doit ajouter une petite quantité à la matrice pour éviter des colonnes vides :
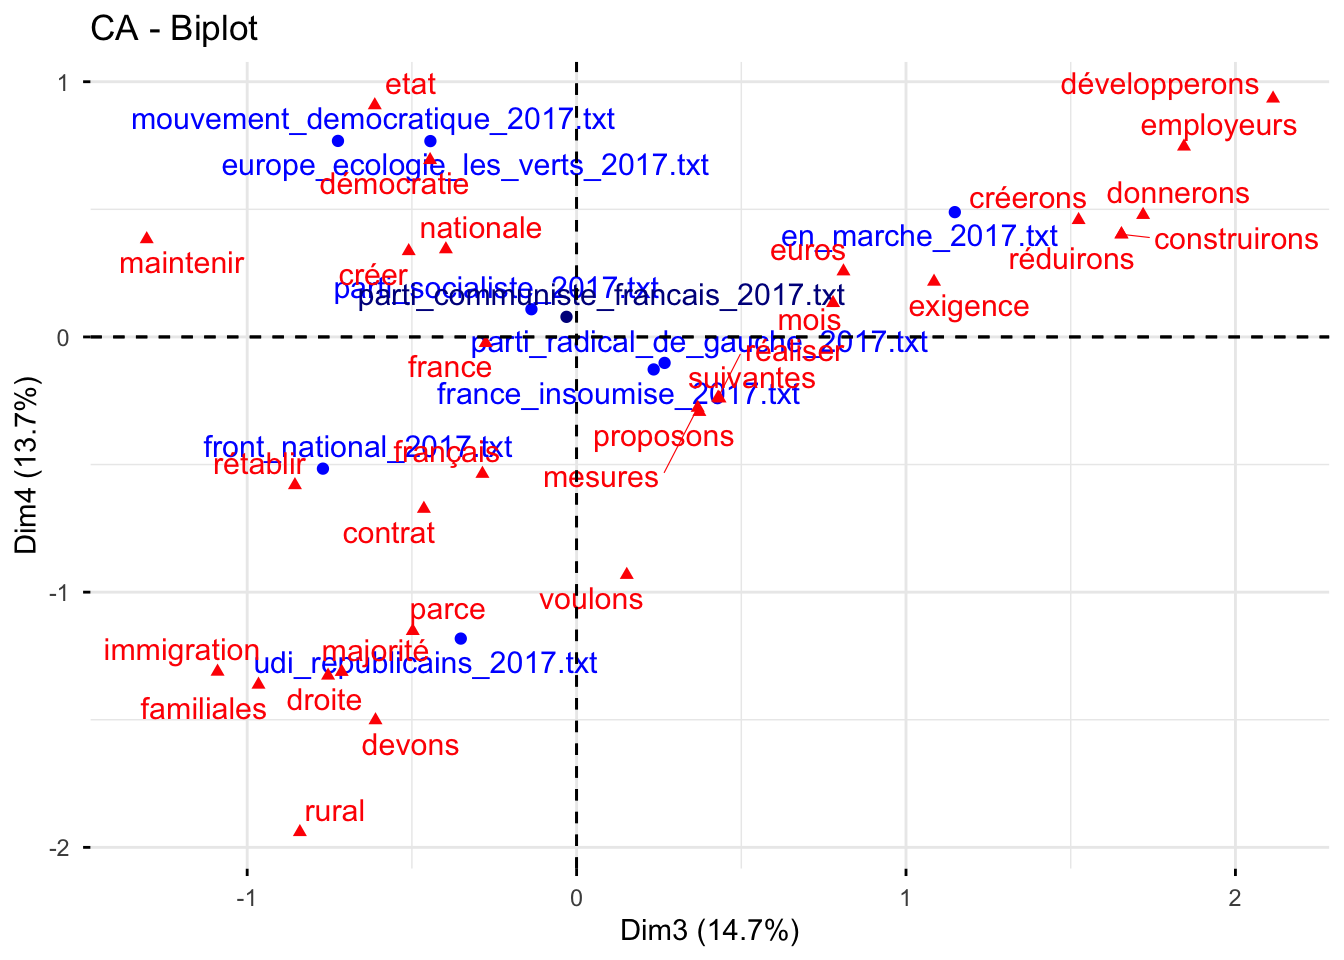
On peut alors refaire nos graphiques. La ligne correspondant au Parti communiste sera toujours affichée, mais n’a pas été utilisée pour définir les axes :
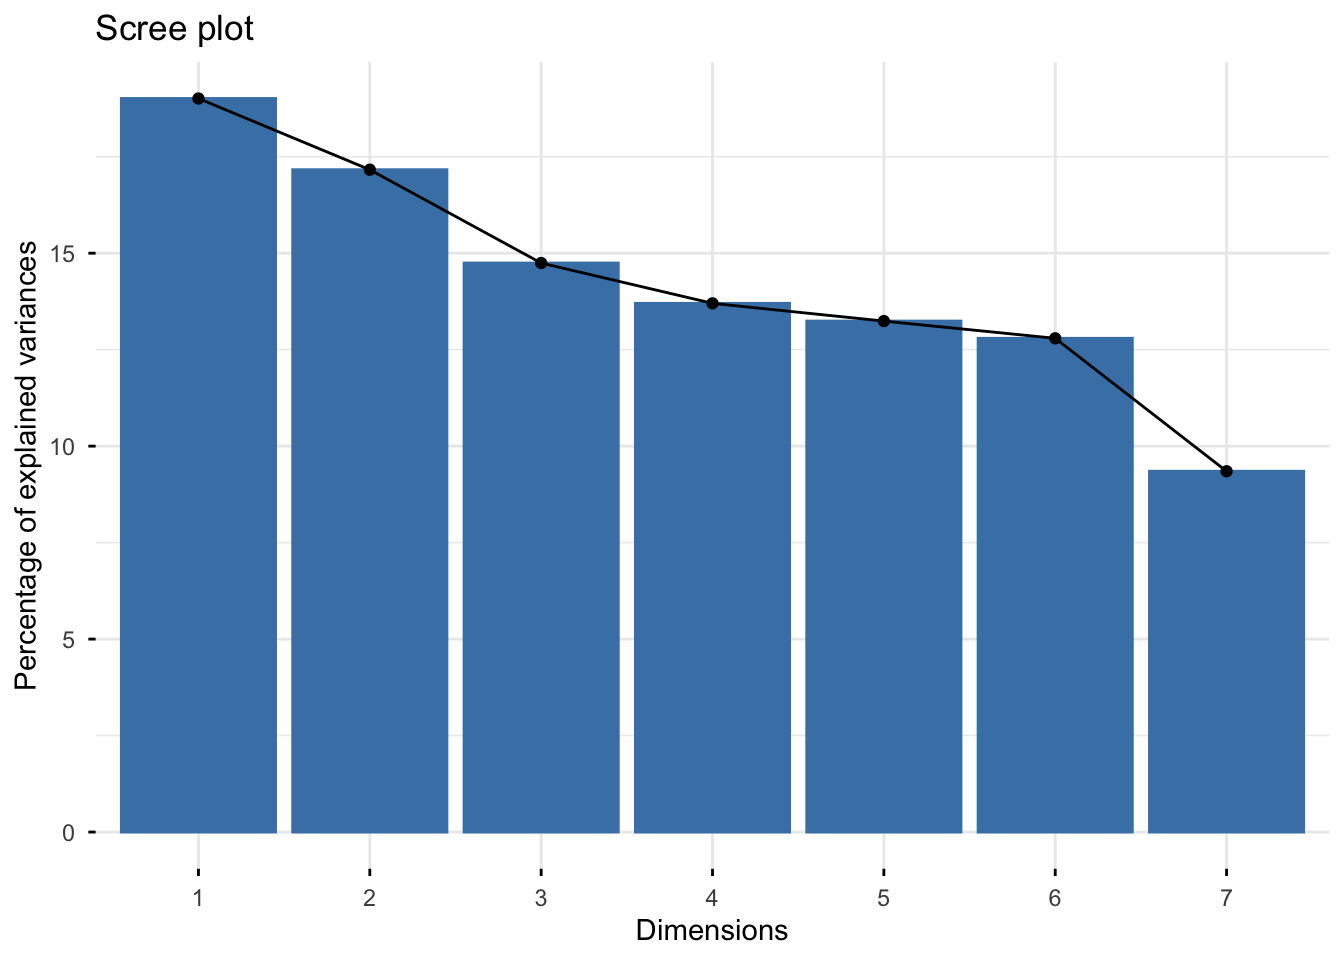
Plusieurs mesures peuvent être obtenues à partir de la sortie de CA. Par exemple, le pourcentage de variance expliquée par chaque axe :
ca_noPCF_res$eig
      eigenvalue percentage of variance cumulative percentage of variance
dim 1  0.3801665              19.008089                          19.00809
dim 2  0.3432619              17.162885                          36.17097
dim 3  0.2948976              14.744699                          50.91567
dim 4  0.2740065              13.700155                          64.61583
dim 5  0.2648177              13.240720                          77.85655
dim 6  0.2558857              12.794127                          90.65068
dim 7  0.1869888               9.349324                         100.00000
Le même résultat avec fviz_eig() :
fviz_eig(ca_noPCF_res)
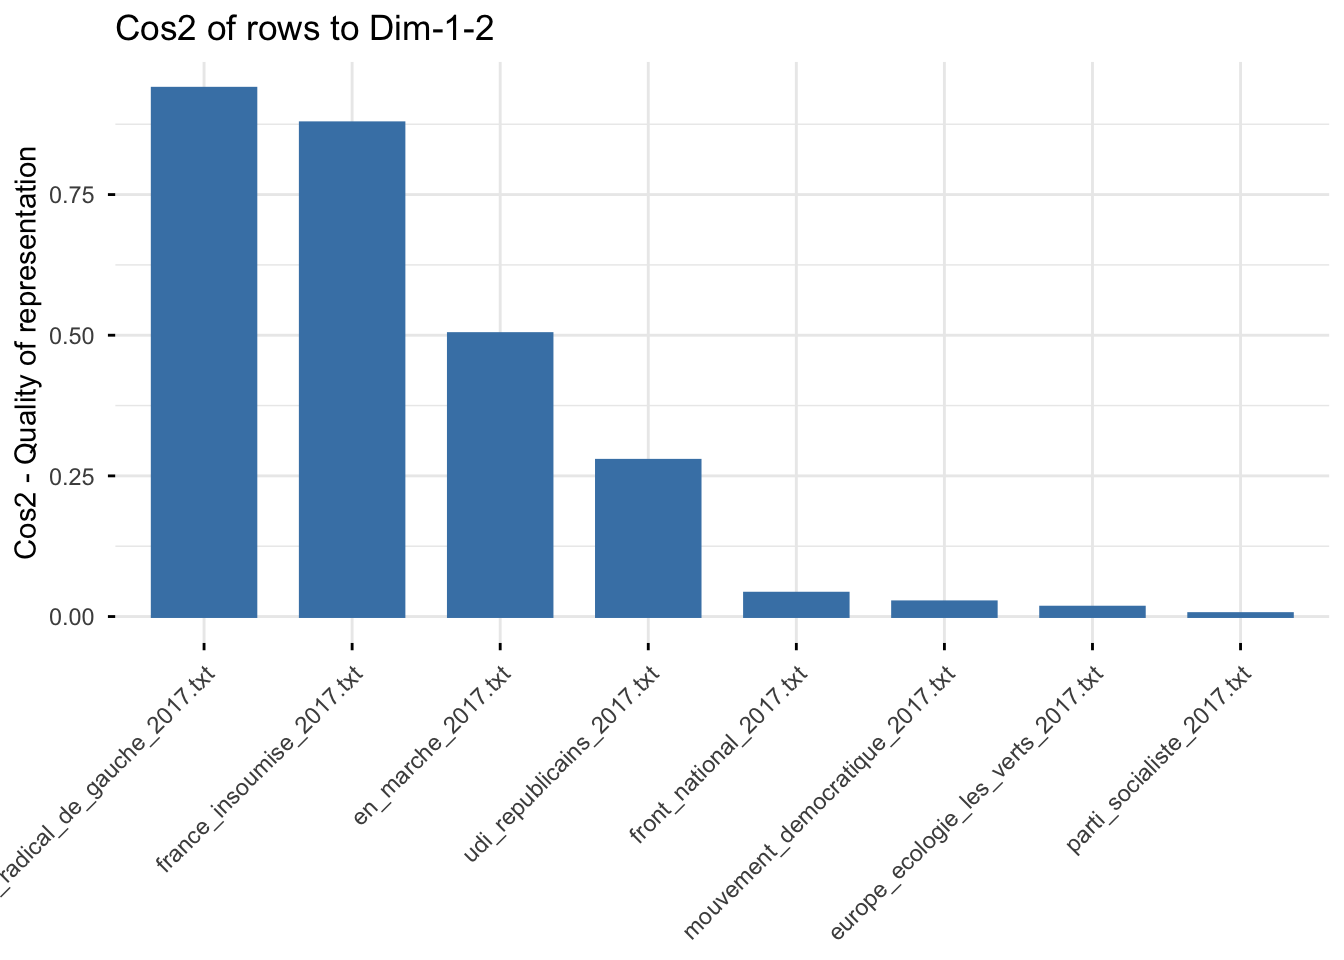
La qualité de la représentation des lignes ou colonnes sur chaque axe s’exprime avec les cosinus carrés :