library(tidyverse)
library(readtext)
library(quanteda)
library(quanteda.textstats)
library(quanteda.textplots)1 Introduction
Dans ce TP, nous allons explorer les bases de la textométrie ou lexicométrie. Cette discipline, à la croisée de la linguistique, de la statistique et de l’informatique, permet d’analyser des corpus de textes de manière quantitative. L’objectif est de complémenter la lecture (l’analyse qualitative) pour identifier des motifs, des récurrences ou des spécificités qui ne sont pas immédiatement visibles à l’oeil nu dans un corpus.
Nous utiliserons encore une fois quanteda, ainsi que quelque un des ses packages supplémentaires :
1.1 Chargement et préparation du corpus
On charge notre corpus avec readtext(). Pour ce TP, nous travaillons encore une fois sur le corpus des manifestes politiques français :
texts_df = readtext("data/manifesto/*.txt")
texts_df
readtext object consisting of 9 documents and 0 docvars.
# A data frame: 9 × 2
doc_id text
<chr> <chr>
1 en_marche_2017.txt "\"Emmanuel M\"..."
2 europe_ecologie_les_verts_2017.txt "\"Il y a urg\"..."
3 france_insoumise_2017.txt "\"L'AVENIR E\"..."
4 front_national_2017.txt "\"Au nom du \"..."
5 mouvement_democratique_2017.txt "\"La France \"..."
6 parti_communiste_francais_2017.txt "\"Le peuple \"..."
# ℹ 3 more rowsOn crée les deux objets quanteda fondamentaux : - Le corpus : contient les textes bruts et leurs métadonnées. - Les tokens : le texte segmenté en unités.
corpus_obj = corpus(texts_df)
tokens_obj = tokens(corpus_obj)
Notez qu’il est possible d’enlever plusieurs types de tokens dans la fonction tokens() avec les options remove_punct, remove_symbols, remove_numbers, remove_url, et remove_separators. On peut également sélectionner ou enlever des tokens choisis de l’objet de type tokens après sa création, à l’aide des fonctions token_select() ou token_remove() (nous le verrons plus tard).
2 Statistiques et indices descriptifs
Le package quanteda.textstats propose plusieurs fonctions permettant d’obtenir divers statistiques et indices portant sur chaque texte. Cela permet de quantifier le “style” d’écriture de chaque document.
2.1 Statistiques globales
Pour obtenir des statistiques globales, on peut utiliser textstat_summary() sur l’objet de type corpus :
textstat_summary(corpus_obj) document chars sents tokens types puncts numbers
1 en_marche_2017.txt 41182 333 6775 1835 930 75
2 europe_ecologie_les_verts_2017.txt 23726 127 3911 1291 493 132
3 france_insoumise_2017.txt 139096 506 21987 4359 2283 342
4 front_national_2017.txt 36170 235 5910 1809 618 66
5 mouvement_democratique_2017.txt 64903 424 10297 2647 1348 57
6 parti_communiste_francais_2017.txt 3072 17 543 276 67 3
7 parti_radical_de_gauche_2017.txt 84406 346 13435 3250 1486 81
8 parti_socialiste_2017.txt 8973 26 1510 620 160 55
9 udi_republicains_2017.txt 31438 238 5262 1539 504 35
symbols urls tags emojis
1 1 0 0 0
2 57 0 0 0
3 8 0 0 0
4 1 0 0 0
5 4 0 0 0
6 0 0 0 0
7 2 0 0 0
8 2 0 0 0
9 2 0 0 02.2 Diversité lexicale
La diversité lexicale mesure la “richesse” du vocabulaire. L’indice le plus simple est le TTR (Type-Token Ratio) : le nombre de mots uniques (types) divisé par le nombre total de mots (tokens). Cet indice présente cependant des défauts : il est très sensible à la longueur du texte (plus un texte est long, plus le TTR baisse).
Il existe de nombreux indices qui essaie de corriger ce problème, et que l’on peut obtenir avec textstat_lexdiv() sur l’objet tokens :
textstat_lexdiv(tokens_obj, measure="all") document TTR C R CTTR
1 en_marche_2017.txt 0.3095857 0.8646090 23.51425 16.627088
2 europe_ecologie_les_verts_2017.txt 0.3682255 0.8763529 20.92415 14.795609
3 france_insoumise_2017.txt 0.2173194 0.8453611 30.23318 21.378090
4 front_national_2017.txt 0.3374163 0.8730976 24.38985 17.246230
5 mouvement_democratique_2017.txt 0.2926418 0.8648543 27.58915 19.508475
6 parti_communiste_francais_2017.txt 0.5560254 0.9047033 12.09275 8.550868
7 parti_radical_de_gauche_2017.txt 0.2692567 0.8601397 29.33045 20.739758
8 parti_socialiste_2017.txt 0.4447022 0.8868971 15.99074 11.307161
9 udi_republicains_2017.txt 0.3181529 0.8646273 21.86014 15.457453
U S K I D Vm Maas
1 27.77955 0.8901815 105.6898 8.966826 0.01057081 0.1009079 0.1897306
2 28.37970 0.8948609 130.3033 10.251784 0.01303437 0.1117989 0.1877138
3 27.72117 0.8845843 119.3774 3.942812 0.01193836 0.1084051 0.1899303
4 29.29879 0.8966593 122.7049 9.183431 0.01227284 0.1090626 0.1847460
5 29.21888 0.8942822 114.4410 7.431584 0.01144538 0.1056983 0.1849985
6 28.06878 0.8982128 119.7878 23.933910 0.01200416 0.1014429 0.1887506
7 29.13124 0.8927454 110.3836 6.531493 0.01103929 0.1039694 0.1852766
8 27.51123 0.8942627 147.4415 13.033152 0.01475557 0.1173815 0.1906536
9 27.14013 0.8882211 119.1259 8.395214 0.01191512 0.1070450 0.1919526
MATTR MSTTR lgV0 lgeV0
1 0.7205450 0.7166667 6.472111 14.90259
2 0.6939105 0.6950000 6.384421 14.70067
3 0.7128107 0.7136269 6.783791 15.62026
4 0.7140616 0.7144231 6.658359 15.33144
5 0.7159916 0.7148864 6.802759 15.66393
6 0.6964171 0.7150000 5.680085 13.07888
7 0.7222232 0.7250847 6.870723 15.82042
8 0.6888442 0.6950000 5.973734 13.75503
9 0.7037278 0.7048936 6.322815 14.55882On trouve par exemple, parmi ces derniers : L’indice R de Guiraud : version normalisée du TTR, qui divise le nombre de types par la racine carrée du nombre de tokens. Le MATTR : Moving-Average Type-Token Ratio, qui calcule le TTR sur des fenêtres mobiles de taille fixe, puis fait la moyenne de ces TTR. Regardez l’aide de la fonction (?textstat_lexdiv) pour comprendre les nombreux autres indices présentés.
2.3 Indices de lisibilité
Ces indices estiment la facilité de lecture d’un texte en se basant sur des critères formels. Ces indices s’obtiennent avec textstat_readability() sur l’objet de type corpus :
textstat_readability(corpus_obj, measure="all") document ARI ARI.simple ARI.NRI Bormuth.MC
1 en_marche_2017.txt 12.29987 65.23874 11.38699 -3.037219
2 europe_ecologie_les_verts_2017.txt 16.77707 74.21938 14.82920 -4.897926
3 france_insoumise_2017.txt 24.25972 89.05313 21.51447 -7.238259
4 front_national_2017.txt 16.45072 73.39402 15.48566 -4.050422
5 mouvement_democratique_2017.txt 15.00788 70.57408 13.98209 -3.763505
6 parti_communiste_francais_2017.txt 17.06000 74.83551 14.78838 -5.221406
7 parti_radical_de_gauche_2017.txt 23.52018 87.43930 21.63892 -6.396699
8 parti_socialiste_2017.txt 30.42420 101.41493 26.27149 -9.756687
9 udi_republicains_2017.txt 14.29691 69.16250 13.35819 -3.530319
Bormuth.GP Coleman Coleman.C2 Coleman.Liau.ECP Coleman.Liau.grade
1 72933678 33.71184 35.32706 34.48173 13.61582
2 302779111 33.83931 32.49773 33.67544 13.83675
3 976694580 28.78451 26.28411 25.73647 16.01205
4 171874141 26.43753 26.92871 25.64689 16.03660
5 138558731 28.61969 29.32466 29.32159 15.02972
6 366202934 30.91049 29.54491 36.01111 13.19676
7 674369895 25.12067 23.47917 19.20919 17.80056
8 2381921725 30.74868 27.10666 26.72625 15.74085
9 113985507 30.49408 31.42298 30.15268 14.80199
Coleman.Liau.short Dale.Chall Dale.Chall.old Dale.Chall.PSK Danielson.Bryan
1 13.61668 -39.24680 19.64873 15.39123 6.685901
2 13.83786 -46.37638 20.21261 16.02624 7.567809
3 16.01335 -54.16176 20.72465 16.68095 9.347405
4 16.03768 -43.53440 20.03477 15.79063 7.715390
5 15.03074 -41.99528 19.87082 15.63779 7.333860
6 13.19788 -46.28524 20.08725 15.97403 7.557590
7 17.80186 -52.04878 20.66642 16.53339 9.412435
8 15.74222 -61.96275 21.17088 17.31203 10.594875
9 14.80297 -40.60579 19.71728 15.49774 7.172765
Danielson.Bryan.2 Dickes.Steiwer DRP ELF Farr.Jenkins.Paterson
1 78.05384 -387.3800 403.7219 7.774775 40.019794
2 79.64151 -505.6547 589.7926 11.952756 30.491315
3 77.86411 -671.9333 823.8259 18.770751 12.030911
4 75.10772 -477.2756 505.0422 11.263830 25.909573
5 76.51546 -445.8735 476.3505 10.202830 30.047080
6 80.89432 -527.5869 622.1406 13.352941 25.142157
7 74.26924 -641.4034 739.6699 17.601156 12.058213
8 79.96053 -841.7612 1075.6687 24.230769 1.203903
9 76.62979 -430.4035 453.0319 9.340336 33.577626
Flesch Flesch.PSK Flesch.Kincaid FOG FOG.PSK FOG.NRI FORCAST
1 42.228039 7.059644 11.75303 15.08413 6.722164 724.97123 11.60909
2 26.894488 8.105828 16.26259 20.40933 9.660864 691.68295 11.59427
3 8.820876 9.356740 21.76825 26.32214 13.165868 5955.67655 12.18203
4 22.192159 8.253699 15.79429 19.91044 8.765860 929.30349 12.45494
5 28.522429 7.880480 14.56070 18.55976 8.192705 1437.60346 12.20120
6 32.441611 7.846795 15.90956 18.96638 9.594897 95.68912 11.93483
7 5.427794 9.434751 21.12328 25.36756 12.162841 3278.38903 12.60806
8 -1.224892 10.200291 26.41531 30.88562 16.518317 530.86212 11.95364
9 33.092558 7.607082 13.62779 17.48280 7.724797 704.01628 11.98325
FORCAST.RGL Fucks Linsear.Write LIW nWS nWS.2 nWS.3
1 11.20000 93.31231 14.16216 49.99759 9.32680 9.718725 8.192257
2 11.18369 142.07874 25.92126 60.20375 11.84057 12.283662 11.127217
3 11.83024 217.14229 41.71542 76.73948 14.96100 15.334147 14.235992
4 12.13043 127.74894 24.57872 61.26691 12.55271 12.865153 11.236428
5 11.85132 116.46698 21.37736 57.39707 11.51669 11.847533 10.385243
6 11.55831 147.47059 21.41176 60.45058 11.25018 11.587118 9.879195
7 12.29887 203.34393 39.86127 75.24533 15.05229 15.363308 14.005114
8 11.57901 285.42308 52.15385 88.39874 16.66340 17.080919 16.234036
9 11.61157 109.45378 18.97479 55.20439 10.96490 11.330390 9.713317
nWS.4 RIX Scrabble SMOG SMOG.C SMOG.simple SMOG.de Spache
1 8.499429 5.708709 1.471613 13.87839 13.41065 13.30613 8.306125 10.73456
2 12.068537 8.976378 1.487949 17.67173 16.98097 16.94308 11.943079 11.94939
3 16.019000 14.715415 1.469752 21.57769 20.68333 20.68801 15.688008 13.35626
4 11.766123 8.748936 1.462236 17.29012 16.62034 16.57720 11.577202 11.43966
5 10.851975 7.681604 1.483653 16.33573 15.71958 15.66216 10.662156 11.19849
6 11.063774 9.117647 1.521299 16.34635 15.72959 15.67234 10.672341 12.10326
7 15.403764 14.069364 1.491435 21.16304 20.28953 20.29045 15.290446 12.89612
8 19.034564 18.884615 1.480736 23.75715 22.75525 22.77761 17.777610 14.86982
9 10.123647 7.050420 1.468236 15.57148 14.99968 14.92941 9.929414 11.00328
Spache.old Strain Traenkle.Bailer Traenkle.Bailer.2 Wheeler.Smith
1 11.65481 9.179279 -415.7480 -277.7923 77.74775
2 13.06344 14.688189 -526.0310 -269.3198 119.52756
3 14.70832 21.996047 -698.4586 -300.0273 187.70751
4 12.46505 12.990638 -503.4141 -308.7776 112.63830
5 12.19221 11.812500 -474.1453 -294.5480 102.02830
6 13.24868 14.858824 -537.5076 -258.2996 133.52941
7 14.16228 20.450289 -668.8883 -330.7128 176.01156
8 16.47990 28.730769 -851.7963 -291.9283 242.30769
9 11.97071 10.912185 -457.9543 -292.6777 93.40336
meanSentenceLength meanWordSyllables
1 17.64565 1.734003
2 27.18898 1.800753
3 39.20356 1.870242
4 22.66383 1.910627
5 21.25236 1.852736
6 28.88235 1.714868
7 34.70231 1.964354
8 52.26923 1.832230
9 20.06303 1.812984La quasi-totalité de ces indices reposent sur deux variables mathématiques simples : la longueur des mots (en lettres ou en syllabes) et la longueur des phrases (en mots).
Pour prendre un exemple, on y trouve par exemple l’indice Flesch, un des plus célèbres, qui se lit sur une échelle de 0 à 100. Plus le score est élevé, plus le texte est facile à lire (80-100 : livre pour enfant, 50-80 : texte standard), alors qu’un score en dessous de 50 indique un texte très complexe (académique ou juridique). Malheureusement, la plupart de ces indices sont calibrés pour l’anglais et leur interprétation pour le français s’en trouve souvent faussée.
Nous n’allons pas aller plus loin ici. Une étude approfondie de l’aide de cette de fonction et de ses sources est donc nécessaire pour utiliser judicieusement ces différents indices.
3 Collocations et Concordance
3.1 Collocations
Les collocations sont des suites de mots qui apparaissent ensemble plus souvent que le simple hasard ne le prédirait (p.ex.: “services publics” ou “développement durable”). Pour les extraire, on utilise textstat_collocations() sur l’objet corpus. L’argument size permet de définir le nombre de termes constituant ces collocations (bigrammes, trigrammes, etc.) :
colloc_df = textstat_collocations(corpus_obj, size=2)
as_tibble(colloc_df)
# A tibble: 6,885 × 6
collocation count count_nested length lambda z
<chr> <int> <int> <dbl> <dbl> <dbl>
1 de la 671 0 2 1.90 38.4
2 doit être 85 0 2 6.10 34.5
3 à la 269 0 2 2.09 28.5
4 la france 148 0 2 3.65 26.4
5 services publics 36 0 2 7.60 24.6
6 notre pays 37 0 2 5.08 23.9
7 créer un 53 0 2 4.74 23.9
8 tous les 100 0 2 4.35 23.1
9 dans les 123 0 2 2.39 22.3
10 service public 22 0 2 6.76 21.6
# ℹ 6,875 more rowsPar défaut, ces collocations sont classées selon le score z de l’indice lambda. Deux choses sont évaluées ici :
La force de l’association (le lambda) : Cet indice compare la fréquence de co-occurrence de deux mots par rapport à ce que prédirait le simple hasard. Par exemple, des termes comme “services” et “publics” s’attirent fortement, contrairement à des mots ultra-fréquents qui se croisent par hasard (comme “dans” et “le”).
La fiabilité du résultat (le score z) : Il mesure la significativité statistique de cette attraction. Il nous garantit que l’association observée est solide et ne relève pas d’un simple hasard lié à un échantillon de texte trop petit.
On peut également s’intéresser aux collocations de plus grand ordre :
colloc_df = textstat_collocations(corpus_obj, size=3)
as_tibble(colloc_df)
# A tibble: 3,518 × 6
collocation count count_nested length lambda z
<chr> <int> <int> <dbl> <dbl> <dbl>
1 pour en faire 5 0 3 6.84 4.92
2 plus en plus 9 0 3 9.97 4.56
3 a pas de 6 0 3 4.58 4.41
4 en la matière 4 0 3 8.95 4.20
5 de plus en 9 0 3 6.04 4.03
6 pas plus de 4 0 3 3.57 3.86
7 sur tout le 8 0 3 6.27 3.66
8 au pas la 2 0 3 6.00 3.60
9 à ne pas 2 0 3 7.71 3.51
10 est un des 2 0 3 5.92 3.49
# ℹ 3,508 more rows3.2 Concordances
Les concordances permettent d’observer les mots en contexte, c’est-à-dire de voir les mots qui apparaissent avant et après un mot de requête donné. Pour obtenir un concordancier, on utilise la fonction kwic() (Key Word In Context) sur notre objet tokens avec un mot de requête (ici "france"). Le résultat de cette fonction peut ensuite être transformé en tibble pour un affiche plus élégant :
requete = "france"
kwic_obj = kwic(tokens_obj, requete)
as_tibble(kwic_obj)
# A tibble: 257 × 7
docname from to pre keyword post pattern
<chr> <int> <int> <chr> <chr> <chr> <fct>
1 en_marche_2017.txt 14 14 de conquête pour bâtir … France nouv… france
2 en_marche_2017.txt 31 31 DE CONQUÊTE POUR BÂTIR … FRANCE NOUV… france
3 en_marche_2017.txt 200 200 sa place . Et la France a to… france
4 en_marche_2017.txt 1151 1151 morts par an rien qu’en France , de… france
5 en_marche_2017.txt 1455 1455 . · Nous placerons la France en t… france
6 en_marche_2017.txt 1512 1512 · Nous ferons de la France le l… france
7 en_marche_2017.txt 1668 1668 mêmes règles pour tous … France , la… france
8 en_marche_2017.txt 2596 2596 pour tous nos enfants La France a ét… france
9 en_marche_2017.txt 2645 2645 grâce à eux que la France fait… france
10 en_marche_2017.txt 3233 3233 . Car redonner à la France son … france
# ℹ 247 more rowsOn peut aussi utiliser des expressions régulières comme requêtes :
requete = "fran"
kwic_obj = kwic(tokens_obj, requete, valuetype="regex")
as_tibble(kwic_obj)
# A tibble: 473 × 7
docname from to pre keyword post pattern
<chr> <int> <int> <chr> <chr> <chr> <fct>
1 en_marche_2017.txt 14 14 de conquête pour bâtir … France nouv… fran
2 en_marche_2017.txt 31 31 DE CONQUÊTE POUR BÂTIR … FRANCE NOUV… fran
3 en_marche_2017.txt 200 200 sa place . Et la France a to… fran
4 en_marche_2017.txt 575 575 au Cœur des préoccupati… França… , c’… fran
5 en_marche_2017.txt 1151 1151 morts par an rien qu’en France , de… fran
6 en_marche_2017.txt 1455 1455 . · Nous placerons la France en t… fran
7 en_marche_2017.txt 1512 1512 · Nous ferons de la France le l… fran
8 en_marche_2017.txt 1668 1668 mêmes règles pour tous … France , la… fran
9 en_marche_2017.txt 2263 2263 la protection de tous l… França… , pa… fran
10 en_marche_2017.txt 2329 2329 · Au plus près des França… , el… fran
# ℹ 463 more rowsOu une “phrase” (voir l’aide ?phrase pour savoir comment les construire) :
requete = phrase("* social*")
kwic_obj =  kwic(tokens_obj, requete)
as_tibble(kwic_obj)
# A tibble: 192 × 7
docname from to pre keyword post pattern
<chr> <int> <int> <chr> <chr> <chr> <fct>
1 en_marche_2017.txt 129 130 est le moteur de la progre… . No… * soci…
2 en_marche_2017.txt 332 333 Nous rétablirons les ex… cotisa… sur … * soci…
3 en_marche_2017.txt 731 732 charges · et supprimero… Régime… des … * soci…
4 en_marche_2017.txt 812 813 à embaucher en baissant… cotisa… empl… * soci…
5 en_marche_2017.txt 911 912 . · Nous redéfinirons le dialog… . · … * soci…
6 en_marche_2017.txt 1973 1974 lutte contre la fraude … presta… sera… * soci…
7 en_marche_2017.txt 2143 2144 à toutes les formes de concur… délo… * soci…
8 en_marche_2017.txt 4229 4230 on part du bas de l’éche… , pl… * soci…
9 en_marche_2017.txt 4391 4392 . · Nous créerons un versem… uniq… * soci…
10 en_marche_2017.txt 4398 4399 unique . · Toutes les alloca… ( AP… * soci…
# ℹ 182 more rowsOn peut afficher comment notre requête se répartit dans les textes avec la fonction textplot_xray() du package quanteda.textplots :
textplot_xray(kwic_obj)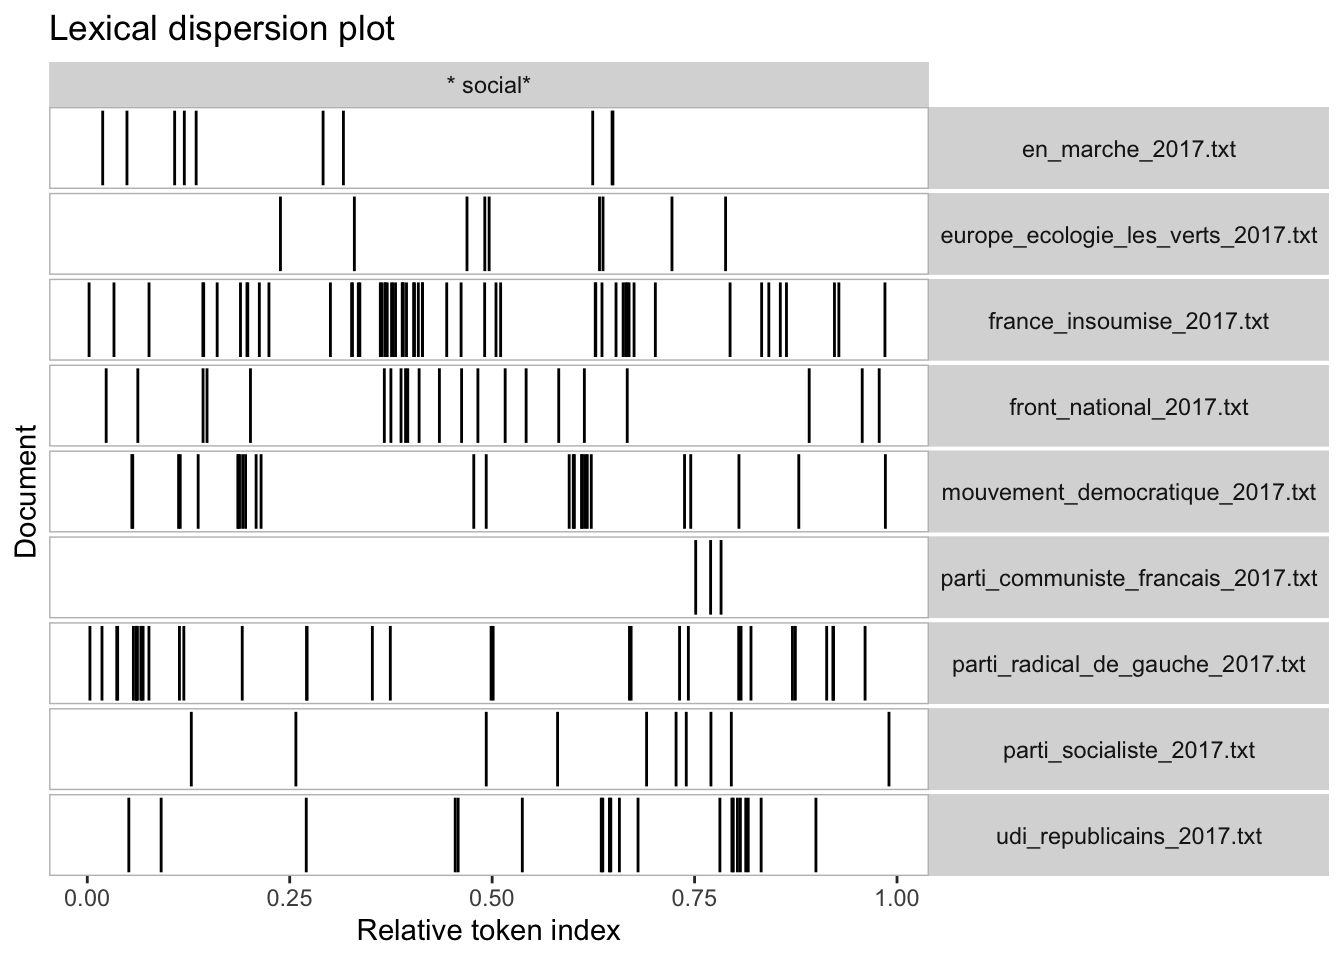
4 Matrice documents-termes et spécificités
4.1 Matrice documents-termes
Nous l’avons déjà vu : pour obtenir la matrice documents-termes, on utilise la fonction dfm() de quanteda (document-features matrix, les “features” étant généralement les termes) :
dfm_obj = dfm(tokens_obj)
dfm_obj
Document-feature matrix of: 9 documents, 8,865 features (77.91% sparse) and 0 docvars.
features
docs emmanuel macron président . “ retrouver
en_marche_2017.txt 1 1 3 349 1 2
europe_ecologie_les_verts_2017.txt 0 0 0 210 0 1
france_insoumise_2017.txt 0 2 6 519 0 2
front_national_2017.txt 0 0 0 243 0 2
mouvement_democratique_2017.txt 0 0 4 426 0 2
parti_communiste_francais_2017.txt 0 1 1 18 0 0
features
docs notre esprit de conquête
en_marche_2017.txt 45 2 351 2
europe_ecologie_les_verts_2017.txt 19 0 195 0
france_insoumise_2017.txt 34 3 1202 0
front_national_2017.txt 17 0 329 0
mouvement_democratique_2017.txt 25 0 566 0
parti_communiste_francais_2017.txt 1 0 27 0
[ reached max_ndoc ... 3 more documents, reached max_nfeat ... 8,855 more features ]Afin d’obtenir une matrice plus compacte et plus pertinente (pour les analyses ultérieurs) il peut être utile de nettoyer notre objet tokens au préalable.
On commence donc par recréer un objet de type tokens en supprimant la ponctuation, les nombres, etc. :
tokens_filtered_obj = tokens(corpus_obj, remove_punct=T, remove_symbols=T,
                             remove_numbers=T, remove_url=T,
                             remove_separators=T)
Nous allons également séparer les tokens par apostrophe (deux caractères présents dans le corpus):
tokens_filtered_obj = tokens_filtered_obj %>%
  tokens_split("'") %>%
  tokens_split("’")
Finalement, on supprime les stopwords avec le fichier “frenchST.txt” que nous avons téléchargé précédemment (voir la section “Préparation du corpus” du TP 1) :
stopwords = readLines("data/stopwords/frenchST.txt")
tokens_filtered_obj = tokens_filtered_obj %>%
  tokens_remove(stopwords)
On obtient alors :
dfm_obj = dfm(tokens_filtered_obj)
dfm_obj
Document-feature matrix of: 9 documents, 7,674 features (78.31% sparse) and 0 docvars.
features
docs emmanuel macron président retrouver esprit
en_marche_2017.txt 1 1 3 2 4
europe_ecologie_les_verts_2017.txt 0 0 0 1 0
france_insoumise_2017.txt 0 2 6 2 5
front_national_2017.txt 0 0 0 2 1
mouvement_democratique_2017.txt 0 0 4 2 1
parti_communiste_francais_2017.txt 0 1 1 0 0
features
docs conquête bâtir france nouvelle contrat
en_marche_2017.txt 2 2 21 5 2
europe_ecologie_les_verts_2017.txt 0 0 38 2 0
france_insoumise_2017.txt 0 1 64 17 7
front_national_2017.txt 0 1 36 1 3
mouvement_democratique_2017.txt 0 4 35 10 8
parti_communiste_francais_2017.txt 0 0 0 1 0
[ reached max_ndoc ... 3 more documents, reached max_nfeat ... 7,664 more features ]Cette matrice peut être utilisée plus tard pour des analyses avancées, par exemple pour faire une Analyse Factorielle des Correspondances (AFC). Elle est à la racine de toutes les méthodes de type Bag-of-Words (l’ordre des mots n’est pas pris en compte).
4.2 Spécificités
Les spécificités (en anglais: keyness) sont obtenues en comparant la fréquence des mots d’un document “cible” par rapport au reste du corpus. Elles permettent de répondre à la questions : “Quels mots caractérisent le mieux ce texte par rapport aux autres ?”. Elles s’obtiennent avec la fonction textplot_keyness() (de quanteda.textstats) appliquée à un objet de type dfm. On doit préciser dans l’argument target quel document observer en contraste avec le reste du corpus. On peut désigner ce document avec un indice :
keyness_obj = textstat_keyness(dfm_obj, target=3) # n°3 -> "france_insoumise_2017.txt"
as_tibble(keyness_obj)
# A tibble: 7,674 × 5
feature chi2 p n_target n_reference
<chr> <dbl> <dbl> <dbl> <dbl>
1 proposons 155. 0 82 4
2 réaliser 155. 0 80 3
3 suivantes 147. 0 78 4
4 mesures 82.3 0 85 34
5 écologique 54.2 1.83e-13 44 12
6 onu 43.6 4.06e-11 21 0
7 refuser 28.9 7.46e- 8 23 6
8 humaine 21.9 2.85e- 6 12 0
9 paix 20.5 5.82e- 6 16 4
10 impót 19.9 8.37e- 6 11 0
# ℹ 7,664 more rowsOu avec son nom :
keyness_obj = textstat_keyness(dfm_obj, target="front_national_2017.txt")
as_tibble(keyness_obj)
# A tibble: 7,674 × 5
feature chi2 p n_target n_reference
<chr> <dbl> <dbl> <dbl> <dbl>
1 français 53.1 3.24e-13 32 80
2 rétablir 47.6 5.32e-12 12 11
3 revaloriser 31.0 2.56e- 8 8 7
4 nationalité 26.0 3.39e- 7 6 4
5 française 23.3 1.35e- 6 13 28
6 expulsion 20.4 6.42e- 6 3 0
7 majoration 20.4 6.42e- 6 3 0
8 startups 20.4 6.42e- 6 3 0
9 immigration 20.0 7.64e- 6 6 6
10 maintenir 17.9 2.34e- 5 7 10
# ℹ 7,664 more rowsNotez que l’on peut afficher ce résultat sous la forme d’un graphique, ce qui montre aussi les mots les “moins caractéristiques” du corpus (les mots sous-représentés par rapport à la référence, i.e. le bas des tableaux précédents) :
textplot_keyness(keyness_obj)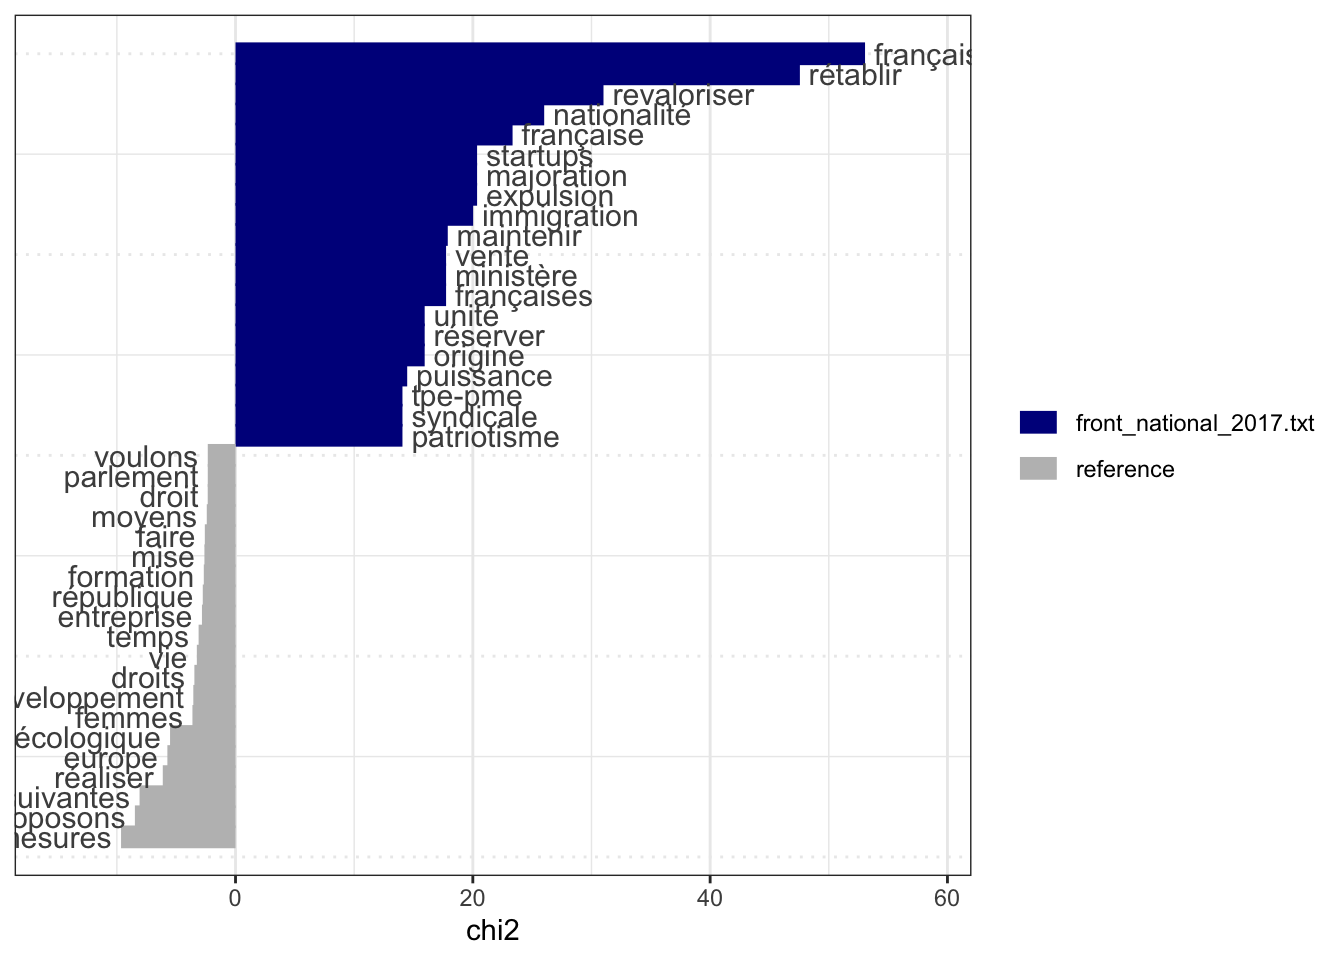
4.3 Nuage de mots
Pour terminer, on peut faire un nuage de mots à partir de notre objet de type “dfm” avec la fonction textplot_wordcloud() du package quanteda.textplots. Ce n’est pas le graphique le plus adapté à une analyse rigoureuse, mais il possède un certain intérêt esthétique :
textplot_wordcloud(dfm_obj, max_words=100)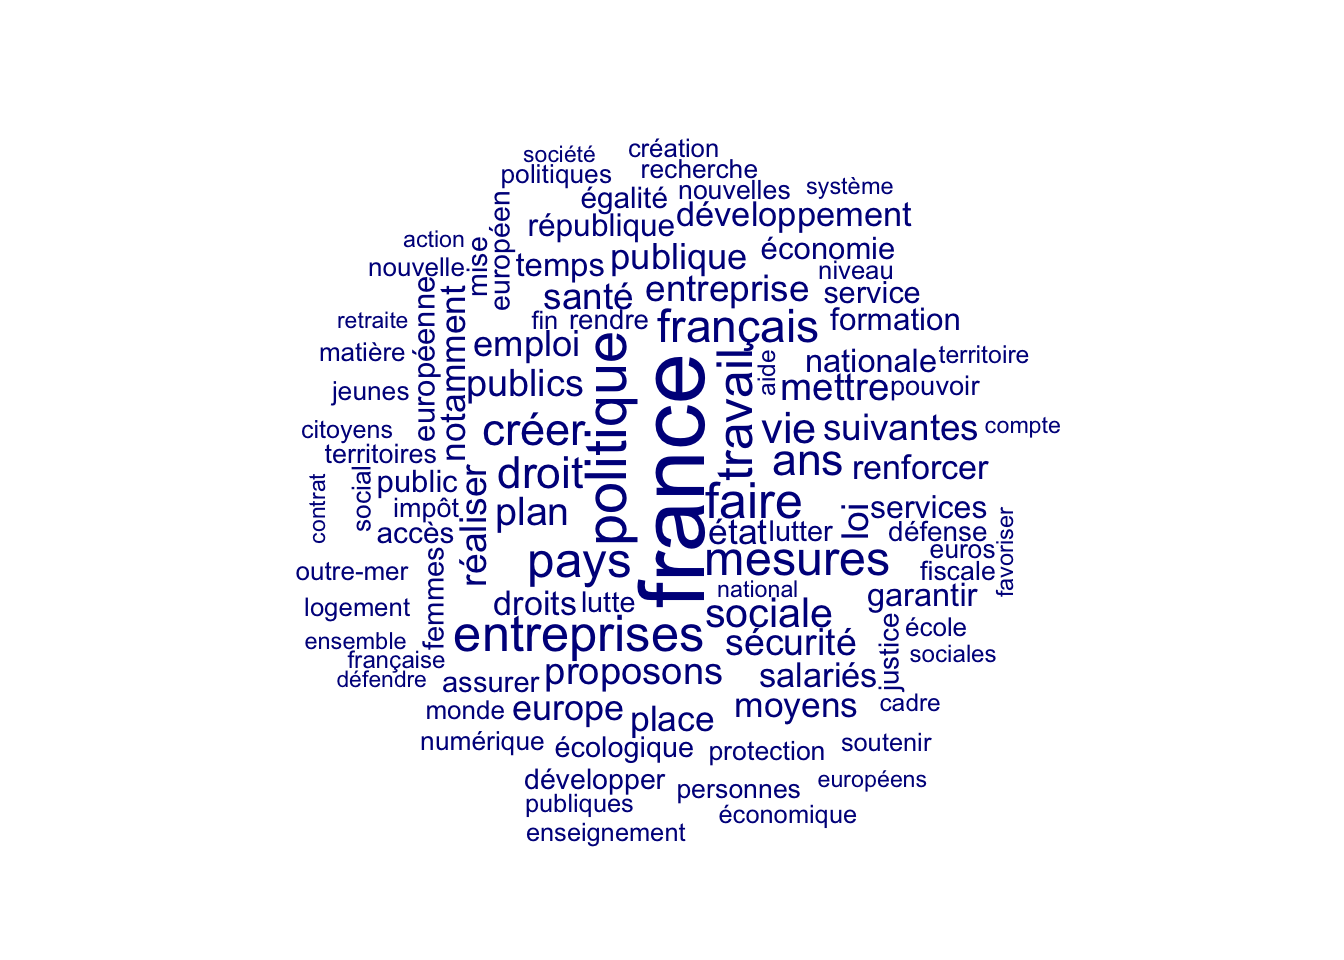
On peut utiliser dfm_subset() pour selectionner un sous-ensemble de document (selon plusieurs conditions logiques) :
# On affiche le nuage de mots de "en_marche_2017.txt"
textplot_wordcloud(dfm_subset(dfm_obj, docname_=="en_marche_2017.txt"), max_words=100)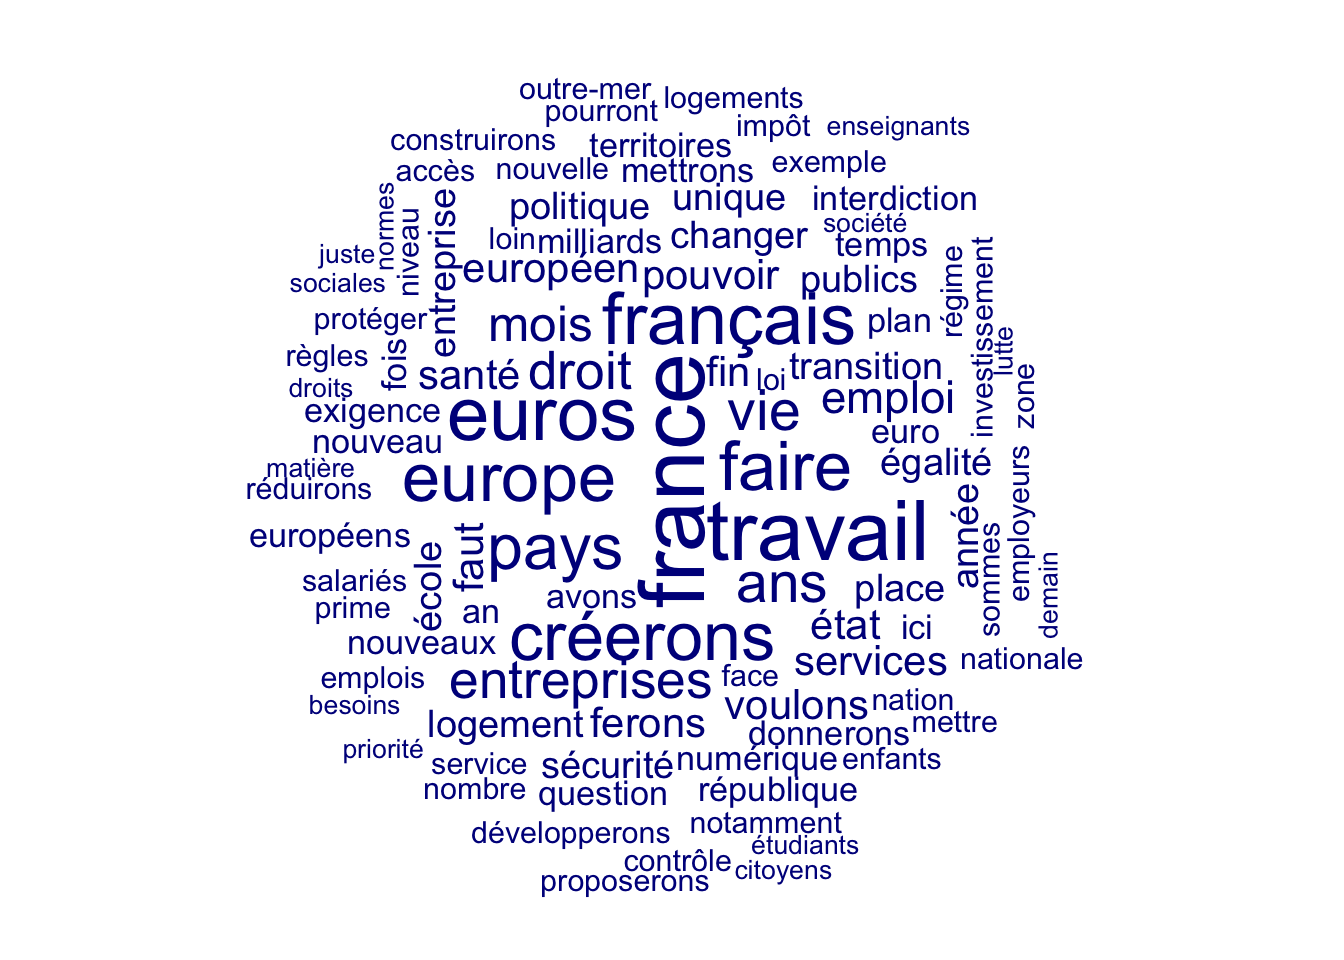
5 Co-occurrences
La table des co-occurrences permet de voir quels mots apparaissent le plus fréquemment ensembles dans un contexte donné. Elle se construit à partir d’un objet de type tokens, avec la fonction fcm() (feature co-occurrence matrix). Notez que, de base, fcm() distingue la casse, c’est pourquoi nous passons notre objet tokens dans tokens_tolower(), afin d’enlever toutes les lettres majuscules :
tokens_low_obj = tokens_tolower(tokens_filtered_obj)
fcm_obj = fcm(tokens_low_obj)
fcm_obj
Feature co-occurrence matrix of: 7,674 by 7,674 features.
features
features emmanuel macron président retrouver esprit conquête bâtir france
emmanuel 1 5 7 4 8 2 2 91
macron 0 2 20 8 18 2 4 219
président 0 0 40 28 50 18 28 783
retrouver 0 0 0 4 24 4 16 385
esprit 0 0 0 0 17 8 18 545
conquête 0 0 0 0 0 2 4 84
bâtir 0 0 0 0 0 0 7 282
france 0 0 0 0 0 0 0 4980
nouvelle 0 0 0 0 0 0 0 0
contrat 0 0 0 0 0 0 0 0
features
features nouvelle contrat
emmanuel 17 32
macron 52 46
président 200 116
retrouver 74 55
esprit 128 84
conquête 20 6
bâtir 68 46
france 1970 1431
nouvelle 217 307
contrat 0 158
[ reached max_nfeat ... 7,664 more features, reached max_nfeat ... 7,664 more features ]Par défaut, fcm() compte le nombre de paires de tokens (distinctes) selon le contexte “document”. Si l’on désire compter le nombre de contextes possédant une ou plusieurs co-occurrences, on doit faire :
fcm_obj = fcm(tokens_low_obj, count="boolean")
fcm_obj
Feature co-occurrence matrix of: 7,674 by 7,674 features.
features
features emmanuel macron président retrouver esprit conquête bâtir france
emmanuel 1 2 2 2 2 1 1 2
macron 0 2 4 3 3 1 2 3
président 0 0 5 4 4 2 3 5
retrouver 0 0 0 4 5 1 4 6
esprit 0 0 0 0 3 1 4 5
conquête 0 0 0 0 0 2 1 2
bâtir 0 0 0 0 0 0 2 4
france 0 0 0 0 0 0 0 8
nouvelle 0 0 0 0 0 0 0 0
contrat 0 0 0 0 0 0 0 0
features
features nouvelle contrat
emmanuel 2 2
macron 4 3
président 6 5
retrouver 6 5
esprit 5 5
conquête 2 2
bâtir 4 4
france 7 7
nouvelle 6 6
contrat 0 5
[ reached max_nfeat ... 7,664 more features, reached max_nfeat ... 7,664 more features ]Ce qui veut dire, qu’avec 9 documents, les composantes ne peuvent dépasser 9.
On peut également une fenêtre d’un certain nombre de mots comme contexte :
fcm_obj = fcm(tokens_low_obj, context="window", window=5)
fcm_obj
Feature co-occurrence matrix of: 7,674 by 7,674 features.
features
features emmanuel macron président retrouver esprit conquête bâtir france
emmanuel 0 3 1 1 1 1 0 0
macron 0 0 2 1 1 1 1 0
président 0 0 0 1 1 1 1 2
retrouver 0 0 0 0 2 2 3 4
esprit 0 0 0 0 0 2 2 4
conquête 0 0 0 0 0 0 2 2
bâtir 0 0 0 0 0 0 0 3
france 0 0 0 0 0 0 0 64
nouvelle 0 0 0 0 0 0 0 0
contrat 0 0 0 0 0 0 0 0
features
features nouvelle contrat
emmanuel 0 0
macron 0 0
président 3 0
retrouver 3 1
esprit 4 2
conquête 3 2
bâtir 3 2
france 14 8
nouvelle 2 3
contrat 0 12
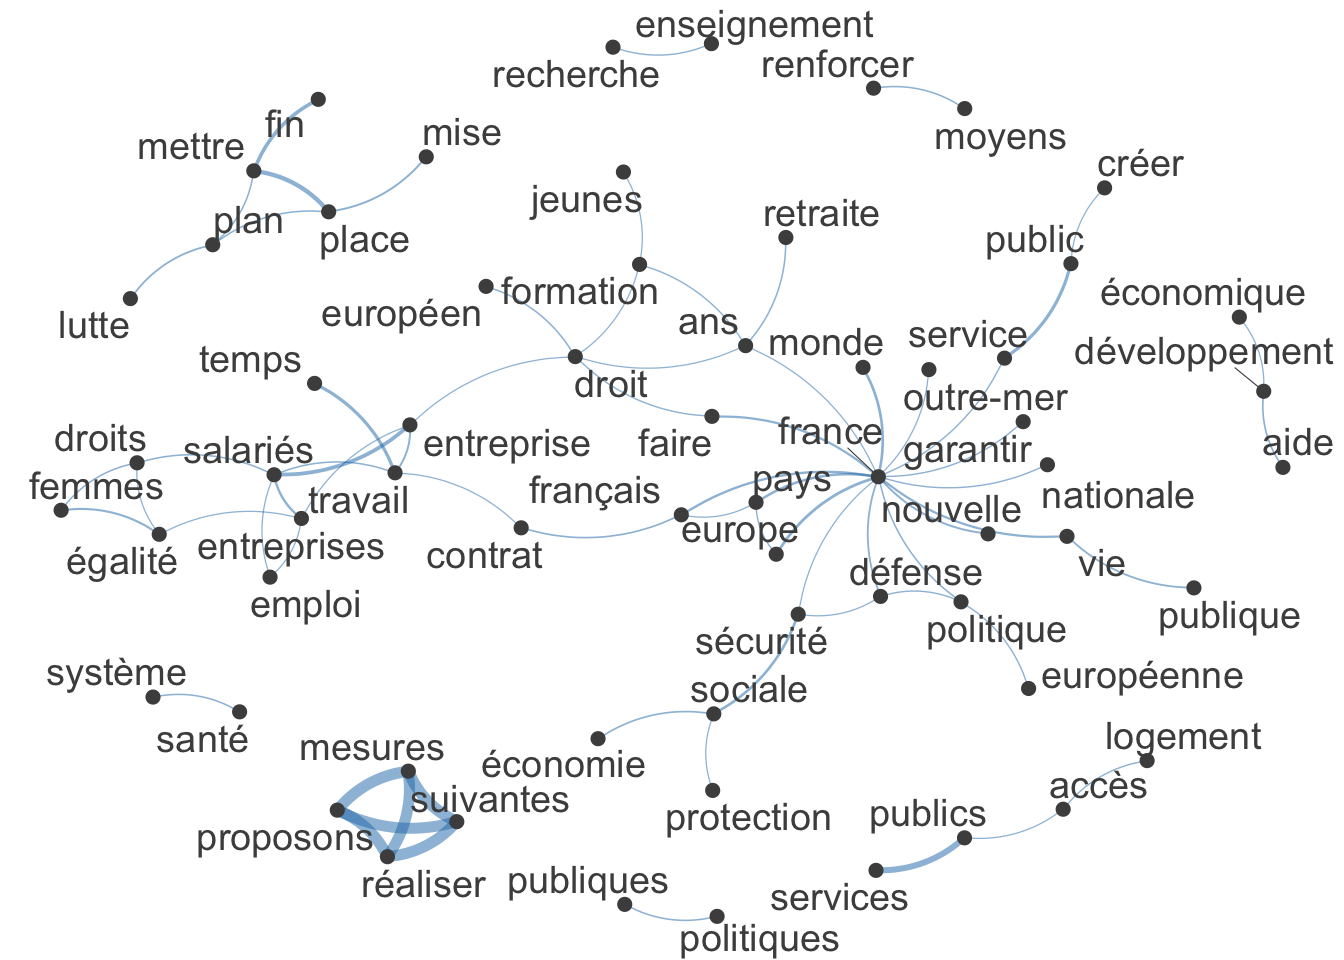
[ reached max_nfeat ... 7,664 more features, reached max_nfeat ... 7,664 more features ]Il nous est ensuite possible d’afficher ces co-occurrences avec un graphe, grâce à la fonction textplot_network().
Cette fonction affiche au maximum 1000 noeuds, et même avec ce nombre, le graphe n’est pas très lisible. Nous allons donc d’abord sélectionner les 100 tokens les plus fréquents :
tokens_names = tokens_low_obj %>%
  dfm() %>%
  topfeatures(n=100) %>%
  names()
tokens_names
[1] "france" "politique" "entreprises" "faire"
[5] "travail" "pays" "mesures" "français"
[9] "créer" "ans" "droit" "vie"
[13] "sociale" "plan" "mettre" "proposons"
[17] "publics" "sécurité" "loi" "réaliser"
[21] "entreprise" "santé" "suivantes" "emploi"
[25] "publique" "europe" "place" "notamment"
[29] "état" "moyens" "salariés" "développement"
[33] "droits" "renforcer" "temps" "nationale"
[37] "garantir" "services" "république" "formation"
[41] "européenne" "économie" "public" "service"
[45] "égalité" "accès" "femmes" "assurer"
[49] "écologique" "lutte" "lutter" "européen"
[53] "mise" "développer" "défense" "justice"
[57] "rendre" "pouvoir" "impôt" "territoires"
[61] "nouvelles" "personnes" "protection" "fiscale"
[65] "numérique" "euros" "recherche" "jeunes"
[69] "social" "politiques" "nouvelle" "monde"
[73] "école" "matière" "outre-mer" "niveau"
[77] "logement" "création" "publiques" "fin"
[81] "enseignement" "économique" "soutenir" "citoyens"
[85] "territoire" "cadre" "aide" "sociales"
[89] "française" "système" "ensemble" "favoriser"
[93] "national" "action" "européens" "compte"
[97] "contrat" "emplois" "société" "retraite" On crée un nouvel objet fcm qui ne contient que ces tokens :
fcm_filtered_obj = fcm_select(fcm_obj, tokens_names)Et on fait un graphe, avec les liens qui s’affichent seulement si le compte est de minimum 9 (seuil trouvé après tâtonnements) :
textplot_network(fcm_filtered_obj, min_freq=9)