Dans ce TP, nous allons voir comment tokeniser, lemmatiser et annoter automatiquement un corpus grâce à la librairie udpipe (https://bnosac.github.io/udpipe/en/index.html). Cette dernière utilise des modèles de langage, construits dans le cadre du projet Universal Dependencies (https://universaldependencies.org/), afin d’effectuer automatiquement toutes ces opérations. Nous allons également voir succinctement comment gérer le format XML avec R.
Il est important de préciser que les “modèles de langage” utilisés par udpipe diffèrent fondamentalement des grands modèles actuels basés sur l’architecture Transformer (comme GPT, Claude ou Qwen). udpipe repose sur des algorithmes d’apprentissage automatique plus légers et traditionnels. Si cette approche peut sembler datée face à l’état de l’art actuel en intelligence artificielle, elle n’en demeure pas moins un standard incontournable pour l’analyse syntaxique. Elle présente en effet des avantages majeurs pour ce type de traitement : une grande rapidité d’exécution, la possibilité de fonctionner localement sur une machine standard sans équipement spécifique (GPU), et une excellente transparence dans les règles grammaticales appliquées.
Nous aurons besoin des librairies suivantes :
library(tidyverse)
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
library(readtext)library(quanteda)
Package version: 4.4
Unicode version: 14.0
ICU version: 71.1
Parallel computing: disabled
See https://quanteda.io for tutorials and examples.

Attachement du package : 'quanteda'

L'objet suivant est masqué depuis 'package:readtext':

    texts
library(udpipe)library(xml2)library(xmlconvert)
1.1 Le corpus
Le chargement du corpus dans R est fait, comme la fois précédente, à l’aide de la fonction readtext() du package readtext :
texts_df =readtext("data/manifesto/*.txt")
On vérifie que le chargement s’est bien déroulé :
texts_df
readtext object consisting of 9 documents and 0 docvars.
# A data frame: 9 × 2
  doc_id                             text
  <chr>                              <chr>
1 en_marche_2017.txt                 "\"Emmanuel M\"..."
2 europe_ecologie_les_verts_2017.txt "\"Il y a urg\"..."
3 france_insoumise_2017.txt          "\"L'AVENIR E\"..."
4 front_national_2017.txt            "\"Au nom du \"..."
5 mouvement_democratique_2017.txt    "\"La France \"..."
6 parti_communiste_francais_2017.txt "\"Le peuple \"..."
# ℹ 3 more rows
Pour rappel, ce format de chargement (en dataframe) nous permet de créer les objets corpus et tokens de quanteda. Ici, nous les utiliserons d’une autre manière avec udpipe.
2 Annotation du corpus et statistiques
2.1 Annotation
Pour utiliser udpipe, on doit d’abord télécharger un modèle de langage pré-entraîné spécifique à la langue que l’on étudie. Ces modèles ont été entraînés sur les corpus du projet Universal Dependencies (dont la liste complète est consultable ici : https://universaldependencies.org/). Dans R, le téléchargement du modèle se fait directement via une fonction dédiée du package, udpipe_download_model() (commande à décommenter pour télécharger le modèle lors de la première utilisation) :
Pour effectuer la tokenisation, la lemmatisation et l’annotation du corpus, on utilise la fonction udpipe_annotate(). On doit donner les textes à annoter dans l’argument x de la fonction, et les noms des textes dans l’argument doc_id (l’option trace=T permet d’afficher une barre de progression) :
2026-10-06 16:17:17.26369 Annotating text fragment 1/9
2026-10-06 16:17:19.498695 Annotating text fragment 2/9
2026-10-06 16:17:20.743451 Annotating text fragment 3/9
2026-10-06 16:17:30.14129 Annotating text fragment 4/9
2026-10-06 16:17:32.279878 Annotating text fragment 5/9
2026-10-06 16:17:35.855047 Annotating text fragment 6/9
2026-10-06 16:17:36.05138 Annotating text fragment 7/9
2026-10-06 16:17:41.201162 Annotating text fragment 8/9
2026-10-06 16:17:41.76756 Annotating text fragment 9/9
Note
Cette fonction peut parfois prendre beaucoup de temps. Pour en gagner, il est possible de désactiver le parsing, avec l’option parser="none".
On peut obtenir le résultat sous la forme de tibble avec as_tibble() et as.data.frame() :
Si vous observez corpus_token_df, vous verrez que chaque ligne correspond désormais à un seul mot (ou ponctuation). Les colonnes les plus importantes pour nos futures analyses sont :
token : Le mot exact tel qu’il apparaît dans le texte original (ex: “chevaux”, “allons”).
lemma : Le mot ramené à sa forme canonique. “chevaux” devient “cheval”, “allons” devient “aller”. C’est indispensable pour compter la fréquence réelle d’un concept et cela nous sera très utile pour faire des analyses de type bag-of-words.
upos (Universal Part of Speech) : La classe grammaticale universelle du mot. Par exemple : NOUN (Nom), ADJ (Adjectif), VERB (Verbe), PUNCT (Ponctuation).
2.3 Nombre d’annotations, de tokens, de types et de lemmes
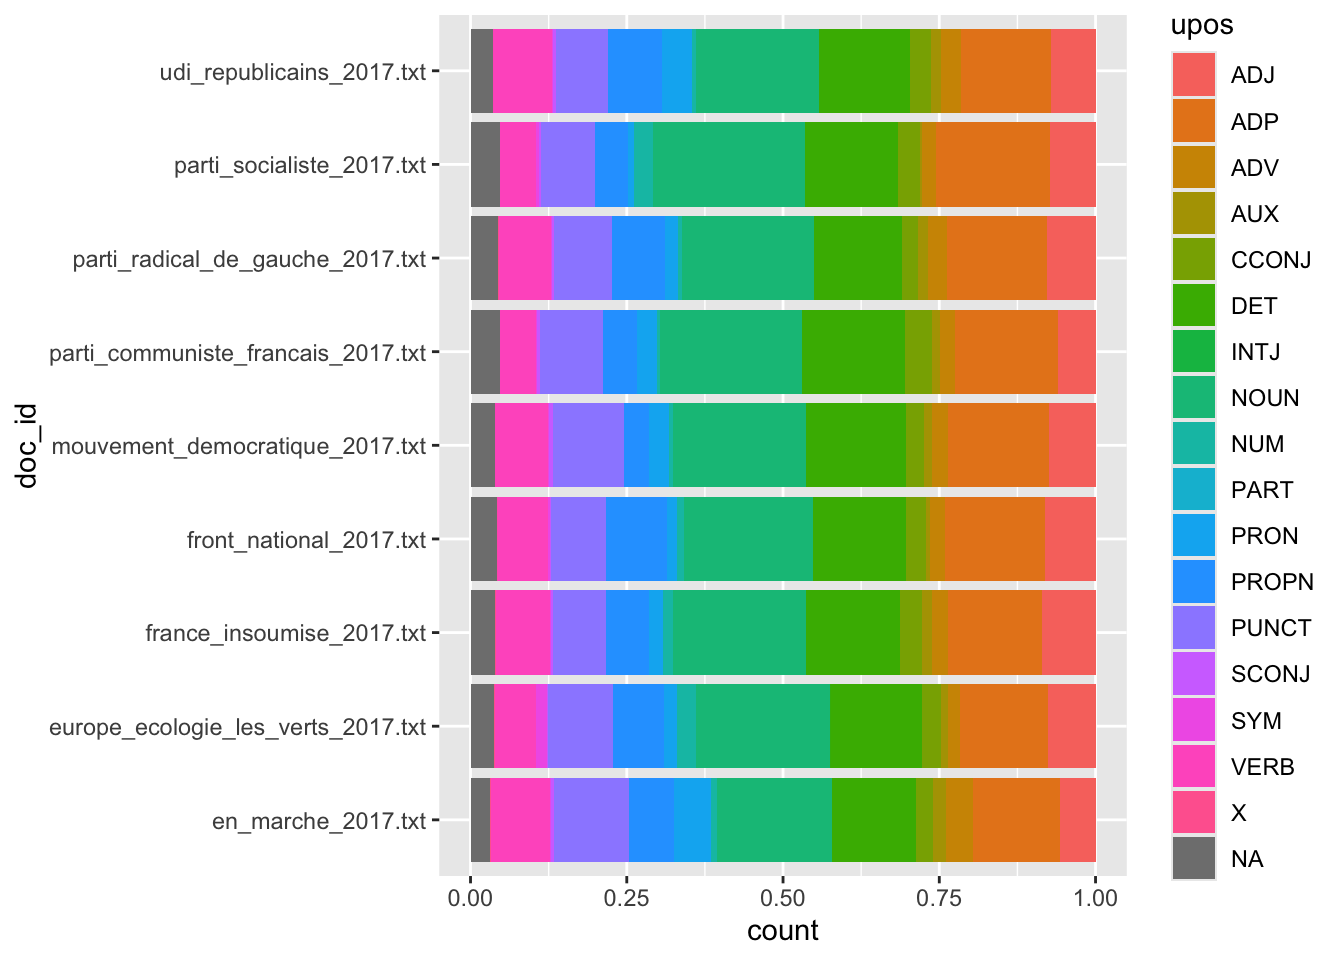
Ce jeu de données peut être utilisé pour extraire des statistiques, par exemple, le nombre et la proportion des annotations morpho-syntaxiques par document :
Pour obtenir des résultats similaires (sans le nombre de types), on peut aussi recréer un vecteur de documents lemmatisés pour ensuite utiliser quanteda.
On recolle les lemmes par document, puis on extrait la colonne dans un vecteur :
Le format XML (https://fr.wikipedia.org/wiki/Extensible_Markup_Language) est très utilisé pour sauvegarder des documents annotés. Avec certaines librairies R, en particulier xml2 et xmlconvert, il est possible d’extraire des informations d’un document XML, ou alors de sauvegarder un tableau de données en XML. Cette tâche n’est cependant pas facile à automatiser, car chaque document XML possède sa propre hiérarchie et ses balises personnalisées.
Pour charger un document XML en R, on utilise la fonction xml_to_df() du package xmlconvert (voir l’aide pour toutes les options). Ici, nous chargeons un document trouvé sur https://www.frantext.fr/ (cette logique devrait donc fonctionner pour tous les documents trouvés sur ce site) :
# A tibble: 3,275 × 3
   word      pos   lemma
   <chr>     <chr> <chr>
 1 I         X     I
 2 Le        DET   le
 3 système   NC    système
 4 de        P     de
 5 la        DET   le
 6 grammaire NC    grammaire
 7 On        NP    On
 8 a         V     avoir
 9 travaillé VPP   travailler
10 de        P     de
# ℹ 3,265 more rows
Il est possible de capturer une plus grande part de la structure de ce document (récupérer les chapitres, paragraphes, phrases, etc.) mais cette procédure peut être complexe et nous ne la verrons pas ici.
Si nécessaire, le texte brut peut être récupéré avec :
# La fonction suivante va malheurseuement ajouter des espaces avant la ponctuationfrantext_texte =str_c(frantext_df$word, collapse=" ")str_sub(frantext_texte, 1, 100)
[1] "I Le système de la grammaire On a travaillé de manière bien différente en grammaire ( = théorie de l"
et peut ensuite être tokenisé, lemmatisé, annoté avec, p.ex., udpipe.
3.2 Sauvegarde
Le processus de sauvegarde est également assez spécifique au jeu de données que nous possédons et de la structure que nous désirons créer dans le document XML. Il s’agira de créer un arbre hiérarchique, avec comme “feuilles” les lignes de notre jeu de données. La création de cette hiérarchie est faite avec les fonctions disponibles dans les packages xml2 et xmlconvert :
xml_new_root(): permet de créer un noeud vide.
xml_add_child(): permet de coller un noeud enfant à un noeud parent.
df_to_xml(): permet de convertir un jeu de données et sous-arbre XML
(chaque ligne est un noeud, qui possède autant d’enfants que de variables).
Nous allons ici sauvegarder le document “parti_socialiste_2017.txt”, annoté en format XML, en gardant la hiérarchie des phrases.
On crée le noeud <document> pour notre document :
doc_xml =xml_new_root("document")
On ajoute le nom du document dans un noeud <nom>, que l’on met comme enfant de <document> :
On extrait les identifiants des phrases du document :
sent_ids =unique(doc_df$sentence_id)
On boucle sur les identifiants des phrases :
for(sent_id in sent_ids){# On restreint le jeu de données à la phrase, on sélectionne les colonnes# pertinentes, puis on transforme ce sous-tableau en arbre XML : sent_xml = doc_df %>%filter(sentence_id==sent_id) %>%select(token, lemma, upos) %>%df_to_xml(root.node="sentence", record.tag="word")# On supprime l'attribut "encoding" du noeud `<sentence>` (automatique avec# `df_to_xml()`)xml_set_attr(sent_xml, "encoding", NULL)# On ajoute le sous-arbre `<sentence>` au noeud <document> doc_xml %>%xml_add_child(sent_xml)}