VI. Traitement des données textuelles

Auteur·rice

Guillaume Guex

1 Les données textuelles

Dans ce TP, premier du deuxième module, nous allons commencer à voir comment R est capable de traiter des données textuelles. De nombreuses librairies aident dans cette tâche. Quelques exemples :

  • stringr : librairie permettant la manipulation des chaînes de caractères et faisant partie du tidyverse.
  • tidytext : manipulation et gestion des données textuelles, possède une logique similaire au tidyverse.
  • tm : la plus vieille librairie R pour le text mining. Permet de faire de nombreuses opérations de base, mais est limité pour les méthodes plus avancées.
  • quanteda : librairie très complète possédant de nombreuses méthodes d’analyse avancées.
  • udpipe : bonne librairie pour l’annotation des données textuelles.

Une des principales difficultés pour analyser des données textuelles (que l’on trouve également avec d’autres langages de programmation, comme Python) est que ces différentes librairies n’offrent pas les mêmes fonctionnalités, et ne suivent pas toujours le même paradigme dans la structuration des données. Savoir passer d’une librairie à l’autre est souvent utile si on varie les analyses, mais nécessite une certaine maîtrise dans la manipulation des données.

Ici nous allons utiliser uniquement :

library(tidyverse) # Contient `stringr` qui permet de manipuler les chaînes de caractères.
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2     
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
library(readtext) # Pour charger les données textuelles, compagnon de `quanteda`.
library(quanteda) # Pour une manipulation "de plus haut niveau" des données textuelles.
Package version: 4.4
Unicode version: 14.0
ICU version: 71.1
Parallel computing: disabled
See https://quanteda.io for tutorials and examples.

Attachement du package : 'quanteda'

L'objet suivant est masqué depuis 'package:readtext':

    texts
library(quanteda.textstats) # Pour des statisiques plus poussées sur des données textuelles.

L’autre difficulté vient du fait que les données textuelles viennent dans toutes sortes de format, ne suivent pas une structure rigoureuse, et sont parfois “sales”. Elles nécessitent fréquemment de nombreux pré-traitements.

Ici, nous allons nous concentrer sur les données textuelles en format .txt, et nous sauterons l’étape préliminaire qui consiste parfois à transformer un autre type de document (p.ex. CSV ou PDF) dans ce format.

De nombreux sites offrent des données textuelles :

Il est bien sûr aussi possible de constituer son propre corpus à l’aide des ressources textuelles disponibles sur internet. On peut par exemple utiliser des scripts R pour procéder à du Web Scraping, comme donné dans l’exemple annexe_2_webscraping_example.R.

2 Manipulation des chaînes de caractères

Dans cette partie, nous allons montrer comment utiliser stringr pour manipuler les chaînes de caractères. Plusieurs des opérations que nous allons voir sont généralement prises en charge par des librairies de plus haut niveau, mais il peut être utile de savoir le faire “manuellement”. Comme la pluparts des packages contenus dans le tidyverse, il existe une feuille de triche pour stringr https://stringr.tidyverse.org/.

2.1 Chargement d’un fichier texte

Commençons avec un exemple simple : le fichier Autour de la Lune.txt du corpus verne, composé de 4 textes issus du Projet Gutenberg (https://www.gutenberg.org/) quelque peu nettoyés manuellement. On commence par définir le chemin d’accès, puis on charge le fichier avec la fonction read_file() (du package du tidyverse readr) :

file_path = "data/verne/Autour de la Lune.txt"
text = read_file(file_path)

On peut afficher les 300 premiers caractères grâce à la fonction str_sub() de stringr :

text %>% 
  str_sub(1, 300)
[1] "AUTOUR DE LA LUNE\npar Jules Verne\nCHAPITRE PRÉLIMINAIRE\nQui résume la première partie de cet ouvrage, pour servir de préface a\nla seconde\nPendant le cours de l'année 186., le monde entier fut singulièrement\nému par une tentative scientifique sans précédents dans les annales de\nla science. Les membre"

Le résultat est une (grande) chaîne de caractères qui contient tout le fichier texte, avec les retours à la lignes indiqué par le caractère \n. Généralement, nous aimerions segmenter ce corpus en différentes unités, selon l’analyse voulue.

2.2 Segmentation

La segmentation d’un texte consiste à le découper en unités plus petites (chapitres, phrases, mots) afin de définir ce qu’on appelle des contextes ou unités d’analyse textuelle (qui deviendront souvent les lignes de notre futur tableau de données). Le choix de la segmentation définit donc la granularité de l’analyse : souhaite-on se focaliser sur des textes entiers, des chapitres, des phrases, des mots, voire des lettres ?

Nous allons voir rapidement comment effectuer ces segmentations avec stringr. Notez que par la suite, nous privilégierons des librairies spécialisées comme quanteda pour ces tâches.

La segmentation dans stringr s’effectue principalement avec la fonction str_split(), qui peut s’utiliser de différentes manières. En premier lieu, elle fonctionne très bien avec la fonction boundary(), qui permet un découpage “intelligent” par caractères, mots, lignes ou phrases en gérant automatiquement la ponctuation.

Par exemple pour faire un découpage en mots :

words = str_split(text, boundary("word"))[[1]]
head(words, 20)
 [1] "AUTOUR"       "DE"           "LA"           "LUNE"         "par"         
 [6] "Jules"        "Verne"        "CHAPITRE"     "PRÉLIMINAIRE" "Qui"         
[11] "résume"       "la"           "première"     "partie"       "de"          
[16] "cet"          "ouvrage"      "pour"         "servir"       "de"          

Notez que str_split() retourne toujours une liste, même si nous n’avons fourni qu’un seul texte en entrée. C’est pour cela que nous utilisons [[1]] : cela permet d’accéder au contenu du premier (et unique) élément de cette liste, qui est notre vecteur de mots.

Pour un découpage en phrases, on prendra soin d’enlever les retours à la ligne au préalable avec str_replace_all() :

sentences = text %>%
  str_replace_all("\n", " ") %>%
  str_split(boundary("sentence")) %>%
  unlist() # Permet de transformer une liste en un vecteur, alternative à .[[1]]
head(sentences)
[1] "AUTOUR DE LA LUNE par Jules Verne CHAPITRE PRÉLIMINAIRE Qui résume la première partie de cet ouvrage, pour servir de préface a la seconde Pendant le cours de l'année 186., le monde entier fut singulièrement ému par une tentative scientifique sans précédents dans les annales de la science. "
[2] "Les membres du Gun-Club, cercle d'artilleurs fondé à Baltimore après la guerre d'Amérique, avaient eu l'idée de se mettre en communication avec la Lune--oui, avec la Lune--, en lui envoyant un boulet. "                                                                                         
[3] "Leur président Barbicane, le promoteur de l'entreprise, ayant consulté à ce sujet les astronomes de l'Observatoire de Cambridge, prit toutes les mesures nécessaires au succès de cette extraordinaire entreprise, déclarée réalisable par la majorité des gens compétents. "                      
[4] "Après avoir provoqué une souscription psublique qui produisit près de trente millions de francs, il commença ses gigantesques travaux. "                                                                                                                                                           
[5] "Suivant la note rédigée par les membres de l'Observatoire, le canon destiné à lancer le projectile devait être établi dans un pays situé entre 0 et 28 degrés de latitude nord ou sud, afin de viser la Lune au zénith. "                                                                          
[6] "Le boulet devait être animé d'une vitesse initiale de douze mille yards à la seconde. "                                                                                                                                                                                                            

Finalement, la manière la plus souple et puissante de segmenter est d’utiliser une expression régulière (pour une référence rapide sur les expressions régulières, voir https://cheatography.com/davechild/cheat-sheets/regular-expressions/).

Cette méthode permet notamment de scinder un corpus contenu dans un seul fichier en plusieurs sous-fichiers distincts. C’est ce que nous allons faire dans la prochaine section avec le document Autour de la Lune.txt afin de séparer les chapitres.

2.3 Segmentation et sauvegarde de plusieurs fichiers

Dans, Autour de la Lune.txt, chaque chapitre est délimité par un nombre romain isolé sur une ligne. On va donc définir l’expression régulière qui capture ces lignes ((?=<expr>) permet de couper juste avant l’expression régulière) :

chapter_split_regex = "(?=(\n(I|V|X)+\n))"

Comme mentionné précédemment, str_split() retourne une liste. Nous extrayons directement notre vecteur de chapitres avec [[1]] :

chapters = str_split(text, chapter_split_regex)[[1]]
length(chapters)
[1] 24

Sachant qu’il y a 23 chapitres plus un chapitre préliminaire, notre découpage (24 éléments) a parfaitement fonctionné.

Avant de sauvegarder nos chapitres, nous allons éliminer les retours à la ligne qu’ils contiennent. Comme on peut le voir, il y a de nombreux \n :

chapters[1] %>%
  str_sub(1, 300)
[1] "AUTOUR DE LA LUNE\npar Jules Verne\nCHAPITRE PRÉLIMINAIRE\nQui résume la première partie de cet ouvrage, pour servir de préface a\nla seconde\nPendant le cours de l'année 186., le monde entier fut singulièrement\nému par une tentative scientifique sans précédents dans les annales de\nla science. Les membre"

On remplace tous les “espaces” (espaces, retours à la ligne, tabulations) superflus de tous les chapitres :

chapters = str_squish(chapters)

On observe le résultat :

chapters[1] %>%
  str_sub(1, 300)
[1] "AUTOUR DE LA LUNE par Jules Verne CHAPITRE PRÉLIMINAIRE Qui résume la première partie de cet ouvrage, pour servir de préface a la seconde Pendant le cours de l'année 186., le monde entier fut singulièrement ému par une tentative scientifique sans précédents dans les annales de la science. Les membre"

On va maintenant construire un vecteur contenant les noms de ces chapitres avec la même expression régulière en utilisant str_match_all(). Contrairement à une simple extraction, cette fonction renvoie un tableau séparant plusieurs éléments de la capture (voir l’aide pour plus de détails). L’indexation [[1]][, 2] nous permet d’isoler directement la deuxième colonne, qui contient exactement nos chiffres romains :

chapter_names = str_match_all(text, chapter_split_regex)[[1]][, 2]
chapter_names
 [1] "\nI\n"     "\nII\n"    "\nIII\n"   "\nIV\n"    "\nV\n"     "\nVI\n"   
 [7] "\nVII\n"   "\nVIII\n"  "\nIX\n"    "\nX\n"     "\nXI\n"    "\nXII\n"  
[13] "\nXIII\n"  "\nXIV\n"   "\nXV\n"    "\nXVI\n"   "\nXVII\n"  "\nXVIII\n"
[19] "\nXIX\n"   "\nXX\n"    "\nXXI\n"   "\nXXII\n"  "\nXXIII\n"

La fonction str_trim() nous permet d’éliminer les espaces, tabulations et retours à la ligne superflus au début et à la fin des chaînes de caractères :

chapter_names = str_trim(chapter_names)
chapter_names
 [1] "I"     "II"    "III"   "IV"    "V"     "VI"    "VII"   "VIII"  "IX"   
[10] "X"     "XI"    "XII"   "XIII"  "XIV"   "XV"    "XVI"   "XVII"  "XVIII"
[19] "XIX"   "XX"    "XXI"   "XXII"  "XXIII"

Finalement, on ajoute manuellement le nom du chapitre préliminaire (qui n’avait pas de chiffre romain) au début du vecteur :

chapter_names = c("0", chapter_names)

Nous avons désormais tout ce qu’il faut pour sauvegarder nos chapitres dans des fichiers séparés, avec des noms appropriés, à l’aide d’une boucle :

# Boucle sur les chapitres
for (i in 1:length(chapters)){
  # On écrit le chapitre dans un fichier .txt
  write_file(chapters[i], 
             paste0("data/autour_de_la_lune/autour_de_la_lune_", chapter_names[i], ".txt"))
}

2.4 Chargement d’un corpus à partir d’un dossier avec le tidyverse

Dans la pratique, la plupart des corpus que nous traiterons seront déjà structurés sous la forme de multiples fichiers répartis dans un dossier. Nous allons voir comment charger toutes ces données d’un coup dans un vecteur, format requis par de nombreuses librairies d’analyse. Nous le verrons à la section suivante, mais readtext, package compagnon de quanteda, propose aussi ses propres méthodes d’importation (préférables lorsque l’on utilise quanteda).

Voici le dossier contenant notre corpus fraîchement découpé :

corpus_folder = "data/autour_de_la_lune/"

On liste d’abord tous les fichiers qu’il contient :

corpus_file_names = list.files(corpus_folder)
corpus_file_names
 [1] "autour_de_la_lune_0.txt"     "autour_de_la_lune_I.txt"    
 [3] "autour_de_la_lune_II.txt"    "autour_de_la_lune_III.txt"  
 [5] "autour_de_la_lune_IV.txt"    "autour_de_la_lune_IX.txt"   
 [7] "autour_de_la_lune_V.txt"     "autour_de_la_lune_VI.txt"   
 [9] "autour_de_la_lune_VII.txt"   "autour_de_la_lune_VIII.txt" 
[11] "autour_de_la_lune_X.txt"     "autour_de_la_lune_XI.txt"   
[13] "autour_de_la_lune_XII.txt"   "autour_de_la_lune_XIII.txt" 
[15] "autour_de_la_lune_XIV.txt"   "autour_de_la_lune_XIX.txt"  
[17] "autour_de_la_lune_XV.txt"    "autour_de_la_lune_XVI.txt"  
[19] "autour_de_la_lune_XVII.txt"  "autour_de_la_lune_XVIII.txt"
[21] "autour_de_la_lune_XX.txt"    "autour_de_la_lune_XXI.txt"  
[23] "autour_de_la_lune_XXII.txt"  "autour_de_la_lune_XXIII.txt"

À partir de cette liste, on crée un vecteur contenant les chemins d’accès complets :

file_paths = paste0(corpus_folder, corpus_file_names)
file_paths[1:2]
[1] "data/autour_de_la_lune/autour_de_la_lune_0.txt"
[2] "data/autour_de_la_lune/autour_de_la_lune_I.txt"

C’est ici qu’intervient une fonctionnalité du Tidyverse. Plutôt que d’écrire une boucle, nous utilisons la fonction map_chr() du package purrr. Elle applique automatiquement la fonction read_file() sur chacun de nos chemins d’accès et nous retourne un vecteur de chaînes de caractères en une seule ligne de code :

texts = map_chr(file_paths, read_file)

On peut vérifier que le chargement groupé a bien fonctionné :

texts[1:3] %>%
  str_sub(1, 100)
[1] "AUTOUR DE LA LUNE par Jules Verne CHAPITRE PRÉLIMINAIRE Qui résume la première partie de cet ouvrage"
[2] "I De dix heures vingt a dix heures quarante-sept minutes du soir Quand dix heures sonnèrent, Michel "
[3] "II La première demi-heure Que s'était-il passé? Quel effet avait produit cette effroyable secousse? "

3 Quanteda et statistiques simples

L’utilisation d’une librairie de plus haut niveau, telle que quanteda, peut fortement simplifier la tâche de segmentation. De plus, les résultats obtenus vont nous servir de base pour de nombreuses analyses futures.

3.1 Chargement du jeu de données

Pour commencer, nous allons charger notre corpus. Nous travaillerons sur le corpus manifesto, qui contient les manifestes politiques émis par différents partis lors des élections présidentielles et législatives françaises de 2017.

Plutôt que d’utiliser read_file() dans la fonction map_chr() comme vu précédemment, nous allons utiliser le package readtext. C’est le compagnon officiel de quanteda. Il est conçu pour charger un dossier complet de textes en une seule ligne, gère nativement de nombreux formats (.txt, .pdf, .docx, etc.), et permet la gestion des métadonnées. Le résultat de ce chargement est un data.frame :

# On charge tous les fichiers .txt du dossier en une seule commande
texts_df = readtext("data/manifesto/text/*.txt")

# Le résultat est un tableau de données (data.frame) contenant les textes et leurs identifiants
head(texts_df, 2)
readtext object consisting of 2 documents and 0 docvars.
# A data frame: 2 × 2
  doc_id                             text               
* <chr>                              <chr>              
1 en_marche_2017.txt                 "\"Emmanuel M\"..."
2 europe_ecologie_les_verts_2017.txt "\"Il y a urg\"..."

3.2 Les objets de type corpus

Les objets de type corpus de quanteda sont conçus pour structurer et contenir l’entièreté d’un corpus. Ils nous permettront, plus tard, d’effectuer plusieurs analyses.

Un objet corpus se crée très simplement à partir du tableau généré par readtext :

my_corpus = corpus(texts_df)

On peut extraire des statistiques simples à partir de cet objet :

summary(my_corpus)
Corpus consisting of 9 documents, showing 9 documents:

                               Text Types Tokens Sentences
                 en_marche_2017.txt  1951   6775       333
 europe_ecologie_les_verts_2017.txt  1344   3911       128
          france_insoumise_2017.txt  4632  21987       506
            front_national_2017.txt  1992   5910       235
    mouvement_democratique_2017.txt  2818  10297       424
 parti_communiste_francais_2017.txt   295    543        17
   parti_radical_de_gauche_2017.txt  3488  13435       346
          parti_socialiste_2017.txt   637   1510        26
          udi_republicains_2017.txt  1667   5262       238

Ou des statistiques plus complètes avec la fonction textstat_summary() du package quanteda.textstats :

textstat_summary(my_corpus)
                            document  chars sents tokens types puncts numbers
1                 en_marche_2017.txt  41182   333   6775  1835    930      75
2 europe_ecologie_les_verts_2017.txt  23726   127   3911  1291    493     132
3          france_insoumise_2017.txt 139096   506  21987  4359   2283     342
4            front_national_2017.txt  36170   235   5910  1809    618      66
5    mouvement_democratique_2017.txt  64903   424  10297  2647   1348      57
6 parti_communiste_francais_2017.txt   3072    17    543   276     67       3
7   parti_radical_de_gauche_2017.txt  84406   346  13435  3250   1486      81
8          parti_socialiste_2017.txt   8973    26   1510   620    160      55
9          udi_republicains_2017.txt  31438   238   5262  1539    504      35
  symbols urls tags emojis
1       1    0    0      0
2      57    0    0      0
3       8    0    0      0
4       1    0    0      0
5       4    0    0      0
6       0    0    0      0
7       2    0    0      0
8       2    0    0      0
9       2    0    0      0

Un grand avantage du corpus est la possibilité d’y attacher des métadonnées (appelées docvars) :

docvars(my_corpus, "Orientation") = c("droite", "gauche", "gauche", "droite", 
                                      "centre", "gauche", "gauche", "centre", 
                                      "droite")
summary(my_corpus)
Corpus consisting of 9 documents, showing 9 documents:

                               Text Types Tokens Sentences Orientation
                 en_marche_2017.txt  1951   6775       333      droite
 europe_ecologie_les_verts_2017.txt  1344   3911       128      gauche
          france_insoumise_2017.txt  4632  21987       506      gauche
            front_national_2017.txt  1992   5910       235      droite
    mouvement_democratique_2017.txt  2818  10297       424      centre
 parti_communiste_francais_2017.txt   295    543        17      gauche
   parti_radical_de_gauche_2017.txt  3488  13435       346      gauche
          parti_socialiste_2017.txt   637   1510        26      centre
          udi_republicains_2017.txt  1667   5262       238      droite

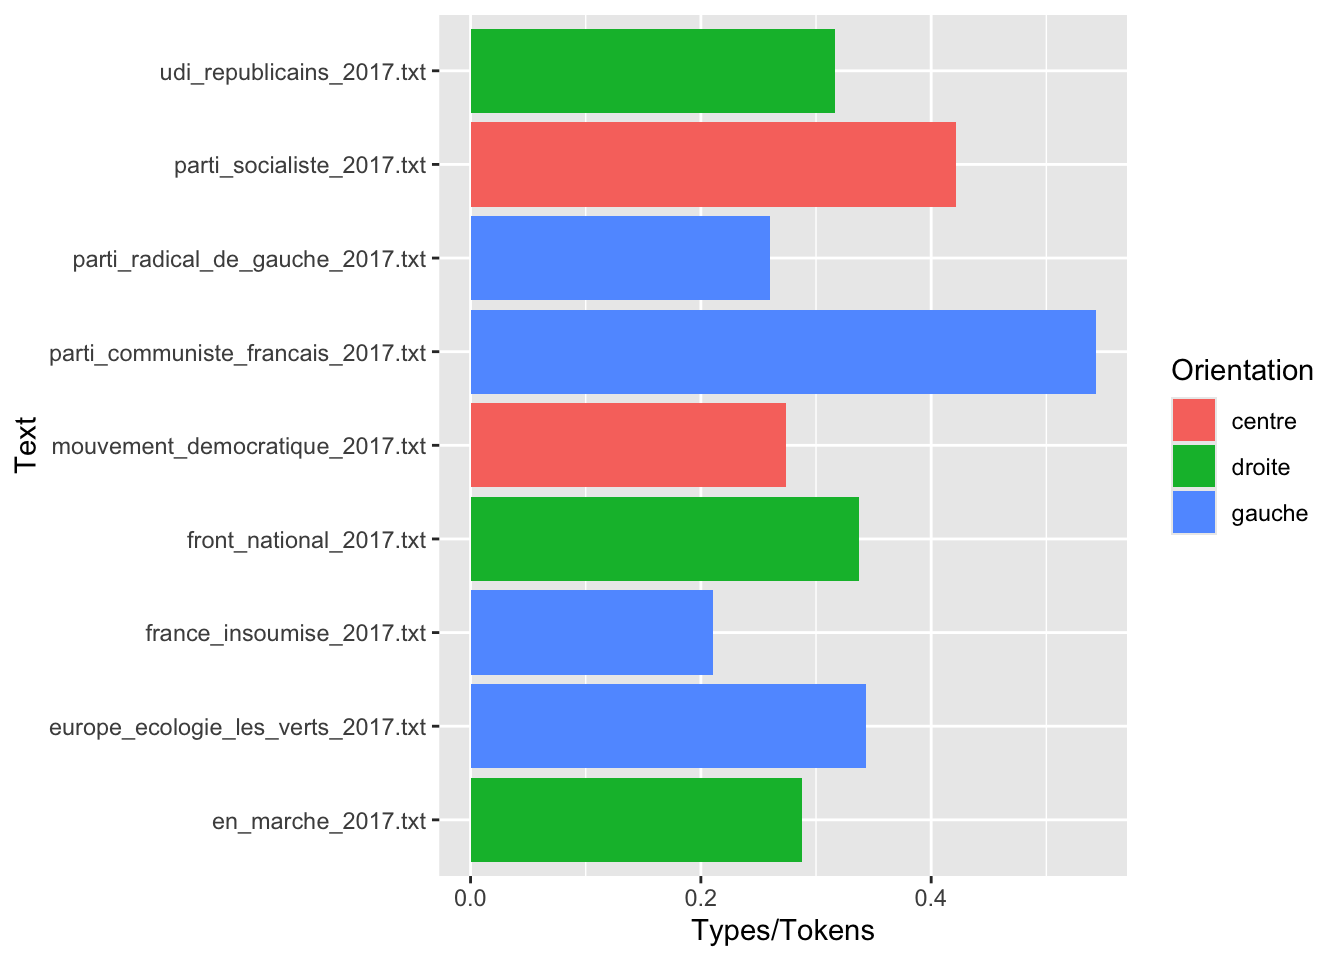
Ces métadonnées permettent par exemple de faire des graphiques rapides croisant le texte et nos variables :

summary(my_corpus) %>%
  ggplot() +
  geom_bar(aes(y=Text, x=Types/Tokens, fill=Orientation), stat="identity")

Ou encore de créer un sous-corpus pour filtrer notre analyse :

sub_corpus = corpus_subset(my_corpus, Orientation == "gauche")
summary(sub_corpus)
Corpus consisting of 4 documents, showing 4 documents:

                               Text Types Tokens Sentences Orientation
 europe_ecologie_les_verts_2017.txt  1344   3911       128      gauche
          france_insoumise_2017.txt  4632  21987       506      gauche
 parti_communiste_francais_2017.txt   295    543        17      gauche
   parti_radical_de_gauche_2017.txt  3488  13435       346      gauche

3.3 Les objets de type tokens :

Pour des analyses portant sur des éléments plus fins du corpus, nous avons besoin de segmenter le texte en créant des objets de type tokens. On applique cette fonction directement sur notre corpus :

my_words = tokens(my_corpus)
my_words
Tokens consisting of 9 documents and 1 docvar.
en_marche_2017.txt :
 [1] "Emmanuel"  "Macron"    "président" "."         "“"         "Retrouver"
 [7] "notre"     "esprit"    "de"        "conquête"  "pour"      "bâtir"    
[ ... and 6,763 more ]

europe_ecologie_les_verts_2017.txt :
 [1] "Il"      "y"       "a"       "urgence" "car"     "notre"   "pays"   
 [8] "est"     "au"      "bord"    "de"      "la"     
[ ... and 3,899 more ]

france_insoumise_2017.txt :
 [1] "L'AVENIR"  "EN"        "COMMUN"    "Le"        "programme" "de"       
 [7] "la"        "France"    "insoumise" "et"        "son"       "candidat" 
[ ... and 21,975 more ]

front_national_2017.txt :
 [1] "Au"            "nom"           "du"            "peuple"       
 [5] "144"           "ENGAGEMENTS"   "PRÉSIDENTIELS" "Marine"       
 [9] "2017"          "Engagements"   "présidentiels" "Marine"       
[ ... and 5,898 more ]

mouvement_democratique_2017.txt :
 [1] "La"           "France"       "solidaire"    ":"            "le"          
 [6] "programme"    "Nos"          "Propositions" "La"           "France"      
[11] "est"          "une"         
[ ... and 10,285 more ]

parti_communiste_francais_2017.txt :
 [1] "Le"              "peuple"          "à"               "l’Assemblée"    
 [5] "nationale"       "Les"             "élections"       "présidentielles"
 [9] "viennent"        "de"              "s’achever"       "avec"           
[ ... and 531 more ]

[ reached max_ndoc ... 3 more documents ]

La segmentation par mots est celle par défaut, mais on peut aussi la faire par phrases :

my_sentences = tokens(my_corpus, what="sentence")
my_sentences
Tokens consisting of 9 documents and 1 docvar.
en_marche_2017.txt :
 [1] "Emmanuel Macron président."                                                                                                                                                                                                                                                                                         
 [2] "“Retrouver notre esprit de conquête pour bâtir une France nouvelle” MON CONTRAT AVEC LA NATION « RETROUVER NOTRE ESPRIT DE CONQUÊTE POUR BÂTIR UNE FRANCE NOUVELLE » COMMENT CE PROGRAMME A-T-IL ÉTÉ CONSTRUIT ?"                                                                                                   
 [3] "Bien vivre de son travail et inventer de nouvelles protections Nous ne sommes pas condamnés à choisir entre le chômage de masse et la précarisation du travail."                                                                                                                                                    
 [4] "Nous ne sommes pas naïfs."                                                                                                                                                                                                                                                                                          
 [5] "Nous savons bien que, dans la vie, on n’a rien sans rien et que tout progrès, personnel ou collectif, dépend de cet effort qu’on appelle le travail."                                                                                                                                                               
 [6] "Nous savons que le travail, lorsqu’il est pratiqué dans de bonnes conditions et correctement payé, est le moteur de la progression sociale."                                                                                                                                                                        
 [7] "Nous savons aussi que le travail a toujours changé (les porteurs d’eau ou les conducteurs de calèche ont été remplacés par d’autres métiers), que de nouveaux besoins naissent du vieillissement de la population, de la transition écologique, de la transition numérique, et que de nouveaux métiers vont surgir."
 [8] "Dans ce monde nouveau, chacun doit trouver sa place."                                                                                                                                                                                                                                                               
 [9] "Et la France a toute la sienne, si elle sait tout à la fois libérer les initiatives et protéger les personnes."                                                                                                                                                                                                     
[10] "·               Nous améliorerons le pouvoir d’achat de tous les travailleurs."                                                                                                                                                                                                                                     
[11] "·               Sans que cela ne revienne plus cher aux employeurs, nous réduirons les cotisations payées par les salariés, par les indépendants et par les fonctionnaires : près de 500 euros supplémentaires nets par an pour un salaire de 2200 euros nets par mois !"                                           
[12] "·               Nous augmenterons le pouvoir d’achat des ouvriers, des employés et des salariés les moins bien payés."                                                                                                                                                                                              
[ ... and 321 more ]

europe_ecologie_les_verts_2017.txt :
 [1] "Il y a urgence car notre pays est au bord de la rupture."                                                                                                                                                                                     
 [2] "Il est pris d’une inquiétante tentation du vide –ou du pire."                                                                                                                                                                                 
 [3] "Il glisse vers le repli nationaliste et le rétrécissement identitaire, le rejet et la haine de l’autre."                                                                                                                                      
 [4] "Le débat politique lui-même s’affaisse, surjouant les simplifications, forgeant des boucs émissaires pour justifier tous les renoncements."                                                                                                   
 [5] "La France souffre de ne plus avoir de projet partagé collectivement."                                                                                                                                                                         
 [6] "Cela dégénère en un sauve-qui-peut généralisé qui pourrait très mal finir."                                                                                                                                                                   
 [7] "Malgré les discours et les tentatives trop frileuses, les gouvernements qui se succèdent nient la réalité qui nous percute brutalement: notre modèle de développement remet en cause les conditions mêmes de vie et de survie sur la planète."
 [8] "Il provoque bouleversements climatiques, nouvelle extinction de masse des espèces vivantes, épuisement des ressources et explosion des maladies liées à l’environnement."                                                                     
 [9] "Il maltraite les animaux comme nous nous maltraitons nousmêmes."                                                                                                                                                                              
[10] "Il génère une concentration des richesses sans précédent, avec pour corollaire l’aggravation des inégalités, le chômage, la précarité et les maladies psychosociales."                                                                        
[11] "Rentiers de ce vieux monde, les dirigeants politiques de droite comme, trop souvent, de gauche, ne veulent rien lâcher."                                                                                                                      
[12] "À vouloir sauver leur passé, ils sacrifient notre futur."                                                                                                                                                                                     
[ ... and 115 more ]

france_insoumise_2017.txt :
 [1] "L'AVENIR EN COMMUN Le programme de la France insoumise et son candidat Jean-Luc MÉLENCHON L’avenir en commun Notre pays est neuf."                                                                    
 [2] "L’urbanisation accélérée et le métissage de sa population depuis un siècle, l’élévation fantastique du niveau d’éducation de son peuple, la mise en oeuvre des conquêtes sociales l’ont métamorphosé!"
 [3] "Notre pays est jeune: sa population sera bientót la première en Europe."                                                                                                                              
 [4] "Notre pays est puissant: son économie compte parmi les premières du monde."                                                                                                                           
 [5] "De tout cela que faisons-nous à l’heure oú l’humanité entière doit relever les plus grands défis collectifs du fait du dérèglement climatique et de la menace d’épuisement qui pèse sur l’écosystème?"
 [6] "Regardons-nous: le pays est défiguré par le chómage, la pauvreté, le productivisme le plus aveuglé, et les communautarismes fielleusement entretenus!"                                                
 [7] "Pillé et démoralisé, il est rendu incapable de déployer son formidable potentiel humain, technique et culturel."                                                                                      
 [8] "La finance, la cupidité, les préjugés de classe, le sexisme et le racisme ordinaires pourrissent tout."                                                                                               
 [9] "Quel genre de pays sommes-nous devenus au bout de trente ans de gâteries aux puissants jamais rassasiés?"                                                                                             
[10] "Le nombre des millionnaires augmente, mais ses millions de salariés, ouvriers, employés, ses paysans se désespèrent, ses retraités peinent à boucler les fins de mois!"                               
[11] "Des centaines de milliers de familles travaillent dur et sont devenues pauvres, ses diplómés vivent dans la précarité!"                                                                               
[12] "Les suicides des salariés s’ajoutent aux centaines de morts annuels sur le poste de travail."                                                                                                         
[ ... and 494 more ]

front_national_2017.txt :
 [1] "Au nom du peuple 144 ENGAGEMENTS PRÉSIDENTIELS Marine 2017 Engagements présidentiels Marine 2017 Remettre la France en ordre, en cinq ans."                                                                                                                                                    
 [2] "C’est l’engagement que je prends."                                                                                                                                                                                                                                                             
 [3] "Mon projet contient 144 grandes mesures qui vous seront détaillées tout au long de la campagne."                                                                                                                                                                                               
 [4] "J’ai voulu, par cette démarche, vous permettre de controller mon action à la tête de l’État au cours du quinquennat."                                                                                                                                                                          
 [5] "Sans ce contrôle, il n’existe pas de démocratie saine."                                                                                                                                                                                                                                        
 [6] "L’objectif de ce projet est d’abord de rendre sa liberté à la France et la parole au peuple."                                                                                                                                                                                                  
 [7] "Car c’est en votre nom, et pour votre seul bénéfice, que toute politique nationale doit être menée."                                                                                                                                                                                           
 [8] "Je veux aussi rendre leur argent aux Français, parce que depuis de trop nombreuses années, notre politique sociale et fiscale appauvrit les classes moyennes et populaires, alors qu’elle enrichit les multinationales et dilapide l’argent public via une immigration totalement incontrôlée."
 [9] "Mon projet, vous pourrez le constater, consiste en une véritable révolution de la proximité."                                                                                                                                                                                                  
[10] "Proximité démocratique : je veux que les décisions soient prises au plus près des citoyens et directement contrôlées par eux."                                                                                                                                                                 
[11] "Proximité économique : il s’agit de réaménager notre territoire, d’y trouver des services publics partout, de relocaliser nos entreprises et donc nos emplois."                                                                                                                                
[12] "Plus aucun Français, plus aucun bout de France, y compris l’Outre-mer pour lequel j’ai déjà présenté mon projet complet, ne doit être oublié."                                                                                                                                                 
[ ... and 223 more ]

mouvement_democratique_2017.txt :
 [1] "La France solidaire : le programme Nos Propositions La France est une grande nation, admirée pendant des siècles pour sa culture et ses valeurs : les droits de l'homme, la créativité artistique, la liberté de ses intellectuels… Nous avons été un pays respecté, offrant une référence à bien des populations opprimées."
 [2] "Les Français sont un grand peuple."                                                                                                                                                                                                                                                                                          
 [3] "Les épreuves ne l'ont pas épargné mais chaque génération a su puiser jusqu'ici dans sa foi en l'avenir et dans les valeurs de la République la fierté et le dynamisme nécessaires."                                                                                                                                          
 [4] "Nous en sommes capables à nouveau."                                                                                                                                                                                                                                                                                          
 [5] "Mais en ce début du 21e siècle, nous voici confrontés à de grandes difficultés."                                                                                                                                                                                                                                             
 [6] "Notre société a subi des mutations profondes qui ne sont pas toutes des progrès."                                                                                                                                                                                                                                            
 [7] "Chacun le voit bien : le profit n'est pas équitablement partagé."                                                                                                                                                                                                                                                            
 [8] "La grande entreprise apparaît trop souvent comme la propriété de ses seuls actionnaires, et la place des salariés n'est pas reconnue comme elle devrait l'être."                                                                                                                                                             
 [9] "Une politique d'endettement public sans frein nous appauvrit chaque jour davantage."                                                                                                                                                                                                                                         
[10] "En outre, de mauvais choix de politique industrielle ont conduit à sacrifier une grande part de notre appareil de production nationale."                                                                                                                                                                                     
[11] "Ce que nous savons faire, nous devons le faire : produire à nouveau en France n'est pas une utopie mais une nécessité."                                                                                                                                                                                                      
[12] "Ce qu'ont fait d'autres nations voisines, nous pouvons le faire."                                                                                                                                                                                                                                                            
[ ... and 412 more ]

parti_communiste_francais_2017.txt :
 [1] "Le peuple à l’Assemblée nationale Les élections présidentielles viennent de s’achever avec l’élection d’un nouveau Président de la République, monsieur Macron."                                                                                                                                                                     
 [2] "Ce scrutin aura été marqué par une légitime colère devant l’inefficacité des politiques publiques mises en oeuvre depuis des décennies."                                                                                                                                                                                             
 [3] "Elle aura aussi, malheureusement, entraîné beaucoup trop de nos concitoyens vers des chemins de divisions, de haine, et tout compte fait, de désespérance."                                                                                                                                                                          
 [4] "Le PCF en soutenant Jean-Luc Mélenchon, a voulu que cette colère devant la pauvreté, le chômage, les inégalités qui s’accroissent, devant le pillage des ressources naturelles, trouve le chemin, non de la division, mais de l’espoir et du progrès."                                                                               
 [5] "A l'occasion des élections législatives, nous avons la possibilité concrétiser cet espoir en élisant un maximum de député-e-s qui s'opposeront fermement à E.Macron, à la droite et à l'extrême droite et qui porteront haut vos luttes et vos espoirs."                                                                             
 [6] "LA GAUCHE DEBOUT POUR L'HUMAIN D'ABORD !"                                                                                                                                                                                                                                                                                            
 [7] "M.Macron a d'ores et déjà annoncé son désir de « réformer » le code du travail par ordonnances durant l'été."                                                                                                                                                                                                                        
 [8] "Face à ce déni démocratique dôtons nous de député-e-s qui voteront contre la loi lui permettant d'âgir de la sorte."                                                                                                                                                                                                                 
 [9] "Donnons nous des députés qui ne se soumettront pas au mépris de la démocratie !"                                                                                                                                                                                                                                                     
[10] "C'est cela que pour les candidat-e-s soutenu-e-s par le PCF. Nous ne laisserons pas faire."                                                                                                                                                                                                                                          
[11] "Nos député-e-s seront aux cotés des jeunes, des femmes, des infirmières, des postiers, des salariés du public et du privé, des agriculteurs, des précaires et chômeurs qui aspirent à ce que leur vie change, qui aspirent à faire émerger une gauche de combat et de valeur, une gauche qui agit au nom de « l'humain d'abord » !\""
[12] "Nos 5 axes d'action Pour faire vivre l'humain d'abord dans notre circonscription, nos candidats agiront pour : 1."                                                                                                                                                                                                                   
[ ... and 5 more ]

[ reached max_ndoc ... 3 more documents ]
Ou par caractères :

my_chars = tokens(my_corpus, what="character")
my_chars
Tokens consisting of 9 documents and 1 docvar.
en_marche_2017.txt :
 [1] "E" "m" "m" "a" "n" "u" "e" "l" "M" "a" "c" "r"
[ ... and 32,022 more ]

europe_ecologie_les_verts_2017.txt :
 [1] "I" "l" "y" "a" "u" "r" "g" "e" "n" "c" "e" "c"
[ ... and 18,560 more ]

france_insoumise_2017.txt :
 [1] "L" "'" "A" "V" "E" "N" "I" "R" "E" "N" "C" "O"
[ ... and 112,278 more ]

front_national_2017.txt :
 [1] "A" "u" "n" "o" "m" "d" "u" "p" "e" "u" "p" "l"
[ ... and 30,661 more ]

mouvement_democratique_2017.txt :
 [1] "L" "a" "F" "r" "a" "n" "c" "e" "s" "o" "l" "i"
[ ... and 50,780 more ]

parti_communiste_francais_2017.txt :
 [1] "L" "e" "p" "e" "u" "p" "l" "e" "à" "l" "’" "A"
[ ... and 2,577 more ]

[ reached max_ndoc ... 3 more documents ]
La fonction tokens() possède de nombreuses options très utiles pour “nettoyer” le texte dès la segmentation :

my_rstr_words = tokens(my_corpus, 
                       remove_punct=T, 
                       remove_symbols=T, 
                       remove_numbers=T,
                       remove_url=T,
                       split_hyphens=T)
my_rstr_words
Tokens consisting of 9 documents and 1 docvar.
en_marche_2017.txt :
 [1] "Emmanuel"  "Macron"    "président" "Retrouver" "notre"     "esprit"   
 [7] "de"        "conquête"  "pour"      "bâtir"     "une"       "France"   
[ ... and 5,788 more ]

europe_ecologie_les_verts_2017.txt :
 [1] "Il"      "y"       "a"       "urgence" "car"     "notre"   "pays"   
 [8] "est"     "au"      "bord"    "de"      "la"     
[ ... and 3,250 more ]

france_insoumise_2017.txt :
 [1] "L'AVENIR"  "EN"        "COMMUN"    "Le"        "programme" "de"       
 [7] "la"        "France"    "insoumise" "et"        "son"       "candidat" 
[ ... and 19,471 more ]

front_national_2017.txt :
 [1] "Au"            "nom"           "du"            "peuple"       
 [5] "ENGAGEMENTS"   "PRÉSIDENTIELS" "Marine"        "Engagements"  
 [9] "présidentiels" "Marine"        "Remettre"      "la"           
[ ... and 5,245 more ]

mouvement_democratique_2017.txt :
 [1] "La"           "France"       "solidaire"    "le"           "programme"   
 [6] "Nos"          "Propositions" "La"           "France"       "est"         
[11] "une"          "grande"      
[ ... and 8,936 more ]

parti_communiste_francais_2017.txt :
 [1] "Le"              "peuple"          "à"               "l’Assemblée"    
 [5] "nationale"       "Les"             "élections"       "présidentielles"
 [9] "viennent"        "de"              "s’achever"       "avec"           
[ ... and 476 more ]

[ reached max_ndoc ... 3 more documents ]
Une fois ces tokens créés, on peut effectuer des opérations de nettoyage supplémentaires. Par exemple, séparer les mots collés par des apostrophes :

my_rstr_words = my_rstr_words %>%
  tokens_split("'") %>%
  tokens_split("’") 
my_rstr_words
Tokens consisting of 9 documents and 1 docvar.
en_marche_2017.txt :
 [1] "Emmanuel"  "Macron"    "président" "Retrouver" "notre"     "esprit"   
 [7] "de"        "conquête"  "pour"      "bâtir"     "une"       "France"   
[ ... and 6,139 more ]

europe_ecologie_les_verts_2017.txt :
 [1] "Il"      "y"       "a"       "urgence" "car"     "notre"   "pays"   
 [8] "est"     "au"      "bord"    "de"      "la"     
[ ... and 3,416 more ]

france_insoumise_2017.txt :
 [1] "L"         "AVENIR"    "EN"        "COMMUN"    "Le"        "programme"
 [7] "de"        "la"        "France"    "insoumise" "et"        "son"      
[ ... and 20,551 more ]

front_national_2017.txt :
 [1] "Au"            "nom"           "du"            "peuple"       
 [5] "ENGAGEMENTS"   "PRÉSIDENTIELS" "Marine"        "Engagements"  
 [9] "présidentiels" "Marine"        "Remettre"      "la"           
[ ... and 5,537 more ]

mouvement_democratique_2017.txt :
 [1] "La"           "France"       "solidaire"    "le"           "programme"   
 [6] "Nos"          "Propositions" "La"           "France"       "est"         
[11] "une"          "grande"      
[ ... and 9,416 more ]

parti_communiste_francais_2017.txt :
 [1] "Le"              "peuple"          "à"               "l"              
 [5] "Assemblée"       "nationale"       "Les"             "élections"      
 [9] "présidentielles" "viennent"        "de"              "s"              
[ ... and 513 more ]

[ reached max_ndoc ... 3 more documents ]

Mettre tous les mots en minuscules pour uniformiser la casse :

my_rstr_words = my_rstr_words %>%
  tokens_tolower()
my_rstr_words
Tokens consisting of 9 documents and 1 docvar.
en_marche_2017.txt :
 [1] "emmanuel"  "macron"    "président" "retrouver" "notre"     "esprit"   
 [7] "de"        "conquête"  "pour"      "bâtir"     "une"       "france"   
[ ... and 6,139 more ]

europe_ecologie_les_verts_2017.txt :
 [1] "il"      "y"       "a"       "urgence" "car"     "notre"   "pays"   
 [8] "est"     "au"      "bord"    "de"      "la"     
[ ... and 3,416 more ]

france_insoumise_2017.txt :
 [1] "l"         "avenir"    "en"        "commun"    "le"        "programme"
 [7] "de"        "la"        "france"    "insoumise" "et"        "son"      
[ ... and 20,551 more ]

front_national_2017.txt :
 [1] "au"            "nom"           "du"            "peuple"       
 [5] "engagements"   "présidentiels" "marine"        "engagements"  
 [9] "présidentiels" "marine"        "remettre"      "la"           
[ ... and 5,537 more ]

mouvement_democratique_2017.txt :
 [1] "la"           "france"       "solidaire"    "le"           "programme"   
 [6] "nos"          "propositions" "la"           "france"       "est"         
[11] "une"          "grande"      
[ ... and 9,416 more ]

parti_communiste_francais_2017.txt :
 [1] "le"              "peuple"          "à"               "l"              
 [5] "assemblée"       "nationale"       "les"             "élections"      
 [9] "présidentielles" "viennent"        "de"              "s"              
[ ... and 513 more ]

[ reached max_ndoc ... 3 more documents ]

Ou enlever les “mots vides” ou stopwords, c’est-à-dire les mots grammaticaux très fréquents qui n’apportent pas de sens (le, la, de, et…).

quanteda possède des dictionnaires intégrés pour cela, pour plusieurs langues :

# Utilisation du dictionnaire français natif
my_rstr_words %>%
  tokens_remove(stopwords("fr"))
Tokens consisting of 9 documents and 1 docvar.
en_marche_2017.txt :
 [1] "emmanuel"  "macron"    "président" "retrouver" "esprit"    "conquête" 
 [7] "bâtir"     "france"    "nouvelle"  "contrat"   "nation"    "retrouver"
[ ... and 3,156 more ]

europe_ecologie_les_verts_2017.txt :
 [1] "a"           "urgence"     "car"         "pays"        "bord"       
 [6] "rupture"     "pris"        "inquiétante" "tentation"   "vide"       
[11] "pire"        "glisse"     
[ ... and 1,930 more ]

france_insoumise_2017.txt :
 [1] "avenir"    "commun"    "programme" "france"    "insoumise" "candidat" 
 [7] "jean"      "luc"       "mélenchon" "avenir"    "commun"    "pays"     
[ ... and 11,437 more ]

front_national_2017.txt :
 [1] "nom"           "peuple"        "engagements"   "présidentiels"
 [5] "marine"        "engagements"   "présidentiels" "marine"       
 [9] "remettre"      "france"        "ordre"         "cinq"         
[ ... and 3,072 more ]

mouvement_democratique_2017.txt :
 [1] "france"       "solidaire"    "programme"    "propositions" "france"      
 [6] "grande"       "nation"       "admirée"      "pendant"      "siècles"     
[11] "culture"      "valeurs"     
[ ... and 5,091 more ]

parti_communiste_francais_2017.txt :
 [1] "peuple"          "assemblée"       "nationale"       "élections"      
 [5] "présidentielles" "viennent"        "achever"         "élection"       
 [9] "nouveau"         "président"       "république"      "monsieur"       
[ ... and 256 more ]

[ reached max_ndoc ... 3 more documents ]

Mais on peut aussi utiliser des listes de stopwords personnalisées. Par exemple, voici comment faire le fichier frenchST.txt (voir http://members.unine.ch/jacques.savoy/clef/frenchST.txt)

# Chargement du fichier
stopwords = read_lines("data/stopwords/frenchST.txt") 
# Retrait des stopwords
my_rstr_words = my_rstr_words %>%
  tokens_remove(stopwords)
my_rstr_words
Tokens consisting of 9 documents and 1 docvar.
en_marche_2017.txt :
 [1] "emmanuel"  "macron"    "président" "retrouver" "esprit"    "conquête" 
 [7] "bâtir"     "france"    "nouvelle"  "contrat"   "nation"    "retrouver"
[ ... and 2,672 more ]

europe_ecologie_les_verts_2017.txt :
 [1] "urgence"      "pays"         "bord"         "rupture"      "pris"        
 [6] "inquiétante"  "tentation"    "vide"         "pire"         "glisse"      
[11] "repli"        "nationaliste"
[ ... and 1,670 more ]

france_insoumise_2017.txt :
 [1] "avenir"    "commun"    "programme" "france"    "insoumise" "candidat" 
 [7] "jean"      "luc"       "mélenchon" "avenir"    "commun"    "pays"     
[ ... and 10,280 more ]

front_national_2017.txt :
 [1] "nom"           "peuple"        "engagements"   "présidentiels"
 [5] "marine"        "engagements"   "présidentiels" "marine"       
 [9] "remettre"      "france"        "ordre"         "ans"          
[ ... and 2,829 more ]

mouvement_democratique_2017.txt :
 [1] "france"       "solidaire"    "programme"    "propositions" "france"      
 [6] "grande"       "nation"       "admirée"      "siècles"      "culture"     
[11] "valeurs"      "droits"      
[ ... and 4,584 more ]

parti_communiste_francais_2017.txt :
 [1] "peuple"          "assemblée"       "nationale"       "élections"      
 [5] "présidentielles" "viennent"        "achever"         "élection"       
 [9] "nouveau"         "président"       "république"      "monsieur"       
[ ... and 225 more ]

[ reached max_ndoc ... 3 more documents ]

3.4 Les matrices dfm (document-features matrix)

C’est ici que s’opère la vraie bascule vers l’analyse quantitative. Un objet DFM (Matrice Documents-Éléments) transforme le texte brut en données tabulaires particulières :

  • Les lignes sont les documents (ou plus généralement, un contexte)

  • Les colonnes sont les mots (ou plus généralement, des petites chaînes de caractères pouvant être comptabilisées).

  • Les cellules contiennent le nombre d’occurrences de chaque mot dans chaque document.

C’est ce qu’on appelle le modèle du Bag-of-Words (Sac de mots) : on perd l’ordre des mots pour ne conserver que leurs fréquences absolues qui forment alors les caractéristiques des documents.

On peut créer cette matrice à partir de nos tokens affinés précédemment avec la fonction dfm() :

my_dfm = dfm(my_rstr_words)
my_dfm
Document-feature matrix of: 9 documents, 7,566 features (78.05% sparse) and 1 docvar.
                                    features
docs                                 emmanuel macron président retrouver esprit
  en_marche_2017.txt                        1      1         3         2      4
  europe_ecologie_les_verts_2017.txt        0      0         0         1      0
  france_insoumise_2017.txt                 0      2         6         2      5
  front_national_2017.txt                   0      0         0         2      1
  mouvement_democratique_2017.txt           0      0         4         2      1
  parti_communiste_francais_2017.txt        0      1         1         0      0
                                    features
docs                                 conquête bâtir france nouvelle contrat
  en_marche_2017.txt                        2     2     21        5       2
  europe_ecologie_les_verts_2017.txt        0     0     38        2       0
  france_insoumise_2017.txt                 0     1     64       18       7
  front_national_2017.txt                   0     1     36        2       4
  mouvement_democratique_2017.txt           0     4     36       10       8
  parti_communiste_francais_2017.txt        0     0      0        1       0
[ reached max_ndoc ... 3 more documents, reached max_nfeat ... 7,556 more features ]

Cette matrice est le format d’entrée obligatoire pour la plupart des modèles statistiques ou de Machine Learning qui suivront. On peut déjà en extraire quelques statistiques descriptives.

Les mots les plus fréquents dans tout le corpus :

topfeatures(my_dfm, 20)
     france   politique       faire entreprises     travail        pays 
        258         150         130         126         124         122 
    mesures    français       droit       créer         vie         ans 
        119         112         109         109         108         107 
    sociale        plan         loi      mettre   proposons     publics 
         96          90          87          87          86          85 
     emploi       santé 
         84          84 

Les mots les plus fréquents par document :

topfeatures(my_dfm, 20, groups=docnames(my_dfm))
$en_marche_2017.txt
     france     travail       euros    français       faire    créerons 
         21          19          17          16          15          15 
     europe        pays         vie         ans       droit entreprises 
         15          14          12          12          11          11 
       mois      emploi        état     pouvoir    européen      ferons 
         10           9           9           8           8           8 
       faut     voulons 
          8           8 

$europe_ecologie_les_verts_2017.txt
     france       faire   renforcer      lutter         vie       créer 
         38          14          13          12          11          11 
       pays       santé  démocratie     travail         ans entreprises 
         10          10          10           8           8           8 
    publics    garantir     sociale       droit  protection     société 
          8           8           7           7           7           7 
  politique    énergies 
          7           7 

$france_insoumise_2017.txt
    mesures   proposons    réaliser   suivantes      france       faire 
         85          82          80          78          64          54 
       pays  écologique       droit     travail   politique        plan 
         47          44          44          42          41          39 
      créer      mettre       temps        état entreprises         mer 
         39          38          36          36          34          33 
   salariés     publics 
         32          31 

$front_national_2017.txt
     france    français         ans       créer        état   française 
         36          32          17          15          13          13 
  nationale    rétablir entreprises       santé      lutter      public 
         12          12          11          11          11          11 
   publique     sociale   notamment      mettre    soutenir       place 
         11          10          10          10          10           9 
  politique      rendre 
          9           9 

$mouvement_democratique_2017.txt
       france         créer     politique         faire           vie 
           36            34            28            22            21 
    nationale           loi   entreprises       sociale        mettre 
           21            20            19            17            17 
         pays          etat       justice         place           ans 
           16            16            15            14            14 
     européen développement      publique       travail     recherche 
           14            14            14            13            13 

$parti_communiste_francais_2017.txt
       faire       humain       emploi        lutte       gauche       député 
           4            4            3            3            3            3 
     travail          eau     salariés     européen       social          loi 
           2            2            2            2            2            2 
    services      publics augmentation   république    élections       femmes 
           2            2            2            2            2            2 
    salaires       public 
           2            2 

$parti_radical_de_gauche_2017.txt
    politique        moyens   entreprises        femmes    entreprise 
           41            31            29            29            28 
développement        europe       mesures     notamment        emploi 
           27            27            27            25            24 
         mise        france         droit           tpe        droits 
           24            21            20            20            19 
      publics         impôt    européenne       matière       soutien 
           19            19            19            19            18 

$parti_socialiste_2017.txt
        loi    défendre      france     sociale     travail  transition 
          8           8           7           6           5           5 
       mise    sécurité territoires énergétique      droits        plan 
          5           5           5           5           4           4 
   services     sociaux     justice      europe         mer       œuvre 
          4           4           4           4           4           4 
     postes     soutien 
          4           4 

$udi_republicains_2017.txt
     france    français     voulons     travail        pays     contrat 
         35          25          18          16          16          15 
  politique      devons         ans entreprises  république       parce 
         15          15          12          12          12          12 
        vie       place    sécurité    publique    majorité   numérique 
         11          11          11          10          10           9 
    pouvoir      emploi 
          9           9 

Pour créer des visualisations personnalisées, on peut transformer cette matrice complexe en un tableau standard (tibble) lisible par le tidyverse :

my_dfm_tib = my_dfm %>% 
  convert(to="data.frame") %>%
  as_tibble()

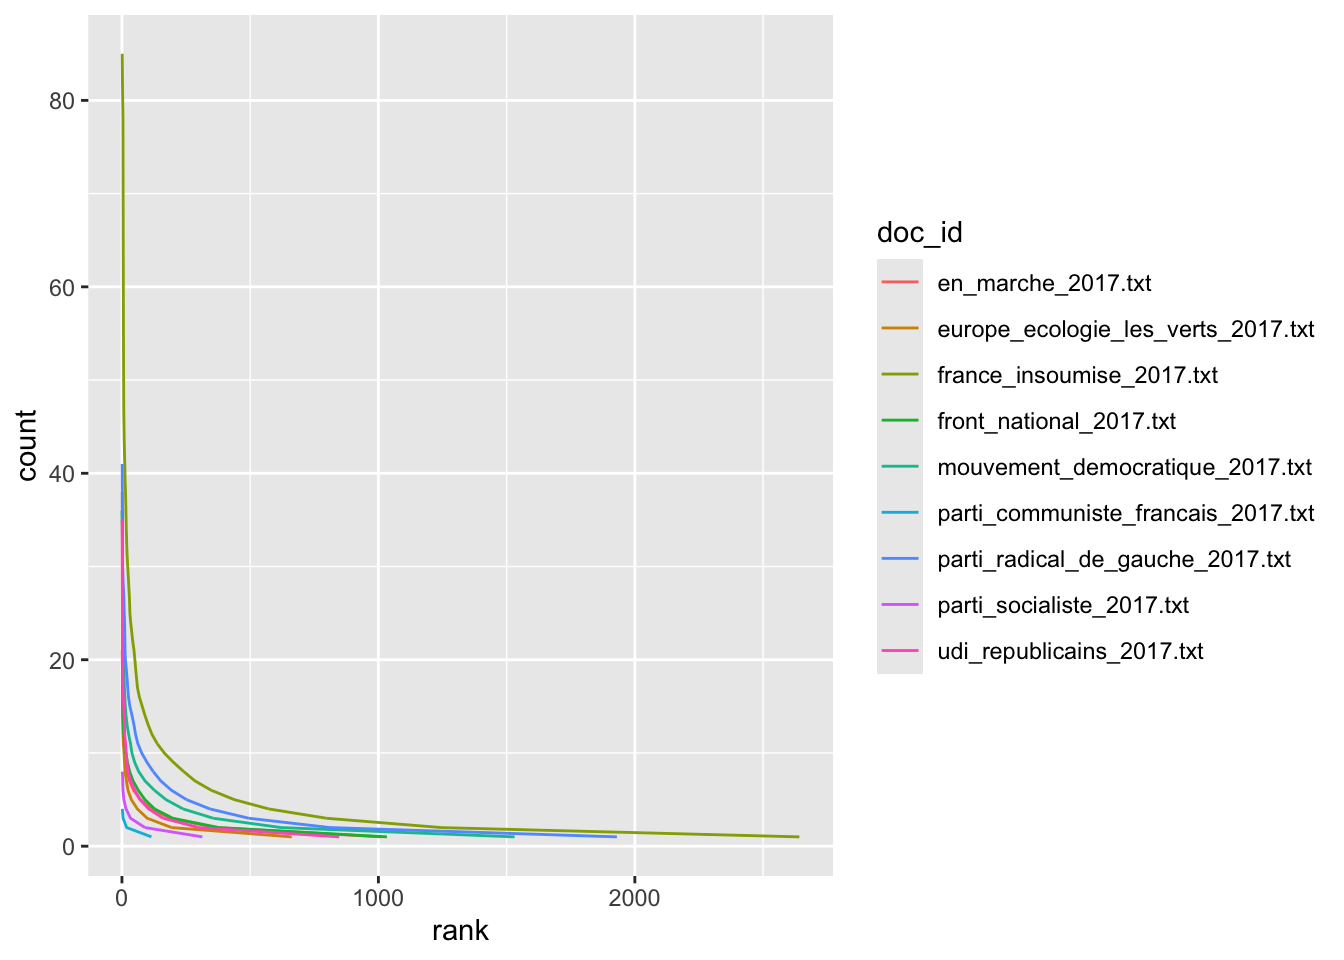
Ce qui peut nous servir, par exemple, à tracer le graphique rang-fréquence illustrant la loi de Zipf.

On commence par faire pivoter les mots pour avoir une ligne par occurrence, puis on calcule les rangs :

word_freq = my_dfm_tib %>%
  pivot_longer(cols=where(is.numeric), names_to="word", values_to="count") %>%
  group_by(doc_id) %>%
  filter(count > 0) %>%
  mutate(rank=rank(-count))
word_freq
# A tibble: 14,946 × 4
# Groups:   doc_id [9]
   doc_id             word      count   rank
   <chr>              <chr>     <dbl>  <dbl>
 1 en_marche_2017.txt emmanuel      1 1011  
 2 en_marche_2017.txt macron        1 1011  
 3 en_marche_2017.txt président     3  188  
 4 en_marche_2017.txt retrouver     2  362. 
 5 en_marche_2017.txt esprit        4  114. 
 6 en_marche_2017.txt conquête      2  362. 
 7 en_marche_2017.txt bâtir         2  362. 
 8 en_marche_2017.txt france       21    1  
 9 en_marche_2017.txt nouvelle      5   72.5
10 en_marche_2017.txt contrat       2  362. 
# ℹ 14,936 more rows

Ce qui nous permet d’obtenir le graphique rang-fréquence typique :

word_freq %>%
  ggplot() + 
  geom_line(aes(x=rank, y=count, color=doc_id))

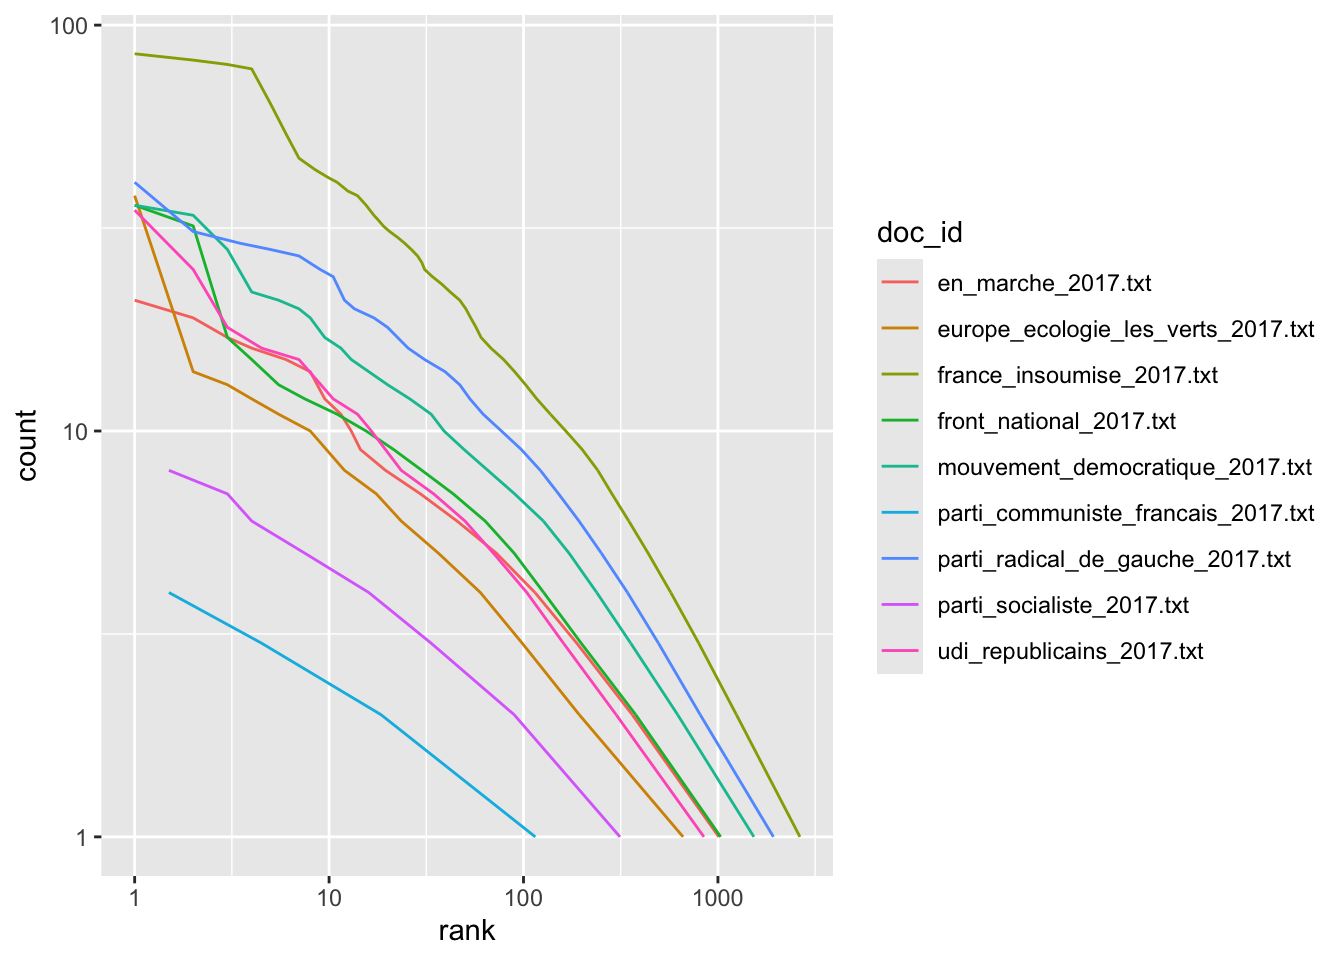
Cette distribution est beaucoup plus lisible (et forme une droite caractéristique) si l’on passe sur une échelle logarithmique (log-log) :

word_freq %>%
  ggplot() + 
  geom_line(aes(x=rank, y=count, color=doc_id)) +
  scale_x_log10() +
  scale_y_log10()