Dans ce TP, nous allons voir comment utiliser différents tests statistiques avec R.
Les librairies nécessaires sont :
library(tidyverse)
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
library(readxl)
Ici, nous allons principalement utiliser le jeu de phonétique.xlsx. Chargeons-le :
phonetique_df =read_excel("data/phonétique.xlsx")
Pour un test du chi2 entre deux variables catégorielles, nous allons plutôt utiliser le jeu de données de sociolinguistique pré-traité (sociolinguistique_v2.csv). Nous allons le charger et effectuer quelques pré-traitements :
# On charge le jeu de données et on transforme les caractères en facteurs (ordinales pas nécessaire ici)socioling_df =read_csv("data/sociolinguistique_v2.csv") %>%mutate(across(where(is.character), factor))
Rows: 113 Columns: 61
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
chr  (12): acc_mode, acc_exclu, acc_accept, acc_enrich, acc_suppr, acc_menac...
dbl  (47): id, annee, duree, duree_num, Hashtag, Design, Selfie, Pull-over, ...
dttm  (2): h_deb, h_fin

ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.
# On recode les années en génération, et on spécifie que c'est une variable ordinalesocioling_df = socioling_df %>%mutate(generation=case_when(annee %in%0:1983~"X", annee %in%1984:1995~"Y", annee %in%1995:3000~"Z")) %>%mutate(generation=factor(generation, order=T, levels=c("X", "Y", "Z")))
2 Tests uni-variés
Les tests uni-variés concernent une seule variable, que l’on peut éventuellement mesurer sur deux groupes de personnes différents. Nous allons voir ici deux types de tests :
Test de la moyenne pour deux groupes non-appariés.
Test de la moyenne pour deux groupes appariés.
2.1 Test de la moyenne pour deux groupes non-appariés
Ce test consiste à vérifier si la moyenne d’une variable numérique est significativement différente dans deux groupes constitués de personnes différentes.
Ici, nous allons tester si la durée de prononciation des mots est significativement différente entre les femmes et les hommes.
Pour cela on peut extraire deux vecteurs de notre jeu de données. Le vecteurs de durée pour les femmes :
duree_f = phonetique_df %>%filter(Sexe=="F") %>% .$Dur_M # Le pipe envoie le résultat à la place du "."head(duree_f, 100)
Le test statistique adéquat est le test de Student ou t-test. Il s’effectue avec la fonction t.test() :
t_test_res =t.test(duree_f, duree_m)t_test_res
    Welch Two Sample t-test

data:  duree_f and duree_m
t = 3.9425, df = 2735.9, p-value = 8.265e-05
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 10.92612 32.54837
sample estimates:
mean of x mean of y
 479.2391  457.5019
Prenez l’habitude de sauver le résultat d’un test dans une variable, car il est possible d’extraire plusieurs informations de ce résultat :
names(t_test_res) # Liste de ce que l'on peut extraire
Ce test consiste à vérifier si la moyenne d’une variable numérique est significativement différente dans deux groupes constitués de personnes identiques. Ce test consiste en fait à calculer la différence entre les valeurs de cette variable pour chaque personne, puis à vérifier si la moyenne de cette différence est significativement différente de 0.
Nous allons tester ici s’il existe une différence significative de durée entre la prononciation de [e] et [e:]. Pour obtenir la tableau des durées de ces deux voyelles par locuteur, on fait les opérations suivantes :
On filtre les observations sur l’opposition désirée.
On groupe par locuteur·trice et par voyelle.
On fait la moyenne de la durée pour chaque locuteur·trice et chaque voyelle.
On pivote le jeu de données pour avoir la durée de chaque voyelle sur deux colonnes différentes.
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by Locuteur and Voyelle.
ℹ Output is grouped by Locuteur.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(Locuteur, Voyelle))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
La fonction t.test() nous permet également de tester un seul vecteur. Par défaut, cette fonction teste si la moyenne du vecteur est significativement différente de 0 (mais on peut aussi tester par rapport à un autre référentiel) :
t_test_res =t.test(duree_e$diff_duree)t_test_res
    One Sample t-test

data:  duree_e$diff_duree
t = 11.612, df = 83, p-value < 2.2e-16
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
  99.35209 140.42172
sample estimates:
mean of x
 119.8869
On aurait aussi pu tester directement avec les deux vecteurs, en précisant que les groupes sont appariés avec l’option paired=T :
    Paired t-test

data:  duree_e$`e:` and duree_e$e
t = 11.612, df = 83, p-value < 2.2e-16
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
  99.35209 140.42172
sample estimates:
mean difference
       119.8869
3 Tests bi-variés
Pour tester les liens entre deux variables, on effectue des tests bi-variés. Le test à utiliser dépend des types de variables que nous voulons tester :
Numérique-numérique : test de la corrélation
Numérique-catégorielle : test du F-Ratio
Catégorielle-catégorielle : test du Chi2
3.1 Test de la corrélation
Le lien entre deux variables numériques se mesure avec la corrélation. Un test de corrélation va déterminer si cette corrélation est significativement différente de 0.
Ici, nous allons tester s’il existe un lien entre la durée de la voyelle et sa valeur du premier formant F1. On effectue ce test avec cor.test(), en fournissant les deux vecteurs de variables numériques :
    Pearson's product-moment correlation

data:  phonetique_df$Dur_V and phonetique_df$F1
t = -10.165, df = 2736, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.2266144 -0.1544177
sample estimates:
      cor
-0.190774
3.2 Test du F-Ratio
Le lien entre une variable numérique et catégorielle se mesure avec le F-ratio. Un test du F-ratio va définir si ce ratio est significativement différent de 0. Si le F-ratio = 0, il n’y a pas de lien entre les deux variables et les groupes définis par la variables catégorielles ont des moyennes (de la variable numérique) identiques.
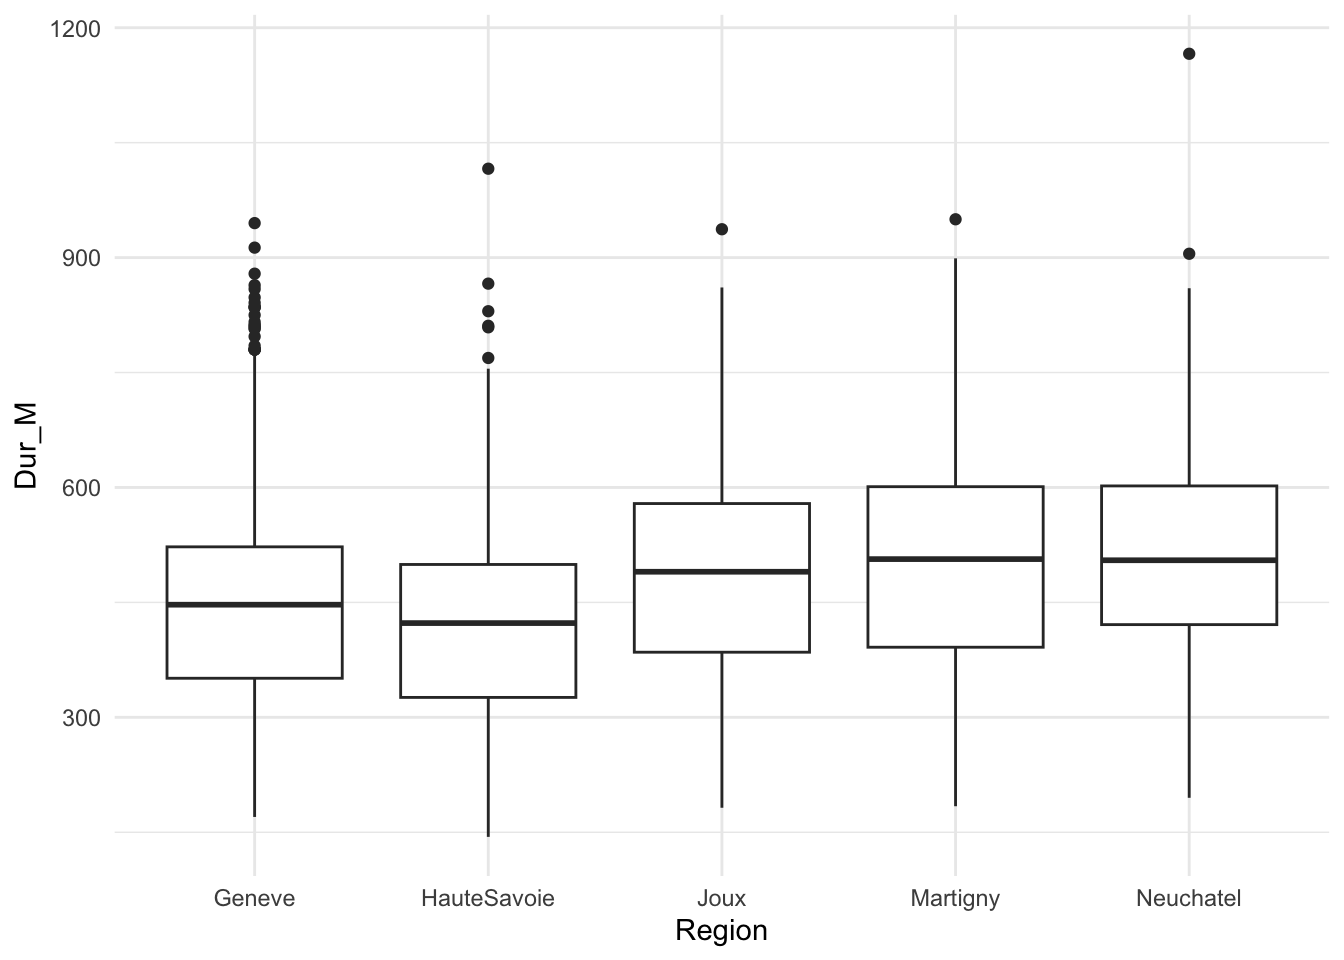
Nous testons ici si la variable région a une influence sur la durée de prononciation des mots.
Un F-test se fait de manière un peu particulière dans R. On doit d’abord faire appel à un modèle d’analyse de variance, grâce à la fonction aov() qui utilise une formule. Ici, pour tester si Dur_M dépend de Region, le modèle à créer est le suivant :
f_test_model =aov(Dur_M ~ Region, phonetique_df)
On peut voir le résultat du test en passant notre modèle dans la fonction summary() :
summary(f_test_model)
              Df   Sum Sq Mean Sq F value Pr(>F)
Region         4  3214708  803677   40.59 <2e-16 ***
Residuals   2733 54117756   19802
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Notez que ce test nous dit uniquement s’il y a une différence significative de la durée parmi les régions, mais on ne peut pas savoir, uniquement avec ce résultat, quelles régions ont une tendance à la hausse ou à la baisse. On peut étudier ce lien plus en profondeur à l’aide d’un graphique :
Finalement, pour tester le lien entre deux variables catégorielles, on utilise un test du chi2 sur une table de contingence. Ce test regarde si le chi2 (qui mesure l’écart entre notre table et la table que l’on devrait avoir en cas d’indépendance des variables catégorielles) est significativement différent de 0.
Nous allons plutôt utiliser le jeu de données sociolinguistique, car il permet des analyses plus pertinentes pour deux variables catégorielles.
Avant de faire un test du chi2, il nous faut créer une table de contingence. On peut utiliser pour cela la fonction table(), en ne gardant au préalable que 2 colonnes de variables catégorielles. Ici, on crée la table entre la variable generation et evite (“Dans la mesure du possible essayez-vous d’éviter les anglicismes ?”, avec modalités “Oui”, “Non” et “Je n’y prête pas attention”) :