library(tidyverse)
library(readxl)
library(FactoMineR)
library(factoextra)
library(aricode)
library(dendextend)1 Introduction
Dans ce TP, nous allons nous intéresser aux méthodes de clustering, aussi appelées méthodes de classification non-supervisée. Ces méthodes permettent d’obtenir des groupes parmi les individus (lignes) d’un jeu de données, en utilisant les motifs ou régularités présentent. Nous allons appliquer ici la méthode des k-moyennes, ou k-means, ainsi qu’une classification ascendante hiérarchique.
Les librairies nécessaires sont les suivantes
1.1 Chargement et pré-traitements du jeu de données
Nous allons utiliser ici le jeu de données de phonétique. Commençons par le charger (et on corrige une erreur dans le jeu de données) : knitr
phonetique_df = read_excel("data/phonétique.xlsx") %>%
  mutate(Opposition = ifelse(Opposition=="e(:)(:)", "e(:)", Opposition))
Il est possible d’effectuer des méthodes de clustering sur des variables catégorielles, en effectuant un recodage binaire de ces dernières. Ici, nous utiliserons uniquement les variables numériques F1, F2, F3 et Dur_V :
phonetique_num_df = phonetique_df %>%
  select(F1, F2, F3, Dur_V)
phonetique_num_df
# A tibble: 2,738 × 4
F1 F2 F3 Dur_V
<dbl> <dbl> <dbl> <dbl>
1 498 1299 3082 91
2 395 1077 2871 110
3 383 1186 2321 172
4 357 976 2293 211
5 490 801 2612 304
6 379 603 2268 155
7 354 801 2291 119
8 452 1224 2814 107
9 432 944 2619 126
10 416 1037 2273 87
# ℹ 2,728 more rowsComme ces variables numériques peuvent avoir des échelles différentes, et donc ne pas avoir la même importance lors d’un clustering, nous allons les standardiser. On utilise pour cela la fonction scale() (et on transforme à nouveau le résultat en tibble) :
phonetique_num_df = phonetique_num_df %>%
  scale() %>%
  as_tibble()
phonetique_num_df
# A tibble: 2,738 × 4
F1 F2 F3 Dur_V
<dbl> <dbl> <dbl> <dbl>
1 0.171 -0.831 0.641 -1.02
2 -0.436 -1.23 0.116 -0.810
3 -0.507 -1.03 -1.25 -0.112
4 -0.660 -1.41 -1.32 0.327
5 0.124 -1.72 -0.530 1.37
6 -0.530 -2.08 -1.39 -0.303
7 -0.678 -1.72 -1.33 -0.708
8 -0.100 -0.965 -0.0265 -0.843
9 -0.218 -1.47 -0.512 -0.630
10 -0.312 -1.30 -1.37 -1.07
# ℹ 2,728 more rows1.2 Analyse en composantes principales
Avant d’effectuer la méthode des k-moyennes, nous allons observer comment les lignes de notre jeu de données peuvent être représenter dans l’espace. Comme notre jeu de données possède 4 variables, on peut voir nos lignes comme des points dans un espace à 4 dimensions. Nous allons faire ici une Analyse en composantes principales (ACP) afin de projeter ces points dans un plan optimal (optimal dans le sens affichant au mieux les contrastes).
Cette méthode est similaire à l’AFC ou la ACM, mais on l’utilise sur un jeu de donnée contenant uniquement des variables numériques. Les résultats que donnent cette méthode sont :
les corrélations entre les axes factoriels et les variables du jeu de données, permettant d’interpréter nos axes. Nous n’allons pas utiliser ces corrélations ici, mais elles sont utilies si on veut comprendre la disposition des points.
carte factorielle qui représente aux mieux nos individus dans les \(q\) premières coordonnées (généralement \(q=2\), pour pouvoir les afficher sur un plan). C’est ce résultat qui nous intéresse ici.
Nous n’allons pas étudier plus en longueur cette méthode, mais comme elle permet d’afficher nos individus (définis par des variables numériques) dans un plan, nous allons l’utiliser en combinaison avec nos méthodes de clustering pour voir comment nos groupes sont constitués.
On utilise la méthode PCA() du package FactoMiner pour faire l’ACP. On va ajouter à nos coordonnées la variable catégorielle phonetique_df$Voyelle, afin de pouvoir afficher les différentes voyelles sur la projection (en précisant que c’est une variable catégorielle supplémentaire en passant son identifiant dans l’argument quali.sup) :
pca_res = PCA(cbind(phonetique_df$Voyelle, phonetique_num_df), graph=F,
              quali.sup=1)
On utilise fviz_pca_ind() de factoextra pour afficher nos individus :
fviz_pca_ind(pca_res, labels=F, habillage=1)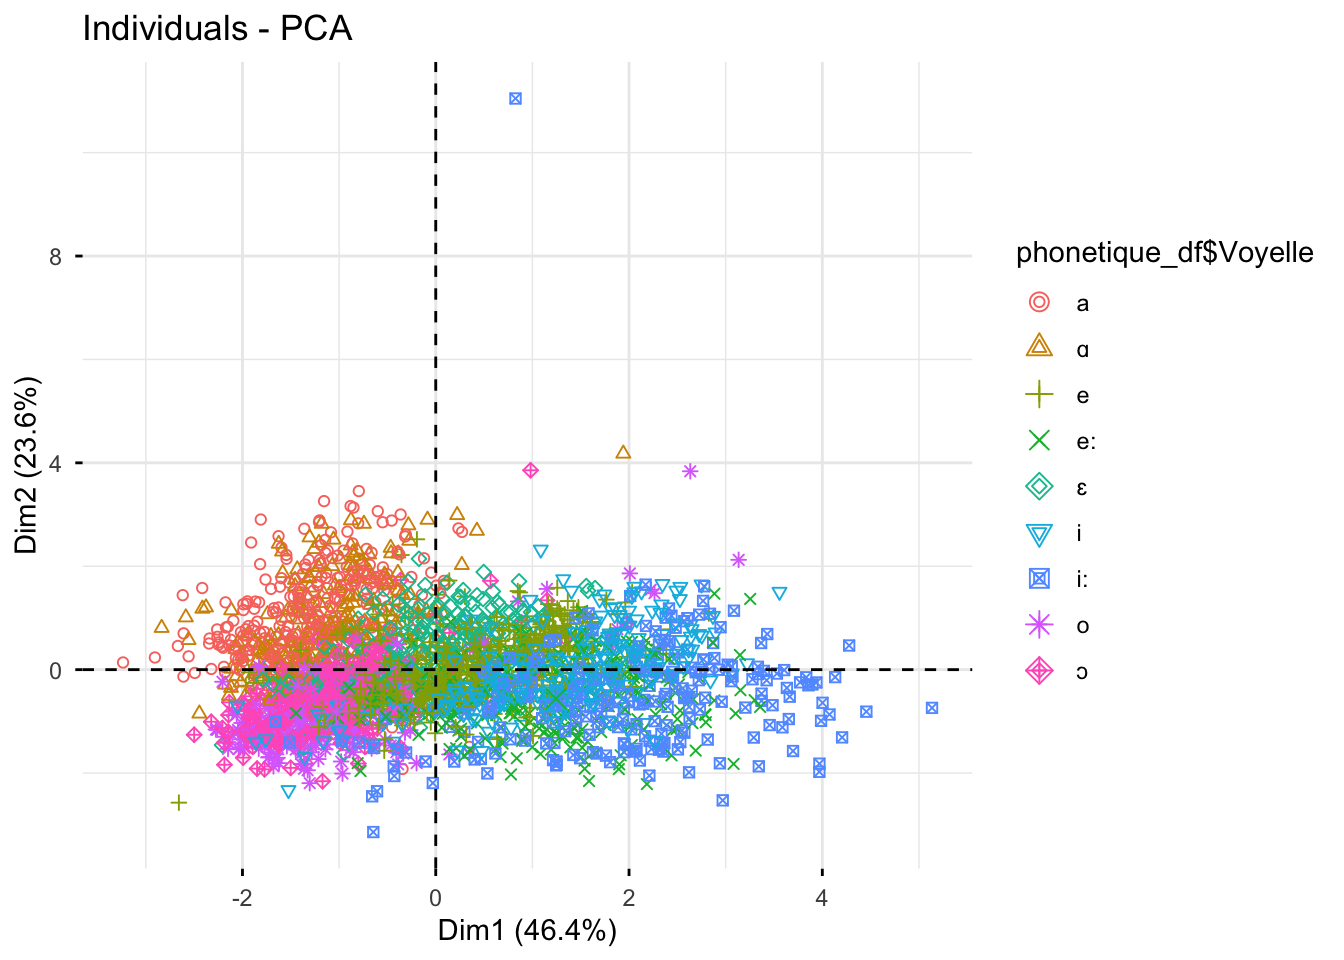
Et sur les dimensions 3 et 4 :
fviz_pca_ind(pca_res, axes=c(3, 4), labels=F, habillage=1)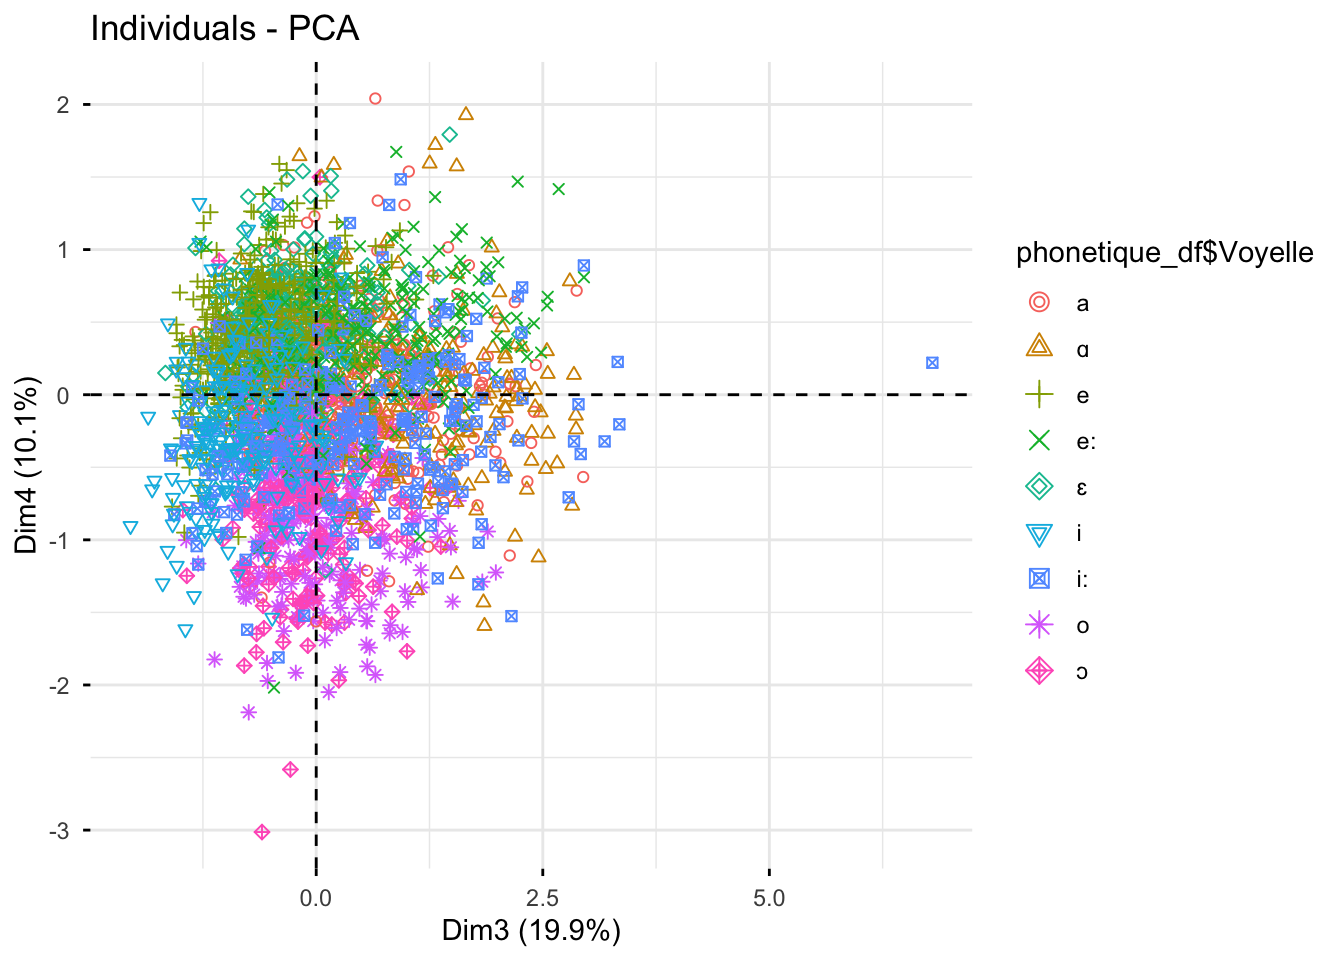
En faisant notre méthode des k-moyennes, nous allons voir si les différentes voyelles peuvent être retrouvées.
2 Les k-moyennes
2.1 Théorie
L’algorithme du k-means, ou des k-moyennes en français, est une méthode de partitionnement itérative. Son fonctionnement est assez intuitif à comprendre :
- Initialisation : L’utilisateur choisit le nombre de groupes k. L’algorithme place aléatoirement k points (les “centroïdes”) dans l’espace des données.
- Affectation : Chaque individu est assigné au centroïde le plus proche (via la distance euclidienne), formant ainsi k groupes initiaux.
- Mise à jour : L’algorithme recalcule la position exacte de chaque centroïde pour qu’il se place parfaitement au milieu (la moyenne) des individus de son groupe.
- Convergence : Puisque les centroïdes ont bougé, on recommence l’étape 2. On boucle ainsi jusqu’à ce que plus aucun individu ne change de groupe.

2.2 Application
La méthode des k-moyennes s’effectue sur un tableau de données numérique à l’aide de la fonction kmeans(). Ici, on précise dans l’argument centers, le nombre de groupes que nous désirons obtenir (en l’occurrence 9, comme le nombre de voyelles) :
kmeans_res = kmeans(phonetique_num_df, centers=9)
kmeans_res
K-means clustering with 9 clusters of sizes 148, 207, 133, 467, 267, 362, 403, 476, 275
Cluster means:
F1 F2 F3 Dur_V
1 -0.7325950 1.0447346 1.2745297 2.60794346
2 -0.6097057 1.2764687 1.8684087 -0.08351633
3 -0.5104325 0.0523920 -0.3668896 1.74986570
4 -0.4019647 0.1013062 -0.7181657 -0.38657849
5 -0.4763477 0.8936634 0.5397304 0.65749991
6 0.9441750 -0.6310123 -1.0213116 -0.53195758
7 -0.3229985 0.7551326 0.4712331 -0.55721726
8 -0.3265852 -1.5588702 -0.4571198 -0.26760487
9 2.0409259 -0.1658392 0.2257366 -0.18884761
Clustering vector:
[1] 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 3 4 8 8 8 8 8
[38] 8 8 7 7 8 8 8 8 8 8 8 8 8 8 5 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8
[75] 8 8 8 8 8 8 8 8 8 6 8 8 8 8 8 8 9 8 8 8 8 7 8 8 8 8 3 8 4 8 8 8 8 8 8 6 8
[112] 8 8 8 6 8 8 8 8 4 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 4 8 8 8 8 6 6 8 8 8 8 8 8
[149] 8 8 8 8 6 8 8 8 7 8 8 8 8 8 8 6 6 8 9 9 6 6 9 6 6 9 6 6 6 4 6 6 4 6 9 3 9
[186] 9 9 6 6 9 6 9 9 6 9 9 9 6 6 9 6 9 6 9 6 9 9 9 6 9 6 6 4 6 9 9 4 9 4 9 6 6
[223] 9 6 6 9 6 6 6 9 6 6 6 9 6 9 9 9 6 6 6 6 9 6 9 6 9 9 9 9 9 6 6 9 6 9 9 9 6
[260] 6 9 6 6 9 8 9 6 6 9 4 6 6 9 9 6 9 4 9 9 9 6 6 9 3 9 6 6 6 9 9 9 9 9 6 9 8
[297] 3 9 9 4 3 9 9 9 8 6 9 6 6 9 9 9 6 6 3 6 9 6 3 9 6 9 9 9 6 6 9 3 9 6 9 9 9
[334] 9 6 6 9 6 6 9 9 6 6 9 6 9 9 8 9 6 9 9 4 6 6 6 9 6 9 4 9 9 9 6 6 9 6 9 6 9
[371] 8 9 9 9 6 9 6 6 6 6 9 9 4 8 9 9 9 9 6 9 6 9 9 9 9 6 9 6 8 3 6 6 3 9 6 9 9
[408] 9 9 6 9 9 9 6 9 9 3 8 8 8 8 8 4 8 8 8 8 8 8 8 8 8 8 8 8 8 2 8 8 8 8 8 8 8
[445] 3 8 8 8 8 7 8 8 8 8 8 8 7 8 8 8 8 8 8 8 8 8 8 2 8 8 8 8 8 6 8 8 8 8 8 8 8
[482] 8 8 8 8 8 8 8 8 8 8 8 8 8 8 2 8 7 8 9 4 4 4 7 6 6 7 7 4 7 9 4 4 7 4 7 4 7
[519] 7 7 7 4 7 7 5 7 4 4 7 5 4 4 4 4 7 4 7 4 7 4 4 6 7 6 4 4 4 9 4 8 4 7 4 2 4
[556] 4 9 6 4 9 7 5 4 4 6 4 6 9 4 5 7 4 6 4 4 4 4 6 7 7 6 7 5 5 7 4 6 5 4 4 7 7
[593] 6 4 7 4 6 7 7 9 8 7 7 7 4 4 5 7 4 9 4 4 7 5 4 4 4 6 4 6 7 4 4 6 6 6 4 4 7
[630] 6 6 9 4 4 4 7 7 4 4 4 7 6 4 9 7 4 4 5 4 4 6 7 4 7 6 4 4 4 4 4 4 7 4 9 7 7
[667] 9 8 8 8 8 8 9 8 8 8 8 8 8 8 8 8 8 8 8 2 8 8 8 8 8 9 8 8 3 8 8 8 8 8 8 8 8
[704] 8 8 9 8 4 8 5 8 8 8 8 8 8 8 7 8 8 8 8 8 8 8 8 8 8 8 8 6 8 8 8 8 8 8 8 8 8
[741] 8 8 7 8 8 9 8 9 8 9 9 6 6 9 6 6 9 9 6 6 9 6 6 9 6 9 6 6 9 8 6 6 3 9 9 9 4
[778] 9 3 6 6 6 3 9 6 6 6 9 9 9 6 9 6 9 8 6 9 9 6 8 9 9 6 6 6 9 6 6 9 9 9 9 6 6
[815] 6 9 6 6 9 6 6 6 6 6 6 3 9 6 9 9 9 6 6 6 6 9 6 6 7 9 6 6 6 6 6 7 6 4 6 6 9
[852] 9 6 6 6 9 9 6 9 6 9 6 9 9 6 6 6 6 9 6 9 6 9 6 9 9 9 6 9 6 6 9 9 4 8 9 9 9
[889] 8 6 9 6 6 9 9 6 6 4 8 6 9 6 6 9 6 6 6 6 6 6 6 9 6 9 6 9 9 6 6 4 6 4 6 6 9
[926] 9 6 6 6 6 9 9 9 6 6 4 6 6 9 7 6 6 6 6 9 9 6 6 9 6 6 6 9 9 6 6 6 6 6 6 6 6
[963] 6 9 6 6 6 9 9 4 6 6 6 9 9 9 9 6 6 6 6 6 6 6 6 9 9 6 4 9 6 6 6 9 9 9 6 6 6
[1000] 6 6 9 9 6 6 9 6 6 6 6 6 9 9 9 9 4 4 6 6 6 9 9 4 9 9 6 6 6 6 9 9 6 6 6 6 9
[1037] 9 9 6 6 6 6 6 9 6 6 6 6 6 6 6 9 6 6 6 9 6 9 9 6 6 6 6 6 6 9 6 9 6 6 6 9 9
[1074] 6 6 9 9 6 6 6 9 9 9 4 7 4 4 5 4 4 7 7 4 4 7 7 4 7 4 7 4 2 5 7 7 4 5 7 7 7
[1111] 4 4 5 5 4 7 4 4 7 4 7 4 7 7 4 4 4 7 4 4 7 7 4 4 7 7 7 4 4 7 4 7 7 7 4 4 4
[1148] 4 4 4 2 4 5 9 7 4 5 7 7 4 7 4 7 4 7 5 9 7 7 4 4 5 7 4 2 7 4 7 5 5 7 7 5 2
[1185] 7 2 2 7 5 4 5 7 7 7 4 4 5 5 4 7 4 4 2 4 7 4 2 7 7 4 7 4 7 4 7 2 7 4 5 2 7
[1222] 7 4 4 7 4 5 7 4 7 4 7 7 4 4 7 4 5 7 7 4 5 7 5 4 2 4 7 7 2 2 7 7 4 4 5 7 5
[1259] 2 2 4 7 5 7 7 7 7 2 4 2 2 7 5 3 5 2 7 7 4 5 5 5 4 7 7 4 7 4 7 4 7 7 7 7 7
[1296] 4 7 4 7 2 7 4 5 7 7 2 4 4 5 4 7 7 5 5 7 5 7 4 4 5 3 5 7 7 4 5 7 5 7 7 4 7
[1333] 7 2 5 7 7 4 4 5 4 4 7 7 4 4 7 7 7 7 4 5 5 7 2 7 7 4 5 7 7 7 4 3 1 5 4 4 4
[1370] 4 2 4 7 4 7 4 4 4 7 4 7 4 4 7 7 4 4 7 4 4 4 4 7 4 4 7 7 4 4 5 4 4 4 7 4 7
[1407] 9 4 4 5 4 5 7 7 4 7 4 7 5 9 7 6 6 5 4 4 7 7 4 2 7 4 4 8 7 4 7 5 6 7 8 8 4
[1444] 5 5 5 2 4 5 5 5 4 4 4 4 6 4 4 4 4 6 4 6 6 6 7 4 7 7 4 4 7 4 7 4 4 4 6 3 6
[1481] 7 4 6 5 4 4 4 6 4 5 9 4 6 5 7 7 4 6 4 2 5 7 9 6 6 6 6 3 4 4 9 6 6 4 7 8 7
[1518] 4 7 4 7 4 7 4 6 5 7 4 7 4 4 7 5 4 4 4 6 9 6 7 6 7 4 4 3 6 6 7 4 4 9 4 4 4
[1555] 7 4 7 4 4 6 6 3 9 7 6 6 5 4 3 4 7 4 7 9 4 4 8 4 7 5 7 4 4 4 7 5 8 8 2 8 8
[1592] 8 8 8 8 8 8 8 8 8 8 8 8 3 2 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8
[1629] 2 8 8 8 8 8 8 8 8 8 8 8 2 7 8 8 8 4 8 8 8 8 2 8 8 8 8 8 8 8 8 8 8 8 8 8 8
[1666] 6 8 8 8 8 8 8 8 8 7 8 8 8 8 8 2 8 8 8 8 8 8 8 8 8 8 8 6 8 8 6 8 8 3 8 8 8
[1703] 8 6 8 4 8 8 8 8 8 8 8 8 8 8 8 8 8 8 8 5 8 8 8 8 6 6 8 8 8 8 8 8 8 8 8 8 8
[1740] 8 8 8 8 8 8 8 8 8 8 8 6 8 4 2 7 8 2 2 5 7 2 7 2 2 7 7 7 7 2 4 4 7 2 7 7 2
[1777] 2 5 2 4 5 5 2 4 4 4 7 4 7 2 7 2 5 2 4 2 7 2 7 8 8 2 8 4 2 8 7 7 2 7 3 8 5
[1814] 7 6 2 4 2 7 2 8 2 7 8 7 2 2 5 8 8 2 7 7 8 7 5 4 7 8 2 2 1 2 3 7 2 9 8 8 4
[1851] 5 2 8 4 3 2 7 1 3 1 1 2 3 5 1 1 3 2 3 1 8 5 1 4 1 1 1 3 2 1 1 3 5 5 5 3 3
[1888] 2 8 1 1 2 3 1 3 1 1 3 1 4 3 5 2 5 1 1 1 5 2 1 1 1 3 1 1 1 2 8 9 7 4 6 5 4
[1925] 4 2 2 4 4 5 4 7 5 4 7 3 4 2 5 4 4 5 7 4 5 4 5 5 5 4 7 7 4 7 4 7 4 2 7 5 4
[1962] 7 4 7 4 4 7 7 4 5 7 5 2 7 4 7 4 4 2 5 7 4 7 4 4 4 7 4 5 7 7 4 5 7 7 4 5 5
[1999] 7 7 7 5 7 7 4 4 7 4 3 5 7 4 4 5 4 4 5 3 2 4 4 4 5 4 3 5 5 5 5 4 4 5 5 3 5
[2036] 3 3 2 4 1 3 1 1 3 3 5 3 1 3 3 1 5 3 3 5 1 7 1 3 1 1 3 1 5 1 5 5 4 3 3 2 4
[2073] 1 1 3 3 5 5 1 3 5 3 5 1 1 1 1 7 4 4 5 4 5 7 5 4 5 5 8 4 5 5 2 5 7 5 5 7 3
[2110] 5 5 1 5 4 5 1 1 3 7 5 3 7 5 3 3 1 3 1 1 5 3 1 3 4 1 5 3 3 1 1 5 1 3 5 1 3
[2147] 1 5 5 3 1 4 3 3 2 4 1 1 3 5 1 5 1 3 5 3 1 3 5 5 7 4 4 4 3 4 5 5 7 7 4 3 2
[2184] 4 5 4 7 4 5 7 7 7 4 5 7 5 5 4 4 1 5 4 4 4 3 7 4 7 4 5 5 7 4 7 4 7 4 4 7 7
[2221] 4 5 7 7 7 4 4 7 4 4 7 5 7 4 5 4 4 4 7 4 5 7 4 4 7 7 7 4 5 6 7 4 2 5 4 4 5
[2258] 7 4 3 4 4 4 3 5 5 5 7 3 5 5 1 5 4 3 5 1 4 5 3 3 2 4 5 4 1 1 1 3 7 3 3 3 3
[2295] 1 2 5 3 1 3 2 1 3 5 3 3 5 1 3 3 1 4 3 3 5 3 5 1 3 3 4 3 1 5 5 5 5 1 5 5 4
[2332] 4 3 7 4 3 4 4 7 7 5 7 7 7 4 5 7 7 7 4 4 5 5 4 4 4 4 7 4 7 4 5 4 4 4 7 4 7
[2369] 4 4 7 7 4 5 7 7 2 4 4 7 4 4 4 5 7 4 5 4 4 4 4 4 5 7 4 7 7 4 5 7 5 7 7 4 7
[2406] 5 2 2 5 4 2 5 5 2 2 5 5 2 2 7 4 7 2 7 5 4 2 7 5 8 2 2 2 4 5 2 2 7 7 7 7 4
[2443] 7 7 7 2 2 2 2 7 5 2 4 5 2 2 5 5 2 2 2 4 2 4 3 2 5 2 7 2 4 7 7 2 2 2 7 7 7
[2480] 7 7 2 2 2 9 7 7 2 2 2 2 7 4 2 2 3 7 2 5 5 2 7 7 2 7 2 5 2 3 3 7 1 2 2 1 1
[2517] 3 5 1 1 5 2 5 1 2 3 2 1 1 1 1 1 2 3 1 3 1 2 2 5 1 1 2 1 1 2 3 1 1 1 1 5 5
[2554] 4 1 5 2 1 2 1 5 5 5 1 1 3 3 1 2 1 1 1 2 2 7 7 2 4 1 2 2 7 2 2 7 7 2 5 2 8
[2591] 2 7 5 7 1 2 1 1 1 3 5 1 1 5 5 1 1 5 1 1 5 1 1 1 1 2 1 1 3 1 7 2 3 5 1 2 1
[2628] 3 1 1 3 1 1 1 5 2 5 1 5 2 1 1 1 5 5 3 1 1 1 1 1 5 3 1 1 2 2 5 4 2 2 1 2 2
[2665] 7 5 2 7 7 2 7 2 7 2 2 2 7 5 5 2 5 2 4 5 5 1 7 2 7 7 5 7 2 4 2 2 2 4 2 5 7
[2702] 7 4 2 2 7 5 5 2 2 5 4 2 7 5 2 2 7 2 7 7 7 2 2 2 2 5 7 4 2 5 2 4 5 2 5 2 2
Within cluster sum of squares by cluster:
[1] 224.9662 223.9077 200.2262 327.0422 221.0258 438.5387 333.0806 525.1417
[9] 558.4430
(between_SS / total_SS = 72.1 %)
Available components:
[1] "cluster" "centers" "totss" "withinss" "tot.withinss"
[6] "betweenss" "size" "iter" "ifault" En affichant le retour de cette fonction, la dernière ligne nous dit ce que l’on peut obtenir de cette variable. Nous allons sauvegarder ici les groupes attribués aux différents points avec kmeans_res$cluster :
clust_res = kmeans_res$clusterAffichons ces groupes dans l’espace avec une ACP :
pca_kmeans_res = PCA(cbind(clust_res, phonetique_num_df), graph=F,
                     quali.sup=1)
fviz_pca_ind(pca_kmeans_res, labels=F, habillage=1)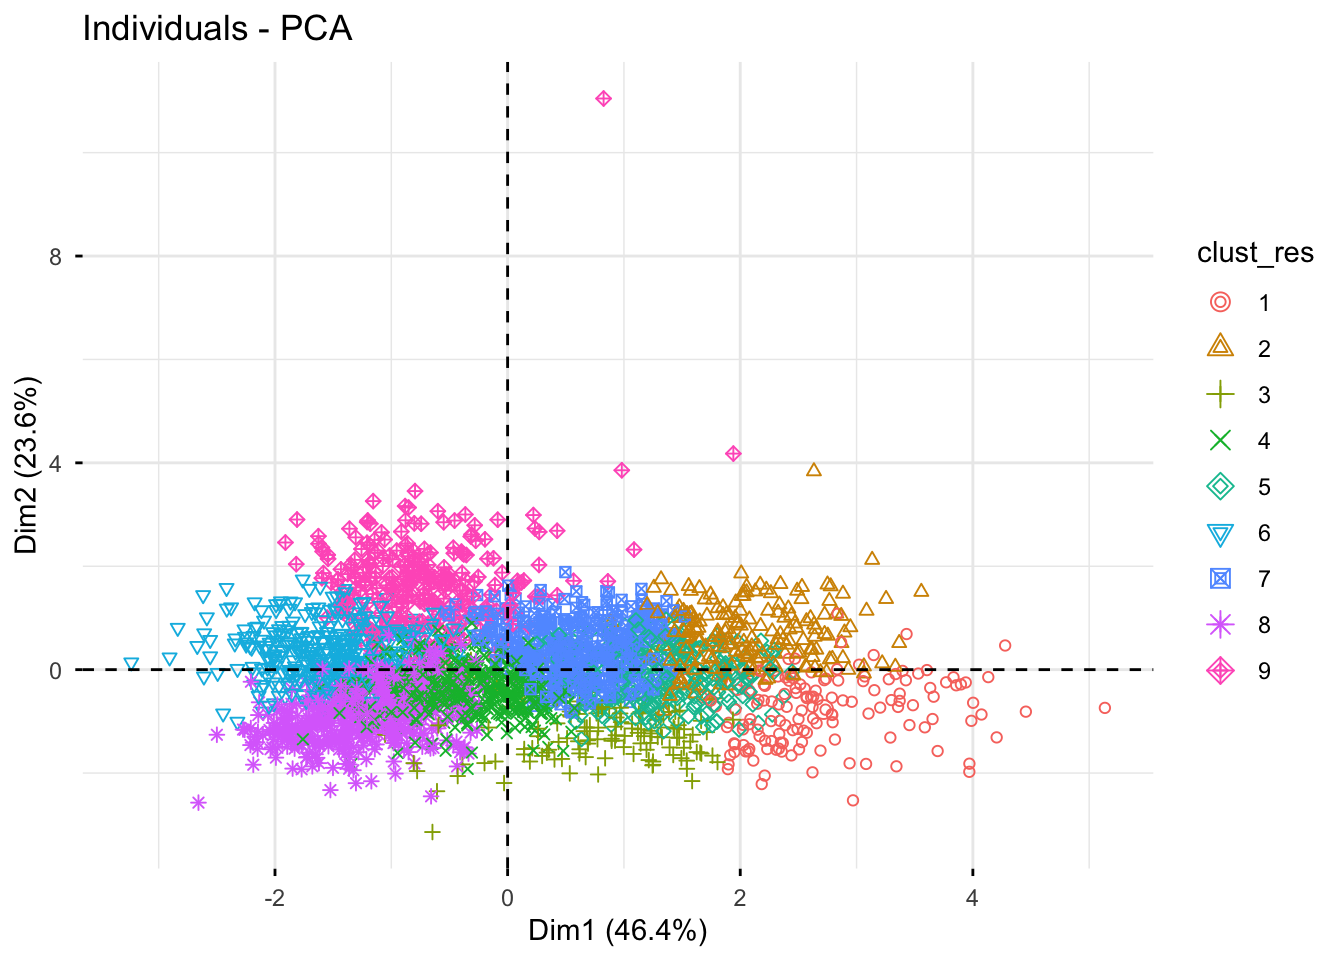
fviz_pca_ind(pca_kmeans_res, axes=c(3, 4), labels=F, habillage=1)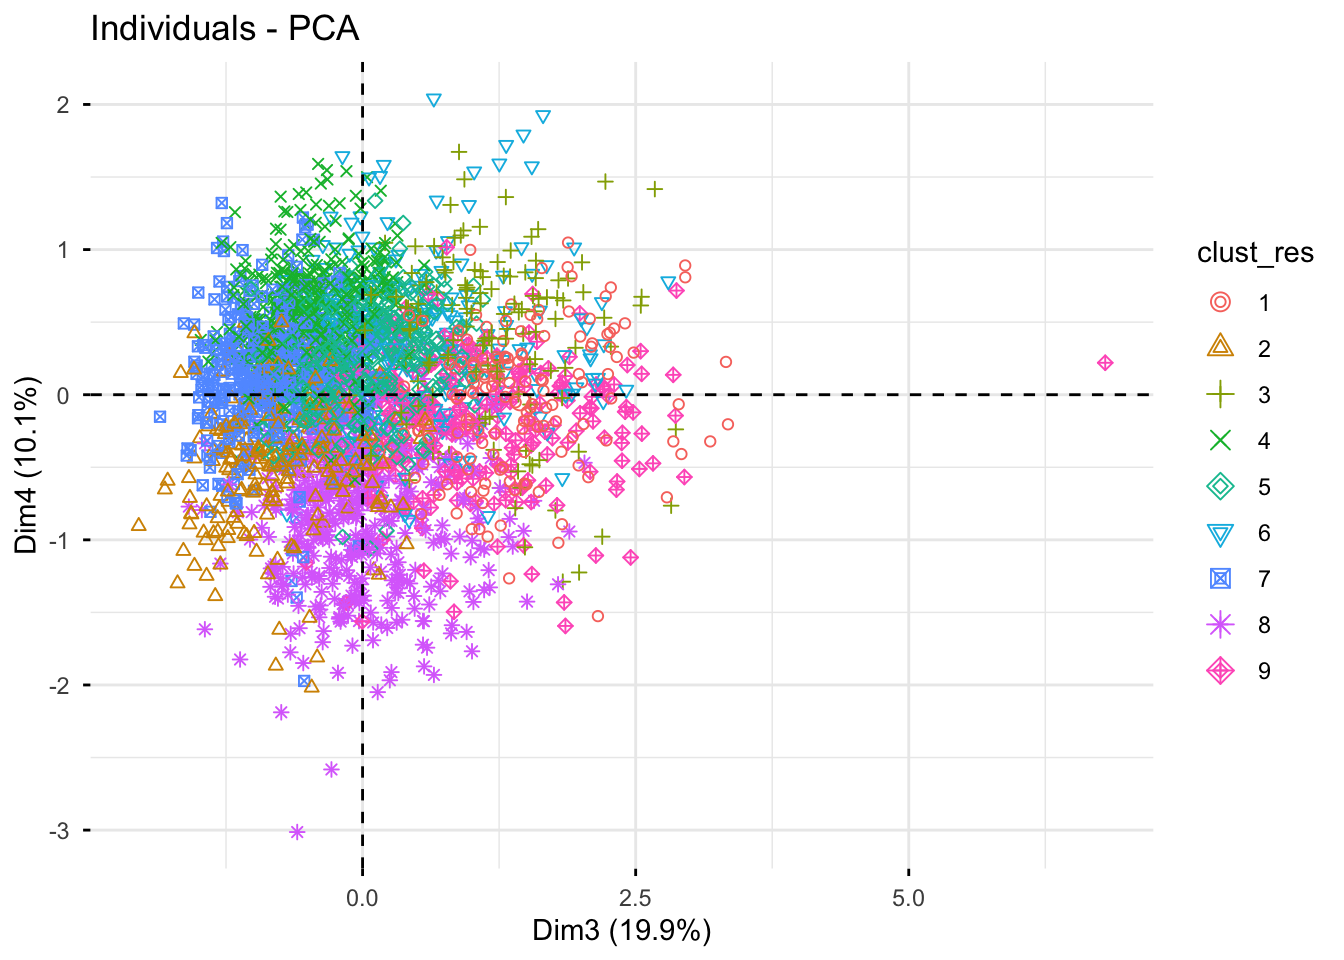
On peut aussi utiliser fviz_cluster() de factoextra, qui trace des zones sur les différents groupes :
fviz_cluster(kmeans_res, data=phonetique_num_df)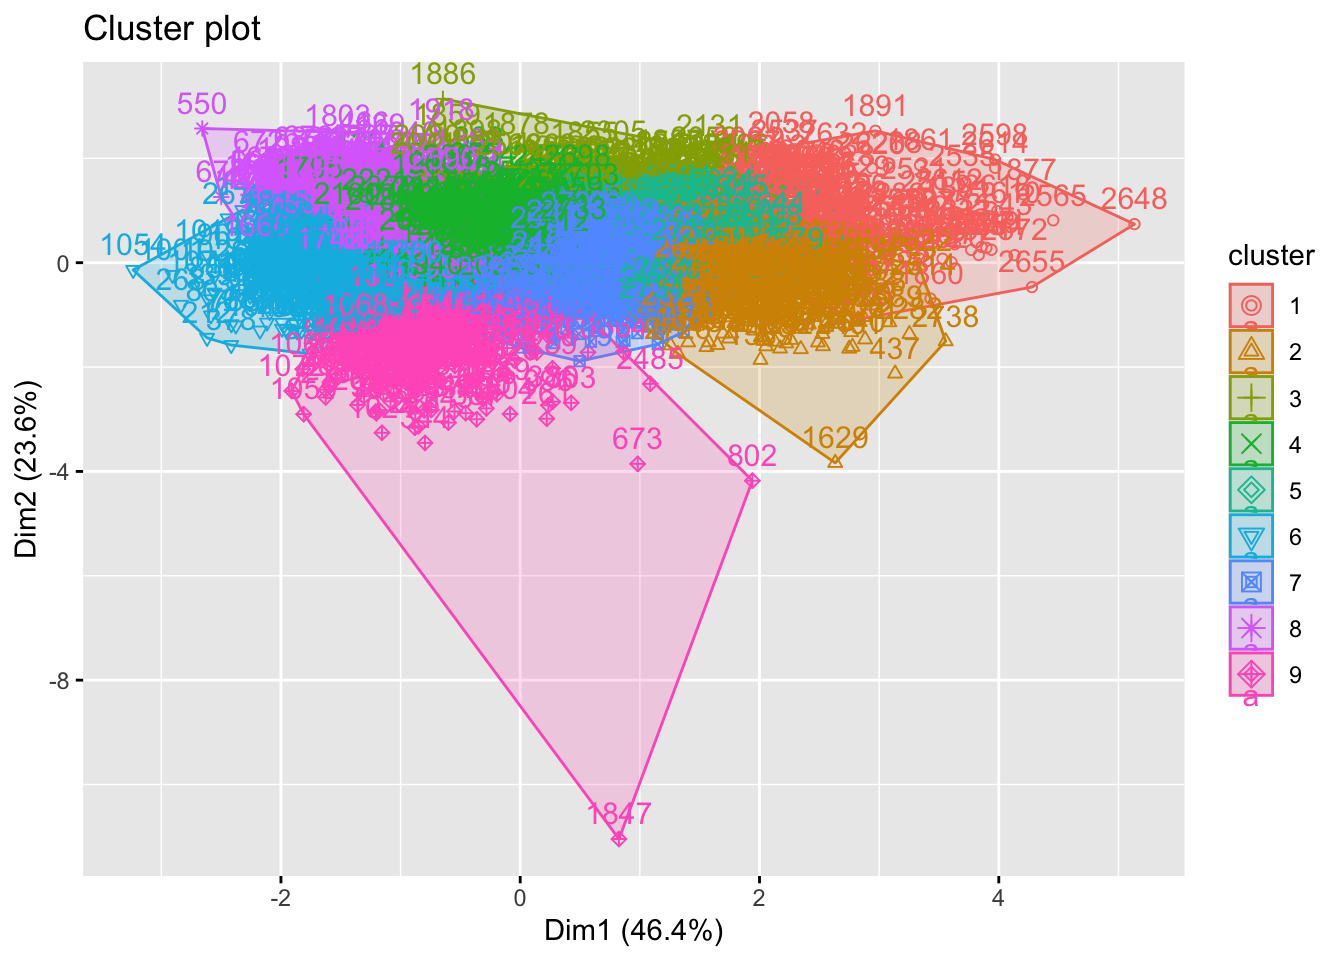
On voit que ces groupes diffèrent de nos voyelles (ce qui est attendu, l’information utilisée pour le k-means n’est pas confondue avec la “définition” de ces dernières), , mais il est difficile de se rendre compte de l’information partagée par ces deux regroupements. Nous allons donc voir maintenant comment mesurer la part d’association entre ces clusters et les voyelles.
2.3 Comparaison entre partitions
Afin de voir si le résultat de notre clustering et les voyelles sont associés, on peut, pour commencer, examiner la table de contingence formée par ces deux partitions :
contingency_table = table(phonetique_df$Voyelle, clust_res)
contingency_table
clust_res
1 2 3 4 5 6 7 8 9
a 0 0 3 16 0 173 1 4 137
ɑ 0 0 10 7 0 116 2 9 106
e 1 33 9 215 94 26 188 4 10
e: 50 8 65 37 69 0 14 1 0
ɛ 1 4 5 148 27 29 104 3 14
i 2 100 2 28 37 1 66 12 1
i: 94 52 32 8 37 0 17 8 1
o 0 8 4 3 1 2 6 226 0
ɔ 0 2 3 5 2 15 5 209 6Notez que les groupes sont anonymes, ce qui veut dire que l’on ne sait pas comment relier chaque cluster à chaque voyelle. Il existe cependant des manières de mesurer l’accord entre deux partitions sans relier explicitement chaque groupe à chaque voyelle.
Par exemple, en effectuant un test du chi2 sur cette table, on peut voir que ces deux partitions partagent une information commune significative :
chisq.test(contingency_table)
    Pearson's Chi-squared test

data:  contingency_table
X-squared = 5776.9, df = 64, p-value < 2.2e-16
Il existe en réalité de nombreux indices pour évaluer l’information commune de deux partitions. Le chi2 en est une, mais peut poser problème car sa valeur n’est pas bornée et dépend du nombre de classes dans les deux partitions.
Un autre indice souvent utilisé pour mesure l’accord entre deux partitions est la Adjusted Mutual Information (NMI). Cette mesure est comprise entre 0 et 1 avec 0 si les deux partitions ne sont pas du tout liées et 1 si elles sont identiques. On peut obtenir cette mesure avec la fonction AMI() du package aricode (ce package contient de nombreuses autres mesures) :
AMI(as.factor(phonetique_df$Voyelle), clust_res)[1] 0.39621632.4 Nombre de groupes inconnu
Parfois, on cherche à effectuer un clustering exploratoire, sans connaitre à priori le nombre de groupes à assigner aux données. Il existe alors de nombreux critères qui permettent d’évaluer la pertinence d’une partition, c’est-à-dire sa capacité à séparer de manière distincte nos données.
Un des critères les plus utilisé est le Average Silhouette Width (AWS), qui mesure à quel point les données sont proches à l’intérieur des clusters, et éloignés entre les clusters. En utilisant la fonction fviz_nbclust() de factoextra, qui attend notre jeu de données et une méthode de clustering, on peut avoir la valeur du AWS en fonction du nombre de groupes :
fviz_nbclust(phonetique_num_df, kmeans)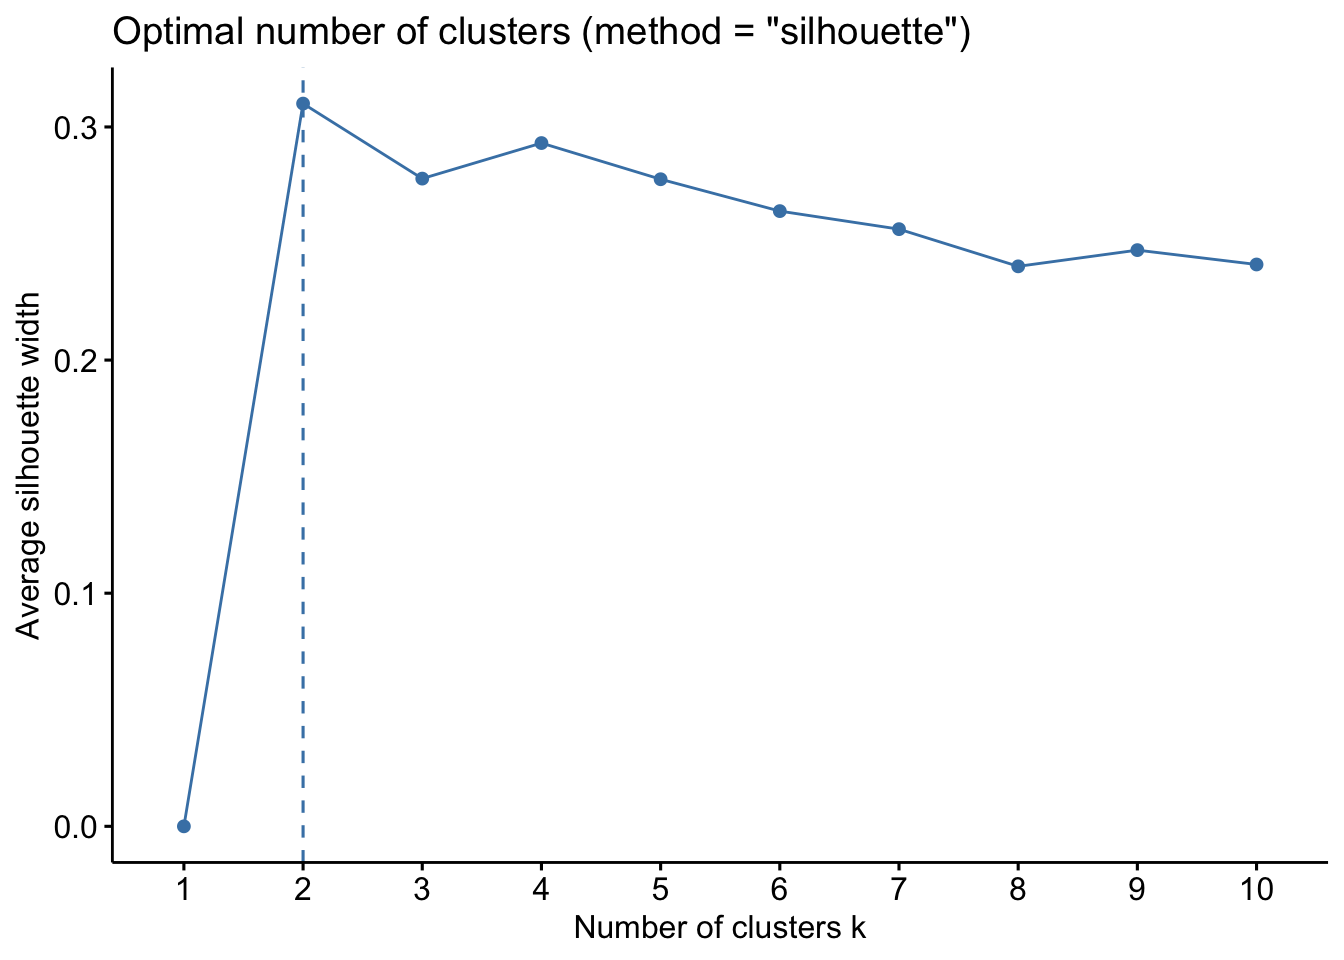
On voit ici que le nombre de groupes optimal selon ce critère est 2. Effectuons donc un k-means avec ce nombre de groupes :
kmeans_2g_res = kmeans(phonetique_num_df, centers=2)
clust_2g_res = kmeans_2g_res$cluster
Et observons le résultat sur notre jeu de données :
fviz_cluster(kmeans_2g_res, data=phonetique_num_df)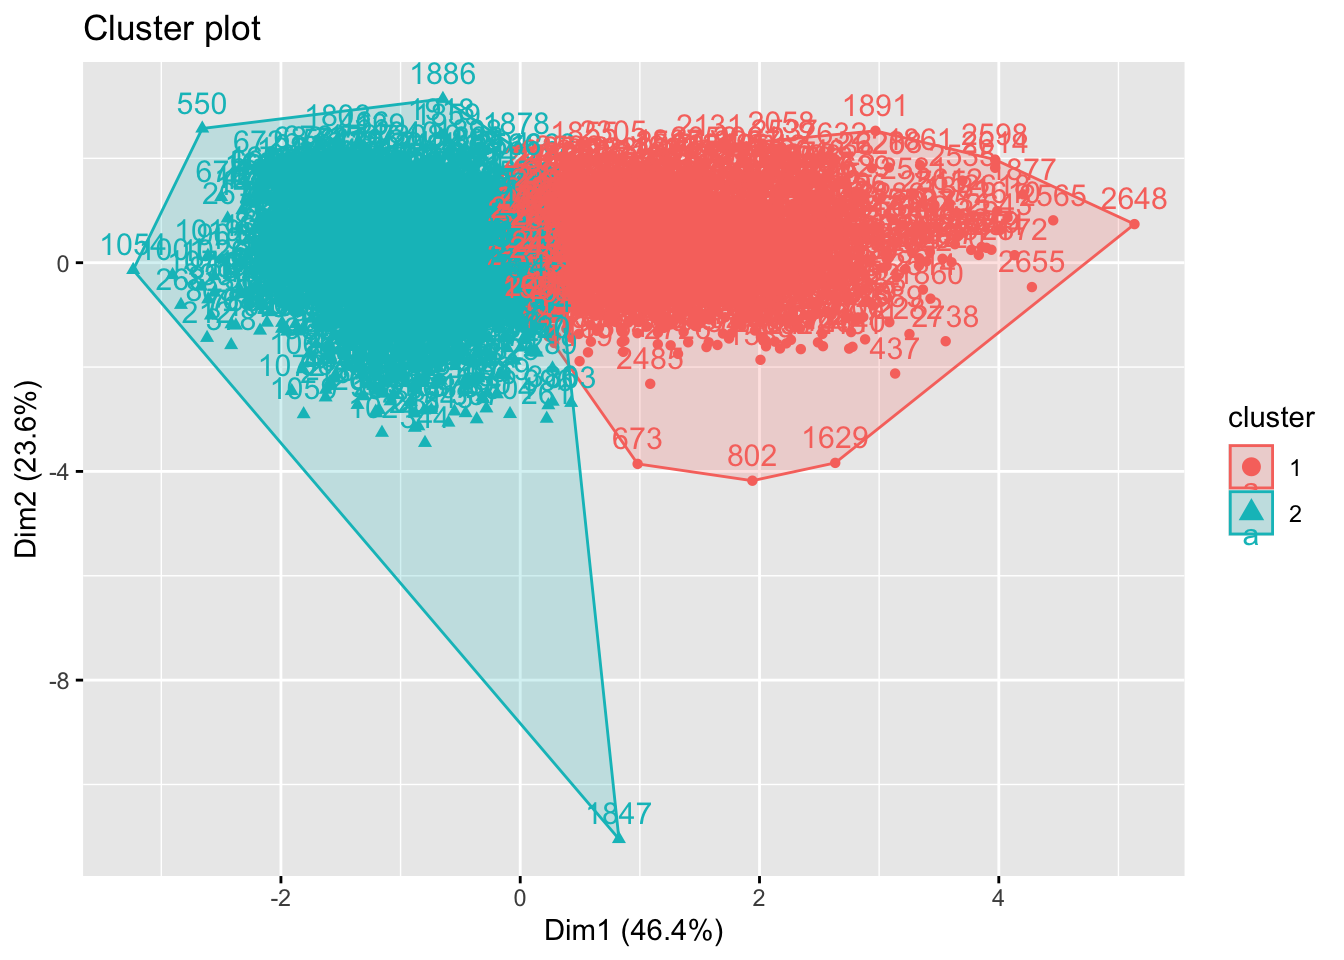
On peut maintenant regarder l’accord maximal de cette partition selon plusieurs de nos variables catégorielles :
chisq.test(table(phonetique_df$Opposition, clust_2g_res))
    Pearson's Chi-squared test

data:  table(phonetique_df$Opposition, clust_2g_res)
X-squared = 1516.2, df = 5, p-value < 2.2e-16AMI(as.factor(phonetique_df$Opposition), clust_2g_res)[1] 0.188869chisq.test(table(phonetique_df$Voyelle, clust_2g_res))
    Pearson's Chi-squared test

data:  table(phonetique_df$Voyelle, clust_2g_res)
X-squared = 1482.5, df = 8, p-value < 2.2e-16AMI(as.factor(phonetique_df$Voyelle), clust_2g_res)[1] 0.1539529chisq.test(table(phonetique_df$Mot, clust_2g_res))
    Pearson's Chi-squared test

data:  table(phonetique_df$Mot, clust_2g_res)
X-squared = 1607.8, df = 32, p-value < 2.2e-16AMI(as.factor(phonetique_df$Mot), clust_2g_res)[1] 0.1035715chisq.test(table(phonetique_df$Tache, clust_2g_res))
    Pearson's Chi-squared test with Yates' continuity correction

data:  table(phonetique_df$Tache, clust_2g_res)
X-squared = 131.7, df = 1, p-value < 2.2e-16AMI(as.factor(phonetique_df$Tache), clust_2g_res)[1] 0.05203811chisq.test(table(phonetique_df$Region, clust_2g_res))
    Pearson's Chi-squared test

data:  table(phonetique_df$Region, clust_2g_res)
X-squared = 9.5096, df = 4, p-value = 0.04955AMI(as.factor(phonetique_df$Region), clust_2g_res)[1] 0.0006472196chisq.test(table(phonetique_df$Sexe, clust_2g_res))
    Pearson's Chi-squared test with Yates' continuity correction

data:  table(phonetique_df$Sexe, clust_2g_res)
X-squared = 105.38, df = 1, p-value < 2.2e-16AMI(as.factor(phonetique_df$Sexe), clust_2g_res)[1] 0.02795475On voit que ces deux groupes semblent recouper partiellement les modalités de la variable Opposition. La table de contingence peut alors nous aider à interpréter ces clusters :
table(phonetique_df$Opposition, clust_2g_res) clust_2g_res
1 2
A 3 581
E-Autre 219 117
E-FC 94 241
e(:) 374 114
i(:) 454 44
O 26 4713 Classification ascendante hiérarchique
3.1 Théorie
Contrairement au k-means qui force à fixer \(k\) dès le départ, la Classification ascendante hiérarchique (CAH) propose une approche différente, qui se base sur une matrice de dissimilarité entre individus calculée en amont :
Au départ, chaque individu est considéré comme son propre groupe (ici, 50 groupes).
L’algorithme cherche les deux individus les plus proches (dissimilarité minimale) et les fusionne.
Les distances sont recalculées entre le nouveau groupe formé et les autres individus restants, en fonction d’un critère de liaison (p.ex. : saut minimal, saut maximal, méthode de Ward).
L’algorithme boucle sur l’étape 2 et 3 jusqu’à ce que tous les individus soient agglomérés dans un seul groupe.
Le résultat final illustre toutes les étapes de cet algorithme sous la forme d’un arbre de classification hiérarchique : le dendrogramme, que l’on peut a posteriori couper à la hauteur désirée pour obtenir nos groupes.
3.2 Création du jeu de données sur les locuteurs
Pour illustrer la classification ascendante hiérarchique, nous allons nous intéresser aux locuteur du jeu de données. Nous allons donc modifier notre jeu de données pour avoir sur chaque ligne un locuteur, et les variables seront constituées du Premier formant et de la Durée sur chaque voyelle (On garde également la variable Region, pour pouvoir comparer avec nos résultats) :
locuteur_df = phonetique_df %>%
  group_by(Voyelle, Locuteur) %>%
  summarise(F1=mean(F1), Dur_V=mean(Dur_V), Region=max(Region)) %>%
  pivot_wider(names_from=Voyelle, values_from=c(F1, Dur_V))
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by Voyelle and Locuteur.
ℹ Output is grouped by Voyelle.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(Voyelle, Locuteur))` for per-operation grouping
(`?dplyr::dplyr_by`) instead.locuteur_df# A tibble: 84 × 20
Locuteur Region F1_a F1_e `F1_e:` F1_i `F1_i:` F1_o F1_ɑ F1_ɔ F1_ɛ
<chr> <chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 74bac1 HauteSavo… 808. 592. 486 372. 342 431 761. 476. 619
2 74bag1 HauteSavo… 704 494 420 407. 463. 390. 750 408. 542.
3 74bam1 HauteSavo… 554 379. 349 278 284. 385. 568. 382 480.
4 74bbb1 HauteSavo… 586. 422. 364. 283. 293. 377 584. 397 480.
5 74bdc1 HauteSavo… 757. 434. 476. 350 365. 436. 743. 544. 472
6 74bem1 HauteSavo… 620. 377. 355. 248. 245. 369. 600. 409. 402.
7 74bgs1 HauteSavo… 678 379 351. 208 209. 351. 649. 358. 440
8 74blm1 HauteSavo… 730. 462. 410. 371 347. 497 664 717 529.
9 74bmc1 HauteSavo… 671. 464. 423 353. 371 458. 786. 425. 552.
10 74bpf1 HauteSavo… 531 403. 395. 305 283 417 554. 420. 460.
# ℹ 74 more rows
# ℹ 9 more variables: Dur_V_a <dbl>, Dur_V_e <dbl>, `Dur_V_e:` <dbl>,
# Dur_V_i <dbl>, `Dur_V_i:` <dbl>, Dur_V_o <dbl>, Dur_V_ɑ <dbl>,
# Dur_V_ɔ <dbl>, Dur_V_ɛ <dbl>On construit également le tableau des variables numériques standardisées :
locuteur_num_df = locuteur_df %>%
  select(-c(Locuteur, Region)) %>%
  scale() %>%
  as_tibble()
Et on sauvegarde le nombre de locuteurs, qui va nous servir par la suite :
n = dim(locuteur_df)[1]3.3 Classification ascendante hiérarchique
Pour effectuer une classification ascendante hiérarchique (CAH), on doit au préalable construire une matrice de dissimilarités. On peut en obtenir plusieurs grâce à la fonction dist(), qui construit des dissimilarités différentes selon l’argument entré dans method (ici, la distance euclidienne) :
dist_mat = dist(locuteur_num_df, method = "euclidean")La CAH s’effectue avec la fonction hclust(), où l’on doit préciser la méthode d’aggrégation dans method :
hclust_res = hclust(dist_mat, method="ward.D2")Pour construire le dendrogramme à partir du résultat, on utilise as.dendrogram() :
dendrogram = as.dendrogram(hclust_res)Qui s’affiche ensuite avec la fonction plot() :
plot(dendrogram)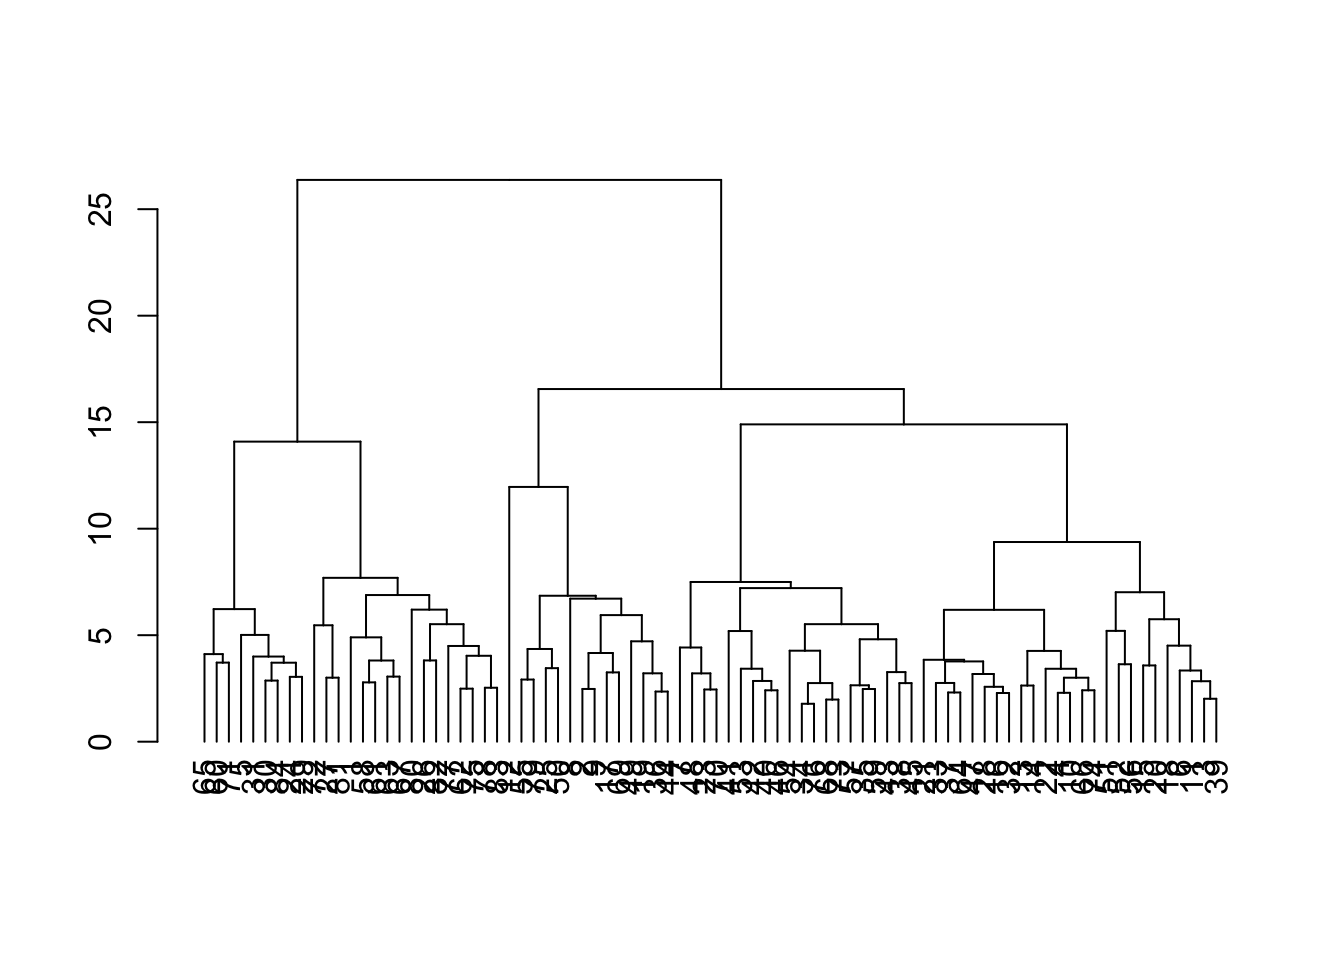
Ce dendrogramme illustre tout le processus agglomératif. Pour obtenir une partition en particulier, on va procéder à une coupe.
3.4 Coupe du dendrogramme
Pour commencer, posons le nombre de groupes que nous désirons obtenir. Ici, un nombre de groupes identique au nombre de régions :
k = 5L’assignation des locuteurs dans les groupes, relativement à notre dendrogramme et à notre nombre de groupes, s’obtient avec cutree() :
groups = cutree(dendrogram, k=k)
groups
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26
1 2 3 3 4 3 5 2 2 3 3 2 3 3 3 3 2 3 2 3 3 3 5 4 2 1
27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52
1 3 4 4 4 3 3 5 5 2 3 5 3 5 5 5 5 2 5 5 3 5 2 2 3 3
53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78
5 5 2 3 5 1 5 4 1 1 1 3 4 3 1 5 2 5 4 1 5 3 1 5 1 1
79 80 81 82 83 84
2 1 1 1 1 4 Avec la librairie dendextend, il nous est possible de personnaliser l’apparence du dendrogramme grâce à la fonction set(). Cette fonction permet de modifier de nombreux éléments de dendrogramme (voir l’aide ou http://www.sthda.com/english/wiki/beautiful-dendrogram-visualizations-in-r-5-must-known-methods-unsupervised-machine-learning). Ici, nous allons uniquement colorer les 5 branches principales du dendrogramme (c’est-à-dire notre coupe) :
dendrogram %>%
  set("branches_k_color", k=k) %>%
  plot()
Le chargement a nécessité le package : colorspace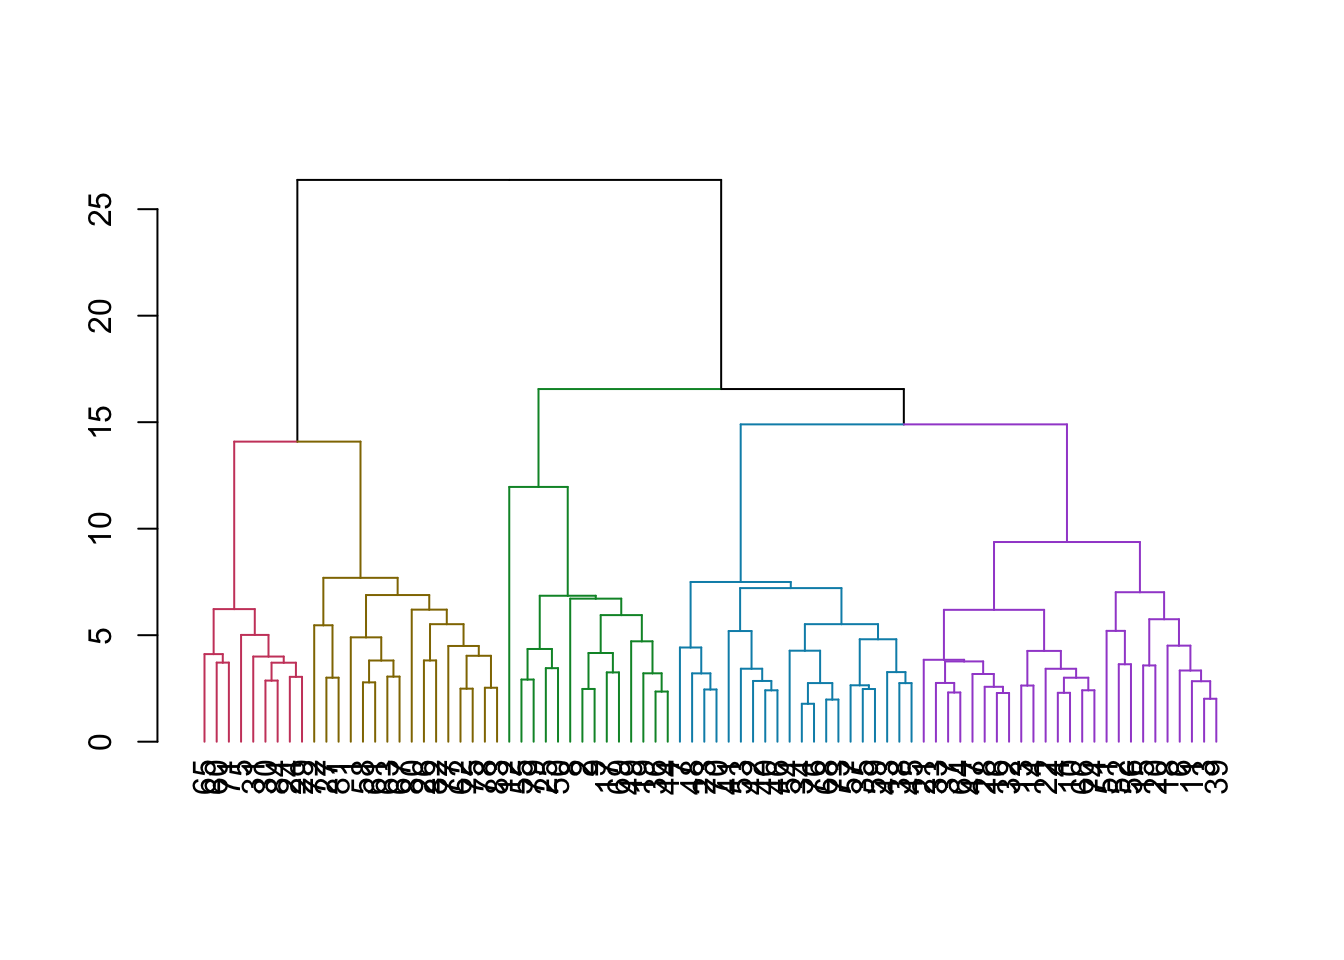
La hauteur à laquelle la coupe à été effectuée s’obtient grâce à un calcul effectué à l’aide du vecteur hclust_res$height :
cutline_height = (hclust_res$height[n-k] + hclust_res$height[n-k+1]) / 2On peut ensuite l’ajouter à notre dendrogramme avec abline() :
dendrogram %>%
  set("branches_k_color", k=k) %>%
  plot()
abline(h=cutline_height, lty=2)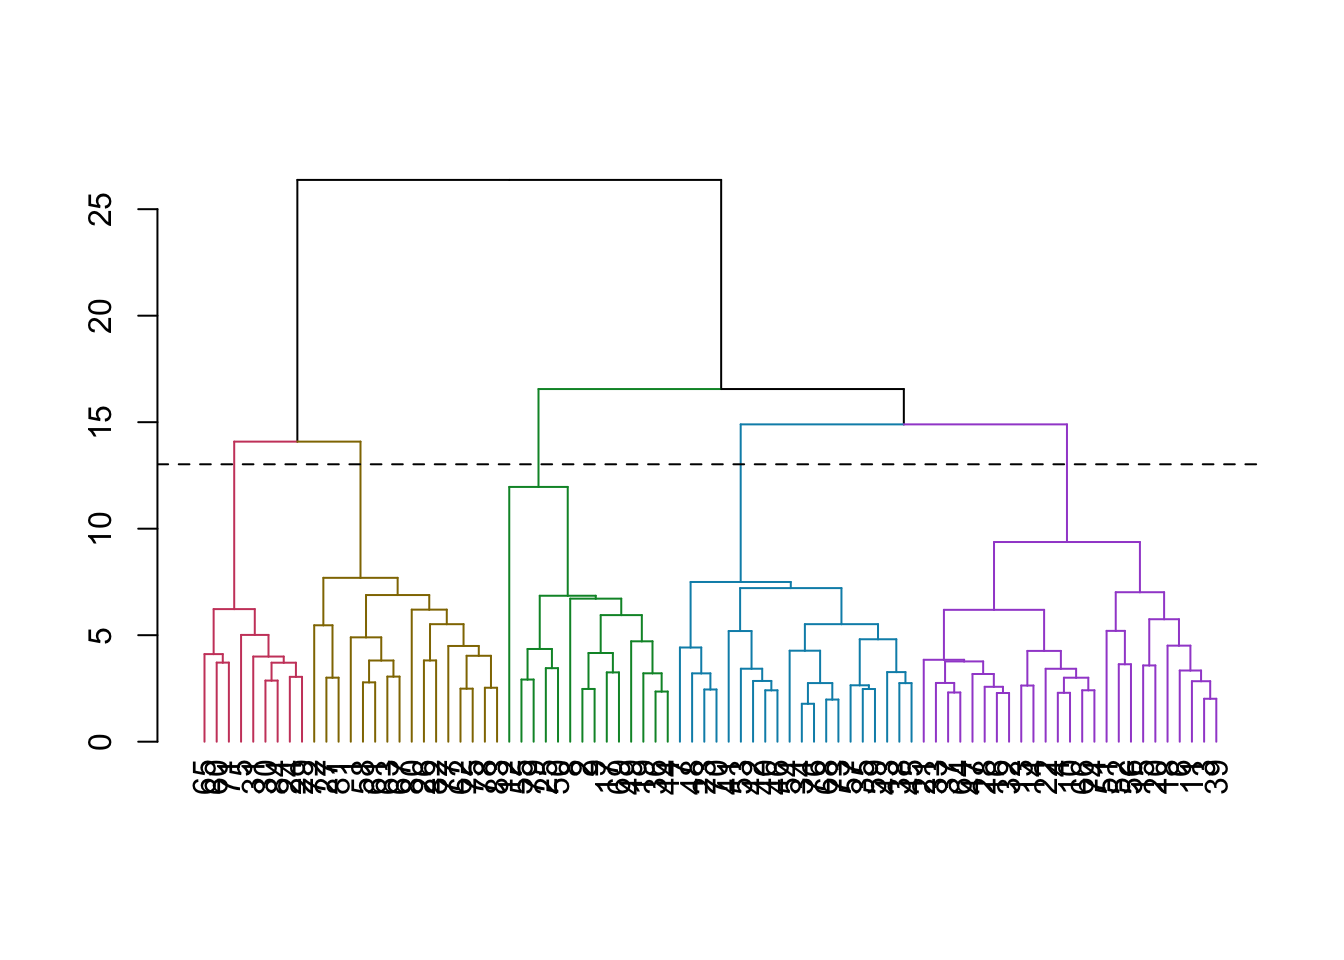
3.5 Comparaison avec les régions
Nous allons comparer notre partition obtenue avec les régions, que nous sauvons dans un nouveau vecteur par commodité :
region = locuteur_df$RegionOn voit que l’information partagée est non-négligeable, mais loin d’être parfaite :
contingency_table = table(region, groups)
contingency_table
groups
region 1 2 3 4 5
Geneve 0 5 6 0 10
HauteSavoie 1 6 13 1 1
Joux 5 0 2 2 3
Martigny 8 2 1 2 3
Neuchatel 2 1 3 4 3chisq.test(contingency_table)Warning in chisq.test(contingency_table): L’approximation du Chi-2 est
peut-être incorrecte
    Pearson's Chi-squared test

data:  contingency_table
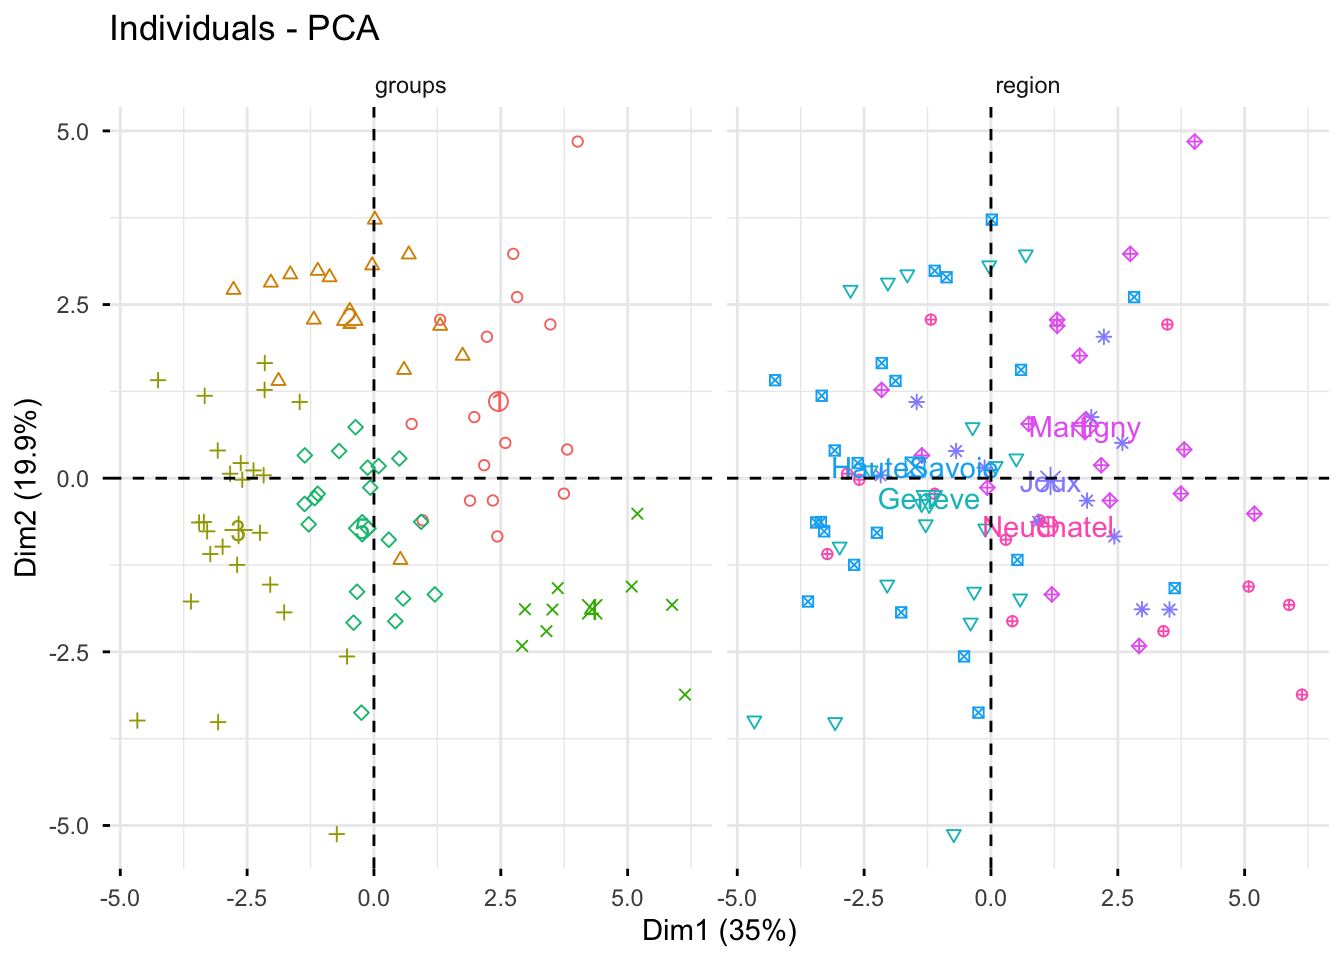
X-squared = 49.908, df = 16, p-value = 2.371e-05AMI(as.factor(region), groups)[1] 0.1493773Nous allons maintenant illustrer ces deux partitions avec une ACP. On ajoute à notre jeu de données numérique nos variables de groupes :
pca_hclust_res = PCA(cbind(region, groups, locuteur_num_df), graph=F,
                     quali.sup=c(1, 2))
On peut maintenant afficher ces deux partitions simultanément :
fviz_pca_ind(pca_hclust_res, labels=F, habillage=c(1, 2))