library(tidyverse)
library(readxl)
library(FactoMineR)
library(factoextra)1 Introduction
Dans ce TP, nous allons voir comment effectuer une Analyse des correspondances multiples (ACM) avec FactoMineR et factoextra. Cette méthode généralise l’analyse factorielle des correspondances en permettant de représenter plusieurs variables catégorielles en même temps.
La première étape (faite de manière sous-jacente, pas besoin de le faire explicitement) consiste à transformer ce jeu de données en tableau disjonctif complet, en recodant les variables catégorielles avec des dummies :
| Individu | Genre | Transport |
|---|---|---|
| P1 | Homme | Vélo |
| P2 | Femme | Voiture |
| P3 | Homme | Bus |
| Individu | Femme | Homme | Bus | Vélo | Voiture |
|---|---|---|---|---|---|
| P1 | 0 | 1 | 0 | 1 | 0 |
| P2 | 1 | 0 | 0 | 0 | 1 |
| P3 | 0 | 1 | 1 | 0 | 0 |
L’ACM n’est ensuite rien d’autre qu’une AFC appliquée sur ce tableau disjonctif complet. Ce tableau est donc considéré comme une table de contingence individus \(\times\) modalités. Cette approche a plusieurs conséquences :
- Biplot individus-modalités : Contrairement à l’AFC qui croise deux variables, l’ACM permet de projeter les individus avec les modalités. On peut ainsi voir les attractions entre individus et modalités.
- Calculs sur les variables : On peut calculer des quantités sur un groupe de modalités faisant partie d’une même variable, permettant ainsi de comprendre l’effet global d’une variable.
- Poids des variables : Les variables possédant plus de modalités ont une inertie plus forte. Il est donc parfois nécessaire de regrouper les modalités avant l’analyse, pour avoir des variables avec un nombre de modalités équivalent.
Nous allons voir tous ces concepts plus en détail avec la pratique.
Les librairies nécessaires sont les suivantes :
2 L’analyse des correspondances multiples
2.1 Chargement et pré-traitements
Commençons par charger le jeu de données de pragmatique :
pragmatique_df = read_excel("data/pragmatique.xlsx")Pour illustrer l’ACM, nous allons voir les relations qui existent entre les variables Type morpho-syntaxique, Position du marqueur dans l'UCT et Direction. Certaines de ces variables nécessitent un léger pré-traitement.
La variable Position du marqueur dans l'UCT, possède les modalités "début*" et "fin*", qui indiquent que le marqueur est “presque” dans cette position, mais qu’il y a un petit élément de langage (p.ex. “heu”, “ben”) qui précède ou succède au marqueur. Dans ce TP, pour simplifier l’analyse, nous allons considérer ces modalités comme étant identiques à leur équivalent sans étoile.
La variable Direction, quant à elle, possède une modalité "à l’intérieur", qui diffère de "à l'intérieur" de par son apostrophe. Nous allons corriger cette erreur.
Ces recodages s’effectuent avec la fonction recode(), et nous en profitons pour nommer les variables recodées avec un nom plus facile d’utilisation :
pragmatique_df = pragmatique_df %>%
  mutate(Type = `Type morpho-syntaxique`,
         Position = recode(`Position du marqueur dans l'UCT`,
                           "début*" = "début",
                           "fin*" = "fin"),
         Direction = recode(Direction, "à l’intérieur" = "à l'intérieur"))
On va maintenant créer un jeu de données contenant uniquement nos variables étudiées :
pragmatique_red_df = pragmatique_df %>%
  select(Type, Position, Direction)
2.2 L’ACM avec FactoMineR
Pour effectuer l’analyse des correspondances multiples, on utilise la fonction MCA() :
mca_res = MCA(pragmatique_red_df, graph=F)
mca_res
**Results of the Multiple Correspondence Analysis (MCA)**
The analysis was performed on 321 individuals, described by 3 variables
*The results are available in the following objects:
name description
1 "$eig" "eigenvalues"
2 "$var" "results for the variables"
3 "$var$coord" "coord. of the categories"
4 "$var$cos2" "cos2 for the categories"
5 "$var$contrib" "contributions of the categories"
6 "$var$v.test" "v-test for the categories"
7 "$var$eta2" "coord. of variables"
8 "$ind" "results for the individuals"
9 "$ind$coord" "coord. for the individuals"
10 "$ind$cos2" "cos2 for the individuals"
11 "$ind$contrib" "contributions of the individuals"
12 "$call" "intermediate results"
13 "$call$marge.col" "weights of columns"
14 "$call$marge.li" "weights of rows" Le retour de cette fonction nous donne plusieurs quantités, dont la plupart similaires à l’AFC. Cependant, on trouve d’autres résultats, comme par exemple le tableau disjonctif, qui a servi de base à l’ACM :
head(mca_res$call$Xtot) construction attributive à verbe copule parenthétique
1 1 0
2 1 0
3 1 0
4 1 0
5 1 0
6 1 0
prédicat verbal à complément proposition complète syntagme adverbial début
1 0 0 0 0
2 0 0 0 1
3 0 0 0 0
4 0 0 0 1
5 0 0 0 0
6 0 0 0 1
fin milieu totalité à l'intérieur marqueur>portée portée<marqueur
1 0 1 0 1 0 0
2 0 0 0 1 0 0
3 0 1 0 1 0 0
4 0 0 0 0 0 1
5 0 1 0 1 0 0
6 0 0 0 1 0 0Ce tableau illustre bien le principe de recodage binaire de variables catégorielles. Une variable catégorielle avec \(m\) modalités peut être recodée par \(m\) colonnes représentant \(m\) variables binaires. Si l’individu possède la modalité \(i\), alors un 1 sera présent dans la colonne correspondante, et 0 dans les colonnes des autres modalités.
Le résultat principal de l’ACM est le biplot, qui s’obtient avec fviz_mca_biplot() de factoextra :
fviz_mca_biplot(mca_res)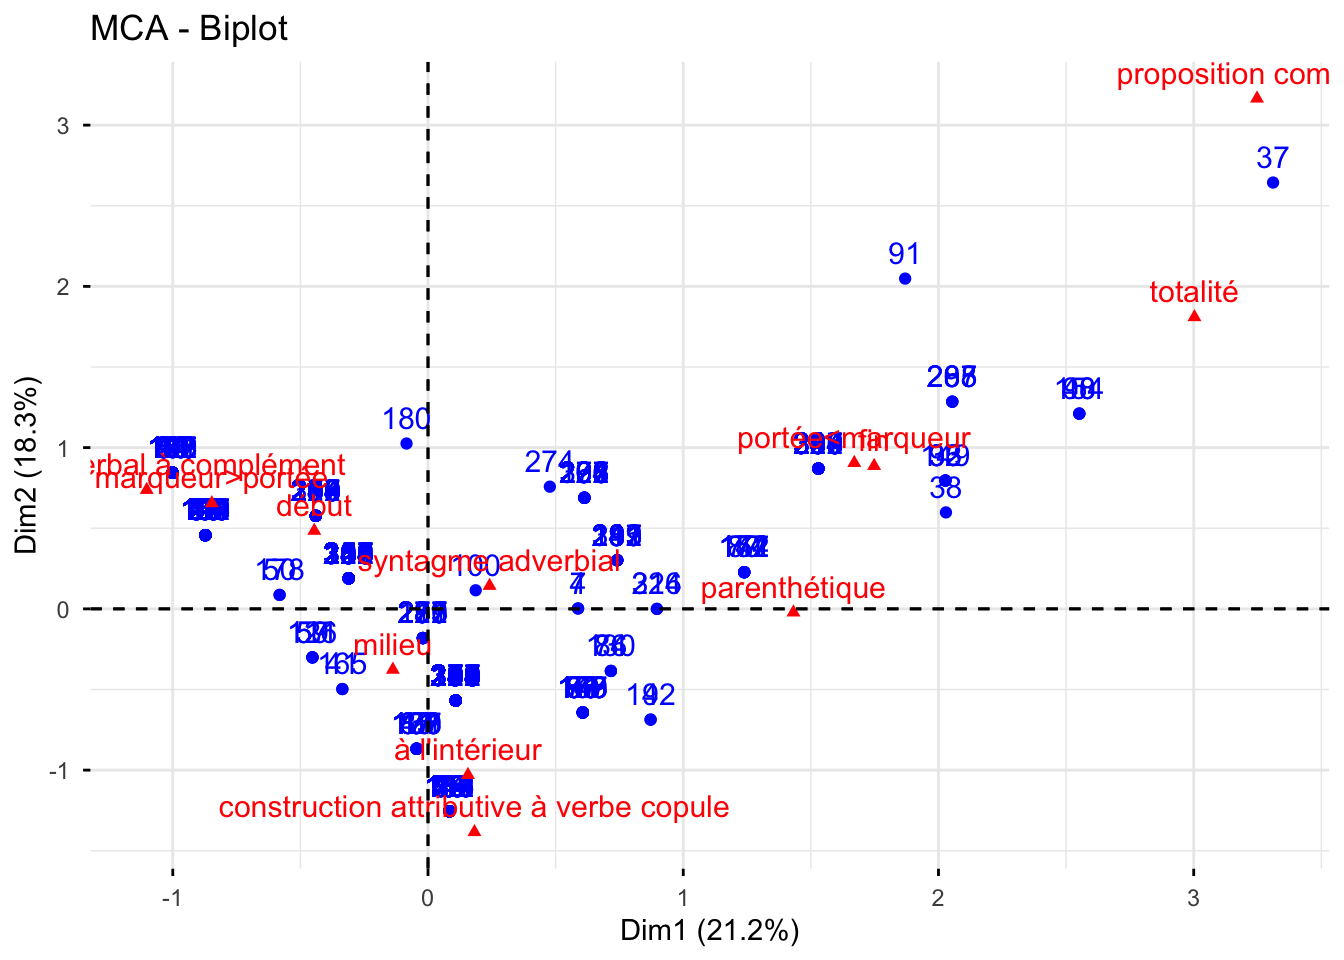
Et on peut obtenir la répartition de l’information sur les différents axes avec :
fviz_eig(mca_res, addlabels=TRUE)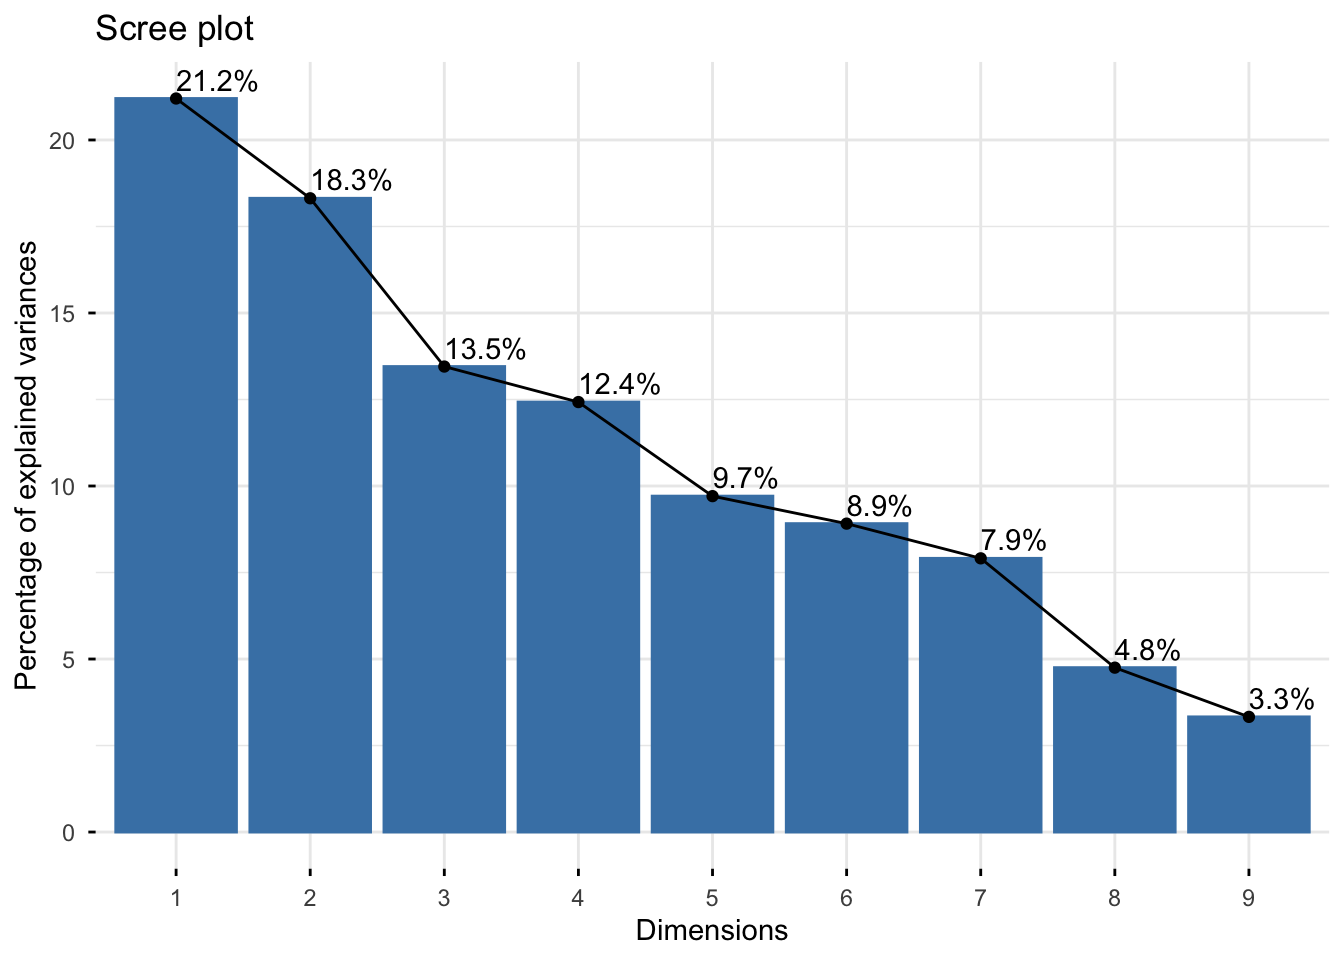
Nous allons maintenant voir comment obtenir des résultats plus détaillés dans la prochaine section.
3 Exploration des résultats
3.1 Les variables
Lors d’une ACM, on se focalise généralement sur l’interprétation des modalités des différentes variables, dont l’affichage peut être isolé des individus grâce à la fonction fviz_mca_var(). Ici, nous allons colorer les différentes modalités selon leur appartenance aux variables.
On commence par extraire le nombre de modalités de chaque variable grâce aux dimensions de la table de contingence sur notre jeu de données :
n_modalities = dim(table(pragmatique_red_df))
n_modalities
[1] 5 4 3On peut donc construire un vecteur contenant l’appartenance de chaque modalité aux variables :
modality_type = rep(names(pragmatique_red_df), n_modalities)
modality_type
[1] "Type" "Type" "Type" "Type" "Type" "Position"
[7] "Position" "Position" "Position" "Direction" "Direction" "Direction"On peut alors tracer le graphique des modalités avec la coloration correspondant aux différentes variables (pour rappel, le paramètre repel=T empêche la superposition des éléments textuels) :
fviz_mca_var(mca_res,
             repel = TRUE,
             col.var = modality_type,
             mean.point = FALSE,
             legend.title = "Variables")
Ignoring unknown labels:
• fill : "Variables"
• linetype : "Variables"
• shape : "Variables"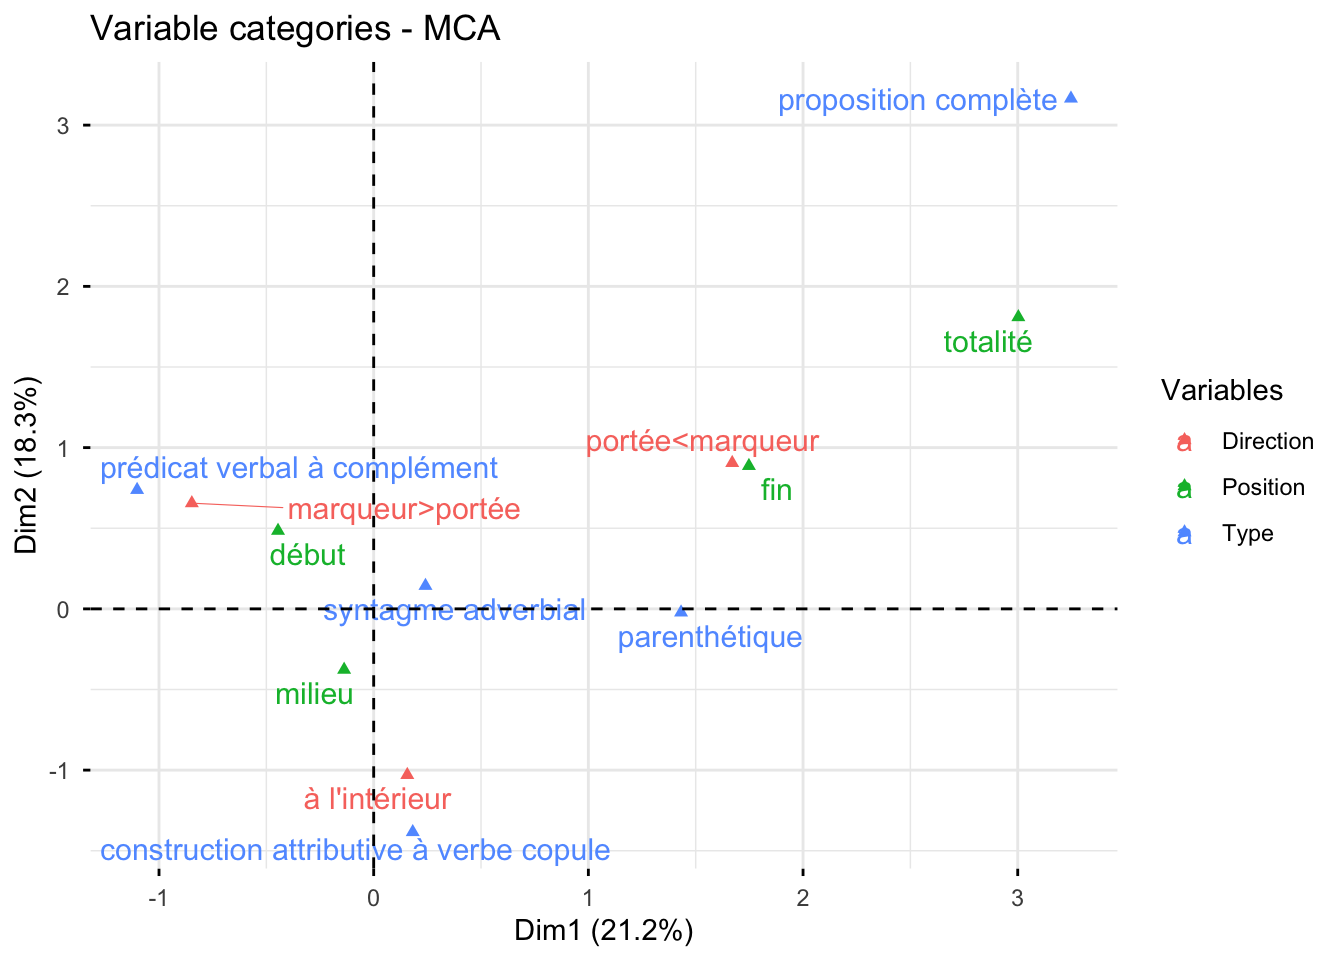
Les contributions aux axes s’obtiennent avec fviz_contrib() :
fviz_contrib(mca_res, choice="var", axes=c(1, 2))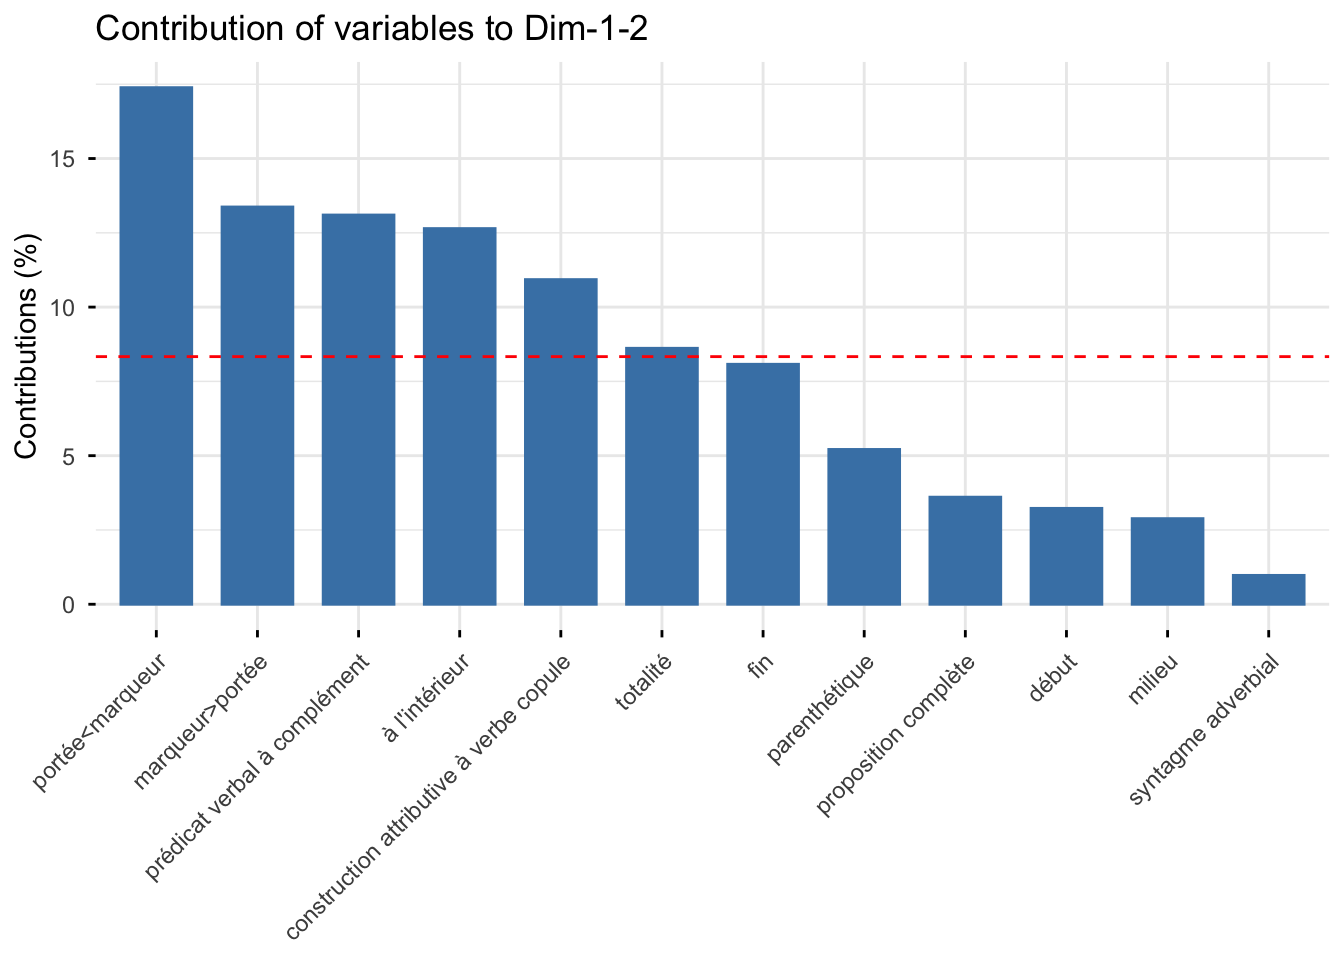
Et la qualité de la représentation (la corrélation ou cos2) avec fviz_cos2() :
fviz_cos2(mca_res, choice="var", axes=c(1, 2))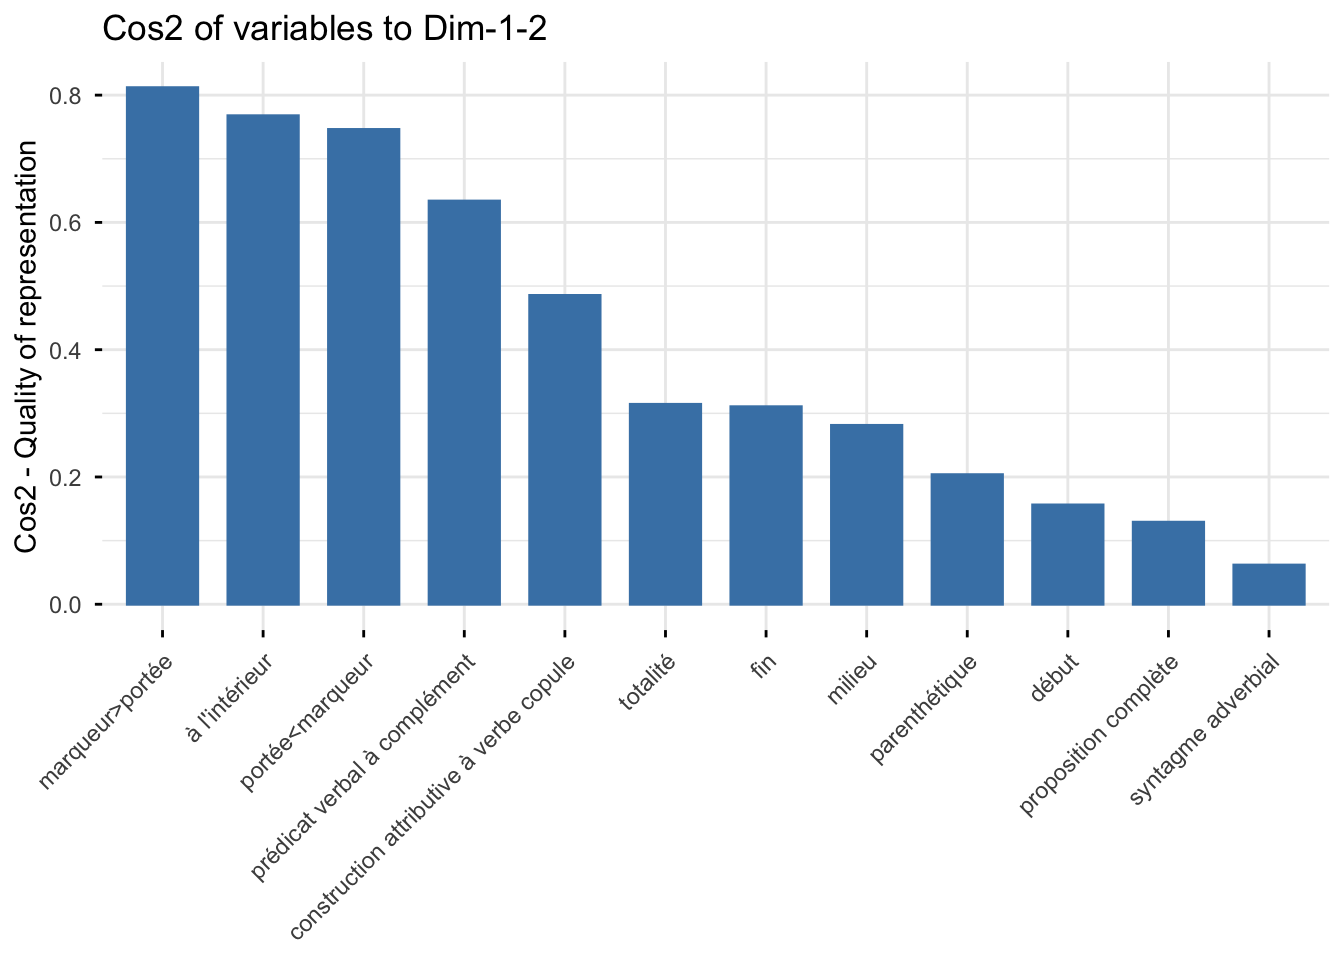
Mais on peut également obtenir la corrélation entre l’entièreté d’une variable (i.e. toutes ses modalités) et les axes via mca_res$var$eta2 :
mca_res$var$eta2 Dim 1 Dim 2 Dim 3 Dim 4 Dim 5
Type 0.6046954 0.5975610 0.584833566 0.6921602 0.57325798
Position 0.5177726 0.2929247 0.617828772 0.4043231 0.27805324
Direction 0.7853821 0.7578414 0.008038193 0.0218250 0.02236664Ce qui peut être représenté graphiquement par fviz_mca_var() avec l’argument choice="mca.cor" :
fviz_mca_var(mca_res, choice="mca.cor")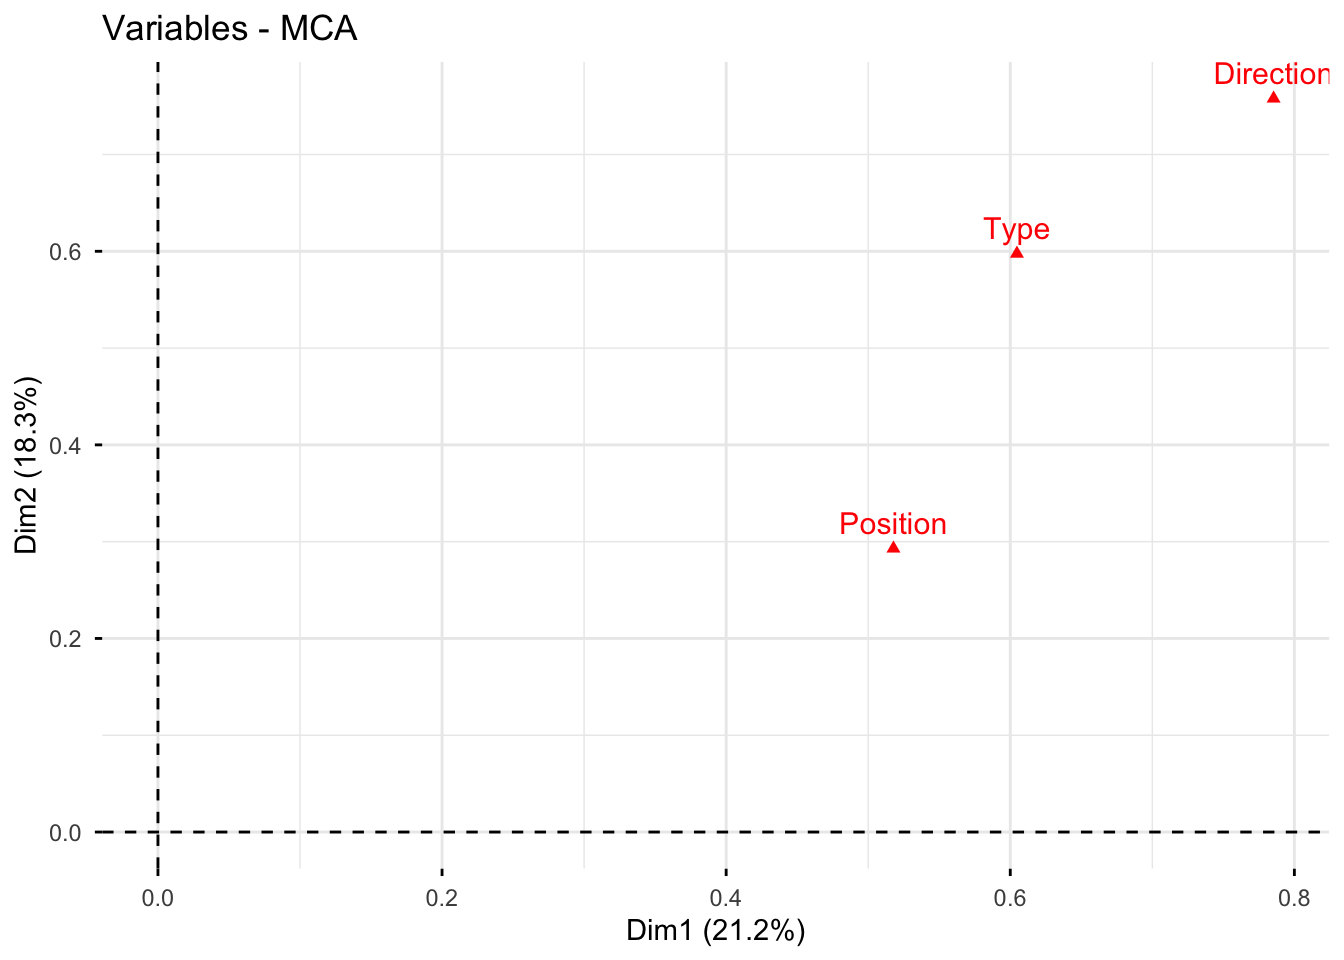
3.2 Les individus
Comme nous l’avons vu sur le biplot, la représentation des individus est généralement moins informative (surtout si ces derniers sont anonymes) que la représentation des variables. Cependant, on peut utiliser une variable auxiliaire (ou plusieurs) afin de gagner de l’information sur la position des individus. Ici, nous allons cartographier les différents lemmes.
On commence par extraire le vecteur des lemmes :
lemme = pragmatique_df$LemmeEt on réutilise fviz_mca_biplot() pour afficher nos individus avec nos modalités. Plusieurs options sont utilisées ici :
goem.ind="point"permet de n’afficher que des points, sans label.col.ind=lemmedonne des couleurs aux individus correspondant aux lemmes.addEllipses=Taffiche également des ellipses illustrant la répartition des différents lemmes.ellipse.type="confidence"permet de tracer des ellipses illustrant un intervalle de confiance sur la moyenne.
Avec ces options, le résultat donne :
fviz_mca_biplot(mca_res,
                geom.ind="point",
                col.ind=lemme,
                col.var=modality_type,
                addEllipses=T,
                ellipse.type="confidence", repel=T)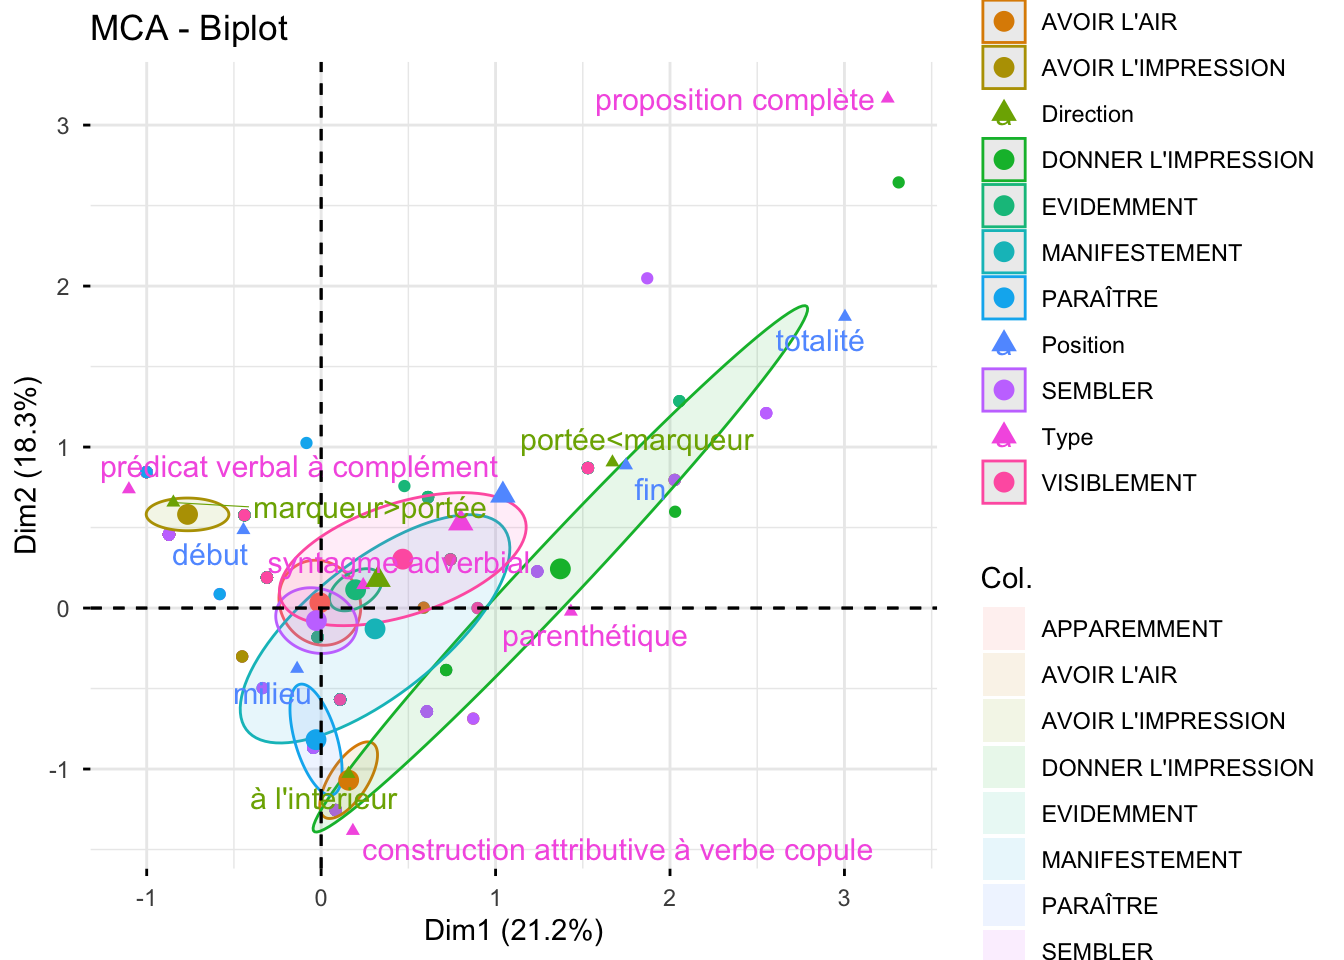
Notez qu’on aurait pu obtenir un résultat similaire (mais pas complètement identique) en définissant Lemme comme une variable supplémentaire.
On sélectionne Lemme en plus de nos trois variables étudiées :
pragmatique_sup_df = pragmatique_df %>%
  select(Lemme, Type, Position, Direction)
On effectue l’ACM en précisant que notre première colonne (quali.sup=1) est une variable supplémentaire :
mca_sup_res = MCA(pragmatique_sup_df, graph=F, quali.sup=1)Et on affiche à nouveau le graphique des variables, qui contiendra alors les modalités de la variable supplémentaire :
fviz_mca_var(mca_sup_res,
             col.var=modality_type,
             repel=T,
             mean.point = FALSE,)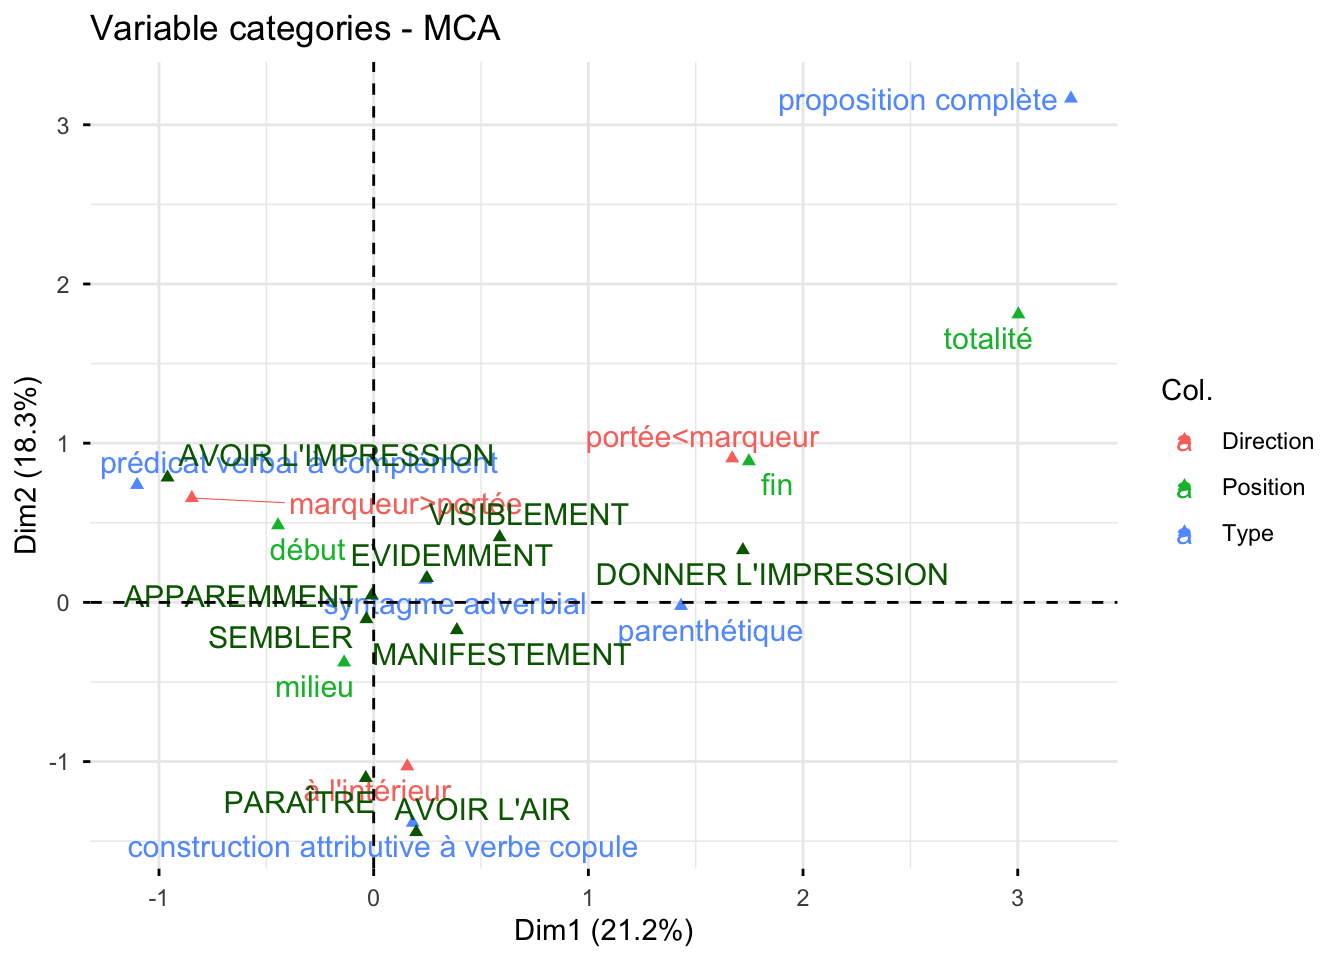
Notez que ce résultat diffère légèrement du précédent car cette fois-ci, les Lemmes sont dans l’espace des variables (alors qu’avant ils étaient dans l’espace des individus). Pour comparer les lemmes avec les modalités étudiées, on se basera sur la distance lorsque les points sont dans le même espace, alors que précédemment, lorsque les Lemmes sont dans l’espace des individus et les modalités dans l’espace des variables, il faut plutôt considérer le produit scalaire (la direction) pour les comparer.