Dans ce TP, nous allons voir comment faire un modèle de régression linéaire en R. La régression linéaire cherche à prédire une variable numérique d’un individu en fonction d’autres de ses variables. C’est une méthode emblématique en statistiques, et il existe de nombreuses méthodes qui dérivent de cette logique. De part son importance en statistiques, les fonctions permettant la construction de modèles linéaires font partie de la base de R.
Les librairies nécessaires pour ce TP sont les suivantes :
library(tidyverse)
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr     1.2.1     ✔ readr     2.2.0
✔ forcats   1.0.1     ✔ stringr   1.6.0
✔ ggplot2   4.0.3     ✔ tibble    3.3.1
✔ lubridate 1.9.5     ✔ tidyr     1.3.2
✔ purrr     1.2.2
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag()    masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
library(fastDummies)library(leaps)
Nous allons utiliser ici le jeu de données de sociolinguistique pré-traité. On commence par le charger et transformer ses variables de type character en factor :
Rows: 113 Columns: 61
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
chr  (12): acc_mode, acc_exclu, acc_accept, acc_enrich, acc_suppr, acc_menac...
dbl  (47): id, annee, duree, duree_num, Hashtag, Design, Selfie, Pull-over, ...
dttm  (2): h_deb, h_fin

ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.
1.1 Recodage de variables ordinales ou catégorielles
La régression linéaire classique permet de faire des prédictions sur une variable numérique à partir d’une ou plusieurs autres variables numériques uniquement. Cependant, il est possible de recoder les variables ordinales ou catégorielles comme variables numériques, afin de les utiliser dans un modèle de régression.
Pour une variable ordinale, on va utiliser des nombres pour chaque niveau des réponses. Par exemple, ici, on va recoder les différents niveaux d’accord avec la fonction suivante :
recode_to_numeric =function(var_accord){ var_accord_numeric =case_when(var_accord =="En désaccord total"~-2, var_accord =="Plutôt en désaccord"~-1, var_accord =="Neutre"~0, var_accord =="Plutôt d'accord"~1, var_accord =="Tout à fait d'accord"~2)return(var_accord_numeric)}
Que l’on peut ensuite appliquer avec mutate_at() sur toutes les variables d’accord :
Pour les variables catégorielles, on utilise l’encodage binaire : Chaque modalité devient une colonne qui contiendra un 1 si l’individu a cette modalité et un 0 sinon. On peut obtenir cet encodage avec la fonction dummy_cols() du package fastDummies :
head(dummy_cols(socioling_df$genre))
      .data .data_Non binaire .data_Un homme .data_Une femme
1 Une femme                 0              0               1
2 Une femme                 0              0               1
3  Un homme                 0              1               0
4 Une femme                 0              0               1
5 Une femme                 0              0               1
6 Une femme                 0              0               1
Cependant, nous le verrons plus tard, cet encodage s’effectue automatiquement lorsque l’on utilise des modèles linéaires avec R. Il n’est donc pas nécessaire de l’appliquer explicitement.
Notre jeu de données est prêt, il ne nous reste plus qu’à créer un jeu de données réduit, contenant uniquement les colonnes que nous allons utiliser :
La régression linéaire s’effectue avec la fonction lm() de R. Cette dernière demande comme premier argument une formule qui a une structure particulière et qui utilise l’opérateur ~.
La structure usuelle d’une formule est la suivante :
Mais on peut également utilisé d’autres syntaxes :
En utilisant <variable réponse> ~ ., on indique que l’on prédit avec toutes les variables du jeu de données.
En ajoutant -1 à la formule, la droite de régression passera par l’origine.
<variable i>^n permet d’ajouter l’ordre \(n\) de la variable
<variable i>*<variable j> permet d’ajouter les termes d’interaction.
Plusieurs fonctions peuvent être utilisées sur les variables, comme exp() ou log().
2.2 Un modèle simple
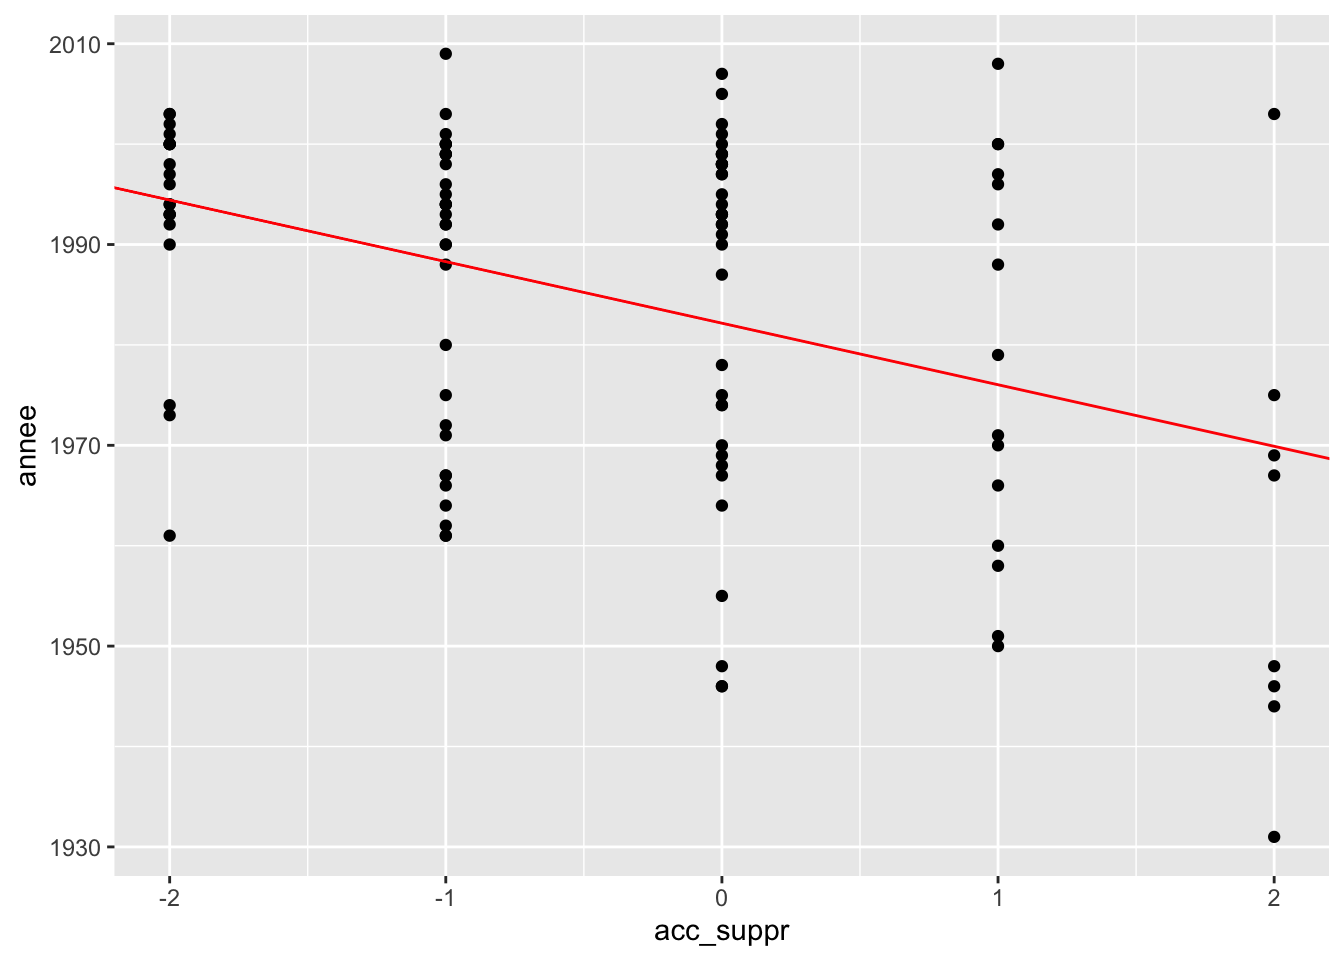
Commençons par faire un modèle linéaire extrêmement simple : on va essayer de prédire l’année de naissance de l’individu en fonction de sa réponse à la question « Il faudrait supprimer l’anglais dans les publicités, affiches, magazines et médias ». Ce modèle se construit de la manière suivante :
En affichant le résultat, on obtient la valeur des coefficients de régression. En utilisant summary() sur notre résultat, plusieurs autres informations sont disponibles, tel que la signicativité des coefficients, le R^2 et le R^2 ajusté :
summary(lm_mini_res)
Call:
lm(formula = annee ~ acc_suppr, data = socioling_red_df)

Residuals:
    Min      1Q  Median      3Q     Max
-38.904 -13.178   4.685  11.685  33.096

Coefficients:
            Estimate Std. Error  t value Pr(>|t|)
(Intercept) 1982.178      1.643 1206.338  < 2e-16 ***
acc_suppr     -6.137      1.368   -4.486 1.78e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 16.57 on 111 degrees of freedom
Multiple R-squared:  0.1535,    Adjusted R-squared:  0.1458
F-statistic: 20.12 on 1 and 111 DF,  p-value: 1.78e-05
On peut également extraire plusieurs informations du résultat de la régression :
Nous allons maintenant voir comment faire le “meilleur modèle” à partir de nos variables pré-sélectionnées. On commence par faire le modèle “complet”, c’est-à-dire avec toutes les variables contenues dans notre jeu de données :
Call:
lm(formula = annee ~ ., data = socioling_red_df)

Residuals:
    Min      1Q  Median      3Q     Max
-43.127  -8.781   2.789  10.680  27.544

Coefficients:
                                        Estimate Std. Error t value Pr(>|t|)
(Intercept)                            1996.6664    25.1396  79.423   <2e-16
genreUn homme                            -4.4780    16.8306  -0.266   0.7907
genreUne femme                           -1.4719    16.8431  -0.087   0.9305
acc_mode                                 -0.4117     1.8471  -0.223   0.8241
acc_exclu                                -0.6950     1.8250  -0.381   0.7042
acc_accept                               -3.2694     1.6903  -1.934   0.0560
acc_enrich                                3.1082     1.5515   2.003   0.0479
acc_suppr                                -2.1636     1.8574  -1.165   0.2469
acc_menace                               -0.5161     1.6140  -0.320   0.7498
ouAu travail                            -13.1166    17.6316  -0.744   0.4587
ouAutre                                 -21.5100    18.1267  -1.187   0.2382
ouDans la rue                           -12.1939    18.3232  -0.665   0.5073
ouDans les groupes de jeunes personnes   -8.3895    17.4245  -0.481   0.6313
eviteNon                                  1.0467     3.6883   0.284   0.7772
eviteOui                                 -4.3463     5.1441  -0.845   0.4002

(Intercept)                            ***
genreUn homme
genreUne femme
acc_mode
acc_exclu
acc_accept                             .
acc_enrich                             *
acc_suppr
acc_menace
ouAu travail
ouAutre
ouDans la rue
ouDans les groupes de jeunes personnes
eviteNon
eviteOui
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 16.11 on 98 degrees of freedom
Multiple R-squared:  0.293, Adjusted R-squared:  0.192
F-statistic: 2.901 on 14 and 98 DF,  p-value: 0.001053
On voit que la plupart des coefficients de régression sont loin d’être significatifs. Cependant, ce problème peut être dû au fait que la régression possède de nombreux prédicteurs qui sont fortement liés entre eux.
Le package leaps nous permet de sélectionner le “meilleur modèle” selon différents critères. Pour cela, on utilise la fonction regsubsets(), qui crée une variable contenant l’évaluation de tous les modèles découlant de notre modèle complet :
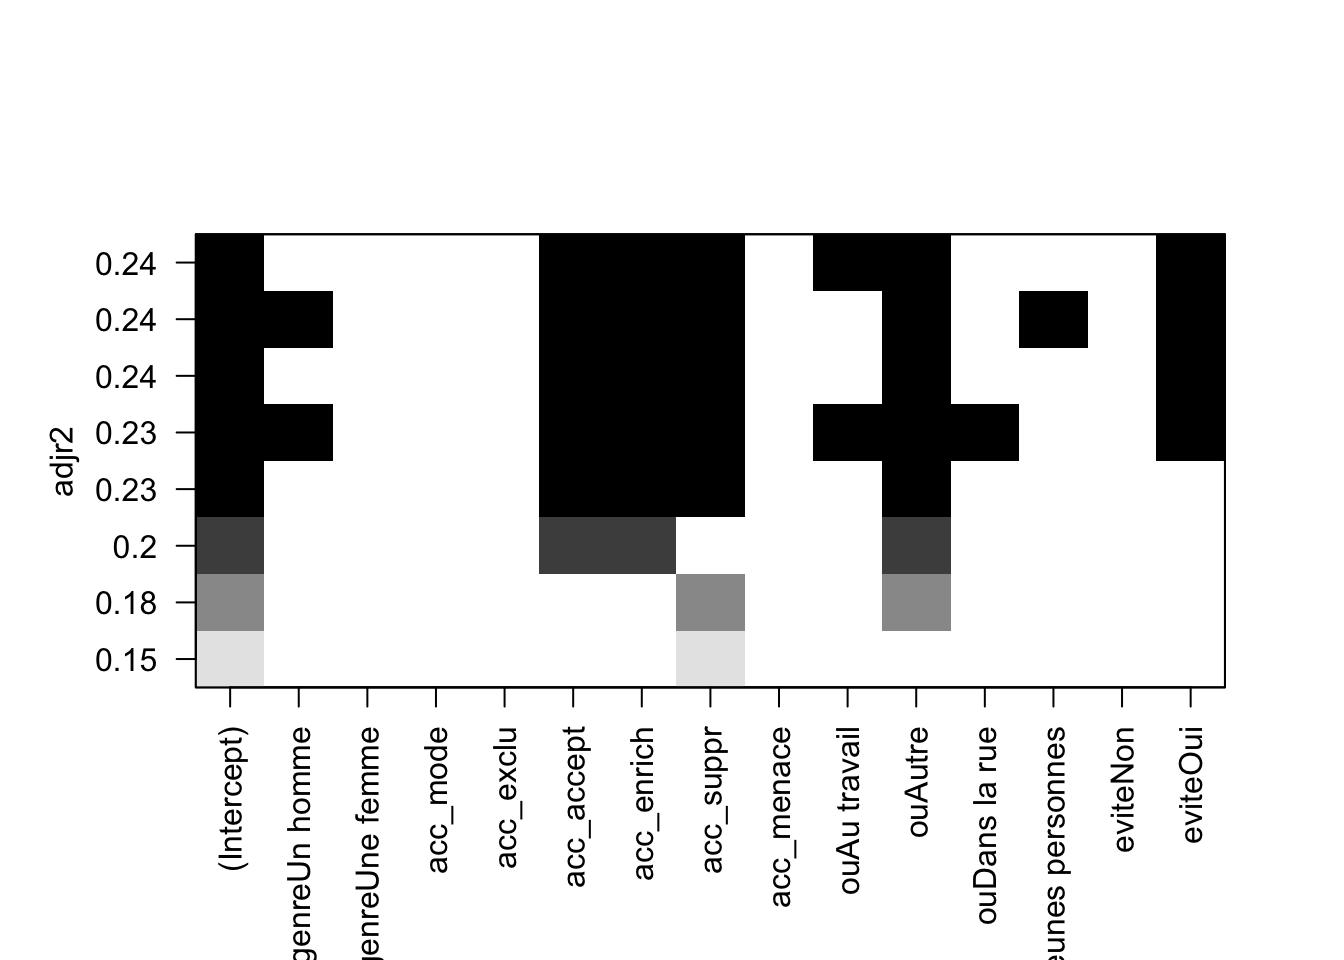
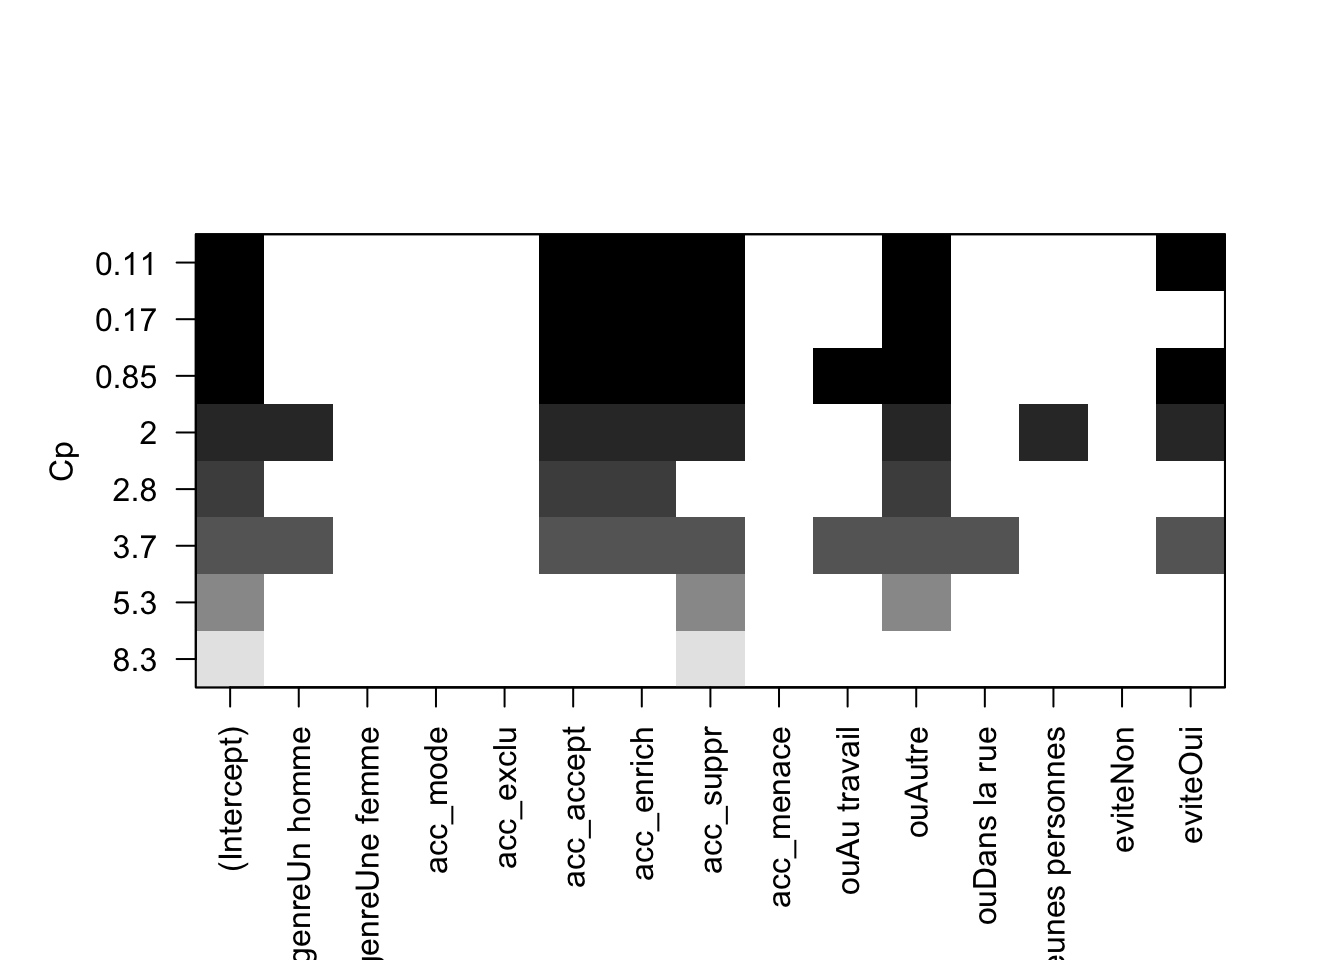
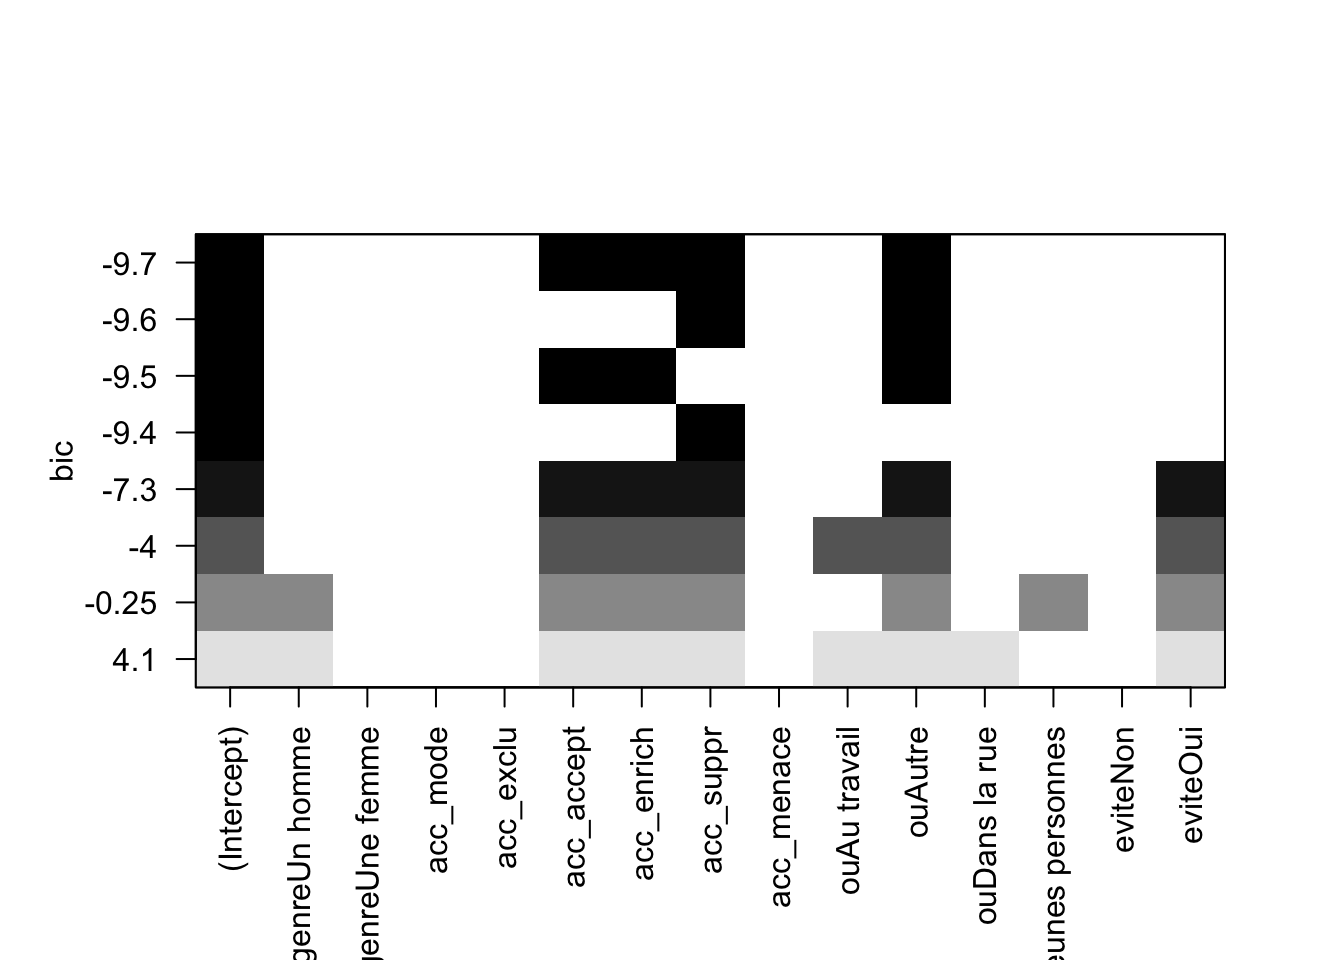
Les valeurs des critères R^2 ajusté (à maximiser), CP et BIC (à minimiser), selon les différents modèles testés peuvent alors s’afficher avec :
plot(lm_subset_res, scale="adjr2")
plot(lm_subset_res, scale="Cp")
plot(lm_subset_res, scale="bic")
Si l’on choisit d’optimiser le BIC, on voit que l’on doit garder acc_accept, acc_enrich, acc_suppr et la modalité Autre de la variable ou. On va donc explicitement construire les modalités de cette variable plus :
Call:
lm(formula = annee ~ acc_accept + acc_enrich + acc_suppr + ou_Autre,
    data = socioling_red_new_df)

Residuals:
    Min      1Q  Median      3Q     Max
-43.339  -9.204   3.449  11.203  27.720

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 1982.255      2.057 963.875   <2e-16 ***
acc_accept    -3.542      1.549  -2.286   0.0242 *
acc_enrich     3.106      1.394   2.229   0.0279 *
acc_suppr     -3.327      1.508  -2.206   0.0295 *
ou_Autre     -11.145      4.765  -2.339   0.0212 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 15.75 on 108 degrees of freedom
Multiple R-squared:  0.2557,    Adjusted R-squared:  0.2281
F-statistic: 9.276 on 4 and 108 DF,  p-value: 1.757e-06
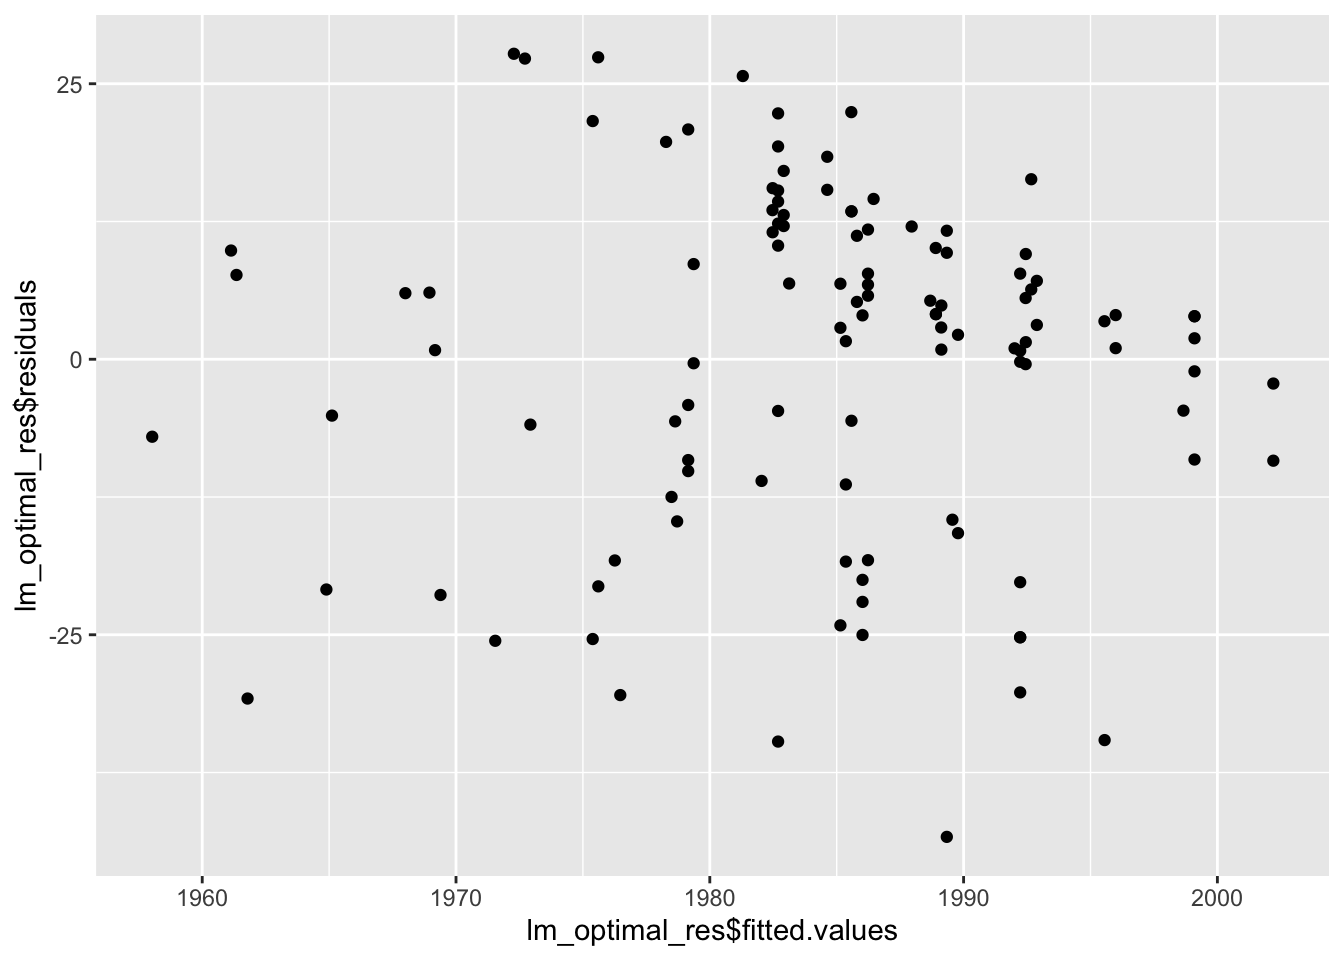
Un bon modèle de régression doit, en principe, suivre plusieurs hypothèses de travail. En particulier, il ne doit pas avoir de “structure particulière” dans ses termes d’erreurs. Cela peut être vérifier en affichant le diagramme des résidus :